
कोर्स
एक स्वस्थ आर्थिक प्रणाली वस्तुओं और सेवाओं के खरीदारों और विक्रेताओं के बीच विश्वास पर टिकी होती है। जब यह विश्वास टूटता है, तो कारोबार की लागत बढ़ जाती है। बेईमान लोग व्यवसायों को धोखा देने के लिए छलपूर्ण लेन-देन करते हैं। कुछ उद्योगों को निशाना बनाने वाले परिष्कृत ठगों के समूह भी होते हैं।
इस लेख में, हम एनालिटिक्स के माध्यम से पकड़ी जाने वाली विभिन्न प्रकार की धोखाधड़ी और उन्हें पकड़ने में काम आने वाली तकनीकों पर चर्चा करते हैं। हम सामान्य फ्रॉड डिटेक्शन वर्कफ़्लोज़ और फ्रॉड एनालिटिक्स में आम तौर पर उपयोग होने वाले सॉफ़्टवेयर टूल्स को भी कवर करेंगे।
जानें कि AI आपकी संस्था को कैसे प्रभावित कर सकता है और सफल AI रणनीतियाँ कैसे लागू करें हमारे श्वेतपत्र The Learning Leader's Guide to AI Literacy के साथ।
फ्रॉड एनालिटिक्स क्या है?
फ्रॉड एनालिटिक्स का तात्पर्य सांख्यिकीय और मशीन लर्निंग तकनीकों से है जो संभावित रूप से धोखाधड़ी वाले लेन-देन की पहचान और फ़्लैग करती हैं, आमतौर पर वास्तविक समय में।
धोखाधड़ी गतिविधियों का पता लगाना चुनौतीपूर्ण है क्योंकि:
- ठग अपनी लेन-देन को वैध दिखाने के लिए कई तकनीकों का उपयोग करते हैं। इसलिए, विक्रेता को संभावित रूप से धोखाधड़ी वाले लेन-देन का पता लगाने के लिए तकनीकी और सांख्यिकीय टूल्स की जरूरत होती है।
- धोखाधड़ी वाले लेन-देन कुल लेन-देन का एक छोटा हिस्सा होते हैं। इसलिए, संभावित रूप से बेईमान लेन-देन को फ़्लैग करने के लिए एक स्वचालित दृष्टिकोण आवश्यक है।
व्यवसायों को ऐसे फ्रॉड डिटेक्शन टूल्स का उपयोग करना चाहिए जो इन विशेषताओं को शामिल करें। ये टूल्स उन लेन-देन को फ़्लैग करते हैं जिनके धोखाधड़ी होने की संभावना अधिक होती है। इसके बाद मानव अन्वेषक फ़्लैग किए गए लेन-देन की मैन्युअल जांच करते हैं और अंतिम निर्णय लेते हैं।
संभावित धोखाधड़ी का पता लगाना उस व्यवहार की खोज करने पर आधारित है जो:
- ज्ञात धोखाधड़ी गतिविधियों से मेल खाता हो।
- सामान्य दायरे से काफी भिन्न हो।
एनालिटिक्स के माध्यम से पता लगने वाले धोखाधड़ी के सामान्य प्रकार
इस खंड में, हम धोखाधड़ी वाले लेन-देन की व्यापक श्रेणियों का पता लगाते हैं, हर श्रेणी में आम उदाहरणों पर चर्चा करते हैं, और यह भी कि उन्हें पहचानने और रोकने के लिए एनालिटिक्स टूल्स का उपयोग कैसे किया जाए।
वित्तीय धोखाधड़ी
वित्तीय धोखाधड़ी शायद सबसे प्रसिद्ध और व्यापक रूप है। पीड़ित आमतौर पर वित्तीय संस्थान और उनके ग्राहक होते हैं। अपराधी आमतौर पर खुद को ग्राहकों या वित्तीय संस्थानों के प्रतिनिधियों के रूप में पेश करने वाले ठग होते हैं।
क्रेडिट कार्ड धोखाधड़ी में किसी कार्ड का बिना अनुमति इस्तेमाल करके सामान खरीदना या एटीएम से पैसे निकालना शामिल है। अक्सर यह चोरी किए गए कार्ड विवरणों से किया जाता है। फ्रॉड एनालिटिक्स आम पैटर्न देखकर कार्ड फ्रॉड का पता लगाने में मदद कर सकता है, जैसे:
- लेन-देन की आवृत्ति और मात्रा में अचानक उछाल।
- कई स्थानों पर लगातार लेन-देन।
पहचान की चोरी तब होती है जब किसी व्यक्ति की निजी जानकारी (जैसे बैंक खाता संख्या, सरकारी जारी आईडी नंबर, ईमेल पासवर्ड आदि) चोरी हो जाती है। इस जानकारी का उपयोग व्यक्ति का प्रतिरूपण करके ऋण लेने, ओवरड्राफ्ट खाते खोलने और अन्य बड़े वित्तीय लेन-देन करने के लिए किया जा सकता है। ऐसी स्थितियों में फ्रॉड एनालिटिक्स निम्नलिखित संदेहास्पद गतिविधियों को फ़्लैग करके मदद करता है:
- कम समय में कई खाते खोलना।
- व्यक्ति के ज्ञात पूर्व व्यवहार से काफी अलग होना।
पेमेंट फ्रॉड किसी व्यक्ति या व्यवसाय को ऐसी चीज़ के लिए भुगतान कराने के लिए छलपूर्ण तरीकों का उपयोग करना है जिसे वे खरीद नहीं रहे हैं। इसमें शामिल हैं:
- कंपनियों को नकली चालान भेजना।
- लंबित भुगतान की पुष्टि के लिए नकली मल्टीफैक्टर ऑथेंटिकेशन संदेश भेजना।
- बैंक कर्मचारियों का प्रतिरूपण करके गोपनीय खाता-संबंधित जानकारी निकालना।
एनालिटिक्स निम्नलिखित प्रकार के लेन-देन की निगरानी और फ़्लैग करके पेमेंट फ्रॉड से निपटने में मदद कर सकता है:
- खाते के सामान्य व्यवहार और भुगतान गतिविधि से काफी अलग होना।
- संदिग्ध IP पते और डिवाइस IDs से उत्पन्न होना।
बीमा धोखाधड़ी
बीमा धोखाधड़ी में मामूली घटनाओं पर बड़े दावों का करना और जोखिम भरी पॉलिसियों के लिए कम प्रीमियम देना शामिल है। पीड़ित आमतौर पर बीमा कंपनी होती है, जबकि अपराधी खुद को ग्राहक या बीमा एजेंट के रूप में पेश करते हैं।
फर्जी दावे उन दुर्घटनाओं के बारे में होते हैं जो हुई ही नहीं। ऐसे दावों का पता लगाने के लिए, एनालिटिक्स टूल्स:
- रिपोर्ट की गई घटनाओं, जैसे प्राकृतिक आपदा या सड़क दुर्घटना, को अन्य स्रोतों से मिलान करके रिपोर्ट की सच्चाई की पुष्टि करते हैं।
- विशिष्ट व्यक्तियों या खास स्थानों पर किए गए दावों में पैटर्न का विश्लेषण करते हैं।
फुलाए हुए दावे छोटे-मोटे हादसों में हुए नुकसान और दावे की राशि को बढ़ा-चढ़ाकर पेश करते हैं। फ्रॉड एनालिटिक्स टूल्स निम्न तरीकों से ऐसे दावों को कम करने में मदद कर सकते हैं:
- ऐतिहासिक डेटा के आधार पर विभिन्न प्रकार की दुर्घटनाओं के लिए सामान्य दावा राशि का अनुमान लगाना।
- रिपोर्ट की गई दुर्घटना का उस प्रकार की सामान्य दावा राशि से मिलान करना।
बीमा सर्वेक्षक संभावित रूप से फुलाए गए दावों की मैन्युअली पुष्टि करते हैं।
प्रीमियम चोरी में बीमा कंपनी को गलत जानकारी देकर कृत्रिम रूप से जोखिम प्रोफ़ाइल घटाकर किसी पॉलिसी के लिए कम प्रीमियम देना शामिल है। फ्रॉड एनालिटिक्स टूल्स इसमें मदद कर सकते हैं:
- पॉलिसी आवेदन में दी गई जानकारी को अन्य स्रोतों से मिलान करके सत्यापित करना।
- प्रीमियम चोरी में इस्तेमाल होने वाले आम पैटर्न का पता लगाना। उदाहरण के लिए, यदि किसी वाहन मॉडल को जो प्रायः वाणिज्यिक गतिविधियों के लिए उपयोग होता है, निजी उपयोग के लिए बीमा कराया गया है, तो एनालिटिक्स टूल्स उसे आगे की जांच के लिए फ़्लैग करते हैं।
नकली पॉलिसियाँ वे जाली पॉलिसियाँ हैं जिन्हें ठग बीमा एजेंट बनकर बनाते और बेचते हैं। ग्राहक को इसका पता तब चलता है जब वह दावा करने जाता है। फ्रॉड एनालिटिक्स सॉफ़्टवेयर नकली पॉलिसियों का पता इस प्रकार लगाता है:
- सिस्टम में संग्रहीत पॉलिसी विवरणों का ग्राहक द्वारा प्रस्तुत विवरणों से मिलान करना।
बीमा कंपनियों का यह सामाजिक दायित्व भी है कि वे उनके नाम पर जारी नकली पॉलिसियों के पैटर्न की पहचान करें। इन विश्लेषणों को कानून प्रवर्तन एजेंसियों के समक्ष प्रस्तुत करने से नकली पॉलिसी रैकेट पकड़े जाने में मदद मिलती है।
हेल्थकेयर धोखाधड़ी
हेल्थकेयर सिस्टम के किसी भी हिस्से में, जिसमें सार्वजनिक स्वास्थ्य बीमाकर्ता भी शामिल हैं, हेल्थकेयर धोखाधड़ी हो सकती है। पीड़ित भुगतानकर्ता होता है, जो निम्नलिखित में से एक या अधिक समूह हो सकते हैं:
- रोगी
- को-पे योजना में रोगी का नियोक्ता
- सरकार, सार्वजनिक रूप से वित्तपोषित स्वास्थ्य प्रणालियों में
- बीमा कंपनी
अपराधी अक्सर हेल्थकेयर सेवा प्रदाता या रोगी होते हैं। हेल्थकेयर धोखाधड़ी आमतौर पर फर्जी दावों के माध्यम से की जाती है, जिनमें न की गई सेवाओं के लिए बिलिंग और अपकोडिंग शामिल हैं।
न की गई सेवाओं के लिए बिलिंग का मतलब उन सेवाओं (जैसे परीक्षण और उपचार) के लिए शुल्क लेना है जो रोगी पर की ही नहीं गईं। इस तरह की धोखाधड़ी का पता लगाने के लिए, एनालिटिक्स टूल्स निम्न कर सकते हैं:
- पैटर्न रिकग्निशन का उपयोग करके चालानों की तुलना समान शिकायतों के लिए उद्योग साथियों द्वारा आमतौर पर बिल की जाने वाली राशियों और वस्तुओं से करना।
- चालान की गई सेवाओं का हेल्थकेयर प्रदाता के सर्विस लॉग और रोगी-उपचार रिकॉर्ड से मिलान करना।
- असामान्य रूप से उच्च बिलिंग रिकॉर्ड वाले प्रदाताओं की पहचान करना और उनकी फाइलिंग की बारिकी से जांच करना।
अपकोडिंग का अर्थ प्रदान की गई सेवा से अधिक महंगी श्रेणी के लिए बिलिंग करने की कदाचार से है। फ्रॉड एनालिटिक्स टूल्स अपकोडिंग का पता लगाने के लिए विभिन्न तरीकों का उपयोग करते हैं, जैसे:
- सांख्यिकीय विश्लेषण करके नियमित परीक्षणों और महंगे परीक्षणों (या उपचारों) के अनुपात की तुलना उद्योग मानकों से करना। उदाहरण के लिए, कोई प्रदाता जो अधिकतर विस्तारित और बहुत कम नियमित चेकअप के लिए बिल करता है, संदेहास्पद है।
- चालानों की तुलना रोगी और अस्पताल के रिकॉर्ड से करना, जिनमें आमतौर पर किए गए प्रोसिजर या टेस्ट का विवरण होता है।
- विशेष अपकोडेड श्रेणियों में अचानक वृद्धि की जांच के लिए बिल की गई राशियों की प्रदाता के ऐतिहासिक डेटा से तुलना करना।
ई-कॉमर्स और रिटेल धोखाधड़ी
कई ई-कॉमर्स विक्रेता छोटे और मध्यम उद्यम होते हैं जो जरूरी नहीं कि टेक-सेवी हों। इसलिए, धोखाधड़ी गतिविधियों का पता लगाने और उन्हें रोकने की जिम्मेदारी ई-कॉमर्स प्लेटफॉर्म्स पर आती है। ई-कॉमर्स और रिटेल धोखाधड़ी कई रूपों में हो सकती है:
अकाउंट टेकओवर में उपयोगकर्ता अपना खाता ठगों के हाथों खो देता है, जो बिना अनुमति खरीदारी करके उसका दुरुपयोग करते हैं। यह आमतौर पर उपयोगकर्ता की गलती या पासवर्ड और फ़िशिंग जैसे सुरक्षा पहलुओं के प्रति लापरवाही के कारण होता है।
ई-कॉमर्स प्लेटफ़ॉर्म अकाउंट टेकओवर का पता निम्नलिखित तकनीकों से लगा सकते हैं:
- व्यवहार विश्लेषण, जैसे लॉगिन समय, खरीद श्रेणियाँ, ब्राउज़िंग हिस्ट्री आदि में विशिष्ट व्यवहार से विचलन की जाँच करना।
- असामान्य गतिविधि (जैसे कई असफल लॉगिन प्रयास) के साथ अकाउंट सेटिंग्स में बदलाव (जैसे ईमेल IDs और डिलीवरी पते) का संयोजन।
नकली रिटर्न तब होते हैं जब दुष्ट तत्व खरीदे गए आइटम से अलग वस्तु लौटाते हैं, जैसे महंगा सामान ऑर्डर करना और नकली लौटाना। इसमें ऐसे इस्तेमालशुदा उत्पादों को लौटाना भी शामिल है जिन्हें दोबारा बेचा नहीं जा सकता। नकली रिटर्न से बचाव के लिए, फ्रॉड एनालिटिक्स यह कर सकता है:
- रिटर्न पैटर्न का विश्लेषण करके उन खरीदारों की पहचान करना जो अक्सर आइटम लौटाते हैं।
- मूल खरीद से तुलना करके सत्यापित करना कि लौटाया गया आइटम वही है जो खरीदा गया था।
- सुनिश्चित करना कि लौटाया गया आइटम अनुपयोगित स्थिति में है।
धोखाधड़ीपूर्ण खरीदारी में चोरी या नकली भुगतान जानकारी और समझौता किए गए खातों का उपयोग करके बिना अनुमति लेन-देन शामिल हैं। इससे विक्रेताओं और अनजान खरीदारों दोनों को नुकसान हो सकता है। फ्रॉड एनालिटिक्स निम्न पैटर्न की पहचान के लिए लेन-देन की निगरानी करके संभावित धोखाधड़ीपूर्ण खरीद को फ़्लैग कर सकता है:
- एक ही IP पते का उपयोग करके कई खातों से बार-बार लॉगिन।
- तेजी से क्रम में अलग-अलग क्रेडिट कार्ड नंबर आज़माना।
- खाते के इतिहास को देखते हुए असामान्य रूप से बड़े खरीद।
चार्जबैक फ्रॉड में क्रेडिट कार्ड की चार्जबैक नीति का दुरुपयोग करके वैध खरीद पर रिफंड का दावा करना शामिल है। फ्रॉड एनालिटिक्स निम्न तरीकों का उपयोग करके चार्जबैक फ्रॉड से सुरक्षा प्रदान कर सकता है:
- पैटर्न रिकग्निशन से उन उपयोगकर्ताओं की पहचान करना जो बार-बार चार्जबैक करते हैं।
- मशीन लर्निंग से संदिग्ध व्यवहार का पता लगाना, जैसे नई अकाउंट्स और हाल ही में अपडेट किए गए भुगतान विवरण के साथ तेज़ी से क्रम में कई खरीदारी।
फ्रॉड एनालिटिक्स में उपयोग की जाने वाली तकनीकें
फ्रॉड एनालिटिक्स टूल्स सामान्य तकनीकों की एक श्रृंखला का उपयोग करते हैं और उन्हें अलग-अलग संदर्भों, डाटासेट्स, और उस डोमेन में ठगों के व्यवहार के अनुरूप ढालते हैं।
सभी फ्रॉड एनालिटिक्स विधियों के दो प्रमुख लक्ष्य होते हैं:
- धोखाधड़ी का पता लगाना और उसे रोकना
- वास्तविक ग्राहकों को सुविधा देना
एनोमली डिटेक्शन
ठग अक्सर वैध ग्राहकों की तुलना में काफी अलग व्यवहार प्रदर्शित करते हैं। एनोमली डिटेक्शन संभावित रूप से धोखाधड़ी वाली गतिविधि की ओर संकेत करने वाले असामान्य व्यवहारों की पहचान करने में मदद करता है। इसमें कई तरीकों का समावेश है:
- सांख्यिकीय आउटलायर डिटेक्शन वितरण के बाकी हिस्से से काफी अलग डेटा बिंदुओं की पहचान करने में मदद करता है। संदिग्ध व्यवहार अक्सर विभिन्न मीट्रिक्स में आउटलायर द्वारा संकेतित होता है, जैसे:
- प्रति घंटे लेन-देन की आवृत्ति।
- किसी दिन में उन ज़िप कोड्स की संख्या जहाँ कार्ड स्वाइप हुआ।
- आइसोलेशन फॉरेस्ट्स कई आइसोलेशन ट्रीज़ से मिलकर बनते हैं। प्रत्येक आइसोलेशन ट्री इस प्रकार काम करता है:
- डेटा की किसी एक विशेषता का यादृच्छिक चयन करें और उस विशेषता के मान के आधार पर डेटा बिंदुओं का यादृच्छिक विभाजन करें।
- हर विभाजन के लिए, एक और यादृच्छिक विशेषता चुनकर आगे विभाजन करें।
- यह प्रक्रिया क्रमिक रूप से तब तक चलती है जब तक कि प्रत्येक डेटा बिंदु केवल उसी बिंदु वाले विभाजन में अलग-थलग न हो जाए।
- यह देखा गया है कि अत्यधिक मान वाले असामान्य बिंदु सामान्य डेटा बिंदुओं की तुलना में कम पुनरावृत्तियों में अलग-थलग हो जाते हैं।
- लोकल आउटलायर फैक्टर वितरण के विभिन्न क्षेत्रों में बिंदुओं का घनत्व गणना करके असामान्य व्यवहार की पहचान करने की एक विधि है।
- जब ग्राहक व्यवहार डाटासेट को ग्राफिकल रूप में दर्शाया जाता है, तो यह घने क्लस्टर्स बनाता है, जिनमें से प्रत्येक एक ग्राहक समूह के अनुरूप होता है।
- किसी क्लस्टर में प्रत्येक डेटा बिंदु (ग्राहक) समान, परंतु एक समान नहीं, व्यवहार प्रदर्शित करता है। अक्सर देखा गया है कि धोखाधड़ी का डेटा भी एक ऐसा क्लस्टर बनाता है जो सामान्य ग्राहकों के क्लस्टर्स से अलग-थलग होता है।
इस तकनीक को और समझने के लिए Anomaly Detection in Python कोर्स देखें।
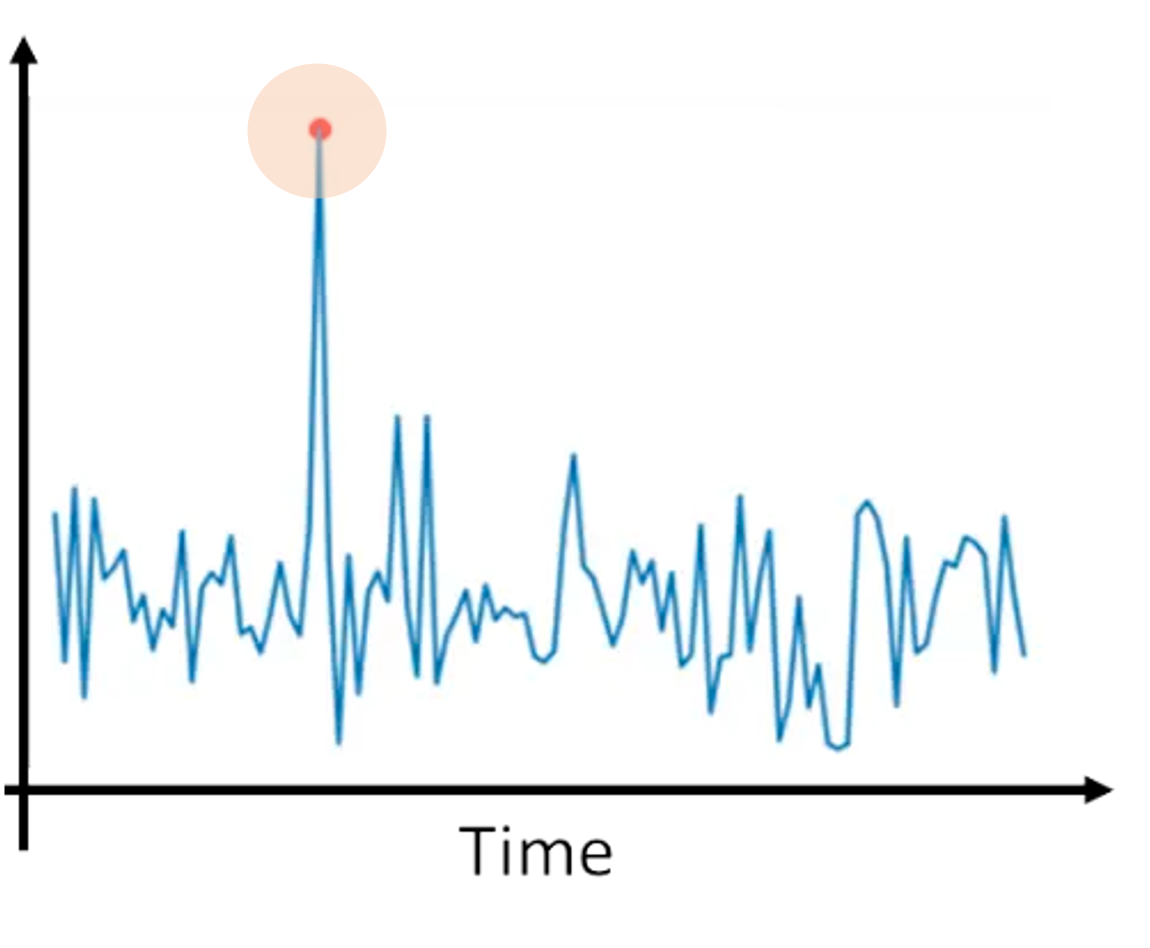
एनोमली डिटेक्शन का चित्रण। इमेज स्रोत: Understanding AI
सुपरवाइज़्ड मशीन लर्निंग
सुपरवाइज़्ड मशीन लर्निंग एनोमली डिटेक्शन की एक सिद्ध विधि है। मनुष्य ज्ञात पिछली धोखाधड़ी घटनाओं के आधार पर डाटासेट्स को लेबल करते हैं। इसके बाद मशीन लर्निंग एल्गोरिद्म लेबल्ड डाटासेट्स पर प्रशिक्षित किए जाते हैं ताकि नए लेन-देन के धोखाधड़ी होने की संभावना का पूर्वानुमान लगाया जा सके।
- लॉजिस्टिक रिग्रेशन यह भविष्यवाणी करता है कि कोई डेटा बिंदु दो समूहों में से किसमें आता है, जैसे वास्तविक और संभावित रूप से धोखाधड़ी वाला।
- ट्रेनिंग डाटासेट में प्रत्येक बिंदु को या तो धोखाधड़ी या वास्तविक के रूप में लेबल किया जाता है।
- ट्रेनिंग के दौरान, मॉडल फीचर्स में उन पैटर्न्स को सीखता है जो धोखाधड़ी लेन-देन की ओर संकेत करते हैं।
- नए डेटा पर, मॉडल यह अनुमान लगा सकता है कि डेटा बिंदु के धोखाधड़ी होने की कितनी संभावना है।
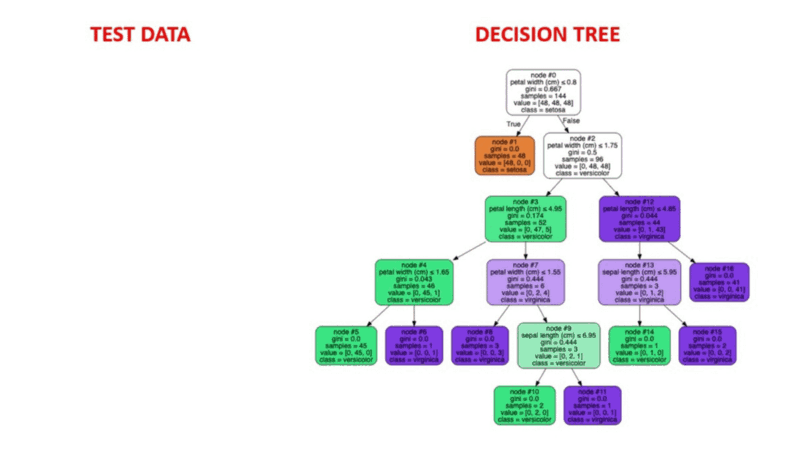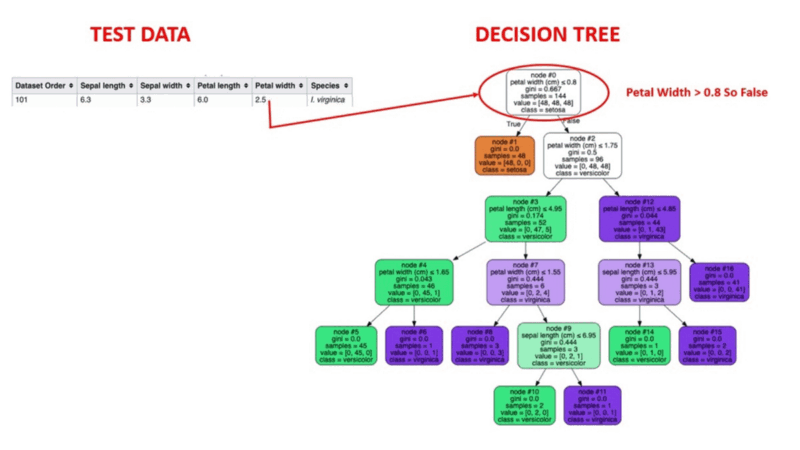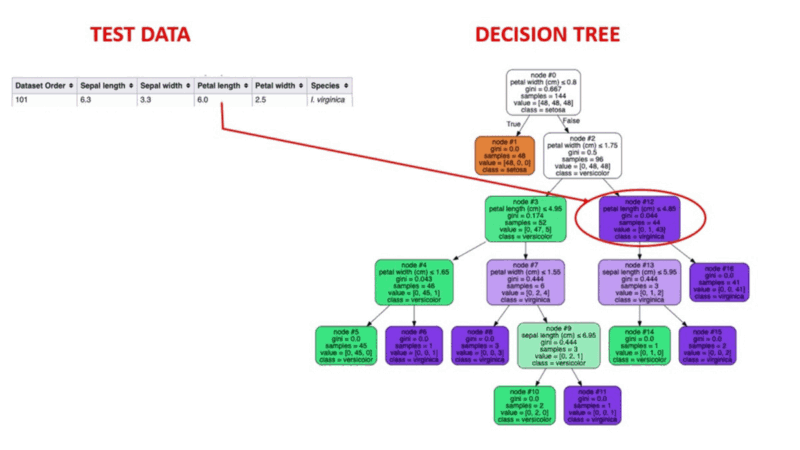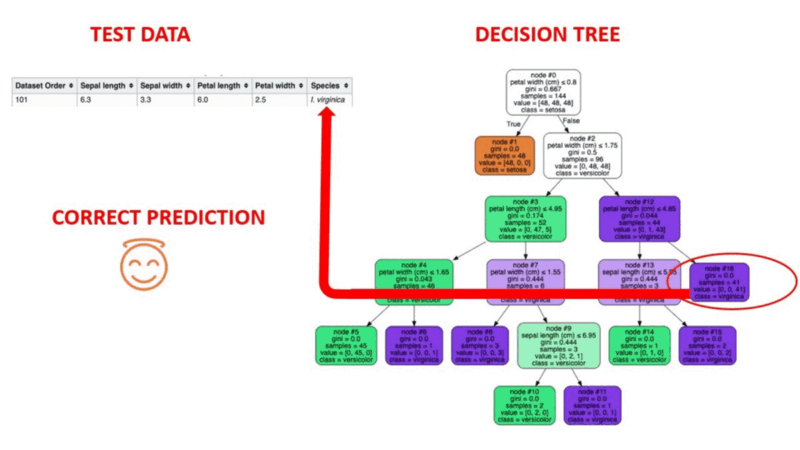
- डिसीजन ट्रीज़ डाटासेट को रिकर्सिव तरीके से उपसमूहों में विभाजित करते हैं। प्रत्येक नोड किसी एक विशेषता (जैसे लेन-देन की आवृत्ति या मासिक लेन-देन मात्रा) के मानों के अनुसार डेटा बिंदुओं को दो शाखाओं में बाँटता है।
- ऐसी कई परतों के बाद, प्रत्येक शाखा दो लीफ नोड्स पर समाप्त होती है - धोखाधड़ी और वास्तविक।
- ट्रेनिंग के दौरान, मॉडल सीखता है कि प्रत्येक नोड पर डाटासेट को कैसे विभाजित करना है।
- मॉडल इन नियमों के अनुसार प्रत्येक नए लेन-देन का वर्गीकरण करता है और यह अनुमान लगाता है कि उसके धोखाधड़ी या वास्तविक होने की संभावना क्या है।
- रैंडम फॉरेस्ट्स कई डिसीजन ट्रीज़ से मिलकर बनते हैं। एक डिसीजन ट्री if…else शर्तों की श्रृंखला लागू करता है ताकि तय किया जा सके कि लेन-देन धोखाधड़ी है या नहीं। ये if…else शर्तें डाटासेट की विशेषताओं पर आधारित होती हैं।
- रैंडम फॉरेस्ट में प्रत्येक ट्री को धोखाधड़ी लेन-देन की भविष्यवाणी करने के लिए फीचर्स के यादृच्छिक उपसमुच्चय का उपयोग करते हुए स्वतंत्र रूप से प्रशिक्षित किया जाता है।
- फॉरेस्ट की भविष्यवाणी सभी व्यक्तिगत ट्रीज़ के आउटपुट को एकत्रित करने पर आधारित होती है।
- यह दृष्टिकोण फीचर सेट के उपसमुच्चयों पर विचार करके डिसीजन ट्रीज़ में आम ओवरफिटिंग की समस्या से बचाता है।

डिसीजन ट्री कैसे काम करते हैं का एनिमेटेड चित्रण। इमेज स्रोत: Supervised Machine Learning
इन तकनीकों के बारे में और जानने के लिए Supervised Machine Learning in Python कोर्स ट्रैक देखें।
अनसुपरवाइज़्ड मशीन लर्निंग
सुपरवाइज़्ड मशीन लर्निंग एल्गोरिद्म, जो पिछले व्यवहारों के आधार पर भविष्यवाणी करते हैं, ठगों द्वारा नई विधियाँ अपनाने पर कम प्रभावी हो जाते हैं।
अनसुपरवाइज़्ड मशीन लर्निंग डेटा में अज्ञात पैटर्न्स की भविष्यवाणी करने में सहायक है। अनसुपरवाइज़्ड तरीकों का एक और लाभ यह है कि आपको बड़े डाटासेट्स को लेबल करने में मानव संसाधन खर्च नहीं करने पड़ते। एल्गोरिद्म स्वयं पैटर्न्स का पता लगाता है।
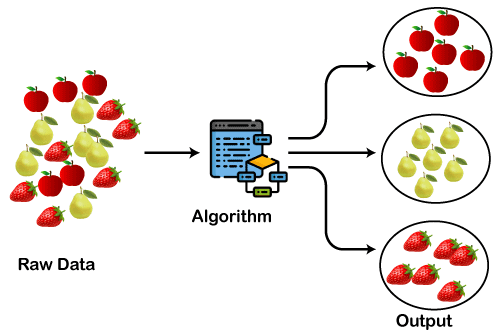
- K-means क्लस्टरिंग पूरे लेन-देन डाटासेट को विभिन्न विशेषताओं के मानों के आधार पर अलग-अलग क्लस्टर्स में समूहित करती है।
- प्रत्येक क्लस्टर के भीतर डेटा बिंदुओं के गुण समान होते हैं, जैसे लेन-देन की आवृत्ति। यह देखा जाता है कि धोखाधड़ी वाले लेन-देन अन्य बड़े क्लस्टर्स में नहीं आते।
- दृश्य रूप में, वे अन्य क्लस्टर्स से काफी दूर होते हैं। इन आउटलायर क्लस्टर्स का विश्लेषण करके संभावित धोखाधड़ी वाले लेन-देन की पहचान की जा सकती है।
- डेंसिटी-बेस्ड स्पैशियल क्लस्टरिंग ऑफ एप्लीकेशन्स विद नॉइज़ (DBSCAN) में लेन-देन डाटासेट्स को एक फीचर स्पेस में निरूपित किया जाता है। इस निरूपण में, डेटा बिंदु उच्च-घनत्व और निम्न-घनत्व क्षेत्रों में अलग हो जाते हैं।
- उच्च घनत्व वाले क्षेत्र क्लस्टर माने जाते हैं, और विरल क्षेत्र आउटलायर माने जाते हैं।
- विरल क्षेत्रों में आने वाले डेटा बिंदुओं को संभावित रूप से धोखाधड़ी वाला मानकर फ़्लैग किया जाता है। इसके बाद उन्हें संदिग्ध गतिविधि के आगे के प्रमाणों के लिए विश्लेषित किया जाता है।

क्लस्टरिंग कैसे काम करती है। इमेज स्रोत: Clustering in Machine Learning
उल्लेखित तकनीकों के बारे में और सीखने के लिए Unsupervised Learning in Python देखें।
नेटवर्क विश्लेषण
संदिग्ध व्यवहार के लिए पैटर्न मिलान द्वारा धोखाधड़ी का पारंपरिक पता लगाना व्यक्तिगत खातों के लिए प्रभावी है। हालाँकि, ठग अक्सर व्यक्तियों के समूहों के रूप में काम करते हैं जो उपकरणों, ईमेल अकाउंट्स और भौतिक पतों के सेट का उपयोग करते हैं, जिससे उस अकाउंट को अलगाव में देखने पर संदिग्ध व्यवहार का ट्रैक करना चुनौतीपूर्ण हो जाता है।
- फ्रॉड रिंग्स ऐसे व्यक्तियों के समूह होते हैं जो समन्वित हमलों में शामिल होते हैं। उदाहरण के लिए, रिंग के सदस्य दस अलग-अलग डिवाइस और IP पते का उपयोग करके दस लगातार लेन-देन कर सकते हैं। नेटवर्क विश्लेषण विभिन्न एंटिटीज़ के बीच संबंधों का पता लगाकर एंटिटी रिलेशनशिप मैप्स बनाता है और फ्रॉड रिंग्स की पहचान करता है।
- एंटिटी रिलेशनशिप मैप्स ग्राफ़-सदृश संरचनाएँ हैं जिनमें नोड्स एंटिटीज़ का प्रतिनिधित्व करते हैं और एजेज़ उनके संबंधों का। एंटिटीज़ व्यक्ति, अकाउंट्स, ईमेल IDs, डिवाइस IDs, IP पते, भौतिक पते आदि हो सकते हैं। एंटिटीज़ के बीच संबंध किसी भी समानता या समान व्यवहार को दर्शाते हैं, जैसे:
- कई IP पते एक ही चोरी किए गए भुगतान विवरण का उपयोग कर रहे हों।
- कई अकाउंट्स एक ही भौतिक पते पर धोखाधड़ीपूर्ण ऑर्डर दे रहे हों।
इन तकनीकों की गहरी समझ के लिए Introduction to Network Analysis in Python कोर्स देखें।
टेक्स्ट माइनिंग और नैचुरल लैंग्वेज प्रोसेसिंग (NLP)
कई प्रकार की धोखाधड़ी, जैसे फर्जी बीमा दावे, नकली ग्राहक समीक्षाएँ, फ़िशिंग ईमेल आदि, टेक्स्ट ब्लॉक्स पर आधारित होती हैं। इनके टेक्स्ट कंटेंट का विश्लेषण करना अक्सर वास्तविक ग्राहक गतिविधि और धोखाधड़ी के प्रयासों में भेद करने के संकेत देता है।
- नैचुरल लैंग्वेज प्रोसेसिंग (NLP) में सेंटिमेंट एनालिसिस और नेम्ड एंटिटी रिकग्निशन (NER) जैसी तकनीकें शामिल हैं। NLP निम्नलिखित अनुप्रयोगों में इस्तेमाल होता है:
- धोखाधड़ीपूर्ण बीमा दावों में अक्सर दावे के विवरण में असंगतियाँ होती हैं। NLP विरोधाभासी बयानों और असामान्य भाषा की पहचान कर सकता है, जबकि NER स्थानों, तिथियों और लोगों के बीच संबंधों की ओर इशारा कर सकता है।
- नकली ग्राहक समीक्षाएँ अक्सर एक ही उत्पाद के लिए विभिन्न अकाउंट्स द्वारा या एक ही अकाउंट द्वारा विभिन्न उत्पादों के लिए प्रस्तुत की जाती हैं। इन समीक्षाओं में समान भाषा होती है, जिसे सेंटिमेंट एनालिसिस और टोन डिटेक्शन से पहचाना जा सकता है।
- फ़िशिंग ईमेल और अन्य सोशल इंजीनियरिंग-आधारित हैकिंग प्रयास अक्सर संवेदनशील जानकारी निकालने के लिए समान भाषा पैटर्न का पालन करते हैं। ऐसे पैटर्न की पहचान करने और प्राप्तकर्ता को चेतावनी देने के लिए मानक NLP तरीके उपयोगी हैं।
- टेक्स्ट माइनिंग एल्गोरिद्म ईमेल, दावे, और समीक्षाओं जैसे असंरचित टेक्स्ट की बड़ी मात्रा को प्रोसेस करते हैं ताकि संदिग्ध भाषा पैटर्न्स और विशेष शब्दावलियों की आम घटनाओं का पता लगाया जा सके जो धोखाधड़ी गतिविधि में सामान्य हैं।
- टेक्स्ट माइनिंग के पीछे मुख्य मान्यता यह है कि अधिकांश धोखाधड़ी गतिविधियाँ सीमित संख्या की श्रेणियों में आती हैं और एक छोटे समूह द्वारा अंजाम दी जाती हैं। इसलिए, टेक्स्ट कंटेंट में पैटर्न्स खोजकर समानताओं की पहचान करना संभावित धोखाधड़ी प्रयासों को फ़्लैग करने की एक व्यावहारिक विधि है।
इस विषय की अधिक गहन समझ के लिए Natural Language Processing in Python स्किल ट्रैक देखें।
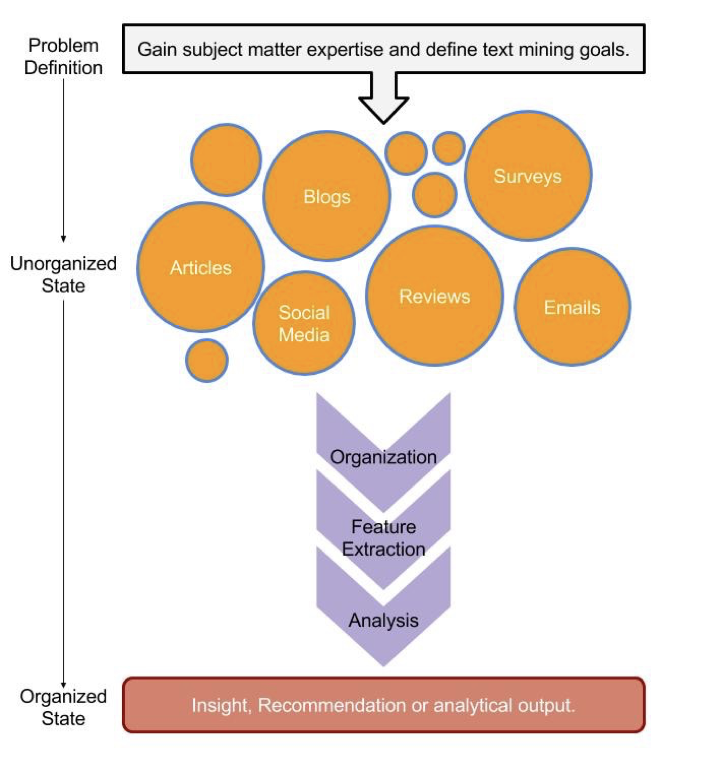
टेक्स्ट माइनिंग वर्कफ़्लो का चित्रण। इमेज स्रोत: Text Mining with Bag-of-Words in R
फ्रॉड डिटेक्शन वर्कफ़्लो
इस खंड में, हम फ्रॉड डिटेक्शन वर्कफ़्लोज़ को लागू करने के व्यावहारिक सिद्धांतों का उच्च-स्तरीय अवलोकन प्रस्तुत करते हैं।
डेटा संग्रह
सभी फ्रॉड डिटेक्शन एल्गोरिद्म बड़े डाटासेट्स में देखे गए पैटर्न्स का विश्लेषण और पहचान करने पर आधारित होते हैं। इसलिए, उच्च-गुणवत्ता, प्रासंगिक और क्यूरेटेड डाटासेट्स जैसे ट्रांज़ैक्शन लॉग्स और ग्राहक प्रोफाइल इन एल्गोरिद्म को प्रशिक्षित करने के लिए महत्वपूर्ण हैं।
- ट्रांज़ैक्शन लॉग्स का उपयोग ऐतिहासिक लेन-देन का विश्लेषण करने और राशि, मात्रा, आवृत्ति, IP पते, टाइमस्टैम्प्स आदि जैसे विवरणों के आधार पर पैटर्न्स खोजने के लिए किया जाता है।
- कस्टमर डेटाबेस में पते, भुगतान विवरण, ब्राउज़िंग हिस्ट्री, खरीद इतिहास, दी गई समीक्षाएँ, रिटर्न्स आदि शामिल होते हैं।
- थर्ड-पार्टी डेटा स्रोत आंतरिक डाटासेट्स के आधार पर अवलोकनों की पुष्टि करने और डेटा गुणवत्ता बढ़ाने में उपयोगी होते हैं।
डेटा प्रीप्रोसेसिंग
डेटा एकत्र करने के बाद, अगला तार्किक कदम इसका उपयोग करके फ्रॉड डिटेक्शन मॉडल्स को प्रशिक्षित करना है। कच्चा डेटा आमतौर पर मॉडल्स के प्रशिक्षण के लिए उपयुक्त नहीं होता। इसलिए, प्रशिक्षण डाटासेट के रूप में उपयोग से पहले डेटा की सफाई और सामान्यीकरण आवश्यक है। डेटा प्रीप्रोसेसिंग, फीचर इंजीनियरिंग के साथ मिलकर, इन चरणों को कवर करता है।
- डेटा क्लीनिंग मिसिंग वैल्यूज़, गलत फ़ॉर्मेटेड मान (उदा., टेक्स्ट के रूप में फ़ॉर्मेट किए गए नंबर), डुप्लिकेट रिकॉर्ड्स, गलत मान आदि को संबोधित करती है। ऐसे मानों को डाटासेट में छोड़ देने से मॉडल खराब प्रशिक्षित होता है। इसलिए, डेटा क्लीनिंग एक उपयोगी डाटासेट सुनिश्चित करने की पहली सीढ़ी है।
- डेटा नॉर्मलाइज़ेशन में संख्यात्मक मानों को एक समान स्केल पर व्यक्त करना शामिल है। इसमें अक्षर-आधारित रैंक्स को संख्यात्मक मानों में अनुवादित करना भी शामिल हो सकता है। जब डेटा स्रोतों को मिलाकर बड़ा डाटासेट बनाया जाता है, तब यह विशेष रूप से महत्वपूर्ण होता है।
- फीचर इंजीनियरिंग उपलब्ध जानकारी को अधिक उपयोगी रूपों में रूपांतरित करती है।
मॉडल प्रशिक्षण और मूल्यांकन
फ्रॉड एनालिटिक्स एल्गोरिद्म मूल रूप से मशीन लर्निंग तकनीकों पर आधारित होते हैं। ऐतिहासिक डेटा मशीन लर्निंग एल्गोरिद्म को प्रशिक्षित करने का आधार होता है। डेटा एकत्र और साफ़ करने के बाद, अगला कदम मॉडल्स को प्रशिक्षित करना है। प्रशिक्षण के दौरान, मॉडल सीखता है कि कौन से लेन-देन या उपयोगकर्ता प्रोफ़ाइल अधिक संभावना से धोखाधड़ी वाले हो सकते हैं।
संभावित रूप से धोखाधड़ी वाले व्यवहार को फ़्लैग करने के अलावा, नियमित उपयोगकर्ताओं को बाधित न करना भी उतना ही महत्वपूर्ण है। फॉल्स पॉज़िटिव वह स्थिति है जब मॉडल किसी वास्तविक लेन-देन को धोखाधड़ी के रूप में फ़्लैग कर देता है। अच्छे ग्राहक अनुभव को बनाए रखने के लिए फॉल्स पॉज़िटिव को कम करना ज़रूरी है। इसे सुनिश्चित करने के लिए प्रशिक्षित मॉडल का विभिन्न मैट्रिक्स के साथ मूल्यांकन किया जाता है।
रियल-टाइम फ्रॉड डिटेक्शन
धोखाधड़ी हो जाने के बाद ठग से चोरी हुए धन या सामान की वसूली करना अत्यधिक कठिन होता जाता है। इसलिए लक्ष्य यह है कि लेन-देन निष्पादित होने से पहले वास्तविक समय में धोखाधड़ी का पता लगाया और रोका जाए। ट्रांज़ैक्शन प्रोसेसिंग पाइपलाइन में फ्रॉड एनालिटिक्स को एकीकृत करना रियल-टाइम डिटेक्शन सक्षम करता है। यह दो तरीकों से किया जा सकता है:
- ट्रांज़ैक्शन पाइपलाइन से रियल-टाइम फ्रॉड एनालिटिक्स सिस्टम तक डेटा स्ट्रीम करना: इवेंट स्ट्रीमिंग टूल्स जैसे Apache Kafka रियल-टाइम ट्रांज़ैक्शन डेटा को फ्रॉड एनालिटिक्स सिस्टम तक भेजना सक्षम करते हैं। रियल-टाइम फ्रॉड एनालिटिक्स प्लेटफ़ॉर्म संदिग्ध लेन-देन को मानव सत्यापन के लिए फ़्लैग करता है। ट्रांज़ैक्शन प्रोसेसिंग पाइपलाइन भी लेन-देन को अंतिम रूप देने से पहले फ्रॉड एनालिटिक्स सिस्टम से पुष्टि प्राप्त करती है।
- ट्रांज़ैक्शन प्रोसेसिंग पाइपलाइन के भीतर फ्रॉड एनालिटिक्स लागू करना: यह Apache Flink जैसे टूल्स से किया जाता है। Flink डेटा स्ट्रीम्स पर इवेंट-टाइम प्रोसेसिंग क्षमताएँ प्रदान करता है, जो फ्रॉड एनालिटिक्स के संदर्भ में ट्रांज़ैक्शन डेटा का रियल-टाइम स्ट्रीम प्रोसेसिंग कहलाता है। यह मशीन लर्निंग मॉडल्स के साथ भी इंटीग्रेट होता है।
रिपोर्टिंग और मॉनिटरिंग
कंपनी प्रबंधन, डेटा वैज्ञानिक, कंप्लायंस अधिकारी, फ्रॉड विश्लेषक और सुरक्षा टीमें चल रहे फ्रॉड डिटेक्शन प्रयासों के परिणामों की निगरानी करते हैं। डैशबोर्ड, रियल-टाइम अलर्ट्स और स्वचालित रिपोर्ट्स जैसे टूल्स मॉनिटरिंग और सुपरविजन को सुगम बनाते हैं।
- डैशबोर्ड्स महत्वपूर्ण मीट्रिक्स को दृश्य रूप में प्रदर्शित करते हैं, जैसे धोखाधड़ी लेन-देन की संख्या, फ्रॉड एनालिटिक्स टूल्स की सफलताएँ और विफलताएँ, हुई धन हानि आदि। विस्तृत रिपोर्टों में गए बिना मुख्य जानकारी को हाइलाइट करना डैशबोर्ड्स से आसान हो जाता है।
- जब सॉफ़्टवेयर धोखाधड़ी गतिविधि का संदेह करता है, तो वह रियल-टाइम अलर्ट्स भेजता है ताकि ट्रांज़ैक्शन मॉनिटरिंग के प्रभारी लोगों को सूचित किया जा सके। सभी एल्गोरिद्मिक भविष्यवाणियों का एक निश्चित कॉन्फिडेंस स्तर होता है—कई मामलों में, निर्णय लेने के लिए मानव निर्णय आवश्यक होता है। साथ ही, कुछ मामलों में आगे के नुकसान को रोकने के लिए सुधारात्मक उपाय ज़रूरी होते हैं, जैसे चोरी होने के संदेह वाले कार्ड पर लेन-देन रोकना। रियल-टाइम अपडेट ऐसे प्रक्रियाओं में तेजी लाते हैं।
- स्वचालित रिपोर्ट्स समय-समय पर फ्रॉड एनालिटिक्स टूल्स की गतिविधियों की जानकारी एकत्रित करती हैं। ये उनके प्रदर्शन की निगरानी और आवश्यक होने पर हस्तक्षेप में सहायक होती हैं।
- ग्राहक सूचनाएँ ग्राहकों को सूचित करती हैं जब उनके खातों पर धोखाधड़ी गतिविधि का संदेह होता है। कभी-कभी एनालिटिक्स सॉफ़्टवेयर वास्तविक ग्राहक गतिविधि को गलती से संभावित धोखाधड़ी के रूप में पहचान लेता है। ऐसे लेन-देन को प्रोसेस करने से पहले ग्राहक से मैन्युअल पुष्टि लेना आवश्यक होता है। अन्य मामलों में, यह सूचित करना महत्वपूर्ण है कि संदिग्ध गतिविधि के कारण उनका अकाउंट निलंबित कर दिया गया है और उसे पुन: सक्रिय करने की आवश्यकता है।
फ्रॉड एनालिटिक्स के लिए टूल्स और प्लेटफ़ॉर्म
फ्रॉड एनालिटिक्स के महत्व और व्यापक उपयोग को देखते हुए, इस क्षेत्र में कई सॉफ़्टवेयर प्रोग्राम उपयोग किए जाते हैं। इनमें ओपन-सोर्स टूल्स के साथ-साथ स्वामित्व वाले सिस्टम भी शामिल हैं। इस खंड में, हम फ्रॉड एनालिटिक्स में उपयोग होने वाले सबसे आम टूल्स और प्लेटफ़ॉर्म्स का एक अवलोकन प्रस्तुत करते हैं।
Python, SQL, और R
ग्राहक डेटा और ट्रांज़ैक्शन लॉग्स आमतौर पर रिलेशनल डेटा स्टोर्स में संग्रहीत होते हैं।
- SQL प्रासंगिक डाटासेट्स निकालने के लिए एक शक्तिशाली और लचीला टूल है। यह डेवलपर्स को विभिन्न मानदंडों को पूरा करने वाले डाटासेट्स लाने के लिए क्वेरी लिखने और ऑप्टिमाइज़ करने की अनुमति देता है। इन डाटासेट्स का विश्लेषण संभावित रूप से धोखाधड़ी गतिविधि की ओर संकेत करने वाले रुझानों और पैटर्न्स की खोज के लिए किया जाता है।
- Python, अपनी विशाल लाइब्रेरी इकोसिस्टम और बड़े डेवलपर समुदाय के कारण, अक्सर विभिन्न एनालिटिक्स एल्गोरिद्म बनाने और परीक्षण करने के लिए पसंदीदा टूल होता है। व्यापक रूप से, Python का उपयोग कई वित्त-आधारित अनुप्रयोगों में भी होता है।
- कई फ्रॉड डिटेक्शन विधियों के केंद्र में सांख्यिकीय विश्लेषण होता है। इसलिए, R, अपनी बड़ी सांख्यिकीय फ़ंक्शन लाइब्रेरी के साथ, धोखाधड़ी का पता लगाने के लिए विभिन्न तरह के एड-हॉक डेटा विश्लेषणों के लिए उपयुक्त है।
इस प्रकार, Python, SQL, और R डेवलपर्स को अपने कस्टम फ्रॉड एनालिटिक्स सिस्टम बनाने के लिए उपयुक्त टूलसेट देते हैं। हालाँकि, ये टूल्स बड़े डाटासेट्स को कुशलता से प्रोसेस करने में संघर्ष कर सकते हैं। एनालिटिक्स सिस्टम्स के इंप्लीमेंटेशन में अक्सर Apache Spark (नीचे चर्चा) जैसे अन्य विशेष सॉफ़्टवेयर का उपयोग किया जाता है।
इसके अतिरिक्त, Python और SQL पर बने टूल्स फ्रॉड विश्लेषकों और कंप्लायंस अधिकारियों जैसे गैर-तकनीकी दर्शकों के लिए उपयुक्त नहीं हो सकते। SAS (आगे चर्चा) जैसे थर्ड-पार्टी टूल्स का उपयोग करके एकीकृत समाधान उपलब्ध कराना आम है।
Apache Spark
कई फ्रॉड एनालिटिक्स तकनीकें ट्रांज़ैक्शन लॉग्स और ग्राहक डाटासेट्स पर प्रशिक्षित मशीन लर्निंग एल्गोरिद्म पर आधारित होती हैं। वास्तविक समय में पैटर्न्स का पता लगाने के लिए बड़े पैमाने पर डेटा प्रोसेसिंग आवश्यक है। उदाहरण के लिए, क्रेडिट कार्ड प्रोसेसर्स प्रतिदिन लाखों लेन-देन संभालते हैं। किसी फ्रॉड रिंग का पता लगाने के लिए, एनालिटिक्स सिस्टम को कई दिनों के ट्रांज़ैक्शन डेटा को कुशलता से प्रोसेस करना चाहिए।
Apache Spark एक ओपन-सोर्स डेटा प्रोसेसिंग इंजन है जो क्लस्टर्स में क्षैतिज रूप से स्केल करता है। इन-मेमोरी कंप्यूटिंग क्षमता के कारण, यह बैच प्रोसेसिंग का सहारा लिए बिना बड़े डाटासेट्स को संभाल सकता है।
यह Cassandra और Amazon S3 जैसे कई डेटा स्रोतों से इनपुट डेटा स्वीकार करता है। यह Python और Java सहित कई भाषाओं में APIs भी प्रदान करता है। इस प्रकार, यह फ्रॉड एनालिटिक्स जैसे बिग डेटा उपयोग मामलों के लिए विशेष रूप से उपयुक्त है।
इस शक्तिशाली डेटा प्रोसेसिंग भाषा को सीखने के लिए Introduction to PySpark कोर्स देखें।
Tableau और Power BI
फ्रॉड एनालिटिक्स में बड़े डाटासेट्स और जटिल विश्लेषण शामिल होते हैं। विज़ुअलाइज़ेशन इंसानों के लिए इस जानकारी को तेज़ी से और आसानी से समझना संभव बनाते हैं। Tableau और Power BI ऐसे डेटा विज़ुअलाइज़ेशन टूल्स हैं जो विभिन्न डेटा स्रोतों के साथ इंटरफ़ेस कर सकते हैं। इनका उपयोग रिपोर्टिंग और विश्लेषण दोनों कार्यों के लिए होता है।
- ये टूल्स इंटरैक्टिव डैशबोर्ड्स बनाते हैं जो रुझान, सफलता और विफलता दर, हानि राशि और लेन-देन मात्रा जैसे महत्वपूर्ण मीट्रिक्स की रिपोर्ट करते हैं। विज़ुअलाइज़ेशन इस जानकारी को धोखाधड़ी के अलग-अलग प्रकारों और भौगोलिक क्षेत्रों के अनुसार भी वर्गीकृत कर सकते हैं।
- रिपोर्टिंग के अलावा, Power BI और Tableau संभावित फ्रॉड रिंग्स, नेटवर्क विश्लेषण और विभिन्न संभावनाओं के बारे में जानकारी को दृश्य रूप में प्रस्तुत करके फ्रॉड विश्लेषण में भी सहायक होते हैं।
- ये टूल्स विश्लेषकों को विभिन्न फ़िल्टर, डिटेक्शन मानदंड और कॉन्फिडेंस लेवल्स को दृश्य रूप में नियंत्रित करने की अनुमति भी देते हैं। इससे यह त्वरित निर्णय लेने में मदद मिलती है कि कोई लेन-देन वास्तविक है या धोखाधड़ी वाला।
ये टूल्स सामान्य-उद्देश्य विज़ुअलाइज़ेशन टूल्स के रूप में डिज़ाइन किए गए हैं जिनमें फ्रॉड एनालिटिक्स के लिए विशिष्ट मॉड्यूल और यूज़र इंटरफेस हैं। आप आज ही PowerBI Fundamentals स्किल ट्रैक का अनुसरण करके PowerBI सीखना शुरू कर सकते हैं।
SAS Fraud Management
SAS, SAS Institute द्वारा बनाया गया एक सांख्यिकीय सॉफ़्टवेयर सूट है। यह संस्थान विभिन्न अनुप्रयोगों, जिनमें फ्रॉड एनालिटिक्स भी शामिल है, के लिए डोमेन-विशिष्ट पैकेज भी बनाता है।
SAS Fraud Management सांख्यिकीय तकनीकों और मशीन लर्निंग एल्गोरिद्म का उपयोग करके धोखाधड़ी की भविष्यवाणी और रोकथाम करता है। इन एल्गोरिद्म को इस तरह उत्पादित किया गया है कि फ्रॉड विश्लेषक और कंप्लायंस अधिकारी जैसे लोग, जिनकी मशीन लर्निंग में पृष्ठभूमि नहीं है, वे भी फ्रॉड डिटेक्शन के लिए ML और सांख्यिकीय तरीकों का उपयोग कर सकें।
H2O.ai
H2O.ai एक स्वचालित क्लाउड-आधारित मशीन लर्निंग सेवा प्रदान करता है। H2O.ai का सॉफ़्टवेयर संभावित रूप से धोखाधड़ी वाली गतिविधि को फ़्लैग करता है, धोखाधड़ी की संभावना का स्कोर देता है और एक कारण कोड असाइन करता है जो बताता है कि एल्गोरिद्म को धोखाधड़ी का संदेह क्यों है।
ये दिशानिर्देश मानव अन्वेषकों को गहराई से जाँच करने में मदद करते हैं ताकि लेन-देन की पुष्टि की जा सके। कई मामलों में, वे वास्तविक लेन-देन को हरी झंडी देने में भी मदद करते हैं ताकि उनकी प्रोसेसिंग तेज़ हो सके।
IBM Safer Payments
IBM Safer Payments भुगतान उद्योग के लिए विशेष रूप से लक्षित एक फ्रॉड डिटेक्शन सिस्टम है।
क्योंकि यह NoSQL इन-मेमोरी डेटाबेस का उपयोग करता है, यह रियल-टाइम में भुगतान की निगरानी कर सकता है। यह नकदीरहित भुगतान प्रणालियों, जैसे क्रेडिट कार्ड भुगतान, में लेन-देन स्ट्रीम्स का वास्तविक समय में विश्लेषण करके और संभावित धोखाधड़ी वाले लेन-देन को निष्पादन से पहले ब्लॉक करके धोखाधड़ी को रोकता है।
निष्कर्ष
इस लेख में विभिन्न प्रकार की धोखाधड़ी और उन्हें पहचानने व रोकने में फ्रॉड एनालिटिक्स की भूमिका का अवलोकन प्रस्तुत किया गया। इसमें संभावित धोखाधड़ी मामलों का पता लगाने के लिए आमतौर पर उपयोग की जाने वाली तकनीकों और फ्रॉड डिटेक्शन वर्कफ़्लो पर चर्चा की गई। अंत में, इस डोमेन में आम तौर पर उपयोग होने वाले कुछ सॉफ़्टवेयर अनुप्रयोगों का परिचय कराया गया।
Python का उपयोग करके फ्रॉड डिटेक्शन सिस्टम बनाना सीखने के लिए Fraud Detection in Python कोर्स देखें। वित्त अनुप्रयोगों के लिए Python का व्यापक परिचय पाने के लिए Introduction to Python for Finance कोर्स का अनुसरण करें। फ्रॉड डिटेक्शन अनुप्रयोगों में उपयोग होने वाले R के सांख्यिकीय फ़ंक्शंस के बारे में अधिक जानने के लिए Fraud Detection in R कोर्स देखें।
FAQs
क्या फ्रॉड एनालिटिक्स धोखाधड़ी को पूरी तरह खत्म कर सकता है?
नहीं, फ्रॉड एनालिटिक्स धोखाधड़ी को काफी हद तक घटाता है लेकिन इसे पूरी तरह समाप्त नहीं कर सकता। यह उच्च-जोखिम वाले लेन-देन को फ़्लैग करता है, पर मानवीय निगरानी अभी भी आवश्यक है।
व्यवसाय वास्तविक समय में फ़्लैग किए गए लेन-देन को कैसे संभालते हैं?
फ़्लैग किए गए लेन-देन की अक्सर मानव अन्वेषकों द्वारा समीक्षा की जाती है। स्वचालित सिस्टम भी आगे की समीक्षा तक संदिग्ध लेन-देन को ब्लॉक कर सकते हैं।
प्रभावी फ्रॉड डिटेक्शन के लिए कौन सा डेटा महत्वपूर्ण है?
मुख्य डेटा में ट्रांज़ैक्शन लॉग्स, ग्राहक प्रोफाइल, थर्ड-पार्टी वैलिडेशन स्रोत, और डिवाइस डेटा शामिल हैं। उच्च-गुणवत्ता, स्वच्छ डेटा डिटेक्शन की सटीकता में सुधार करता है।
अनसुपरवाइज़्ड मशीन लर्निंग मॉडल नई धोखाधड़ी प्रवृत्तियों के साथ कैसे विकसित होते हैं?
अनसुपरवाइज़्ड मॉडल अज्ञात पैटर्न और विसंगतियों की पहचान करके नए व्यवहारों के अनुकूल होते रहते हैं, जिससे उभरती धोखाधड़ी विधियों का पता लगाने में वे अधिक प्रभावी होते हैं।
फ्रॉड डिटेक्शन सिस्टम गति और सटीकता में संतुलन कैसे बनाते हैं?
सिस्टम Apache Flink जैसे रियल-टाइम डेटा प्रोसेसिंग टूल्स का उपयोग करके तुरंत लेन-देन का विश्लेषण करते हैं और समय के साथ एल्गोरिद्म को परिष्कृत करके फॉल्स पॉज़िटिव को कम करते हुए सटीकता बनाए रखते हैं।
अरुण एक पूर्व स्टार्टअप संस्थापक हैं जो नई चीज़ें बनाना पसंद करते हैं। वे वर्तमान में कृत्रिम बुद्धिमत्ता की तकनीकी और गणितीय नींव का अन्वेषण कर रहे हैं। उन्हें जो सीखा है उसे साझा करना अच्छा लगता है, इसलिए वे इस पर लिखते हैं।
DataCamp के अलावा, आप उनके प्रकाशन Medium, Airbyte, और Vultr पर पढ़ सकते हैं।
