
Các dạng gian lận phổ biến được phát hiện qua phân tích
Phần này khám phá các nhóm lớn của giao dịch gian lận, thảo luận những ví dụ thường gặp trong mỗi nhóm và cách dùng công cụ phân tích để phát hiện, ngăn chặn.
Gian lận tài chính
Gian lận tài chính có lẽ là dạng phổ biến và lan rộng nhất. Nạn nhân thường là các tổ chức tài chính và khách hàng của họ. Thủ phạm thường giả mạo là khách hàng hoặc đại diện của tổ chức tài chính.
Gian lận thẻ tín dụng là sử dụng trái phép thẻ để mua hàng hoặc rút tiền tại ATM. Phần lớn là dùng thông tin thẻ bị đánh cắp. Phân tích gian lận có thể giúp phát hiện bằng cách tìm các mẫu phổ biến như:
- Đột ngột tăng mạnh tần suất và giá trị giao dịch.
- Các giao dịch liên tiếp tại nhiều địa điểm khác nhau.
Đánh cắp danh tính xảy ra khi thông tin cá nhân (như số tài khoản ngân hàng, số ID do chính phủ cấp, mật khẩu email, v.v.) bị đánh cắp. Thông tin này có thể được dùng để mạo danh cá nhân nhằm vay tiền, mở thấu chi và thực hiện các giao dịch tài chính lớn khác. Phân tích gian lận giúp bằng cách gắn cờ hành vi đáng ngờ như:
- Mở nhiều tài khoản trong thời gian ngắn.
- Lệch khỏi hành vi đã biết trước đây của cá nhân.
Gian lận thanh toán là sử dụng thủ đoạn để thuyết phục cá nhân hoặc doanh nghiệp thanh toán cho thứ họ không mua. Bao gồm:
- Gửi hóa đơn giả cho công ty.
- Gửi tin nhắn xác thực đa yếu tố giả để xác nhận khoản thanh toán đang chờ xử lý.
- Giả mạo nhân viên ngân hàng để khai thác thông tin bí mật liên quan đến tài khoản.
Phân tích có thể hỗ trợ gian lận thanh toán bằng cách theo dõi và gắn cờ các giao dịch:
- Lệch đáng kể so với hành vi và hoạt động thanh toán thông thường của tài khoản.
- Phát sinh từ địa chỉ IP và ID thiết bị đáng ngờ.
Gian lận bảo hiểm
Gian lận bảo hiểm bao gồm yêu cầu bồi thường lớn cho sự cố nhỏ và trả phí thấp cho hợp đồng rủi ro. Nạn nhân thường là công ty bảo hiểm, còn thủ phạm giả làm khách hàng hoặc đại lý bảo hiểm.
Khai man yêu cầu bồi thường về những tai nạn không hề xảy ra. Để phát hiện các yêu cầu như vậy, công cụ phân tích sẽ:
- Đối chiếu sự kiện được báo cáo, như thiên tai hoặc tai nạn giao thông, với các nguồn khác để xác minh tính xác thực.
- Phân tích mô hình trong các yêu cầu do những cá nhân nhất định hoặc tại địa điểm cụ thể gửi.
Thổi phồng yêu cầu bồi thường là phóng đại mức độ thiệt hại và số tiền yêu cầu trong các sự cố nhỏ. Công cụ phân tích gian lận có thể giảm thiểu tình trạng này bằng cách:
- Ước tính mức đòi bồi thường điển hình cho các loại tai nạn khác nhau dựa trên dữ liệu lịch sử.
- Đối chiếu tai nạn được báo cáo với mức yêu cầu bồi thường điển hình cho loại tai nạn đó.
Giám định viên bảo hiểm sẽ xác minh thủ công các yêu cầu có khả năng bị thổi phồng.
Trốn phí bảo hiểm là cung cấp thông tin sai cho công ty bảo hiểm để cố tình giảm hồ sơ rủi ro và trả phí thấp hơn cho một hợp đồng cụ thể. Công cụ phân tích có thể giúp:
- Xác thực thông tin trong hồ sơ hợp đồng với các nguồn khác.
- Phát hiện các mẫu thường gặp trong hành vi trốn phí. Ví dụ, nếu một mẫu xe thường dùng để kinh doanh lại được bảo hiểm cho mục đích cá nhân, công cụ sẽ gắn cờ để điều tra thêm.
Hợp đồng giả là hợp đồng giả mạo do kẻ lừa đảo giả làm đại lý bảo hiểm tạo và bán. Khách hàng chỉ phát hiện khi nộp yêu cầu bồi thường. Phần mềm phân tích gian lận phát hiện hợp đồng giả bằng cách:
- Đối chiếu chi tiết hợp đồng lưu trong hệ thống với thông tin khách hàng cung cấp.
Các công ty bảo hiểm cũng có trách nhiệm xã hội trong việc xác định các mô hình hợp đồng giả phát hành dưới tên họ. Trình bày các phân tích này cho cơ quan thực thi pháp luật giúp triệt phá đường dây hợp đồng giả.
Gian lận y tế
Gian lận y tế có thể xảy ra ở bất kỳ phần nào của hệ thống y tế, bao gồm cả bảo hiểm y tế công. Nạn nhân là bên chi trả, có thể là một hoặc nhiều nhóm:
- Bệnh nhân
- Người sử dụng lao động của bệnh nhân trong chương trình đồng chi trả
- Chính phủ trong hệ thống y tế công
- Công ty bảo hiểm
Thủ phạm thường là nhà cung cấp dịch vụ y tế hoặc bệnh nhân. Gian lận y tế thường được thực hiện thông qua khai man, bao gồm tính phí dịch vụ không thực hiện và tăng mã dịch vụ (upcoding).
Tính phí dịch vụ không thực hiện là việc thu tiền các dịch vụ (như xét nghiệm, điều trị) không thực hiện cho bệnh nhân. Để phát hiện kiểu gian lận này, công cụ phân tích có thể:
- Dùng nhận dạng mẫu để so sánh hóa đơn với số tiền và hạng mục thường được các đơn vị cùng ngành tính cho triệu chứng tương tự.
- Đối chiếu dịch vụ trên hóa đơn với nhật ký dịch vụ của nhà cung cấp và hồ sơ điều trị của bệnh nhân.
- Xác định các nhà cung cấp có lịch sử tính phí bất thường cao và kiểm tra kỹ hồ sơ của họ.
Upcoding là hành vi tính phí theo hạng mục dịch vụ đắt tiền hơn so với thực tế. Công cụ phân tích gian lận dùng nhiều phương pháp để phát hiện upcoding, ví dụ:
- Phân tích thống kê để so sánh tỷ lệ giữa xét nghiệm thường quy và xét nghiệm/điều trị đắt tiền so với chuẩn ngành. Ví dụ, nhà cung cấp chủ yếu tính phí khám kéo dài và rất ít khám thường là đáng nghi.
- So sánh hóa đơn với hồ sơ bệnh nhân và bệnh viện thường có chi tiết thủ thuật hoặc xét nghiệm thực hiện.
- So sánh số tiền tính với dữ liệu lịch sử của nhà cung cấp để kiểm tra việc tăng đột biến ở các hạng mục tăng mã cụ thể.
Gian lận thương mại điện tử và bán lẻ
Nhiều người bán trên sàn thương mại điện tử là doanh nghiệp nhỏ và vừa, không nhất thiết am hiểu công nghệ. Vì thế, trách nhiệm thuộc về nền tảng thương mại điện tử trong việc phát hiện và kiềm chế gian lận. Gian lận TMĐT và bán lẻ có thể xảy ra dưới nhiều hình thức:
Chiếm đoạt tài khoản là khi người dùng mất quyền kiểm soát tài khoản vào tay kẻ gian, những kẻ này lạm dụng để thực hiện mua hàng trái phép. Điều này thường do lỗi người dùng hoặc lơ là bảo mật như mật khẩu và lừa đảo qua email.
Nền tảng TMĐT có thể phát hiện chiếm đoạt tài khoản bằng các kỹ thuật như:
- Phân tích hành vi để kiểm tra lệch khỏi hành vi điển hình như thời gian đăng nhập, nhóm hàng mua, lịch sử duyệt, v.v.
- Hoạt động bất thường (như nhiều lần đăng nhập thất bại) kết hợp với thay đổi cài đặt tài khoản (như email và địa chỉ giao hàng).
Hoàn trả giả mạo xảy ra khi đối tượng xấu trả lại sản phẩm khác với sản phẩm đã mua, như đặt hàng đắt tiền rồi trả hàng giả. Cũng bao gồm trả lại hàng đã qua sử dụng không thể bán lại. Để bảo vệ khỏi hoàn trả giả mạo, phân tích gian lận có thể:
- Phân tích mô hình hoàn trả để xác định người mua thường xuyên trả hàng.
- Đối chiếu đơn mua gốc để xác minh sản phẩm trả lại đúng với sản phẩm đã mua.
- Đảm bảo sản phẩm trả lại còn nguyên tình trạng chưa sử dụng.
Mua hàng gian lận liên quan đến giao dịch trái phép dùng thông tin thanh toán bị đánh cắp/giả mạo và tài khoản bị xâm phạm. Điều này có thể gây thiệt hại cho cả người bán và người mua không hay biết. Phân tích gian lận có thể gắn cờ mua hàng tiềm ẩn gian lận bằng cách theo dõi giao dịch để nhận diện các mẫu như:
- Nhiều tài khoản đăng nhập thường xuyên từ cùng một địa chỉ IP.
- Thử nhiều số thẻ tín dụng liên tiếp trong thời gian rất ngắn.
- Các đơn hàng có giá trị bất thường lớn so với lịch sử tài khoản.
Gian lận chargeback là lợi dụng chính sách hoàn bồi (chargeback) của thẻ tín dụng để đòi hoàn tiền cho các giao dịch hợp pháp. Phân tích gian lận có thể bảo vệ trước hành vi này bằng cách dùng:
- Nhận dạng mẫu để xác định người dùng thường xuyên yêu cầu chargeback.
- Học máy để phát hiện hành vi đáng ngờ như nhiều lần mua liên tiếp trong thời gian ngắn, đặc biệt với tài khoản mới và thông tin thanh toán vừa cập nhật.
Các kỹ thuật dùng trong phân tích gian lận
Công cụ phân tích gian lận dùng một tập kỹ thuật chung, được điều chỉnh cho từng ngữ cảnh, bộ dữ liệu và hành vi của kẻ gian trong từng lĩnh vực.
Mọi phương pháp phân tích gian lận đều có hai mục tiêu then chốt:
- Phát hiện và ngăn chặn gian lận
- Tạo thuận lợi cho khách hàng chân chính
Phát hiện bất thường
Kẻ gian thường thể hiện hành vi khác biệt đáng kể so với khách hàng hợp pháp. Phát hiện bất thường giúp xác định hành vi bất thường gợi ý hoạt động gian lận tiềm ẩn. Nó bao gồm nhiều phương pháp:
- Phát hiện ngoại lai thống kê giúp nhận diện các điểm dữ liệu khác biệt đáng kể so với phần còn lại của phân phối. Hành vi đáng ngờ thường được chỉ báo bởi các giá trị ngoại lai ở nhiều chỉ số, như:
- Tần suất giao dịch mỗi giờ.
- Số mã bưu chính nơi thẻ được quẹt trong một ngày.
- Rừng cô lập (Isolation Forests) gồm nhiều cây cô lập. Mỗi cây hoạt động như sau:
- Chọn ngẫu nhiên một thuộc tính của dữ liệu và phân tách ngẫu nhiên các điểm dữ liệu dựa trên giá trị của thuộc tính đó.
- Với mỗi phần tách, chọn một thuộc tính ngẫu nhiên khác và tiếp tục phân tách.
- Quá trình lặp lại cho đến khi mỗi điểm dữ liệu được cô lập vào một phần chỉ có điểm đó.
- Quan sát thấy các điểm bất thường với giá trị cực đoan được cô lập (vào phần riêng lẻ) với ít vòng lặp hơn so với điểm dữ liệu bình thường.
- Hệ số ngoại lai cục bộ (Local Outlier Factor) là phương pháp nhận diện hành vi bất thường bằng cách tính mật độ điểm ở các vùng khác nhau của phân phối.
- Khi biểu diễn dữ liệu hành vi khách hàng một cách trực quan, nó tạo thành các cụm dày đặc, mỗi cụm tương ứng với một nhóm khách hàng.
- Mỗi điểm (khách hàng) trong cụm thể hiện hành vi tương tự nhưng không trùng khít. Thường quan sát thấy dữ liệu gian lận cũng tạo thành một cụm tách biệt khỏi các cụm khách hàng bình thường.
Xem khóa học Phát Hiện Bất Thường Trong Python để hiểu sâu hơn kỹ thuật này.
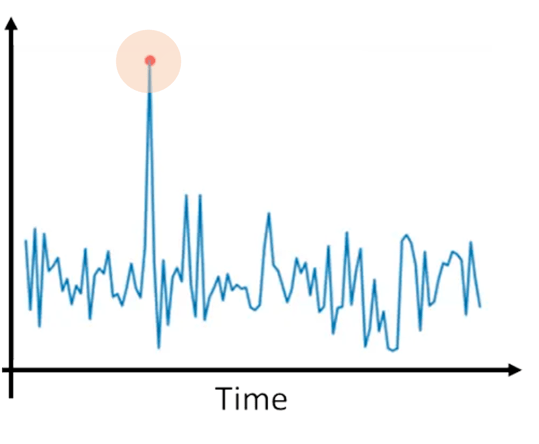
Minh họa phát hiện bất thường. Nguồn ảnh: Understanding AI
Học máy có giám sát
Học máy có giám sát là phương pháp đã được kiểm chứng để phát hiện bất thường. Con người gán nhãn bộ dữ liệu dựa trên các trường hợp hành vi gian lận đã biết trong quá khứ. Thuật toán học máy sau đó được huấn luyện trên dữ liệu gán nhãn để dự đoán khả năng một giao dịch mới là gian lận.
- Hồi quy logistic dự đoán xác suất một điểm dữ liệu thuộc một trong hai nhóm, như hợp pháp và có khả năng gian lận.
- Mỗi điểm trong tập huấn luyện được gán nhãn là gian lận hoặc hợp pháp.
- Trong huấn luyện, mô hình học các mẫu trong đặc trưng chỉ ra giao dịch gian lận.
- Khi gặp dữ liệu mới, mô hình dự đoán khả năng điểm dữ liệu là gian lận.
- Cây quyết định chia đệ quy tập dữ liệu thành các tập con. Mỗi nút chia điểm dữ liệu thành hai nhánh theo giá trị của một thuộc tính cụ thể (như tần suất giao dịch hoặc tổng giá trị giao dịch hàng tháng).
- Sau một loạt phép chia, mỗi nhánh kết thúc ở hai nút lá - gian lận và hợp pháp.
- Trong huấn luyện, mô hình học các quy tắc cho mỗi nút để chia tập dữ liệu.
- Mô hình phân loại mỗi giao dịch mới theo các quy tắc này và dự đoán khả năng gian lận hay hợp pháp.
- Rừng ngẫu nhiên gồm nhiều cây quyết định. Một cây áp dụng chuỗi điều kiện if…else để quyết định giao dịch có gian lận hay không. Các điều kiện if…else dựa trên đặc trưng của tập dữ liệu.
- Mỗi cây trong rừng ngẫu nhiên được huấn luyện độc lập, sử dụng một tập con đặc trưng ngẫu nhiên để dự đoán giao dịch gian lận.
- Dự đoán của rừng dựa trên việc tổng hợp đầu ra của tất cả cây riêng lẻ.
- Cách tiếp cận này tránh vấn đề quá khớp phổ biến ở cây quyết định bằng việc chỉ xét các tập con đặc trưng.
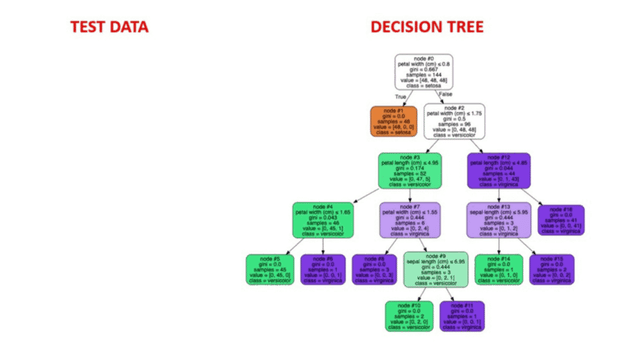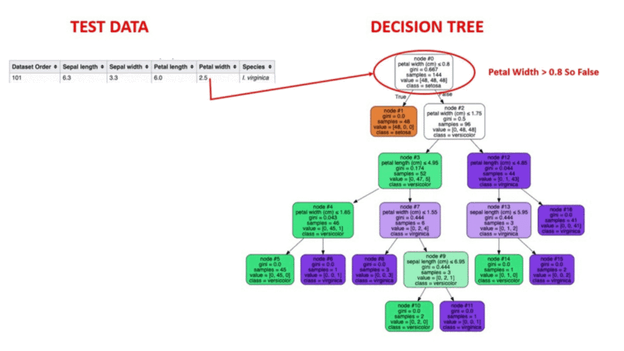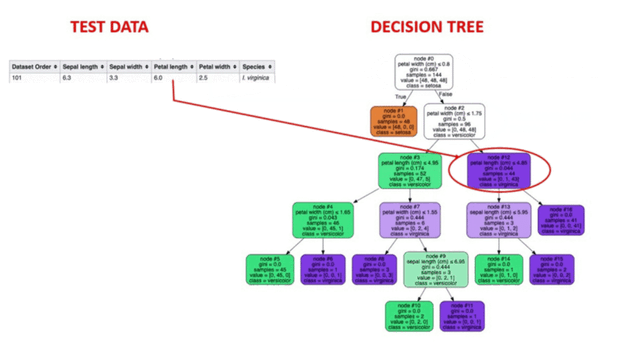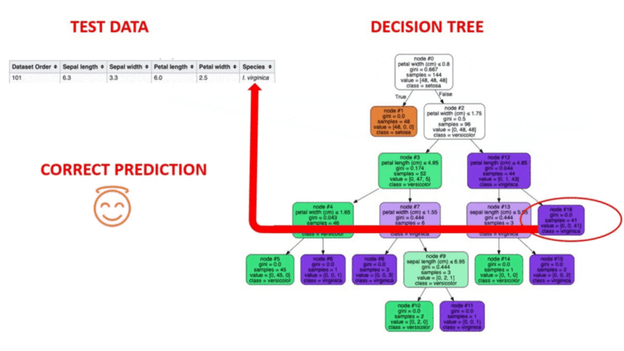
Minh họa động về cách cây quyết định hoạt động. Nguồn ảnh: Supervised Machine Learning
Xem lộ trình Học Máy Có Giám Sát Trong Python để tìm hiểu thêm các kỹ thuật này.
Học máy không giám sát
Các thuật toán học máy có giám sát, dự đoán dựa trên hành vi quá khứ, kém hiệu quả hơn khi kẻ gian áp dụng phương thức mới.
Học máy không giám sát hữu ích để dự đoán các mẫu chưa biết trong dữ liệu. Ưu điểm khác là không cần tiêu tốn nguồn lực con người để gán nhãn bộ dữ liệu lớn. Thuật toán tự phát hiện mẫu.
- Phân cụm K-means nhóm toàn bộ tập giao dịch vào các cụm khác nhau dựa trên giá trị điểm dữ liệu theo các thuộc tính khác nhau.
- Các điểm dữ liệu trong mỗi cụm có thuộc tính tương tự, như tần suất giao dịch. Thường thấy giao dịch gian lận không rơi vào các cụm lớn khác.
- Về trực quan, chúng cách xa các cụm khác. Có thể xác định giao dịch tiềm ẩn gian lận bằng cách phân tích các cụm ngoại lai này.
- Phân cụm mật độ DBSCAN liên quan đến việc biểu diễn tập giao dịch trong không gian đặc trưng. Ở biểu diễn này, các điểm dữ liệu tách thành vùng mật độ cao và thấp.
- Vùng mật độ cao được xem là cụm, còn vùng thưa được xem là ngoại lai.
- Các điểm rơi vào vùng thưa bị gắn cờ là tiềm ẩn gian lận. Sau đó được phân tích để tìm thêm bằng chứng hoạt động đáng ngờ.
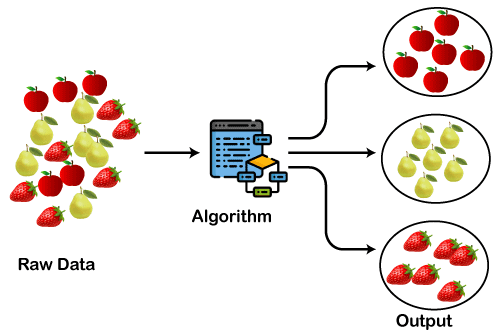
Cách hoạt động của phân cụm. Nguồn ảnh: Clustering in Machine Learning
Xem khóa học Học Không Giám Sát Trong Python để tìm hiểu thêm về các kỹ thuật đề cập.
Phân tích mạng
Các phương pháp truyền thống phát hiện gian lận bằng đối sánh mẫu hành vi đáng ngờ hiệu quả với tài khoản riêng lẻ. Tuy nhiên, kẻ gian thường hoạt động theo nhóm cá nhân sử dụng tập thiết bị, tài khoản email và địa chỉ thực, khiến việc theo dõi hành vi đáng ngờ trở nên khó khi xem xét tài khoản một cách cô lập.
- Vòng gian lận (fraud rings) là nhóm cá nhân tiến hành các đợt tấn công phối hợp. Ví dụ, các thành viên có thể dùng mười thiết bị và địa chỉ IP khác nhau để thực hiện mười giao dịch liên tiếp. Phân tích mạng có thể phát hiện mối liên hệ giữa các thực thể để tạo bản đồ quan hệ và xác định các vòng gian lận.
- Bản đồ quan hệ thực thể là cấu trúc dạng đồ thị với nút đại diện cho thực thể và cạnh đại diện cho mối quan hệ. Thực thể có thể là cá nhân, tài khoản, email, ID thiết bị, địa chỉ IP, địa chỉ thực, v.v. Mối quan hệ thể hiện điểm chung hoặc hành vi tương tự, như:
- Nhiều địa chỉ IP dùng cùng thông tin thanh toán đánh cắp.
- Nhiều tài khoản đặt đơn gian lận tới cùng một địa chỉ thực.
Xem khóa học Giới Thiệu Phân Tích Mạng Trong Python để hiểu sâu hơn các kỹ thuật này.
Khai phá văn bản và xử lý ngôn ngữ tự nhiên (NLP)
Nhiều dạng gian lận như yêu cầu bồi thường bảo hiểm giả, đánh giá khách hàng giả, email lừa đảo, v.v., dựa trên các khối văn bản. Phân tích nội dung văn bản thường mang lại manh mối để phân biệt hoạt động khách hàng chân chính với nỗ lực gian lận.
- Xử lý ngôn ngữ tự nhiên (NLP) bao gồm các kỹ thuật như phân tích cảm xúc và nhận dạng thực thể có tên (NER). NLP dùng trong các ứng dụng như:
- Các yêu cầu bảo hiểm gian lận thường có điểm bất nhất trong mô tả. NLP có thể nhận diện mâu thuẫn và ngôn ngữ bất thường, trong khi NER chỉ ra mối liên hệ giữa địa điểm, ngày tháng và con người.
- Đánh giá khách hàng giả thường được gửi bởi nhiều tài khoản cho cùng sản phẩm hoặc cùng tài khoản cho nhiều sản phẩm. Các đánh giá này có xu hướng chứa ngôn ngữ tương tự, có thể nhận diện qua phân tích cảm xúc và phát hiện giọng điệu.
- Email lừa đảo và các nỗ lực tấn công dựa trên kỹ nghệ xã hội thường theo các mẫu ngôn ngữ tương tự nhằm khai thác thông tin nhạy cảm từ người nhận. Các phương pháp NLP chuẩn hữu ích để nhận diện mẫu này và cảnh báo người nhận.
- Khai phá văn bản xử lý khối lượng lớn văn bản phi cấu trúc như email, yêu cầu bồi thường và đánh giá để phát hiện các mẫu ngôn ngữ đáng ngờ và thuật ngữ đặc thù thường gặp trong hoạt động gian lận.
- Giả định then chốt phía sau khai phá văn bản là phần lớn hoạt động gian lận rơi vào số ít nhóm và do một nhóm nhỏ cá nhân thực hiện. Vì vậy, xác định điểm chung bằng cách tìm mẫu trong nội dung văn bản là phương pháp khả thi để gắn cờ nỗ lực gian lận.
Xem lộ trình kỹ năng Xử Lý Ngôn Ngữ Tự Nhiên Trong Python để hiểu sâu hơn chủ đề này.
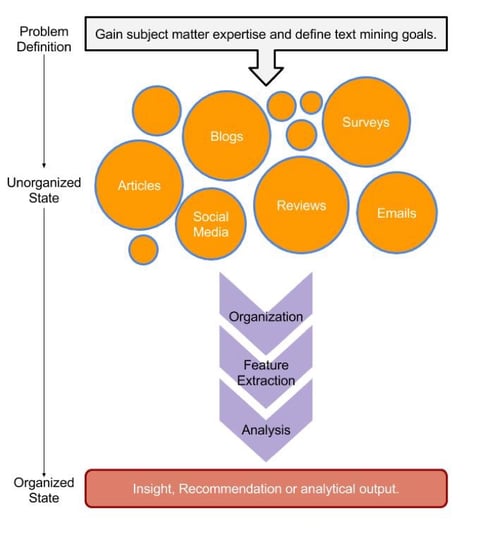
Minh họa quy trình khai phá văn bản. Nguồn ảnh: Text Mining with Bag-of-Words in R
Quy trình phát hiện gian lận
Phần này trình bày tổng quan cấp cao về các nguyên tắc thực tiễn để triển khai quy trình phát hiện gian lận.
Thu thập dữ liệu
Mọi thuật toán phát hiện gian lận đều dựa trên việc phân tích và xác định mẫu quan sát trong các bộ dữ liệu lớn. Do đó, các bộ dữ liệu chất lượng cao, phù hợp và được tuyển chọn như nhật ký giao dịch và hồ sơ khách hàng là tối quan trọng để huấn luyện các thuật toán này.
- Nhật ký giao dịch dùng để phân tích giao dịch lịch sử và phát hiện mẫu dựa trên các chi tiết như số tiền, khối lượng, tần suất, địa chỉ IP, dấu thời gian, v.v.
- Cơ sở dữ liệu khách hàng chứa địa chỉ, thông tin thanh toán, lịch sử duyệt, lịch sử mua, đánh giá đã để lại, hoàn trả, v.v.
- Nguồn dữ liệu bên thứ ba hữu ích để xác nhận quan sát dựa trên dữ liệu nội bộ và nâng cao chất lượng dữ liệu.
Tiền xử lý dữ liệu
Sau khi thu thập dữ liệu, bước hợp lý tiếp theo là dùng nó để huấn luyện mô hình phát hiện gian lận. Dữ liệu thô thường không phù hợp để huấn luyện. Vì vậy, cần làm sạch và chuẩn hóa dữ liệu trước khi sử dụng làm tập huấn luyện. Tiền xử lý dữ liệu, cùng với kỹ thuật đặc trưng, bao quát các bước này.
- Làm sạch dữ liệu xử lý giá trị thiếu, định dạng sai (ví dụ số bị định dạng dạng văn bản), bản ghi trùng lặp, giá trị sai, v.v. Để các giá trị như vậy trong dữ liệu sẽ dẫn đến mô hình huấn luyện kém. Vì vậy, làm sạch là bước đầu để đảm bảo bộ dữ liệu sử dụng được.
- Chuẩn hóa dữ liệu liên quan đến biểu diễn các giá trị số trên cùng một thang đo. Cũng có thể bao gồm chuyển các xếp hạng bằng chữ thành giá trị số. Điều này đặc biệt quan trọng khi kết hợp nhiều nguồn dữ liệu thành một bộ lớn hơn.
- Kỹ thuật đặc trưng biến đổi thông tin sẵn có thành dạng hữu ích hơn.
Huấn luyện và đánh giá mô hình
Các thuật toán phân tích gian lận về cốt lõi được xây dựng trên kỹ thuật học máy. Dữ liệu lịch sử là cơ sở để huấn luyện thuật toán học máy. Sau khi thu thập và làm sạch dữ liệu, bước tiếp theo là huấn luyện mô hình. Trong quá trình này, mô hình học cách dự đoán giao dịch hoặc hồ sơ người dùng nào có khả năng gian lận cao hơn.
Bên cạnh việc gắn cờ hành vi có khả năng gian lận, việc không cản trở người dùng bình thường cũng quan trọng không kém. Dương tính giả là khi mô hình gắn cờ giao dịch hợp pháp là gian lận. Giảm thiểu dương tính giả rất quan trọng để duy trì trải nghiệm khách hàng tốt. Để đảm bảo điều này, mô hình đã huấn luyện được đánh giá bằng nhiều chỉ số.
Phát hiện gian lận theo thời gian thực
Sau khi gian lận xảy ra, việc thu hồi tiền hoặc hàng hóa bị chiếm đoạt trở nên ngày càng khó khăn. Vì vậy, mục tiêu là phát hiện và ngăn chặn gian lận theo thời gian thực trước khi giao dịch được thực hiện. Tích hợp phân tích gian lận vào đường ống xử lý giao dịch cho phép phát hiện theo thời gian thực. Có hai cách thực hiện:
- Streaming dữ liệu từ đường ống giao dịch vào hệ thống phân tích gian lận thời gian thực: Các công cụ truyền sự kiện như Apache Kafka cho phép truyền dữ liệu giao dịch thời gian thực vào hệ thống phân tích gian lận. Nền tảng phân tích gian lận thời gian thực gắn cờ giao dịch đáng ngờ để con người xác minh. Đường ống xử lý giao dịch cũng nhận xác nhận từ hệ thống phân tích gian lận trước khi chốt giao dịch.
- Áp dụng phân tích gian lận ngay trong đường ống xử lý giao dịch: Thực hiện bằng các công cụ như Apache Flink. Flink cung cấp khả năng xử lý theo thời gian sự kiện trên luồng dữ liệu, trong bối cảnh phân tích gian lận gọi là xử lý luồng thời gian thực dữ liệu giao dịch. Nó cũng tích hợp với các mô hình học máy.
Báo cáo và giám sát
Các bên liên quan như ban lãnh đạo, nhà khoa học dữ liệu, nhân viên tuân thủ, nhà phân tích gian lận và đội an ninh giám sát kết quả của nỗ lực phát hiện gian lận đang diễn ra. Các công cụ như bảng điều khiển, cảnh báo thời gian thực và báo cáo tự động hỗ trợ theo dõi và giám sát.
- Bảng điều khiển hiển thị trực quan các chỉ số quan trọng như số giao dịch gian lận, tỷ lệ thành công/thất bại của công cụ phân tích, mức thiệt hại, khối lượng giao dịch, v.v. Bảng điều khiển giúp làm nổi bật thông tin quan trọng mà không cần đi sâu vào báo cáo chi tiết.
- Khi phần mềm nghi ngờ hoạt động gian lận, nó gửi cảnh báo thời gian thực để thông báo cho người phụ trách giám sát giao dịch. Mọi dự đoán thuật toán đều có mức độ tin cậy nhất định—trong nhiều trường hợp, phán đoán của con người là thiết yếu. Hơn nữa, đôi khi cần biện pháp khắc phục để ngăn thiệt hại thêm, như chặn giao dịch trên thẻ nghi bị đánh cắp. Cập nhật thời gian thực giúp đẩy nhanh quá trình này.
- Báo cáo tự động định kỳ tổng hợp thông tin về hoạt động của các công cụ phân tích gian lận. Chúng hỗ trợ theo dõi hiệu suất và can thiệp khi cần.
- Thông báo cho khách hàng khi nghi ngờ hoạt động gian lận trên tài khoản của họ. Đôi khi phần mềm phân tích nhầm hoạt động hợp pháp thành gian lận tiềm ẩn. Cần có xác nhận thủ công từ khách hàng trước khi xử lý các giao dịch như vậy. Ở trường hợp khác, cần thông báo tài khoản bị tạm ngưng vì hoạt động đáng ngờ và họ cần kích hoạt lại.
Công cụ và nền tảng cho phân tích gian lận
Xét tầm quan trọng và phạm vi ứng dụng rộng rãi của phân tích gian lận, có rất nhiều phần mềm được dùng trong lĩnh vực này. Bao gồm công cụ mã nguồn mở lẫn hệ thống sở hữu độc quyền. Phần này cung cấp cái nhìn tổng quan về những công cụ và nền tảng phổ biến nhất trong phân tích gian lận.
Python, SQL và R
Dữ liệu khách hàng và nhật ký giao dịch thường được lưu trong kho dữ liệu quan hệ.
- SQL là công cụ mạnh mẽ, linh hoạt để trích xuất bộ dữ liệu phù hợp. Nó cho phép nhà phát triển viết và tối ưu truy vấn để lấy bộ dữ liệu đáp ứng các tiêu chí khác nhau. Các bộ dữ liệu này được phân tích để khám phá xu hướng và mẫu gợi ý hoạt động gian lận tiềm ẩn.
- Python, nhờ hệ sinh thái thư viện lớn và cộng đồng phát triển đông đảo, thường là công cụ ưa dùng để xây dựng và thử nghiệm các thuật toán phân tích khác nhau. Rộng hơn, Python cũng được dùng cho nhiều ứng dụng tài chính.
- Phân tích thống kê là cốt lõi của nhiều phương pháp phát hiện gian lận. Do đó, R với thư viện hàm thống kê phong phú, rất phù hợp cho nhiều phân tích dữ liệu ad-hoc để phát hiện gian lận.
Vì vậy, Python, SQL và R cung cấp bộ công cụ hoàn hảo để nhà phát triển xây dựng hệ thống phân tích gian lận tùy chỉnh. Tuy nhiên, các công cụ này có thể gặp khó khi xử lý hiệu quả bộ dữ liệu rất lớn. Việc triển khai hệ thống phân tích thường dùng thêm phần mềm chuyên biệt như Apache Spark (trình bày bên dưới).
Ngoài ra, công cụ xây trên Python và SQL có thể không phù hợp với đối tượng không kỹ thuật như nhà phân tích gian lận và nhân viên tuân thủ. Thông thường sẽ cung cấp giải pháp tích hợp xây dựng bằng công cụ bên thứ ba như SAS (trình bày sau).
Apache Spark
Nhiều kỹ thuật phân tích gian lận dựa trên thuật toán học máy được huấn luyện trên nhật ký giao dịch và dữ liệu khách hàng. Phát hiện mẫu theo thời gian thực đòi hỏi xử lý lượng dữ liệu lớn. Ví dụ, đơn vị xử lý thẻ tín dụng xử lý hàng triệu giao dịch mỗi ngày. Để phát hiện một vòng gian lận, hệ thống phân tích phải xử lý hiệu quả dữ liệu giao dịch của nhiều ngày.
Apache Spark là động cơ xử lý dữ liệu mã nguồn mở có khả năng mở rộng ngang qua các cụm máy. Nhờ khả năng tính toán trong bộ nhớ, nó xử lý được tập dữ liệu lớn mà không cần chuyển sang xử lý theo lô.
Spark nhận dữ liệu đầu vào từ nhiều nguồn như Cassandra và Amazon S3. Nó cũng cung cấp API ở nhiều ngôn ngữ, gồm Python và Java. Vì vậy, Spark đặc biệt phù hợp cho các trường hợp dữ liệu lớn như phân tích gian lận.
Xem khóa học Giới Thiệu PySpark để học ngôn ngữ xử lý dữ liệu mạnh mẽ này ngay hôm nay.
Tableau và Power BI
Phân tích gian lận liên quan đến bộ dữ liệu lớn và phân tích phức tạp. Trực quan hóa giúp con người dễ và nhanh nắm bắt thông tin hơn. Tableau và Power BI là công cụ trực quan hóa dữ liệu có thể kết nối nhiều nguồn dữ liệu. Chúng dùng cho cả báo cáo và phân tích.
- Các công cụ này tạo bảng điều khiển tương tác để báo cáo chỉ số quan trọng như xu hướng, tỷ lệ thành công/thất bại, số tiền thiệt hại, khối lượng giao dịch. Trực quan hóa cũng có thể phân loại theo loại hình gian lận và khu vực địa lý.
- Ngoài báo cáo, Power BI và Tableau còn hỗ trợ phân tích gian lận bằng cách hiển thị trực quan thông tin về vòng gian lận tiềm ẩn, phân tích mạng và các xác suất khác nhau.
- Các công cụ này cũng cho phép nhà phân tích điều chỉnh trực quan nhiều bộ lọc, tiêu chí phát hiện và mức độ tin cậy. Điều này giúp nhanh chóng quyết định giao dịch là hợp pháp hay gian lận.
Đây là các công cụ trực quan hóa mục đích chung với mô-đun và giao diện riêng cho phân tích gian lận. Bạn có thể bắt đầu học PowerBI ngay hôm nay qua lộ trình kỹ năng PowerBI Fundamentals.
SAS Fraud Management
SAS là bộ phần mềm thống kê do Viện SAS phát triển. Viện cũng xây dựng các gói chuyên ngành cho nhiều ứng dụng, bao gồm phân tích gian lận.
SAS Fraud Management sử dụng các kỹ thuật thống kê và thuật toán học máy để dự đoán và ngăn chặn gian lận. Những thuật toán này được đóng gói thành sản phẩm để những người không có nền tảng học máy, như nhà phân tích gian lận và nhân viên tuân thủ, cũng có thể dùng phương pháp ML và thống kê cho phát hiện gian lận.
H2O.ai
H2O.ai cung cấp dịch vụ học máy tự động trên đám mây. Phần mềm của H2O.ai gắn cờ hoạt động có khả năng gian lận, chấm điểm xác suất gian lận và gán mã lý do để chỉ ra vì sao thuật toán nghi ngờ gian lận.
Các hướng dẫn này giúp điều tra viên đào sâu để xác minh giao dịch. Trong nhiều trường hợp, chúng cũng giúp phê duyệt nhanh giao dịch hợp pháp để tăng tốc xử lý.
IBM Safer Payments
IBM Safer Payments là hệ thống phát hiện gian lận nhắm riêng vào ngành thanh toán.
Vì dùng cơ sở dữ liệu NoSQL trong bộ nhớ, nó có thể giám sát thanh toán theo thời gian thực. Hệ thống ngăn chặn gian lận trong phương thức thanh toán không tiền mặt, như thanh toán thẻ tín dụng, bằng cách phân tích luồng giao dịch theo thời gian thực và chặn các giao dịch có khả năng gian lận trước khi được thực hiện.
Kết luận
Bài viết cung cấp cái nhìn tổng quan về các loại hình gian lận khác nhau và vai trò của phân tích gian lận trong việc phát hiện, ngăn chặn. Bài cũng thảo luận các kỹ thuật thường dùng để phát hiện các trường hợp gian lận tiềm ẩn và quy trình phát hiện gian lận. Cuối cùng, bài giới thiệu một số ứng dụng phần mềm thường dùng trong lĩnh vực này.
Để học cách xây dựng hệ thống phát hiện gian lận bằng Python, hãy tham gia khóa học Phát Hiện Gian Lận Trong Python. Để có phần mở đầu tổng quan về Python cho ứng dụng tài chính, theo học khóa Nhập Môn Python Cho Tài Chính. Để tìm hiểu thêm về các hàm thống kê trong R dùng cho ứng dụng phát hiện gian lận, theo học khóa Phát Hiện Gian Lận Trong R.
Câu hỏi thường gặp
Phân tích gian lận có thể loại bỏ hoàn toàn gian lận không?
Không, phân tích gian lận giúp giảm thiểu đáng kể nhưng không thể loại bỏ hoàn toàn. Nó giúp gắn cờ giao dịch rủi ro cao, nhưng vẫn cần giám sát của con người.
Doanh nghiệp xử lý giao dịch bị gắn cờ theo thời gian thực như thế nào?
Các giao dịch bị gắn cờ thường được điều tra viên xem xét. Hệ thống tự động cũng có thể chặn tạm thời các giao dịch đáng ngờ để chờ xem xét thêm.
Dữ liệu nào là tối quan trọng cho phát hiện gian lận hiệu quả?
Dữ liệu chủ chốt gồm nhật ký giao dịch, hồ sơ khách hàng, nguồn xác thực từ bên thứ ba và dữ liệu thiết bị. Dữ liệu chất lượng cao, sạch giúp cải thiện độ chính xác phát hiện.
Mô hình học máy không giám sát thích ứng với mẫu gian lận mới như thế nào?
Các mô hình không giám sát liên tục thích ứng với hành vi mới bằng cách nhận diện các mẫu và bất thường chưa biết, giúp phát hiện hiệu quả hơn các phương thức gian lận mới nổi.
Hệ thống phát hiện gian lận cân bằng giữa tốc độ và độ chính xác ra sao?
Hệ thống dùng công cụ xử lý dữ liệu thời gian thực như Apache Flink để phân tích giao dịch tức thời, đồng thời giảm dương tính giả bằng cách tinh chỉnh thuật toán theo thời gian.

Arun là cựu nhà sáng lập startup, yêu thích xây dựng những điều mới mẻ. Hiện tại, anh đang khám phá các nền tảng kỹ thuật và toán học của Trí tuệ Nhân tạo. Anh thích chia sẻ những gì mình học được, vì thế anh viết về chúng.
Bên cạnh DataCamp, bạn có thể đọc các bài viết của anh trên Medium, Airbyte và Vultr.


Một hệ thống kinh tế lành mạnh dựa trên niềm tin giữa người mua và người bán hàng hóa, dịch vụ. Khi niềm tin này bị phá vỡ, chi phí kinh doanh sẽ tăng lên. Những kẻ không trung thực thực hiện các giao dịch lừa dối để chiếm đoạt của doanh nghiệp. Cũng có những nhóm gian lận tinh vi nhắm mục tiêu vào các ngành cụ thể.
Trong bài viết này, chúng tôi thảo luận các loại hình gian lận khác nhau được phát hiện thông qua phân tích và các kỹ thuật dùng để phát hiện gian lận. Chúng tôi cũng đề cập các quy trình phát hiện gian lận điển hình và các công cụ phần mềm thường dùng cho phân tích gian lận.
Khám phá cách AI có thể tác động đến tổ chức của bạn và cách triển khai chiến lược AI thành công với sách trắng của chúng tôi, Hướng Dẫn Về Kiến Thức AI Dành Cho Nhà Lãnh Đạo Học Tập.
Phân tích gian lận là gì?
Phân tích gian lận đề cập đến các kỹ thuật thống kê và học máy nhằm xác định và gắn cờ các giao dịch có khả năng gian lận, thường là theo thời gian thực.
Việc phát hiện hoạt động gian lận đầy thách thức vì:
Doanh nghiệp cần dùng các công cụ phát hiện gian lận tích hợp những tính năng này. Các công cụ sẽ gắn cờ giao dịch có xác suất gian lận cao. Điều tra viên sau đó kiểm tra thủ công các giao dịch bị gắn cờ và đưa ra quyết định cuối cùng.
Phát hiện gian lận tiềm ẩn bao gồm phát hiện hành vi: