Last chance! 50% off DataCamp Premium
Sale ends in
Bayangkan Anda menceritakan kisah panjang kepada seorang teman, lalu menyadari bahwa mereka sudah lupa bagian awal saat Anda sampai pada punchline. Rasa frustrasi ini persis terjadi ketika AI kehabisan "memori jangka pendek", sehingga terpaksa membuang detail penting untuk memberi ruang bagi informasi baru.
Dalam dunia Large Language Models (LLM), rentang perhatian ini ditentukan oleh context window.
Seiring model menjadi lebih kuat dan ukuran konteks meningkat, memahami cara kerja window ini menjadi kunci untuk membangun sistem AI yang andal dan dapat diskalakan. Dalam panduan ini, kami akan membahas dasar-dasar context window, trade-off saat memperluasnya, dan strategi untuk menggunakannya secara efektif.
Untuk melampaui teori dan mempelajari cara mengelola batas konteks dalam aplikasi Python nyata, lihat kursus kami Developing LLM Applications with LangChain.
Context window pada model AI menentukan jumlah teks yang dapat disimpan dalam memori kerjanya saat menghasilkan respons. Ini membatasi seberapa lama percakapan dapat berlangsung tanpa melupakan detail dari interaksi sebelumnya.
Anda bisa menganggapnya sebagai memori jangka pendek manusia. Ia menyimpan informasi dari percakapan sebelumnya secara sementara untuk digunakan pada tugas yang sedang dikerjakan.
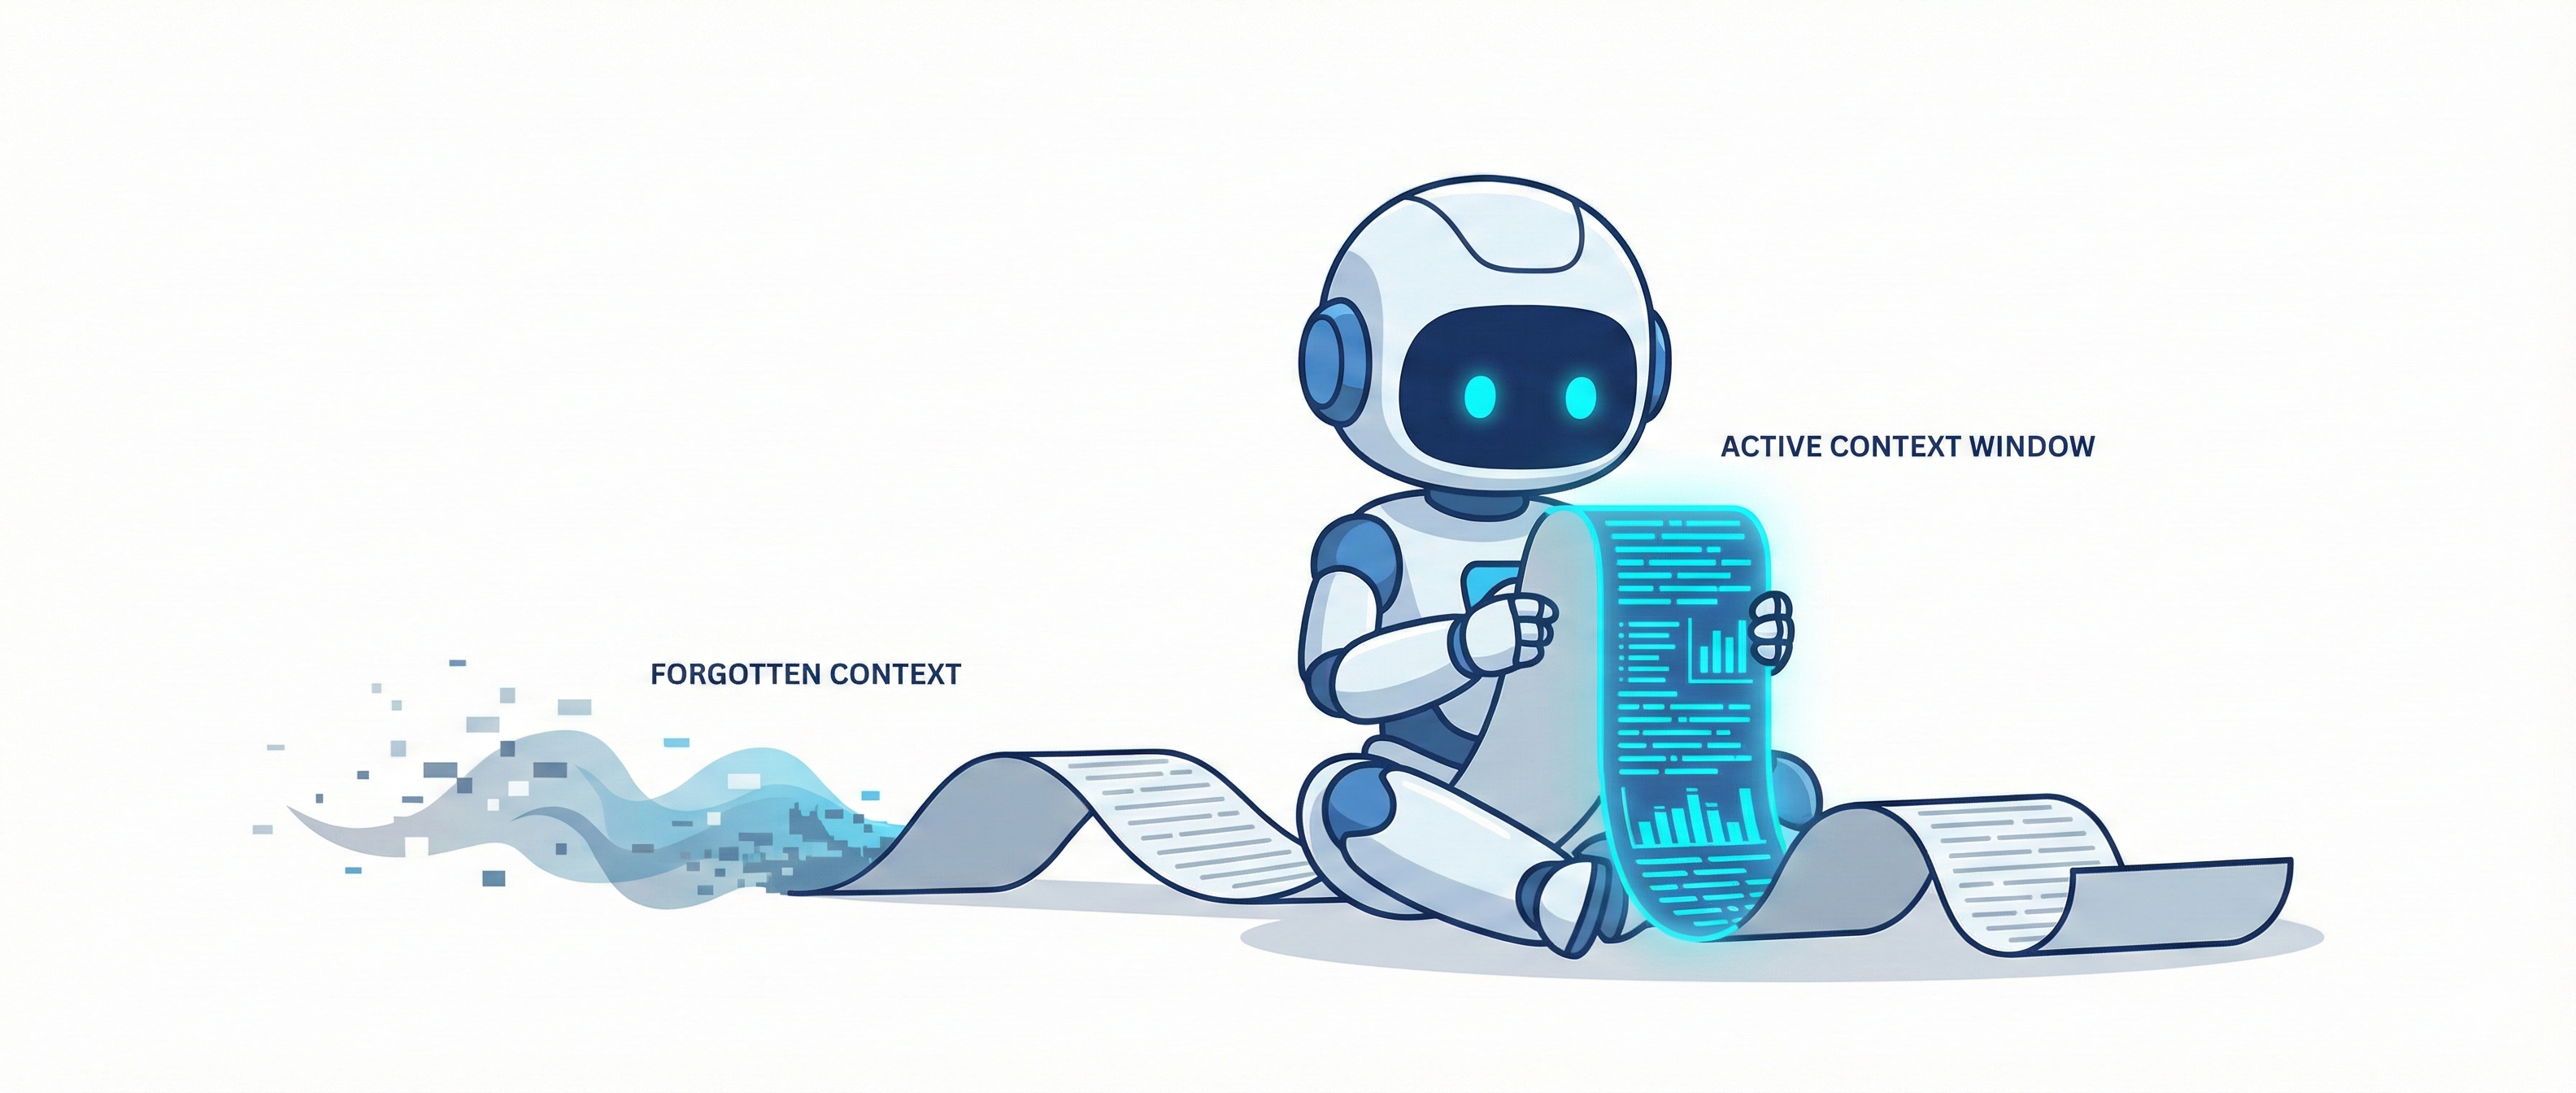
Context window memengaruhi berbagai aspek, termasuk kualitas penalaran, kedalaman percakapan, dan kemampuan model untuk mempersonalisasi respons secara efektif. Ini juga menentukan ukuran input maksimum yang dapat diproses sekaligus. Ketika prompt atau konteks percakapan melebihi batas tersebut, model akan memangkas (memotong) bagian teks paling awal untuk memberi ruang.
Untuk mendapatkan gambaran lebih jelas tentang apa artinya ini, mari kita lihat beberapa konsep dasar yang mendasari model AI dan context window.
Tiga konsep inti mendasari LLM: tokenisasi, mekanisme attention, dan penyandian posisi.
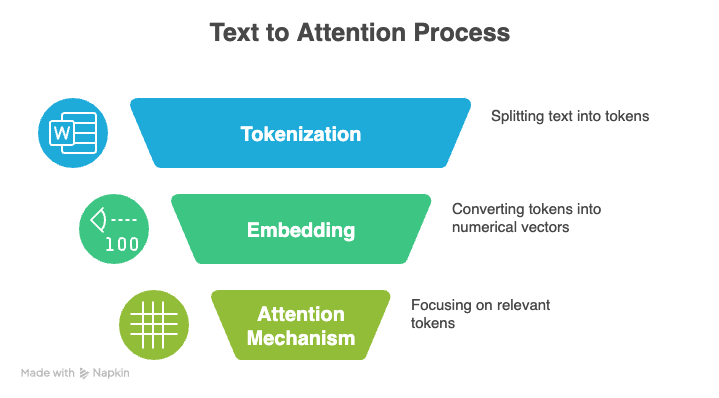
Tokenisasi adalah proses mengonversi teks mentah menjadi urutan unit yang lebih kecil, atau token, yang dapat diproses LLM. Token ini dapat merepresentasikan seluruh kata, karakter individual, atau bahkan suku kata parsial. Secara kolektif, seluruh himpunan token unik yang dikenali model disebut sebagai kosakatanya.
Sebagai contoh, kalimat “Hello, world” dapat ditokenisasi menjadi [“Hello”, “,”, “ world”].
Selama pelatihan atau inferensi, setiap token diubah menjadi bilangan bulat unik, dan model membaca angka-angka ini alih-alih teks asli. Ia menganalisis urutan numerik, mempelajari bagaimana token saling berhubungan, dan menghasilkan teks baru dengan memprediksi token berikutnya yang paling mungkin.
Tokenisasi yang efisien berperan besar pada jumlah informasi yang muat dalam context window model. Ketika tokenizer dapat merepresentasikan teks dengan lebih sedikit token, lebih banyak konten dapat masuk ke window yang sama.
Tokenizer yang merepresentasikan kata atau frasa umum sebagai satu token sangat efektif karena mengurangi jumlah token, memungkinkan model menangani dokumen lebih panjang dalam batas konteksnya.
Yang disebut mekanisme attention adalah fondasi lain dari LLM modern. Ini membantu model memusatkan perhatian pada bagian input yang paling relevan saat menghasilkan output.
Alih-alih memperlakukan setiap token secara setara, model membandingkan representasi saat ini dengan semua representasi token lainnya dan memberikan skor pada setiap perbandingan. Pembobotan selektif ini memungkinkan model memproses urutan panjang dan memahami konteks dengan lebih efektif.
Attention dibangun di atas tiga komponen: Query, Key, dan Value.
Query: Sinyal yang dikirim token saat ini untuk "mencari" informasi relevan dalam sisa urutan.
Key: Pengidentifikasi untuk setiap token dalam urutan yang menentukan seberapa baik kecocokannya dengan sinyal pencarian.
Value: Konten informasional sebenarnya yang diambil dan digunakan ketika terjadi kecocokan antara Query dan Key.
Model menghitung skor kemiripan antara query dan key, mengonversi skor tersebut menjadi bobot menggunakan fungsi aktivasi softmax, lalu menghasilkan output akhir sebagai jumlah berbobot dari value.
Self-attention membandingkan token saat ini dengan setiap token lain dalam urutan. Ini menciptakan biaya komputasi kuadratik: menggandakan context window melipatgandakan empat kali daya pemrosesan dan memori yang diperlukan.
Saat context window diperluas, biayanya cepat menjadi mahal, sehingga model mengandalkan optimasi seperti sparse attention, low-rank approximation, atau chunking untuk menjaga komputasi tetap terkelola.
Transformer, yang menggerakkan model bahasa modern, secara alami tidak memahami urutan token. Alih-alih, mereka mengandalkan penyandian posisi untuk memasukkan informasi ini.
Penyandian posisi menambahkan sinyal kecil pada setiap token yang membantu model memahami jarak dan susunan relatif.
Metode spesifik penyajian informasi posisi juga menentukan sejauh mana model dapat melacak hubungan dalam suatu urutan secara andal, yang menentukan ukuran dan efektivitas context window-nya. Mari bandingkan beberapa metode populer:
Absolute Positional Embeddings: Model mempelajari vektor terpisah untuk setiap posisi dalam urutan, seperti memberi setiap token alamat tetap. Ini bekerja untuk urutan yang lebih pendek, tetapi model tidak bisa menangani posisi di luar yang dilatih, sehingga sulit memperluas context window.
Sinusoidal Encodings: Posisi disandikan menggunakan gelombang sinus dan kosinus yang berulang, memberi setiap token pola unik berdasarkan lokasinya. Mereka lebih mampu menggeneralisasi ke panjang yang belum terlihat dibanding embedding absolut, meskipun menjadi kurang stabil pada urutan yang sangat panjang.
Relative Positional Encodings: Alih-alih menandai posisi pasti, model mempelajari jarak antar-token. Ini membantu generalisasi ke urutan yang lebih panjang, tetapi batas konteks keseluruhan tetap bergantung pada arsitektur dan memori model.
Rotary Positional Embeddings (RoPE): RoPE menyandikan posisi dengan memutar representasi vektor setiap token berdasarkan posisi absolutnya, lalu menghitung jarak dari token lain. Metode ini tetap stabil saat urutan bertambah panjang dan mendukung context window yang jauh lebih besar.
ALiBi (Attention Linear Biases): ALiBi menerapkan bias berbasis jarak sederhana di dalam mekanisme attention, sehingga token yang lebih dekat secara alami menerima bobot lebih tinggi. Metode ini berskala baik untuk urutan panjang.
Saya merekomendasikan tutorial ini tentang cara kerja transformer untuk ikhtisar mendetail.
Jika konteks melebihi context window, model dapat memangkas atau mengabaikan bagian paling awal, yang berpotensi kehilangan konteks penting. Itulah sebabnya para peneliti terus bereksperimen dengan teknik baru untuk mendorong batas ini dan memungkinkan context window yang lebih panjang.
Sampai tahun 2022, model GPT dari OpenAI mendominasi lanskap. Model GPT pertama, dirilis pada 2018, mendukung window 512 token. Dua versi berikutnya pada 2019 dan 2020 masing-masing menggandakan batas tersebut, mencapai 2.048 token untuk GPT-3. Model-model selanjutnya terus memperluas batas ini hingga satu juta token (GPT-4.1).
Baru-baru ini, OpenAI tersusul atau bahkan terkalahkan oleh kompetitor. Gemini 2.5 dan 3 Pro dari Google menyamai ukuran window hingga satu juta token, memungkinkan pemrosesan seluruh buku, basis kode besar, dan beban kerja multi-dokumen dalam satu kali proses.
Seri Claude Sonnet 4.5 dari Anthropic saat ini menguji ukuran context window yang sama dalam versi beta, berkembang dari ukuran awal 200.000 token.
Keluarga model open-source seperti Llama dan Mistral umumnya berada di kisaran 100k hingga 200k, menawarkan performa konteks panjang yang andal sekaligus tetap praktis untuk dijalankan secara lokal atau di-fine-tune.
Pengecualian penting mencakup Llama Maverick, yang mendukung window 1 juta token yang dirancang untuk penalaran tujuan umum pada dokumen panjang. Sementara itu, Llama Scout mendorong batas lebih jauh dengan kapasitas 10 juta token yang sangat besar, direkayasa khusus untuk memproses seluruh basis kode atau arsip hukum dalam satu kali proses.
Namun, rilis GPT-5.2 pekan ini menandai pergeseran strategi. Alih-alih mengejar konteks tak terbatas, OpenAI membatasi flagship terbarunya pada window 400.000 token, menukar ukuran mentah dengan 'ingatan sempurna' dan kemampuan penalaran unggul yang menghindari masalah distraksi yang umum pada model lebih besar.
Perbedaan ukuran context window membentuk bagaimana setiap model berkinerja dalam alur kerja nyata. Context window yang diperluas memberdayakan model dengan akurasi, koherensi, dan penalaran jangka panjang yang kuat, tetapi juga memerlukan komputasi lebih besar dan seleksi konteks yang lebih cermat.
Model kelas menengah tetap efisien dan masih mampu menangani dokumen panjang dan percakapan berkepanjangan, meski membutuhkan struktur yang tepat untuk input yang sangat besar.
Kasus penggunaan berikut menyoroti bagaimana kekuatan model dengan context window besar muncul dalam aplikasi dunia nyata.
Dengan ruang yang cukup untuk menampung seluruh laporan, transkrip, basis kode, atau makalah riset sekaligus, model dapat melacak pola, menghubungkan detail yang jauh, dan mempertahankan pemahaman yang koheren dari awal hingga akhir. Ini menawarkan banyak bidang penerapan:
Hukum: Window besar memungkinkan model menganalisis kontrak penuh, membandingkan klausul di banyak dokumen, dan melacak referensi yang tersembunyi dalam dokumen panjang.
Kesehatan: Tim dapat meninjau pedoman klinis panjang, riwayat pasien, atau kumpulan data multi-studi sambil mempertahankan konteks penting yang akan terlewat oleh window yang lebih kecil.
Riset: Model dengan window besar dapat membaca makalah lengkap dan tinjauan literatur dalam satu kali proses serta menampilkan keterkaitan yang hanya muncul ketika seluruh dokumen terlihat.
Context window yang lebih besar membuat AI percakapan terasa lebih alami karena model dapat mengingat lebih banyak bagian percakapan tanpa melupakan pesan sebelumnya.
Dalam layanan pelanggan, ini menghasilkan interaksi yang lebih mulus dan personal. Model dapat menggunakan preferensi masa lalu dan percakapan sebelumnya untuk memberikan respons yang lebih akurat dan relevan.
Context window yang diperluas mendukung penalaran kompleks lintas teks, audio, dan visual dengan memberikan ruang yang cukup agar model menampung semua modalitas secara bersamaan alih-alih memprosesnya secara terpisah.
Ketika transkrip lengkap, bingkai visual, dan materi tertulis terkait muat dalam satu window, model dapat membandingkan detail lintas format, melacak hubungan, dan membangun pemahaman konteks yang terpadu.
Ini menghilangkan celah yang muncul saat informasi harus dipecah atau diringkas dan memungkinkan model menalar seluruh set input sekaligus.
Context window besar membuka kemampuan model yang kuat, tetapi juga memperkenalkan tantangan kinerja baru seiring ukuran input tumbuh. Bahkan model canggih pun kesulitan mempertahankan perhatian sempurna pada urutan yang sangat panjang, sehingga tidak selalu menggunakan informasi dari setiap bagian konteks seandal yang Anda harapkan.
Salah satu masalah umum pada model konteks panjang adalah efek “lost in the middle”. Model mengingat bagian awal dan akhir urutan panjang dengan cukup baik, tetapi sering melewatkan atau mengabaikan detail penting yang tersembunyi di tengah. Ini dapat menyebabkan jawaban yang lebih lemah, meskipun konteks lengkap tersedia.
Menata input dengan cara yang cerdas membantu menghindari masalah ini untuk tugas-tugas penting. Ini berarti memecahnya menjadi bagian-bagian yang jelas atau mengulang poin-poin kunci agar model tidak melewatkannya.
Biaya dapat meningkat pesat seiring bertambahnya ukuran context window. Setiap token tambahan meningkatkan ukuran perhitungan attention, yang menaikkan waktu inferensi, kebutuhan memori GPU, dan beban sistem secara keseluruhan.
Untuk mengelolanya, diperlukan cara yang lebih efektif untuk memberi model informasi. Teknik seperti pengambilan selektif, chunking hierarkis, atau ringkasan cepat membantu menjaga input tetap kecil, sehingga model tidak kewalahan.
Window besar juga menimbulkan kekhawatiran terkait keselamatan, keamanan, dan privasi. Ketika Anda memberikan lebih banyak input ke model, peluang mengekspos data sensitif semakin tinggi.
Karena itu, tim memerlukan aturan penanganan data yang kuat, langkah-langkah redaksi, dan kontrol akses untuk memastikan context window besar tidak menciptakan risiko baru.
Dalam banyak kasus, informasi yang tidak perlu atau kurang terkait meningkatkan beban kognitif bagi model, meningkatkan risiko halusinasi dan pola yang keliru. Input yang panjang juga memperkenalkan noise yang dapat mendistorsi pemahaman model terhadap tugas.
Dalam praktiknya, performa berkualitas tinggi sering kali berasal dari konteks yang diseleksi dengan cermat, memastikan model melihat informasi yang tepat alih-alih sekadar terpapar jumlah informasi terbesar.
Beberapa metode dapat diterapkan untuk memaksimalkan penggunaan context window. Di antaranya adalah Retrieval Augmented Generation (RAG), rekayasa konteks, chunking, dan pemilihan model.
Retrieval Augmented Generation (RAG) bekerja dengan menarik informasi tambahan dari basis data eksternal dan memberikannya ke model setiap kali konteks diperlukan.
Alih-alih memasukkan seluruh dokumen ke dalam context window, RAG menyimpan semuanya secara terpisah dan hanya mengambil bagian yang penting untuk pertanyaan saat ini. Ini menjaga konteks tetap kecil sambil tetap memberi model semua informasi yang dibutuhkan.
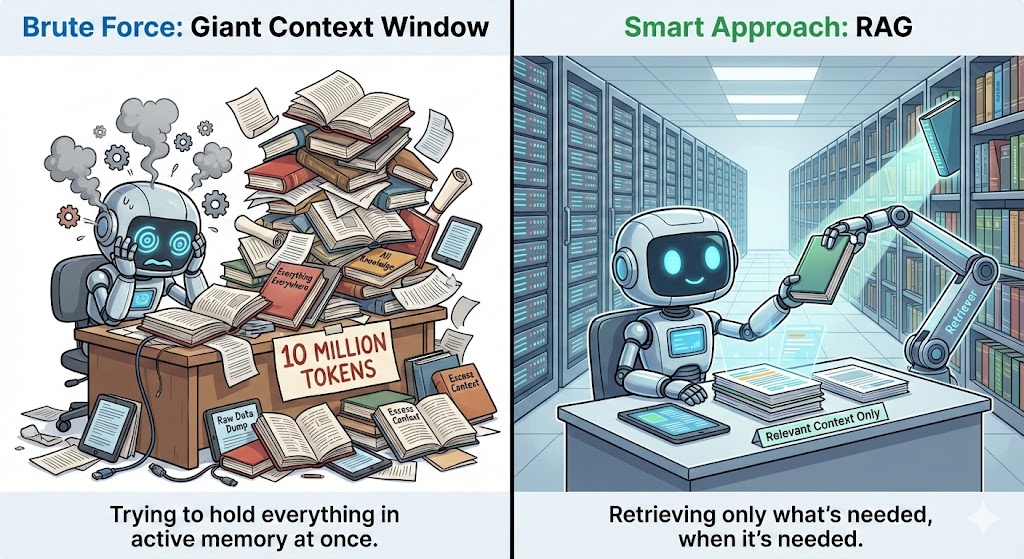
Ini dilakukan dengan menggunakan embedding atau pencarian vektor untuk menemukan potongan paling relevan dan mengirimkannya ke model dengan cara yang rapi dan terstruktur. Ini meningkatkan akurasi dengan memastikan model dapat menggunakan informasi tambahan yang relevan di luar data pelatihannya.
Rekayasa konteks berfokus pada pemberian informasi yang relevan kepada model alih-alih membebani dengan detail yang tidak perlu. Strategi efektif mencakup segmentasi dokumen panjang, meringkas bagian bernilai rendah, dan menggunakan langkah praproses ringan untuk menyoroti poin-poin utama.
Pencarian semantik membantu di sini dengan mengidentifikasi teks yang penting untuk kueri saat ini. Anda juga dapat meningkatkan hasil dengan memindahkan informasi paling krusial ke awal atau akhir konteks, karena model cenderung lebih mengingat bagian-bagian itu.
Chunking memecah dokumen panjang menjadi bagian-bagian yang lebih kecil dan koheren. Idenya adalah mengelompokkan konten berdasarkan subjek, struktur, atau tugas yang didukung.
Ini menjaga setiap potongan tetap koheren dan membantu model tetap fokus alih-alih tersesat dalam blok teks yang sangat besar. Jika Anda ingin tahu lebih lanjut, silakan lihat artikel tentang strategi chunking tingkat lanjut.
Semantic chunking mengelompokkan kalimat yang memiliki makna serupa alih-alih memotong teks pada batas karakter acak. Ini membagi konten pada titik jeda alami seperti pergeseran topik, transisi paragraf, atau header bagian.
Task-based chunking melangkah lebih jauh dengan membentuk setiap potongan berdasarkan pertanyaan spesifik yang ingin Anda jawab. Setiap bagian kemudian hanya berisi informasi yang benar-benar relevan dengan tugas tersebut.
Tugas yang melibatkan analisis dokumen penuh, penalaran multi-berkas, atau percakapan jangka panjang akan diuntungkan dari model dengan window di kisaran 200k–1M. Untuk tugas yang lebih terfokus seperti peringkasan, tinjauan kode, atau tanya jawab bentuk pendek, model di kisaran 100k–200k sering kali memberikan keseimbangan terbaik antara kecepatan, biaya, dan akurasi.
Window yang lebih kecil tetap bisa berkinerja baik saat dipasangkan dengan sistem retrieval yang kuat. Sistem RAG yang baik atau Model Context Protocol (MCP) dapat mengambil informasi yang tepat sesuai permintaan, sehingga model tidak perlu menahan semuanya dalam memorinya.
Sebelum menutup, mari lihat ke mana teknologi mengarah terkait context window.
Arsitektur model masa depan bergerak menuju context window dinamis, bukan window berukuran tetap.
Para peneliti mengeksplorasi pendekatan yang memadukan kekuatan transformer dengan sistem memori jangka panjang baru, menghasilkan model yang dapat menyimpan dan mengingat informasi tanpa hanya mengandalkan mekanisme attention.
Arsitektur ini mengatasi batas saat ini dengan beralih dari context window statis ke lapisan memori dinamis yang tumbuh seiring tugas.
Sistem memori adalah area inovasi lainnya. Model di masa depan diperkirakan akan lebih mengandalkan sistem memori yang sadar konteks yang melampaui satu sesi dan memberikan kesinambungan dari waktu ke waktu.
Alih-alih memperlakukan setiap percakapan sebagai awal yang baru, sistem ini menyimpan preferensi kunci, keputusan masa lalu, dan tema berulang dalam lapisan memori terstruktur yang dapat dipanggil saat relevan.
Ini menggeser personalisasi dari reaktif menjadi proaktif, memungkinkan model memahami pengguna secara lebih holistik dan mendukung tujuan jangka panjang dengan konsistensi yang jauh lebih baik.
Pengambilan informasi eksternal juga berevolusi. Saat ini, RAG bekerja seperti mesin telusur, menarik teks relevan ke dalam prompt. Versi lanjutan seperti Corrective Retrieval-Augmented Generation (CRAG) telah muncul, tetapi itu baru permulaan.
Di masa depan, retrieval akan terasa lebih terintegrasi, seolah-olah model memiliki memori eksternalnya sendiri. Model akan secara otomatis mengumpulkan, memadatkan, dan menampilkan kembali informasi dengan intervensi pengguna minimal.
Memori persisten juga akan mengubah cara kita berinteraksi dengan AI. Alih-alih melupakan semuanya ketika sesi berakhir, model akan mengingat detail penting selama hari, minggu, atau bahkan bulan. Seiring model mempelajari gaya, kebiasaan, dan prioritas Anda, ia dapat memberikan respons yang lebih disesuaikan dan bermanfaat, tanpa mengharuskan Anda mengulanginya.
Perangkat seperti Mem0 telah merintis pendekatan ini, bertindak sebagai lapisan memori khusus antara aplikasi dan LLM. Namun, ke depan, kami berharap lebih banyak kemampuan ini dibangun langsung ke dalam arsitektur model daripada bergantung pada lapisan eksternal.
Window yang lebih besar membuka alur kerja baru yang kuat, namun juga memperkenalkan tantangan attention, biaya komputasi yang lebih tinggi, dan risiko kualitas ketika konteks berlebihan. Ini menjadikan pengelolaan konteks yang strategis sebagai hal yang esensial.
Teknik seperti retrieval augmentation, semantic chunking, dan rekayasa konteks membantu model tetap fokus, efisien, dan andal bahkan saat kapasitasnya berkembang.
Ke depan, sistem berbasis LLM terbaik mengombinasikan alat yang cerdas dan pemahaman yang kuat tentang bagaimana konteks memengaruhi penalaran. Dengan menerapkan prinsip-prinsip ini, tim dapat memetik manfaat dari model konteks panjang sambil mempersiapkan arsitektur generasi berikutnya yang mendorong batas konteks lebih jauh lagi.
Tingkatkan dasar-dasar Python Anda dengan Developing Large Language Models skill track. Jalur ini dirancang untuk membimbing Anda dari kode dasar hingga membangun dan menyempurnakan aplikasi AI Anda sendiri yang kuat.
Kursus LLM
Kursus
Program
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt