
Ga naar hoofdinhoud
Kunstmatige intelligentie
Generative AI

Google I/O 2025: Top 8 AI-aankondigingen (en mijn visie)

Lees meer over de belangrijkste AI-aankondigingen op Google I/O 2025—Veo 3, Flow, Imagen 4 en meer—plus eerste indrukken.
Alex Olteanu's photo
Alex Olteanu
Bijgewerkt · 8 min lezen

Verken met AI

ChatGPTClaudePerplexity

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.

Dag 1 van Google I/O 2025 zit erop. In dit artikel neem ik je mee langs de aankondigingen die het meest tellen voor de AI-sector.

Ik focus op de updates die óf meteen te gebruiken zijn, óf binnenkort worden verwacht. Onderweg deel ik korte indrukken en zet ik dingen waar relevant in context met de concurrentie.

We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis vrijdagnieuwsbrief die de belangrijkste verhalen van de week ontleedt. Abonneer je en blijf scherp in een paar minuten per week:

Veo 3

Wat mij opviel aan Veo 3 is dat het native audio-uitvoer biedt. Je kunt nu direct video’s genereren mét geluid, zonder extra montagestappen. Laten we een voorbeeld bekijken:

Bron: Google

Native audio-uitvoer heb ik nog niet gezien in Runway of Sora. Op dit moment zou ik zeggen dat Veo 3 een stap voor ligt.

Hoewel de demo er goed uitziet, heb ik geleerd dat demo’s zelden laten zien hoe deze modellen zich in de praktijk gedragen. Zodra de prompt buiten de vorm van de trainingsdata treedt—een onbekende scène, een vreemd personage of een idee met te veel subtiliteit—loopt het model vaak vast. Ik kan niet wachten om met Veo 3 te spelen om te zien hoe goed het presteert.

Toegang tot Veo 3 vereist een AI Ultra-abonnement, dat $250/maand kost. Zelfs als je wilt betalen, is de beschikbaarheid beperkt. Op dit moment is het alleen toegankelijk in de VS, en uitsluitend binnen Google’s nieuwe AI-aangedreven video-editor genaamd Flow (die we zo bespreken).

Ben je benieuwd naar de technische details of wil je meer voorbeelden zien, bekijk dan de officiële pagina van Veo hier.

Flow 

Flow is een AI-filmmakingtool waarmee je losse shots kunt genereren met een combinatie van Veo, Imagen en Gemini.

Handig vind ik dat je afzonderlijke elementen (zogenaamde “ingrediënten”) kunt maken en ze vervolgens kunt groeperen tot één scène. Dat geeft je modulaire controle en is vooral nuttig als je dezelfde elementen in meerdere prompts of shots wilt hergebruiken.

Laten we een voorbeeld bekijken:

Bron: Google

Er zijn in Flow ook tools voor camerabediening en overgangen, die de clips een cinematografischer gevoel geven. Die zijn nuttig, maar niet nieuw—Sora en Runway bieden al vergelijkbare functies, dus baanbrekend zou ik het niet noemen.

Toch is het de moeite waard om te volgen hoe dit soort tools evolueren. Flow voelt als de vroege versie van een AI-first video-editor, en het is niet moeilijk om je een toekomst voor te stellen waarin deze workflow standaard wordt. Net zoals we nu tools als Premiere Pro of DaVinci Resolve vanzelfsprekend vinden, kan iets als Flow over een paar jaar de norm zijn.

Flow is momenteel alleen beschikbaar in de VS en je krijgt er toegang toe via Google’s AI Pro- en AI Ultra-abonnementen.

Imagen 4

Een andere belangrijke aankondiging was Imagen 4, Google’s nieuwste model voor beeldgeneratie. Je kunt het rechtstreeks in Gemini gebruiken of binnen Whisk, Google’s designtool.

Google claimt verbeteringen over de hele linie—betere fotorealistische weergave, schonere details in close-ups, meer variatie in kunststijlen. Dat is prima, maar wat mijn aandacht trok, was de belofte van geavanceerde spelling en typografie. Als je de laatste tijd een beeldgenerator hebt gebruikt, heb je waarschijnlijk gezien dat de meeste nog steeds woorden verhaspelen of letters volledig vervormen.

Laten we een beeld bekijken dat Imagen 4 heeft gegenereerd:
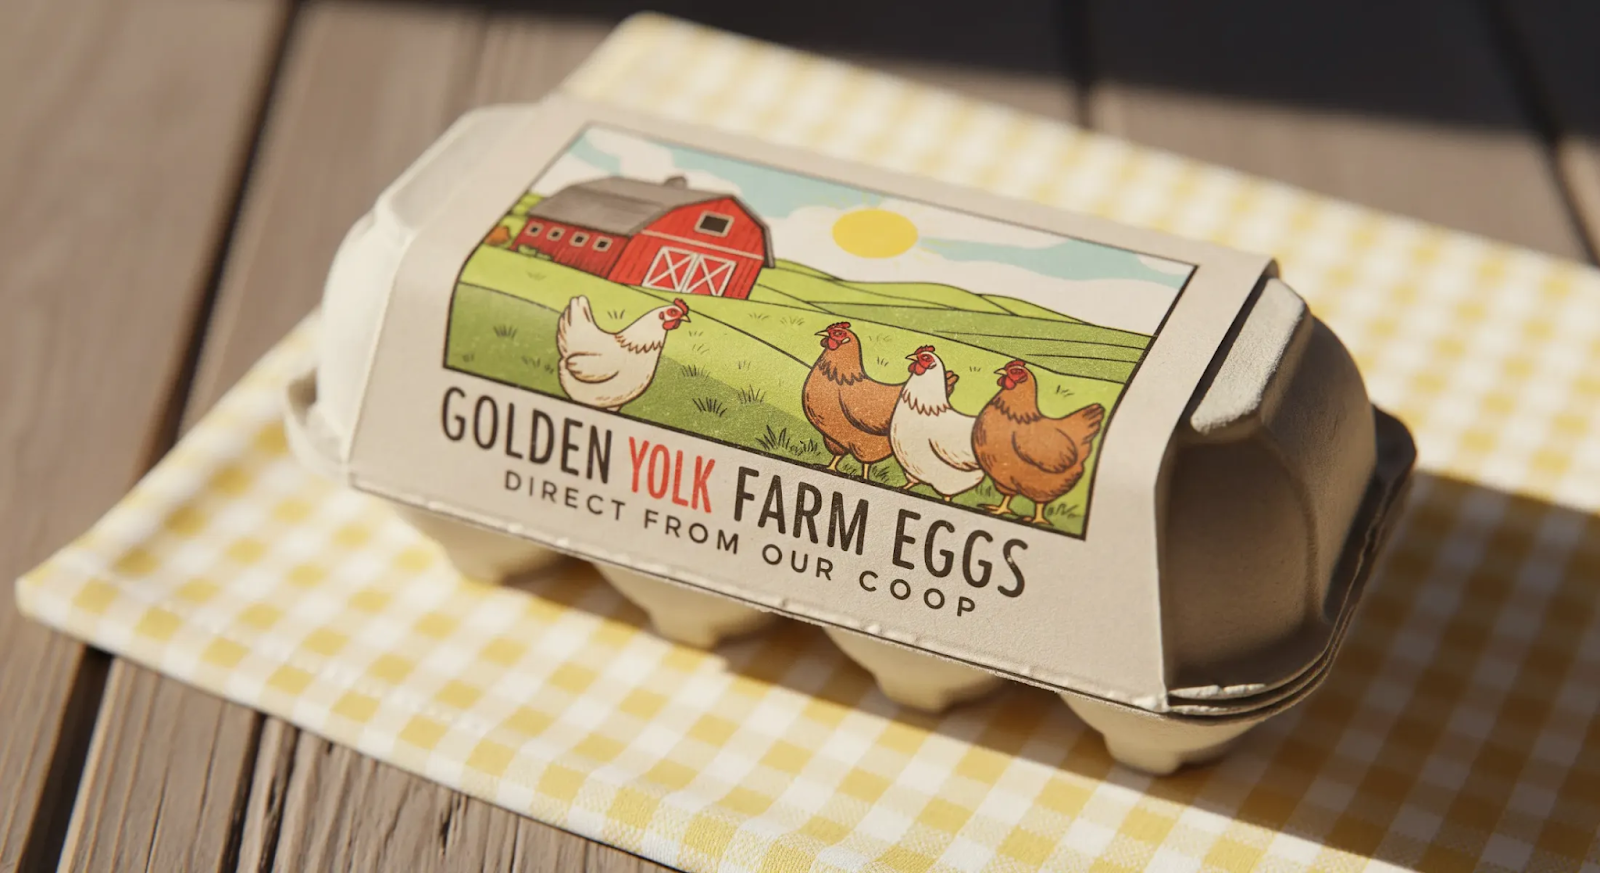
imagen 4 example

Bron: Google

Op dit moment zou ik zeggen dat de beeldgeneratie van GPT-4o de sterkste op de markt is. Maar het heeft nog steeds soms moeite met tekst en het trouw blijven aan de prompt. Als Imagen 4 spelling echt op orde krijgt en de intentie van de prompt vasthoudt, denk ik dat het een kans heeft om de leiding te nemen in beeldgeneratie.

Gemma 3n

Gemma 3n is Google’s nieuwste en capabelste on-device model. Als je niet bekend bent met de term: een on-device model draait direct op je telefoon, tablet of laptop—zonder data naar de cloud te hoeven sturen. Dat is om een paar redenen belangrijk: lagere latentie, betere privacy en offline beschikbaarheid.

Maar om dat te laten werken, moet het model klein genoeg zijn voor beperkte geheugencapaciteit, en toch krachtig genoeg om echte taken aan te kunnen. Dat is de uitdaging waar Gemma 3n voor staat.

Het is gebouwd op een nieuwe architectuur die het deelt met Gemini Nano—en de “n” in “3n” staat zelfs voor “nano”. Deze architectuur is geoptimaliseerd voor laag geheugengebruik, snelle responstijden en ondersteuning voor meerdere invoertypen zoals tekst, audio en beelden.

Gemma 3n komt in twee varianten, met parameters van 5B en 8B. Beide zijn ontworpen om efficiënt te draaien, met geheugenvereisten die dichter bij 2B- en 4B-modellen liggen dankzij enkele optimalisaties onder de motorkap.

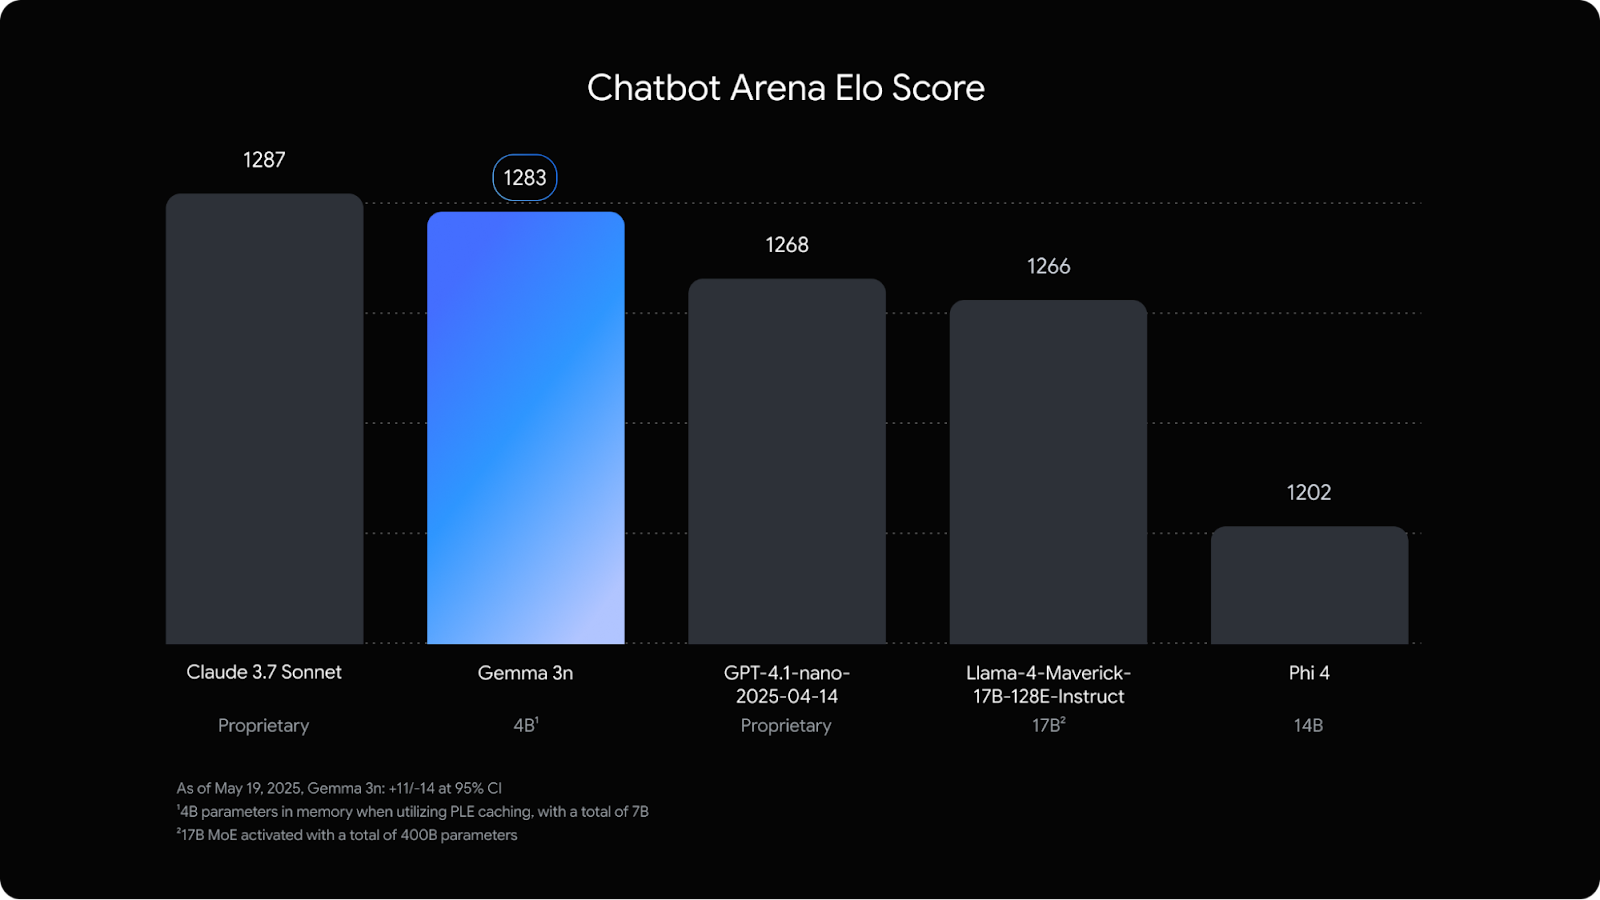
Wat ik echt opvallend vind, is dat het op de Chatbot Arena bijna op gelijke hoogte staat met Claude 3.7 Sonnet, een veel groter model.
gemma 3n chatbot arena elo score

Bron: Google

Deze release is vooral gericht op ontwikkelaars, met name degenen die mobiele of embedded apps bouwen die baat hebben bij lokale AI. Terwijl ons team bij DataCamp werkt aan nieuwe Gemma 3n-tutorials, raad ik aan om te beginnen met deze Gemma 3-blogs:

Gemini Diffusion

De technologie waar ik het meest nieuwsgierig naar ben is Gemini Diffusion.

Gemini Diffusion is een nieuwe experimentele modelarchitectuur die is ontworpen om snelheid en samenhang in tekstgeneratie te verbeteren. In tegenstelling tot traditionele taalmodellen die tokens één voor één in een vaste volgorde genereren, werken diffusie-modellen door ruis in meerdere stappen te verfijnen—een methode geleend uit beeldgeneratie.

In plaats van het volgende woord direct te voorspellen, begint Gemini Diffusion met een ruwe benadering en verbetert die iteratief. Daardoor is het beter in taken die baat hebben bij verfijning en foutcorrectie—zoals wiskunde, code en redactie.

Bron: Google

In vroege benchmarks zou het tot vijf keer sneller tokens genereren dan standaard autoregressieve modellen zoals Gemini 2.0 Flash-Lite, terwijl het vergelijkbare of betere prestaties levert op gestructureerde redeneertaken.

Op dit moment is de toegang beperkt tot geselecteerde testers. Er is geen openbare releasedatum aangekondigd. Meld je aan voor de wachtlijst op deze pagina.

Project Mariner

Project Mariner is Google’s visie op een AI-agent die rechtstreeks in de browser kan opereren. Het is ontworpen om te helpen bij complexe, meerstapse taken—zoals reisplanning, productonderzoek of het samenvatten van dense content over meerdere tabbladen.

In die zin lijkt het op Manus AI of OpenAI’s Operator, dat al beschikbaar is via ChatGPT. Laten we een voorbeeld van Mariner in actie bekijken:

Op dit moment is Mariner niet publiek beschikbaar, maar Google zegt dat bredere toegang eraan komt. Toegang voor ontwikkelaars wordt binnenkort verwacht via de Gemini API.

Bekijk hier meer voorbeelden:

Project Astra

Project Astra is Google DeepMind’s prototype voor een meer algemene AI-assistent—iets dat niet alleen reageert op prompts, maar kijkt, luistert, onthoudt en reageert. Het werd vorig jaar voor het eerst geïntroduceerd als een onderzoeksproject, en op I/O 2025 kregen we een beter beeld van wat het kan.

Laten we het in actie zien:

Dit is nog niet publiek beschikbaar, maar onderdelen van Astra vinden hun weg al naar Gemini Live, en een bredere uitrol wordt later verwacht. Of het een echt product wordt of in de onderzoeksfase blijft, moet nog blijken, maar de richting is duidelijk: dit ziet Google als de basis voor een universele AI-assistent.

AI-modus in Zoeken

AI-modus is Google’s nieuwe zoekervaring die meer aanvoelt als een chatbot dan als een zoekmachine. Het verschilt van AI Overviews, de korte AI-samenvattingen bovenaan de traditionele Google-resultatenpagina die we allemaal kennen. AI-modus neemt daarentegen de volledige interface over—het is een nieuwe tab waarin je complexe vragen kunt stellen en er gespreksonderwerpen op kunt volgen.

Laten we een voorbeeld bekijken:

Bron: Google

De interface lijkt erg op ChatGPT of Perplexity. Je voert een prompt in en de AI-modus reageert met langere, meer gestructureerde antwoorden, inclusief links, citaties, grafieken en soms zelfs een volledige onderzoeksuitwerking. Het gebruikt een “query fan-out”-aanpak om je vraag op te splitsen in deelonderwerpen en in één keer informatie van het hele web te halen.

Een opvallende functie is de integratie van de agentachtige mogelijkheden van Project Mariner. Dat kan tijd besparen bij taken als het kopen van evenemententickets, reserveringen maken of beschikbaarheid vinden op meerdere websites.

Het is duidelijk dat zoeken een fundamentele verschuiving doormaakt. We gaan van een model dat is gebouwd rond lijsten met links naar één dat draait om directe antwoorden, samenvattingen en het afronden van taken. Dat heeft grote gevolgen voor hoe informatie wordt getoond en geconsumeerd. De SEO- en contentmarketingsectoren merken de impact nu al.

AI-modus wordt nu uitgerold in de VS, met meer functies die de komende weken naar Labs komen. Je kunt het experiment inschakelen in Google Labs als je het vroeg wilt proberen.

Conclusie

Dat waren de belangrijkste AI-aankondigingen van dag 1 van I/O 2025. Zoals altijd is er veel ambitie te zien—maar de echte test is hoe deze tools presteren in de handen van alledaagse gebruikers en ontwikkelaars.

Een deel van deze technologie staat nog in de kinderschoenen of zit achter dure abonnementen, maar enkele functies worden al uitgerold naar alle gebruikers.


Alex Olteanu's photo
Author
Alex Olteanu
LinkedIn

Ik ben redacteur en schrijver van AI-blogs, tutorials en nieuws, en zorg ervoor dat alles past binnen een sterke contentstrategie en SEO-best practices. Ik heb datascience-cursussen geschreven over Python, statistiek, kansrekening en datavisualisatie. Ook heb ik een bekroonde roman gepubliceerd en besteed ik mijn vrije tijd aan scenarioschrijven en filmregie.

Onderwerpen
Kunstmatige intelligentie
Generative AI

Leer AI met deze cursussen!

Leerpad

AI-basisprincipes

10 uur
Ontdek de basis van AI, leer hoe je AI slim kunt gebruiken voor je werk en duik in modellen zoals ChatGPT om je weg te vinden in de dynamische wereld van AI.
Bekijk detailsStart Cursus

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.
Meer bekijken
Gerelateerd

blog

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer bekijken

