
原生音频输出是我至今在 Runway 或 Sora 中还没见到的功能。就目前而言,我会说 Veo 3 领先半步。
尽管演示看起来不错,但我深知演示视频很少能反映模型在实际中的表现。一旦提示偏离训练数据的“范式”——比如不熟悉的场景、怪异的人物,或含有太多微妙之处的想法——模型往往会“塌方”。我很期待亲自上手 Veo 3,看看它的真实水准。
访问 Veo 3 需要订阅 AI Ultra,价格为每月 250 美元。即便愿意付费,可用性也有限。目前它仅在美国开放,且只能通过 Google 新推出的 AI 驱动视频编辑器 Flow(下文会介绍)访问。
如果您对技术细节感兴趣,或想查看更多示例,请查看 Veo 的官方页面 here。
Flow
Flow 是一款 AI 电影制作工具,允许您结合使用 Veo、Imagen 和 Gemini 来生成独立镜头。
我觉得很实用的一点是,您可以创建独立的元素(称为“ingredients”),然后把它们组合成一个场景。这样能实现模块化控制,尤其是在您希望跨多个提示或镜头复用相同元素时格外有用。
来看一个示例:
Flow 内还提供了机位控制和转场工具,有助于让片段更具电影感。这些功能确实有用,但并不新鲜——Sora 和 Runway 已经提供了类似特性,所以我不认为这里有颠覆性突破。
尽管如此,仍值得关注此类工具的演进。Flow 更像是一款 AI 优先的视频编辑器的早期形态,不难想象未来这种工作流会成为标准。就像我们如今习以为常的 Premiere Pro 或 DaVinci Resolve,也许几年后,类似 Flow 的工具会成为常态。
Flow 目前仅在美国可用,您可通过 Google 的 AI Pro 与 AI Ultra 订阅访问。
Imagen 4
另一个重要发布是 Imagen 4,即 Google 最新的图像生成模型。您可以在 Gemini 中直接使用,也可在 Whisk(Google 的设计工具)中使用。
Google 表示全面提升——更好的照片真实感、近景更干净的细节、更丰富的艺术风格。这些都不错,但最吸引我的是其承诺的高级拼写与字体表现。如果您最近用过任何图像生成器,可能会发现大多数仍然会把文字弄错,甚至把字母完全“变形”。
来看一张 Imagen 4 生成的图片:
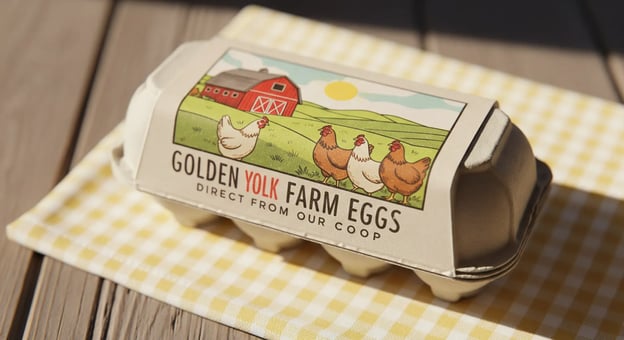
来源:Google
目前我会说,GPT-4o 的图像生成是市面上最强的。不过,它在文本处理和遵循提示方面有时仍会失手。如果 Imagen 4 真的能把拼写处理好、并紧扣提示意图,我认为它有机会在图像生成上后来居上。
Gemma 3n
Gemma 3n 是 Google 最新、能力最强的端侧模型。如果您对这个术语不熟悉,端侧模型就是直接在您的手机、平板或笔记本上运行——无需把数据发送到云端。这对降低时延、提升隐私和离线可用性都很重要。
但要实现这些,模型既要足够小,能适应有限的内存;又要足够强,能胜任真实任务。Gemma 3n 正是在迎接这一挑战。
它基于与 Gemini Nano 共享的新架构构建——事实上,“3n”中的“n”就代表“nano”。该架构针对低内存占用、快速响应,以及对文本、音频、图像等多种输入类型的支持进行了优化。
Gemma 3n 提供两个变体,参数规模分别为 5B 与 8B。两者都以高效运行为目标,通过底层多项优化,将内存需求压近 2B 与 4B 模型的水平。
让我尤为惊讶的是,它在 Chatbot Arena 上的表现几乎接近Claude 3.7 Sonnet,而后者是大得多的模型。
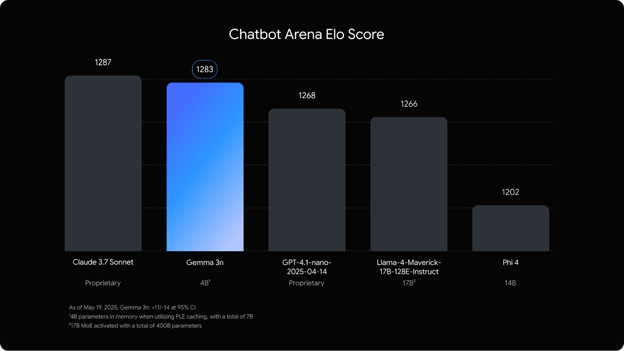
来源:Google
此次发布主要面向开发者,尤其是构建可从本地 AI 受益的移动或嵌入式应用的团队。我们的 DataCamp 团队正在制作全新的 Gemma 3n 教程,建议您先从这些 Gemma 3 相关博客入手:
Gemini Diffusion
我最感兴趣的技术是 Gemini Diffusion。
Gemini Diffusion 是一种新的实验性模型架构,旨在提升文本生成的速度与连贯性。与按固定序列逐 token 生成的传统语言模型不同,扩散模型通过多步“去噪”来精炼结果——这一方法源自图像生成。
Gemini Diffusion 并非直接预测下一个词,而是从一个粗略近似开始并不断迭代改进,这让它更擅长那些受益于反复打磨与纠错的任务——例如数学、代码与编辑。
早期基准测试显示,相比 Gemini 2.0 Flash-Lite 等标准自回归模型,它的 token 生成速度可提升至多 5 倍,同时在结构化推理任务上取得相当或更好的表现。
目前仅向部分测试者开放,尚未公布公开发布时间。您可在此页面加入候补名单。
Project Mariner
Project Mariner 是 Google 针对可在浏览器内直接操作的 AI 代理的探索。它旨在助力复杂的多步骤任务——例如行程规划、产品调研,或在多个标签页中汇总密集内容。
从这个意义上讲,它与 Manus AI 或 OpenAI 的 Operator 类似,后者已可通过 ChatGPT 使用。来看 Mariner 的实操示例:
这暂未向公众开放,但 Astra 的部分能力已开始融入 Gemini Live,后续预计将更大范围推送。它最终会成为真正的产品还是停留在研究阶段仍待观察,但方向已经很明确:这就是 Google 眼中通用 AI 助手的基石。
搜索中的 AI 模式
AI 模式是 Google 的全新搜索体验,更像一个聊天机器人而非搜索引擎。它不同于 AI Overviews(AI 概览),后者是在我们熟悉的传统 Google 结果页顶部放置简短 AI 摘要。相比之下,AI 模式会接管整个界面——这是一个新标签页,您可以提出复杂问题并进行对话式追问。
来看一个示例:
界面看起来与 ChatGPT 或 Perplexity 很像。您输入提示,AI 模式会给出更长、更结构化的答案,包括链接、引文、图表,有时甚至是完整的研究分解。它采用“查询扇出”的方式,将您的问题拆解为子话题,并在一次处理过程中从全网抓取信息。
其中一个亮点是整合了 Project Mariner 的代理能力。它能为您在购票、预订或跨多个网站查找可用性等任务上节省时间。
显而易见,搜索正在发生根本性转变。我们正从以链接列表为中心的模式,转向以直接答案、摘要与任务完成为中心的模式。这将深刻影响信息的呈现与消费方式。SEO 与内容营销行业已经感受到了影响。
AI 模式已在美国开始上线,更多功能将在接下来几周登陆 Labs。若想提前试用,可在 Google Labs 中启用该实验。
结语
以上便是 I/O 2025 首日最重要的 AI 发布。和往常一样,雄心勃勃不在少数——但真正的考验在于这些工具在普通用户与开发者手中的实际表现。
有些技术仍处于早期阶段,或被高价订阅所“圈定”,但也有一些功能已经开始面向所有用户推送。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
Google I/O 2025 的第一天已经结束。本文将带您梳理对 AI 行业最重要的发布。
我将重点关注已经可用或即将发布的更新,并在过程中分享一些快速印象,必要时也会与竞品做个对比,帮助您把握背景。
我们通过免费周五通讯 The Median 为读者带来最新 AI 动态,梳理本周关键信息。订阅即可用几分钟保持敏锐:
Veo 3
Veo 3 让我眼前一亮的一点是它原生支持音频输出。现在,您可以直接生成带声音的视频,无需额外编辑步骤。来看一个示例: