
Chuyển đến nội dung chính
Trí tuệ Nhân tạo
AI sinh sinh

Google I/O 2025: 8 thông báo AI hàng đầu (và góc nhìn của tôi)

Tìm hiểu những thông báo AI quan trọng nhất tại Google I/O 2025—Veo 3, Flow, Imagen 4 và hơn thế nữa—kèm ấn tượng ban đầu.
Alex Olteanu's photo
Alex Olteanu
Đã cập nhật · 8 phút đọc

Khám phá cùng AI

ChatGPTClaudePerplexity

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.

Ngày đầu tiên của Google I/O 2025 đã khép lại. Trong bài viết này, tôi sẽ điểm qua những thông báo quan trọng nhất đối với ngành AI.

Tôi sẽ tập trung vào các cập nhật đã sẵn sàng sử dụng hoặc dự kiến phát hành sớm. Xen kẽ, tôi sẽ chia sẻ vài ấn tượng nhanh và, khi phù hợp, đặt chúng trong bối cảnh cạnh tranh.

Chúng tôi liên tục cập nhật cho độc giả những tin tức mới nhất về AI qua The Median, bản tin miễn phí vào thứ Sáu của chúng tôi, tóm lược các câu chuyện nổi bật trong tuần. Đăng ký để luôn nhạy bén chỉ với vài phút mỗi tuần:

Veo 3

Điểm khiến tôi chú ý ở Veo 3 là đầu ra âm thanh gốc (native). Giờ đây bạn có thể tạo video kèm âm thanh trực tiếp, không cần bước biên tập thêm. Cùng xem một ví dụ:

Nguồn: Google

Đầu ra âm thanh gốc là điều tôi chưa thấy trong Runway hay Sora. Ở thời điểm này, tôi cho rằng Veo 3 đang đi trước một bước.

Dù bản demo trông ấn tượng, tôi đã rút kinh nghiệm rằng video demo hiếm khi phản ánh đúng cách các mô hình hoạt động thực tế. Chỉ cần prompt lệch khỏi dạng dữ liệu huấn luyện—một bối cảnh lạ, một nhân vật kỳ quặc, hay một ý tưởng quá tinh tế—mô hình thường sụp đổ. Tôi rất mong sớm được thử Veo 3 để xem khả năng thực sự thế nào.

Truy cập Veo 3 yêu cầu gói đăng ký AI Ultra, với chi phí 250 đô/tháng. Ngay cả khi bạn sẵn sàng chi trả, quyền truy cập vẫn hạn chế. Hiện tại, nó chỉ khả dụng ở Mỹ và chỉ trong trình biên tập video tích hợp AI mới của Google tên là Flow (chúng ta sẽ đề cập ngay sau đây).

Nếu bạn quan tâm đến chi tiết kỹ thuật hoặc muốn xem thêm ví dụ, hãy xem trang chính thức của Veo tại đây.

Flow 

Flow là công cụ làm phim bằng AI cho phép bạn tạo từng cảnh quay riêng lẻ bằng cách kết hợp Veo, Imagen và Gemini.

Điểm tôi thấy hữu ích là bạn có thể tạo các thành phần riêng lẻ (gọi là “ingredients”) rồi nhóm chúng lại thành một cảnh. Cách này cho phép kiểm soát theo mô-đun và đặc biệt hữu ích khi bạn muốn tái sử dụng cùng thành phần cho nhiều prompt hoặc cảnh quay khác nhau.

Cùng xem một ví dụ:

Nguồn: Google

Flow cũng có các công cụ điều khiển máy quay và chuyển cảnh, giúp clip có cảm giác điện ảnh hơn. Những tính năng này hữu ích nhưng không mới—Sora và Runway đã có các tính năng tương tự, nên tôi không cho rằng đây là đột phá.

Dù vậy, vẫn đáng theo dõi cách các công cụ này phát triển. Flow mang cảm giác của một phiên bản đầu của trình biên tập video ưu tiên AI, và không khó để hình dung tương lai khi quy trình như vậy trở thành tiêu chuẩn. Cũng như chúng ta coi Premiere Pro hay DaVinci Resolve là điều hiển nhiên ngày nay, một công cụ như Flow có thể trở thành chuẩn mực trong vài năm tới.

Flow hiện chỉ khả dụng ở Mỹ, và bạn có thể truy cập qua các gói AI Pro và AI Ultra của Google.

Imagen 4

Một thông báo quan trọng khác là Imagen 4, mô hình tạo ảnh mới nhất của Google. Bạn có thể dùng trực tiếp trong Gemini hoặc trong Whisk, công cụ thiết kế của Google.

Google cho biết đã cải thiện trên toàn diện—tính chân thực cao hơn, chi tiết cận cảnh sạch hơn, đa dạng phong cách nghệ thuật hơn. Tất cả đều ổn, nhưng điều thu hút tôi là lời hứa về khả năng chính tả và kiểu chữ nâng cao. Nếu bạn từng dùng các trình tạo ảnh gần đây, hẳn thấy hầu hết vẫn sai chữ hoặc làm biến dạng ký tự.

Hãy xem một bức ảnh do Imagen 4 tạo:
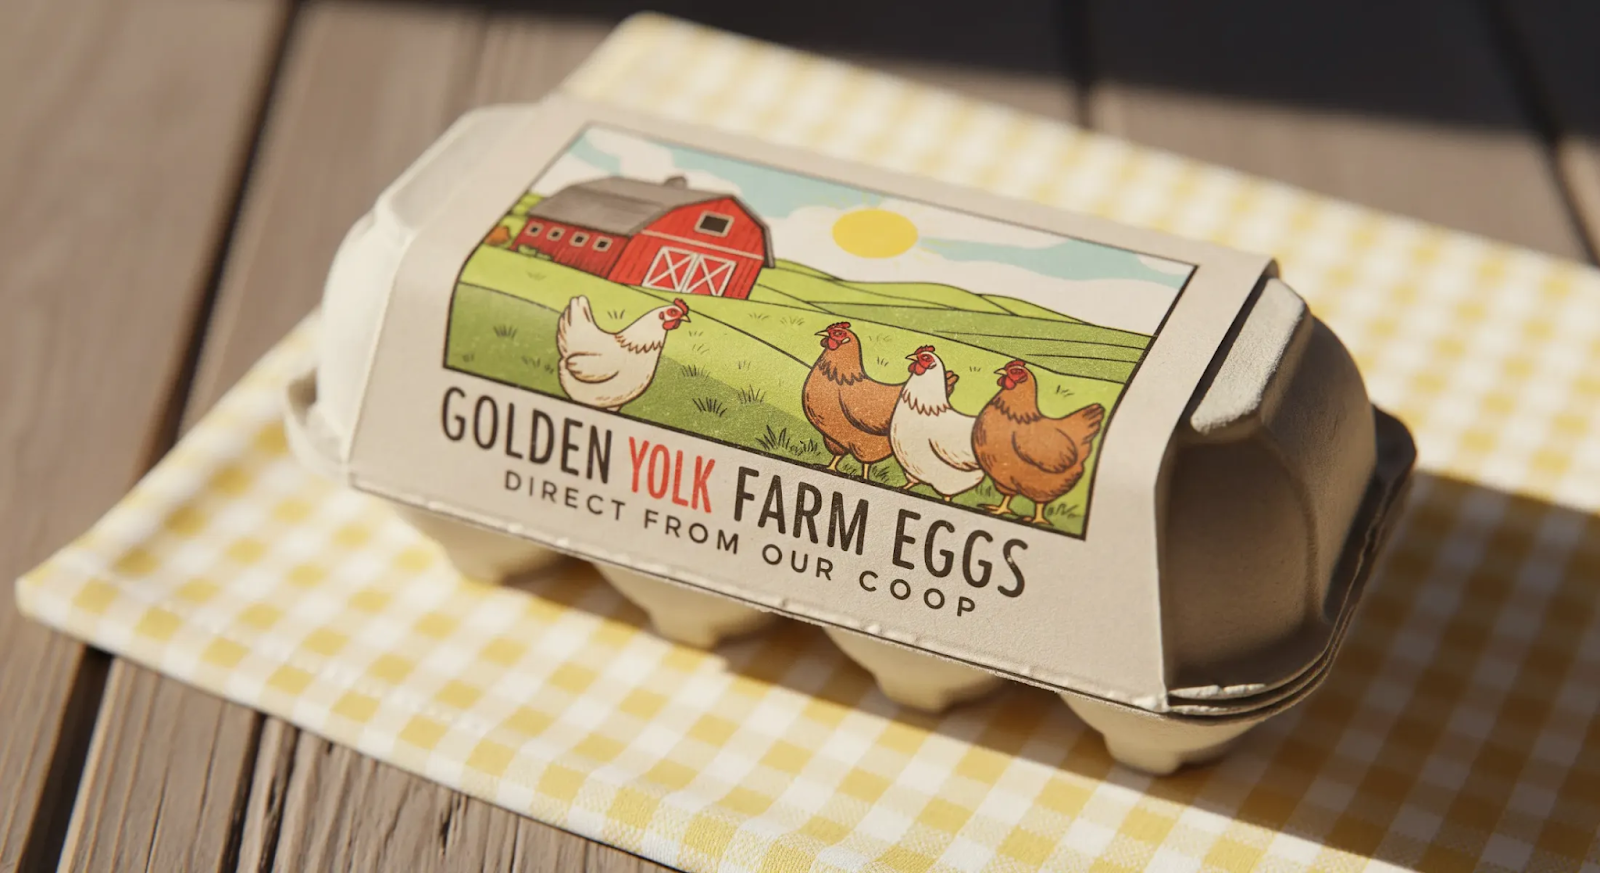
imagen 4 example

Nguồn: Google

Hiện tại, tôi cho rằng khả năng tạo ảnh của GPT-4o là mạnh nhất thị trường. Tuy nhiên, nó vẫn đôi khi gặp khó với văn bản và bám sát prompt. Nếu Imagen 4 thực sự xử lý chính tả chuẩn và giữ được ý định của prompt, tôi nghĩ nó có cơ hội vươn lên dẫn đầu mảng tạo ảnh.

Gemma 3n

Gemma 3n là mô hình on-device mới nhất và mạnh nhất của Google. Nếu bạn chưa quen với thuật ngữ này, mô hình on-device là mô hình chạy trực tiếp trên điện thoại, máy tính bảng hoặc laptop của bạn—không cần gửi dữ liệu lên đám mây. Điều này quan trọng vì: độ trễ thấp, quyền riêng tư tốt hơn và khả năng dùng ngoại tuyến.

Nhưng để làm được vậy, mô hình phải đủ nhỏ để vừa với bộ nhớ hạn chế, đồng thời đủ mạnh để xử lý tác vụ thực. Đó là thách thức mà Gemma 3n hướng tới.

Nó được xây dựng trên kiến trúc mới dùng chung với Gemini Nano—và thực tế, chữ “n” trong “3n” là viết tắt của “nano.” Kiến trúc này được tối ưu cho mức dùng bộ nhớ thấp, phản hồi nhanh, và hỗ trợ nhiều kiểu đầu vào như văn bản, âm thanh, hình ảnh.

Gemma 3n có hai biến thể, với kích thước tham số 5B và 8B. Cả hai được thiết kế để chạy hiệu quả, với yêu cầu bộ nhớ tiệm cận các mô hình 2B và 4B nhờ một số tối ưu bên trong.

Điều khiến tôi ấn tượng là nó gần như ngang ngửa trên Chatbot Arena với Claude 3.7 Sonnet, một mô hình lớn hơn nhiều.
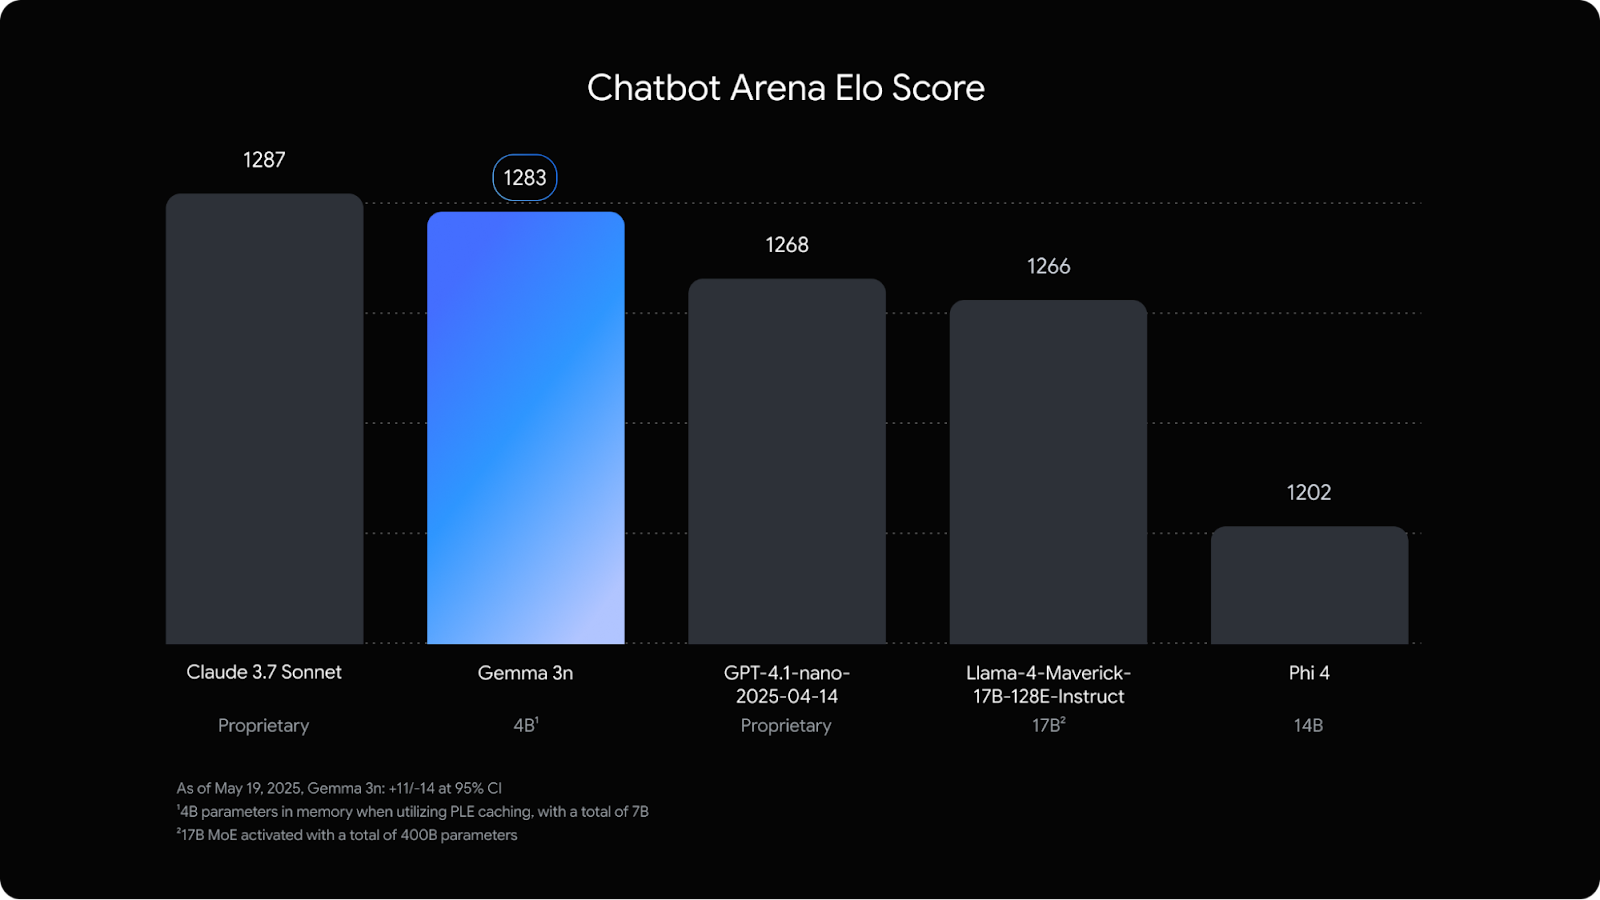
gemma 3n chatbot arena elo score

Nguồn: Google

Bản phát hành này chủ yếu nhắm tới nhà phát triển, đặc biệt là những người xây dựng ứng dụng di động hoặc nhúng có thể hưởng lợi từ AI cục bộ. Trong khi đội ngũ DataCamp của chúng tôi đang thực hiện các hướng dẫn Gemma 3n mới, tôi khuyến nghị bắt đầu với các bài blog Gemma 3 này:

Gemini Diffusion

Công nghệ tôi tò mò nhất là Gemini Diffusion.

Gemini Diffusion là kiến trúc mô hình thử nghiệm mới được thiết kế để cải thiện tốc độ và tính mạch lạc trong sinh văn bản. Khác với các mô hình ngôn ngữ truyền thống tạo từng token theo chuỗi cố định, mô hình diffusion hoạt động bằng cách tinh lọc nhiễu qua nhiều bước—một phương pháp mượn từ tạo ảnh.

Thay vì dự đoán trực tiếp từ kế tiếp, Gemini Diffusion bắt đầu với một bản xấp xỉ thô và cải thiện lặp dần, nhờ đó tốt hơn ở các tác vụ hưởng lợi từ tinh chỉnh và sửa lỗi—như toán, mã nguồn, và biên tập.

Nguồn: Google

Trong các benchmark ban đầu, nó được ghi nhận có thể sinh token nhanh gấp năm lần so với các mô hình tự hồi quy tiêu chuẩn như Gemini 2.0 Flash-Lite, đồng thời cho hiệu năng tương đương hoặc tốt hơn ở các bài toán suy luận có cấu trúc.

Hiện quyền truy cập chỉ dành cho một số người thử nghiệm được chọn. Chưa có ngày phát hành công khai. Tham gia danh sách chờ tại trang này.

Project Mariner

Project Mariner là cách tiếp cận của Google về một tác tử AI có thể vận hành trực tiếp trong trình duyệt. Nó được thiết kế để hỗ trợ các tác vụ phức tạp, nhiều bước—như lên kế hoạch chuyến đi, nghiên cứu sản phẩm, hoặc tóm tắt nội dung dày đặc trên nhiều thẻ.

Theo nghĩa đó, nó tương tự Manus AI hoặc Operator của OpenAI, vốn đã có trong ChatGPT. Cùng xem Mariner hoạt động thế nào:

Hiện Mariner chưa mở cho công chúng, nhưng Google cho biết sẽ sớm mở rộng quyền truy cập. Quyền truy cập cho nhà phát triển dự kiến có sớm qua Gemini API.

Xem thêm ví dụ tại đây:

Project Astra

Project Astra là nguyên mẫu của Google DeepMind cho một trợ lý AI đa năng hơn—không chỉ phản hồi prompt mà còn có thể nhìn, lắng nghe, ghi nhớ và phản ứng. Dự án được giới thiệu lần đầu năm ngoái như một nghiên cứu, và tại I/O 2025, chúng ta có cái nhìn rõ hơn về những gì nó làm được.

Cùng xem nó hoạt động:

Công nghệ này chưa mở cho công chúng, nhưng một phần của Astra đã dần tích hợp vào Gemini Live, và sẽ mở rộng hơn sau đó. Liệu nó trở thành sản phẩm thực thụ hay dừng ở giai đoạn nghiên cứu còn phải chờ xem, nhưng hướng đi thì rõ ràng: đây là nền tảng cho một trợ lý AI phổ quát theo tầm nhìn của Google.

AI Mode trong Tìm kiếm

AI Mode là trải nghiệm tìm kiếm mới của Google, mang cảm giác giống chatbot hơn là công cụ tìm kiếm. Nó khác với AI Overviews, tức các tóm tắt AI ngắn hiển thị phía trên trang kết quả Google truyền thống mà chúng ta quen thuộc. Trái lại, AI Mode chiếm toàn bộ giao diện—đó là một tab mới nơi bạn có thể đặt câu hỏi phức tạp và tiếp tục trao đổi theo ngữ cảnh hội thoại.

Cùng xem một ví dụ:

Nguồn: Google

Giao diện trông khá giống ChatGPT hoặc Perplexity. Bạn nhập prompt, và AI Mode phản hồi bằng các câu trả lời dài, có cấu trúc hơn, kèm liên kết, trích dẫn, biểu đồ và đôi khi là cả một bản phân tích nghiên cứu đầy đủ. Nó sử dụng cách tiếp cận “query fan-out” để chia câu hỏi thành các chủ đề nhỏ và truy xuất trên toàn web, chỉ trong một lượt.

Một điểm đáng chú ý là tích hợp năng lực tác tử của Project Mariner. Điều này giúp bạn tiết kiệm thời gian cho các tác vụ như mua vé sự kiện, đặt chỗ, hoặc tìm lịch trống trên nhiều website.

Rõ ràng tìm kiếm đang chuyển dịch căn bản. Chúng ta đang rời xa mô hình xoay quanh danh sách liên kết để hướng tới câu trả lời trực tiếp, tóm tắt và hoàn tất tác vụ. Điều này tác động lớn đến cách thông tin được hiển thị và tiêu thụ. Ngành SEO và tiếp thị nội dung đã bắt đầu thấy ảnh hưởng.

AI Mode đang được triển khai tại Mỹ, với nhiều tính năng sẽ xuất hiện trên Labs trong vài tuần tới. Bạn có thể bật thử nghiệm trong Google Labs nếu muốn dùng sớm.

Kết luận

Trên đây là những thông báo AI quan trọng nhất trong ngày đầu tiên của I/O 2025. Như thường lệ, tham vọng là rất lớn—nhưng bài kiểm tra thực sự là cách các công cụ này hoạt động trong tay người dùng và nhà phát triển hằng ngày.

Một phần công nghệ vẫn còn sớm hoặc bị giới hạn sau các gói đăng ký đắt đỏ, nhưng một vài tính năng đã bắt đầu đến tay tất cả người dùng.


Alex Olteanu's photo
Author
Alex Olteanu
LinkedIn

Tôi là biên tập viên và tác giả phụ trách blog, hướng dẫn và tin tức về AI, bảo đảm mọi nội dung phù hợp với chiến lược nội dung vững chắc và các thực tiễn SEO tốt nhất. Tôi đã viết các khóa học khoa học dữ liệu về Python, thống kê, xác suất và trực quan hóa dữ liệu. Tôi cũng đã xuất bản một tiểu thuyết đoạt giải và dành thời gian rảnh cho việc viết kịch bản và đạo diễn phim.

Chủ đề
Trí tuệ Nhân tạo
AI sinh sinh

Học AI với các khóa học này!

Lộ trình

Cơ bản về Trí tuệ Nhân tạo

10 giờ
Khám phá những kiến thức cơ bản về Trí tuệ Nhân tạo (AI), học cách ứng dụng AI một cách hiệu quả trong công việc, và tìm hiểu sâu về các mô hình như ChatGPT để nắm bắt xu hướng phát triển của lĩnh vực AI.
Xem chi tiếtBắt Đầu Khóa Học

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.
Xem thêm
Liên quan

blog

Claude Opus 4.6: Tính năng, Điểm chuẩn, Bài kiểm tra thực hành và hơn thế nữa

Mô hình mới nhất của Anthropic dẫn đầu ở mã hóa tác tử và lập luận phức tạp. Thêm vào đó, nó có cửa sổ ngữ cảnh 1M.
Matt Crabtree's photo

Matt Crabtree

10 phút

Xem thêm