
नेटिव ऑडियो आउटपुट ऐसी चीज़ है जो मैंने अभी तक Runway या Sora में नहीं देखी है। इस समय, मैं कहूँगा कि Veo 3 एक कदम आगे है।
डेमो अच्छा दिखता है, लेकिन मैंने सीखा है कि डेमो वीडियो शायद ही कभी यह दिखाते हैं कि ये मॉडल व्यवहार में कैसे काम करते हैं। जैसे ही प्रॉम्प्ट ट्रेनिंग डेटा के दायरे से बाहर जाता है—कोई अनजाना दृश्य, अजीब कैरेक्टर, या बहुत सूक्ष्म विचार—मॉडल अक्सर बिखर जाता है। मैं Veo 3 को इस्तेमाल कर देखने के लिए उत्सुक हूँ कि यह कितना अच्छा प्रदर्शन करता है।
Veo 3 तक पहुँच के लिए AI Ultra सदस्यता चाहिए, जिसकी कीमत $250/माह है। भुगतान करने की इच्छा होने पर भी उपलब्धता सीमित है। अभी के लिए, यह केवल अमेरिका में और केवल Google के नए AI-समर्थित वीडियो एडिटर Flow के भीतर उपलब्ध है (जिस पर हम अगला भाग कवर करेंगे)।
यदि आप तकनीकी विवरणों के बारे में जिज्ञासु हैं या अधिक उदाहरण देखना चाहते हैं, तो Veo का आधिकारिक पेज यहाँ देखें।
Flow
Flow एक AI फिल्ममेकिंग टूल है जो Veo, Imagen और Gemini के संयोजन से अलग-अलग शॉट्स जेनरेट करने देता है।
एक उपयोगी बात यह है कि आप अलग-अलग तत्व (जिन्हें “ingredients” कहा गया है) बना सकते हैं और फिर उन्हें एक सीन में समूहित कर सकते हैं। इससे आपको मॉड्यूलर नियंत्रण मिलता है और यह विशेष रूप से तब मददगार होता है जब आप वही तत्व कई प्रॉम्प्ट्स या शॉट्स में दोबारा उपयोग करना चाहते हैं।
एक उदाहरण देखते हैं:
Flow में कैमरा कंट्रोल और ट्रांज़िशन के लिए भी टूल हैं, जो क्लिप्स को अधिक सिनेमाई अहसास देते हैं। ये उपयोगी हैं, पर नए नहीं—Sora और Runway पहले से ऐसी सुविधाएँ देते हैं, इसलिए मैं इसे क्रांतिकारी नहीं कहूँगा।
फिर भी, ऐसे टूल्स के विकास पर नज़र रखना ज़रूरी है। Flow एक AI-प्रथम वीडियो एडिटर का शुरुआती संस्करण लगता है, और यह सोचना मुश्किल नहीं कि भविष्य में ऐसा वर्कफ़्लो मानक बन जाए। जैसे आज हम Premiere Pro या DaVinci Resolve जैसे टूल्स को सामान्य मानते हैं, कुछ सालों में Flow जैसा कुछ मानक बन सकता है।
Flow फिलहाल केवल अमेरिका में उपलब्ध है, और इसे Google की AI Pro और AI Ultra सदस्यताओं के जरिए एक्सेस किया जा सकता है।
Imagen 4
एक और महत्वपूर्ण घोषणा थी Imagen 4, Google का नवीनतम इमेज जेनरेशन मॉडल। आप इसे सीधे Gemini में या Whisk, Google के डिज़ाइन टूल, के भीतर इस्तेमाल कर सकते हैं।
Google के अनुसार, हर क्षेत्र में सुधार हैं—बेहतर फ़ोटो-यथार्थवाद, क्लोज़-अप्स में साफ़ डिटेल्स, कला शैलियों में अधिक विविधता। यह सब ठीक है, लेकिन जिसने मेरा ध्यान खींचा वह उन्नत स्पेलिंग और टाइपोग्राफी का वादा है। अगर आपने हाल में कोई इमेज जेनरेटर इस्तेमाल किया है, तो आपने देखा होगा कि उनमें से अधिकतर अब भी शब्दों को बिगाड़ देते हैं या अक्षरों को तोड़-मरोड़ देते हैं।
आइए Imagen 4 द्वारा बनाई एक छवि देखें:
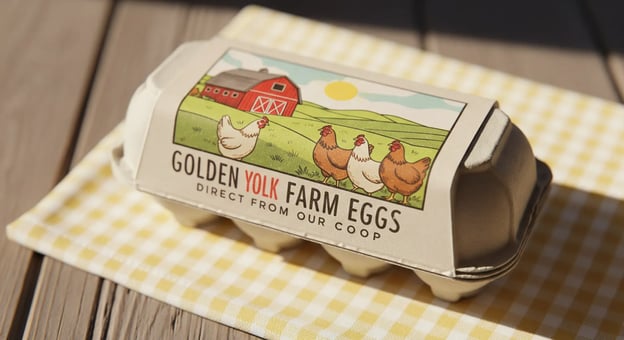
स्रोत: Google
अभी की स्थिति में, मैं कहूँगा कि GPT-4o की इमेज जेनरेशन बाज़ार में सबसे मज़बूत है। हालाँकि, यह अब भी कभी-कभी टेक्स्ट और प्रॉम्प्ट अनुपालन में संघर्ष करता है। अगर Imagen 4 सच में स्पेलिंग को सही रखता है और प्रॉम्प्ट की मंशा को थामे रखता है, तो मुझे लगता है कि इसमें इमेज जेनरेशन में बढ़त लेने की पूरी संभावना है।
Gemma 3n
Gemma 3n Google का नवीनतम और अब तक का सबसे सक्षम ऑन-डिवाइस मॉडल है। यदि आप इस शब्द से परिचित नहीं हैं, तो ऑन-डिवाइस मॉडल वह होता है जो सीधे आपके फ़ोन, टैबलेट या लैपटॉप पर चलता है—यानि डेटा को क्लाउड पर भेजने की ज़रूरत नहीं। यह कई कारणों से मायने रखता है: कम विलंबता, बेहतर गोपनीयता, और ऑफ़लाइन उपलब्धता।
लेकिन ऐसा होने के लिए, मॉडल इतना छोटा होना चाहिए कि सीमित मेमोरी में फिट हो सके, और इतना शक्तिशाली भी कि वास्तविक कार्य सँभाल सके। यही चुनौती Gemma 3n लेने की कोशिश कर रहा है।
यह Gemini Nano के साथ साझा एक नए आर्किटेक्चर पर बना है—और दरअसल “3n” में “n” का अर्थ “nano” है। यह आर्किटेक्चर कम मेमोरी उपयोग, तेज़ प्रतिक्रिया समय, और टेक्स्ट, ऑडियो व इमेज जैसे अनेक इनपुट प्रकारों के समर्थन के लिए अनुकूलित है।
Gemma 3n दो रूपों में आता है, जिनके पैरामीटर आकार 5B और 8B हैं। दोनों को कुशलतापूर्वक चलने के लिए डिज़ाइन किया गया है, और कुछ अंदरूनी अनुकूलनों के कारण इनकी मेमोरी आवश्यकता 2B और 4B मॉडलों के क़रीब बैठती है।
जिस बात ने मुझे वास्तव में चकित किया, वह यह है कि यह Chatbot Arena पर Claude 3.7 Sonnet जैसे कहीं बड़े मॉडल के लगभग बराबर है।
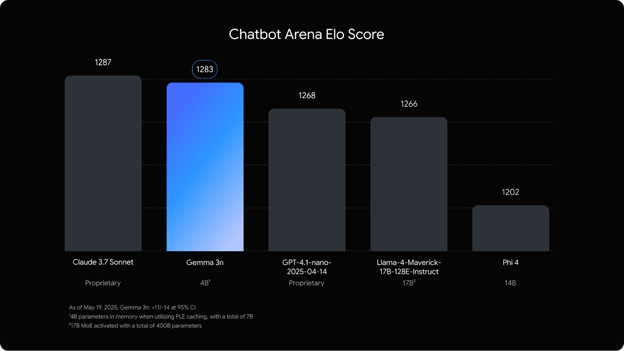
स्रोत: Google
यह रिलीज़ मुख्यतः डेवलपर्स के लिए है, खासकर वे जो मोबाइल या एम्बेडेड एप्लिकेशंस बना रहे हैं जिन्हें लोकल AI से लाभ मिल सकता है। जबकि हमारी DataCamp टीम नए Gemma 3n ट्यूटोरियल्स पर काम कर रही है, मैं इन Gemma 3 ब्लॉग्स से शुरुआत करने की सलाह देता हूँ:
- Gemma 3 को लोकल रूप से Ollama के साथ सेट अप और रन कैसे करें
- Gemma 3 का फाइन-ट्यून: चरण-दर-चरण मार्गदर्शिका
Gemini Diffusion
जिस तकनीक को लेकर मैं सबसे अधिक जिज्ञासु हूँ, वह है Gemini Diffusion।
Gemini Diffusion एक नया प्रायोगिक मॉडल आर्किटेक्चर है, जिसे टेक्स्ट जेनरेशन में गति और सामंजस्य सुधारने के लिए डिज़ाइन किया गया है। पारंपरिक भाषा मॉडलों के विपरीत, जो फिक्स्ड क्रम में एक-एक टोकन जनरेट करते हैं, डिफ्यूज़न मॉडल शोर को कई चरणों में परिष्कृत करके काम करते हैं—यह विधि इमेज जेनरेशन से ली गई है।
अगला शब्द सीधे भविष्यवाणी करने के बजाय, Gemini Diffusion एक मोटे-तौर पर अनुमान से शुरू करता है और उसे क्रमशः बेहतर बनाता जाता है, जिससे यह उन कार्यों में बेहतर साबित होता है जिन्हें परिष्करण और त्रुटि-सुधार का लाभ मिलता है—जैसे गणित, कोड, और संपादन।
प्रारंभिक बेंचमार्क्स में, बताया गया है कि यह Gemini 2.0 Flash-Lite जैसे मानक ऑटोरेग्रेसीव मॉडलों की तुलना में पाँच गुना तक तेज़ी से टोकन जनरेट कर सकता है, जबकि संरचित तर्क कार्यों पर समान या बेहतर प्रदर्शन देता है।
अभी के लिए, एक्सेस चुनिंदा टेस्टर्स तक सीमित है। सार्वजनिक रिलीज़ डेट की घोषणा नहीं हुई है। प्रतीक्षा सूची में शामिल होने के लिए इस पेज पर जाएँ।
Project Mariner
Project Mariner एक ऐसा AI एजेंट है जो सीधे ब्राउज़र में काम कर सकता है—इस पर Google का दृष्टिकोण। इसे जटिल, बहु-चरणीय कार्यों में मदद के लिए डिज़ाइन किया गया है—जैसे यात्रा योजना बनाना, उत्पाद अनुसंधान, या कई टैब्स में फैली घनी सामग्री का सार निकालना।
इस अर्थ में, यह Manus AI या OpenAI के Operator जैसा है, जो ChatGPT के माध्यम से पहले से उपलब्ध है। आइए Mariner को क्रिया में देखते हैं:
अभी Mariner सार्वजनिक रूप से उपलब्ध नहीं है, लेकिन Google का कहना है कि व्यापक पहुँच आने वाली है। डेवलपर एक्सेस जल्द ही Gemini API के माध्यम से अपेक्षित है।
यहाँ और उदाहरण देखें:
Project Astra
Project Astra Google DeepMind का एक प्रोटोटाइप है एक अधिक सामान्य-उद्देश्य वाले AI सहायक का—कुछ ऐसा जो सिर्फ़ प्रॉम्प्ट्स का उत्तर ही नहीं देता, बल्कि देखता, सुनता, याद रखता और प्रतिक्रिया भी करता है। इसे पहली बार पिछले साल एक रिसर्च प्रोजेक्ट के रूप में पेश किया गया था, और I/O 2025 में हमें इसकी क्षमताओं की बेहतर झलक मिली।
आइए इसे क्रिया में देखें:
यह अभी आम उपयोगकर्ताओं के लिए उपलब्ध नहीं है, लेकिन Astra के कुछ हिस्से पहले से Gemini Live में आ रहे हैं, और आगे व्यापक रोलआउट की उम्मीद है। यह वास्तविक उत्पाद बनता है या शोध के चरण में ही रहता है, यह देखना बाकी है, लेकिन दिशा स्पष्ट है: Google इसे एक सार्वभौमिक AI सहायक की बुनियाद के रूप में देखता है।
सर्च में AI मोड
AI मोड Google का नया सर्च अनुभव है जो सर्च इंजन से ज़्यादा एक चैटबॉट जैसा लगता है। यह AI Overviews से अलग है, जो पारंपरिक Google परिणाम पेज के शीर्ष पर छोटे-छोटे AI सारांश दिखाता है, जिससे हम सब परिचित हैं। इसके विपरीत, AI मोड पूरा इंटरफ़ेस अपने हाथ में ले लेता है—यह एक नया टैब है जहाँ आप जटिल प्रश्न पूछ सकते हैं और बातचीत की तरह फॉलो-अप कर सकते हैं।
एक उदाहरण देखते हैं:
इंटरफ़ेस ChatGPT या Perplexity जैसा दिखता है। आप प्रॉम्प्ट दर्ज करते हैं, और AI मोड लिंक, संदर्भ, चार्ट्स, और कभी-कभी पूरे शोध विश्लेषण समेत लंबे, अधिक संरचित उत्तर देता है। यह “क्वेरी फैन-आउट” दृष्टिकोण का उपयोग करता है, जो आपके प्रश्न को उप-विषयों में बाँटकर वेब भर से एक ही पास में सामग्री जुटाता है।
एक उल्लेखनीय फ़ीचर है Project Mariner की एजेंटिक क्षमताओं का एकीकरण। यह इवेंट टिकट खरीदने, आरक्षण कराने, या कई वेबसाइट्स पर उपलब्धता खोजने जैसे कार्यों में आपका समय बचा सकता है।
स्पष्ट है कि सर्च में बुनियादी बदलाव चल रहा है। हम लिंक सूचियों-केंद्रित मॉडल से सीधे उत्तर, सारांश और कार्य-समापन केंद्रित मॉडल की ओर बढ़ रहे हैं। इसका यह पर बड़ा असर पड़ेगा कि जानकारी कैसे सामने आती है और कैसे खपत होती है। SEO और कंटेंट मार्केटिंग उद्योग पहले से ही प्रभाव देख रहे हैं।
AI मोड अभी अमेरिका में रोलआउट हो रहा है, और अगले कुछ हफ्तों में Labs में और फीचर्स आएँगे। यदि आप इसे जल्दी आज़माना चाहते हैं तो Google Labs में यह प्रयोग सक्षम कर सकते हैं।
निष्कर्ष
यही था I/O 2025 के पहले दिन की सबसे महत्वपूर्ण AI घोषणाओं का सार। हमेशा की तरह, महत्वाकांक्षा बहुत दिखी—लेकिन असली कसौटी यह है कि ये टूल्स रोज़मर्रा के उपयोगकर्ताओं और डेवलपर्स के हाथों में कैसा प्रदर्शन करते हैं।
इनमें से कुछ तकनीकें अभी शुरुआती चरण में हैं या महँगी सदस्यताओं के पीछे सीमित हैं, लेकिन कुछ फीचर्स सभी उपयोगकर्ताओं तक पहले ही पहुँचने लगे हैं।

मैं एक संपादक और लेखक हूँ जो AI ब्लॉग, ट्यूटोरियल, और समाचार कवर करता/करती हूँ, यह सुनिश्चित करते हुए कि सब कुछ ठोस कंटेंट रणनीति और SEO के सर्वोत्तम तरीकों के अनुरूप हो। मैंने Python, सांख्यिकी, प्रायिकता, और डेटा विज़ुअलाइज़ेशन पर डेटा साइंस पाठ्यक्रम लिखे हैं। मेरा एक पुरस्कृत उपन्यास भी प्रकाशित हो चुका है, और खाली समय में मैं पटकथा लेखन और फ़िल्म निर्देशन में समय बिताता/बिताती हूँ।
Google I/O 2025 का पहला दिन समाप्त हो गया है। इस लेख में, मैं आपको AI उद्योग के लिए सबसे मायने रखने वाली घोषणाओं से रू-ब-रू कराऊँगा।
मैं उन अपडेट्स पर ध्यान दूँगा जो या तो उपयोग के लिए तैयार हैं या जल्द ही जारी होने की उम्मीद है। इसी दौरान, मैं त्वरित प्रतिक्रियाएँ साझा करूँगा और जहाँ प्रासंगिक होगा, प्रतिस्पर्धा के संदर्भ में बात रखूँगा।
हम अपने पाठकों को The Median, हमारे नि:शुल्क शुक्रवार न्यूज़लेटर, के जरिए AI की नवीनतम खबरों से अपडेट रखते हैं, जो हफ्ते की मुख्य कहानियों का संक्षेप देता है। कुछ ही मिनटों में अपडेट रहने के लिए सदस्यता लें:
Veo 3
Veo 3 की जो बात मेरे लिए सबसे अलग रही, वह है इसका नेटिव ऑडियो आउटपुट। अब आप सीधे ऐसी वीडियो जेनरेट कर सकते हैं जिनमें ध्वनि शामिल हो—अलग से संपादन की ज़रूरत नहीं। एक उदाहरण देखते हैं: