
Programma
Il Giorno 1 di Google I/O 2025 è finito. In questo articolo ti guido tra gli annunci più importanti per il settore dell’IA.
Mi concentrerò sugli aggiornamenti già utilizzabili o in arrivo a breve. Lungo il percorso condividerò impressioni rapide e, dove serve, metterò le novità a confronto con la concorrenza.
Teniamo i nostri lettori aggiornati sulle ultime novità dell’IA con The Median, la nostra newsletter gratuita del venerdì che riassume le storie chiave della settimana. Iscriviti e resta aggiornato in pochi minuti a settimana:
Veo 3
Quello che mi ha colpito di Veo 3 è l’output audio nativo. Ora puoi generare video che includono direttamente il suono, senza passaggi extra di editing. Vediamo un esempio:
L’output audio nativo è qualcosa che non ho ancora visto in Runway o Sora. A questo punto, direi che Veo 3 è un passo avanti.
Anche se la demo è convincente, ho imparato che i video dimostrativi raramente riflettono il comportamento reale dei modelli. Appena il prompt esce dalla forma dei dati di addestramento—una scena inusuale, un personaggio strano o un’idea troppo sottile—il modello tende a crollare. Non vedo l’ora di provare Veo 3 per capire quanto regge.
Per accedere a Veo 3 serve un abbonamento AI Ultra, che costa 250 $/mese. Anche volendo pagare, la disponibilità è limitata. Al momento è accessibile solo negli Stati Uniti e solo all’interno di Flow, il nuovo editor video con IA di Google (che vedremo tra poco).
Se ti incuriosiscono i dettagli tecnici o vuoi esplorare altri esempi, dai un’occhiata alla pagina ufficiale di Veo qui.
Flow
Flow è uno strumento di filmmaking con IA che ti permette di generare singole inquadrature usando una combinazione di Veo, Imagen e Gemini.
Una cosa utile è che puoi creare elementi separati (chiamati “ingredienti”) e poi raggrupparli in un’unica scena. Questo ti dà un controllo modulare ed è particolarmente comodo quando vuoi riutilizzare gli stessi elementi in più prompt o shot.
Vediamo un esempio:
Dentro Flow ci sono anche strumenti per il controllo della camera e le transizioni, che aiutano a dare ai clip un tocco più cinematografico. Utili, ma non nuove—Sora e Runway offrono già funzioni simili, quindi non direi che qui ci sia qualcosa di rivoluzionario.
Detto questo, vale la pena seguire come si evolvono questi strumenti. Flow sembra la prima versione di un editor video AI-first, e non è difficile immaginare un futuro in cui questo flusso di lavoro diventa standard. Proprio come oggi diamo per scontati strumenti come Premiere Pro o DaVinci Resolve, qualcosa come Flow potrebbe diventare la norma tra qualche anno.
Flow al momento è disponibile solo negli Stati Uniti e vi si accede tramite gli abbonamenti AI Pro e AI Ultra di Google.
Imagen 4
Un altro annuncio importante è Imagen 4, il nuovo modello di generazione di immagini di Google. Puoi usarlo direttamente in Gemini o dentro Whisk, lo strumento di design di Google.
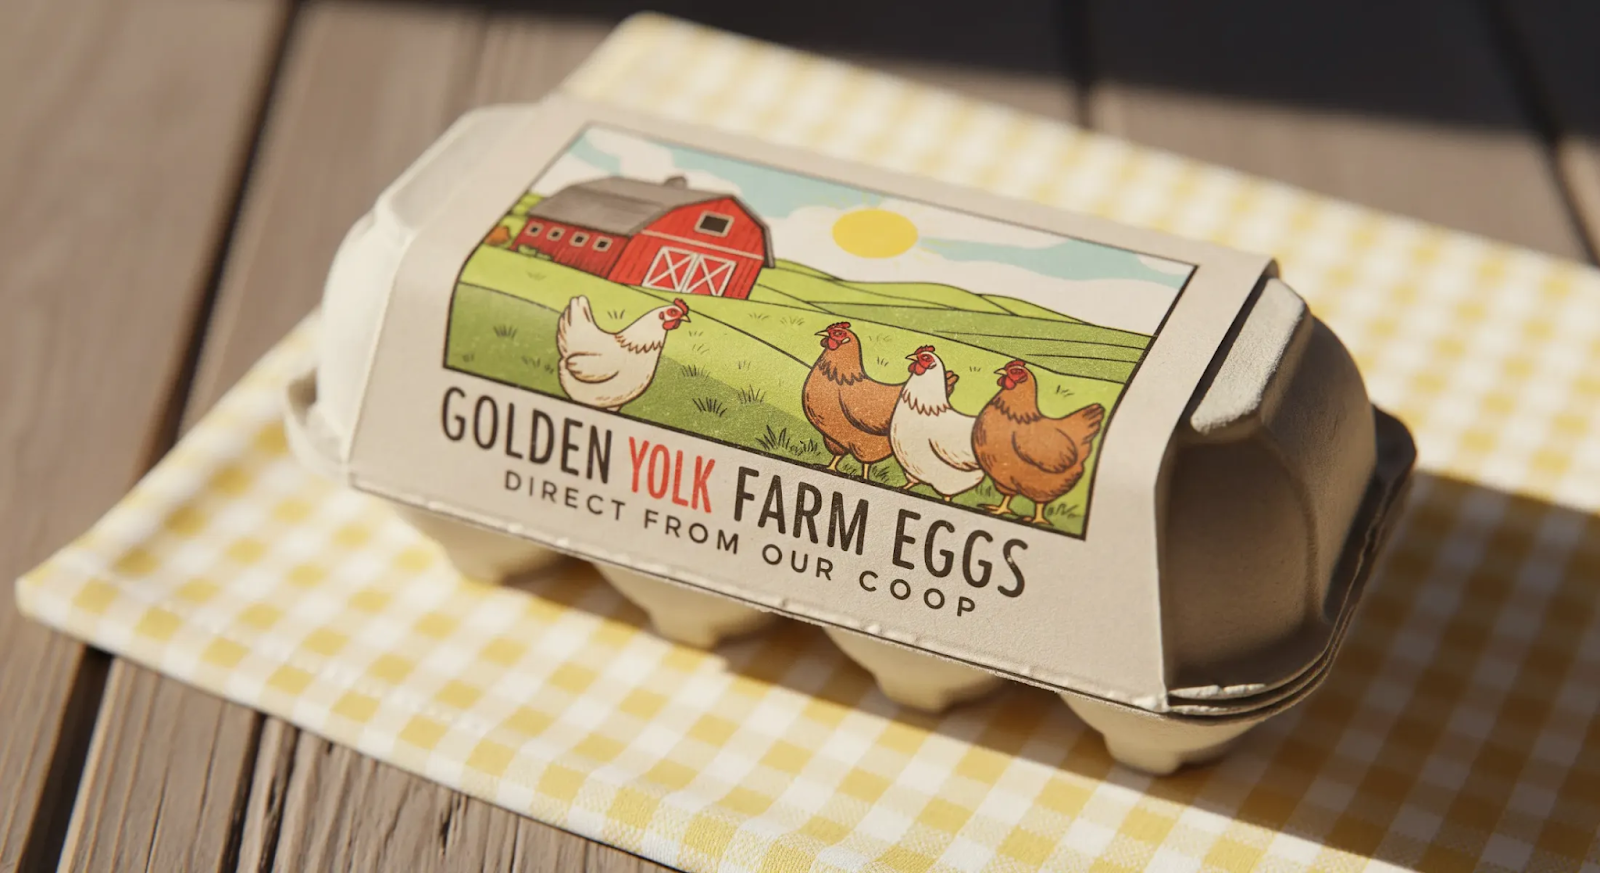
Google dichiara miglioramenti a tutto tondo—maggior fotorealismo, dettagli più puliti nei primi piani, più varietà negli stili artistici. Tutto bene, ma ciò che ha attirato la mia attenzione è la promessa di ortografia e tipografia avanzate. Se hai usato di recente un generatore di immagini, avrai notato che molti ancora sbagliano le parole o deformano le lettere.
Ecco un’immagine generata da Imagen 4:
Fonte: Google
Al momento, direi che la generazione di immagini di GPT-4o è la più forte sul mercato. Tuttavia, ancora fatica a volte con il testo e l’aderenza al prompt. Se Imagen 4 riesce davvero a gestire l’ortografia e a mantenere l’intento del prompt, penso che abbia la possibilità di prendersi la leadership nella generazione di immagini.
Gemma 3n
Gemma 3n è l’ultimo e più capace modello on-device di Google. Se il termine non ti è familiare, un modello on-device gira direttamente su telefono, tablet o laptop—senza inviare dati al cloud. Questo conta per vari motivi: latenza più bassa, migliore privacy e disponibilità offline.
Ma perché funzioni, il modello deve essere abbastanza piccolo da entrare in una memoria limitata, e al contempo abbastanza potente da gestire compiti reali. È la sfida che Gemma 3n cerca di affrontare.
Si basa su una nuova architettura condivisa con Gemini Nano—e infatti la “n” in “3n” sta per “nano”. Questa architettura è ottimizzata per un basso uso di memoria, tempi di risposta rapidi e supporto a più tipi di input come testo, audio e immagini.
Gemma 3n arriva in due varianti, con dimensioni di 5B e 8B parametri. Entrambe sono progettate per funzionare in modo efficiente, con requisiti di memoria più vicini ai modelli 2B e 4B grazie ad alcune ottimizzazioni sotto il cofano.
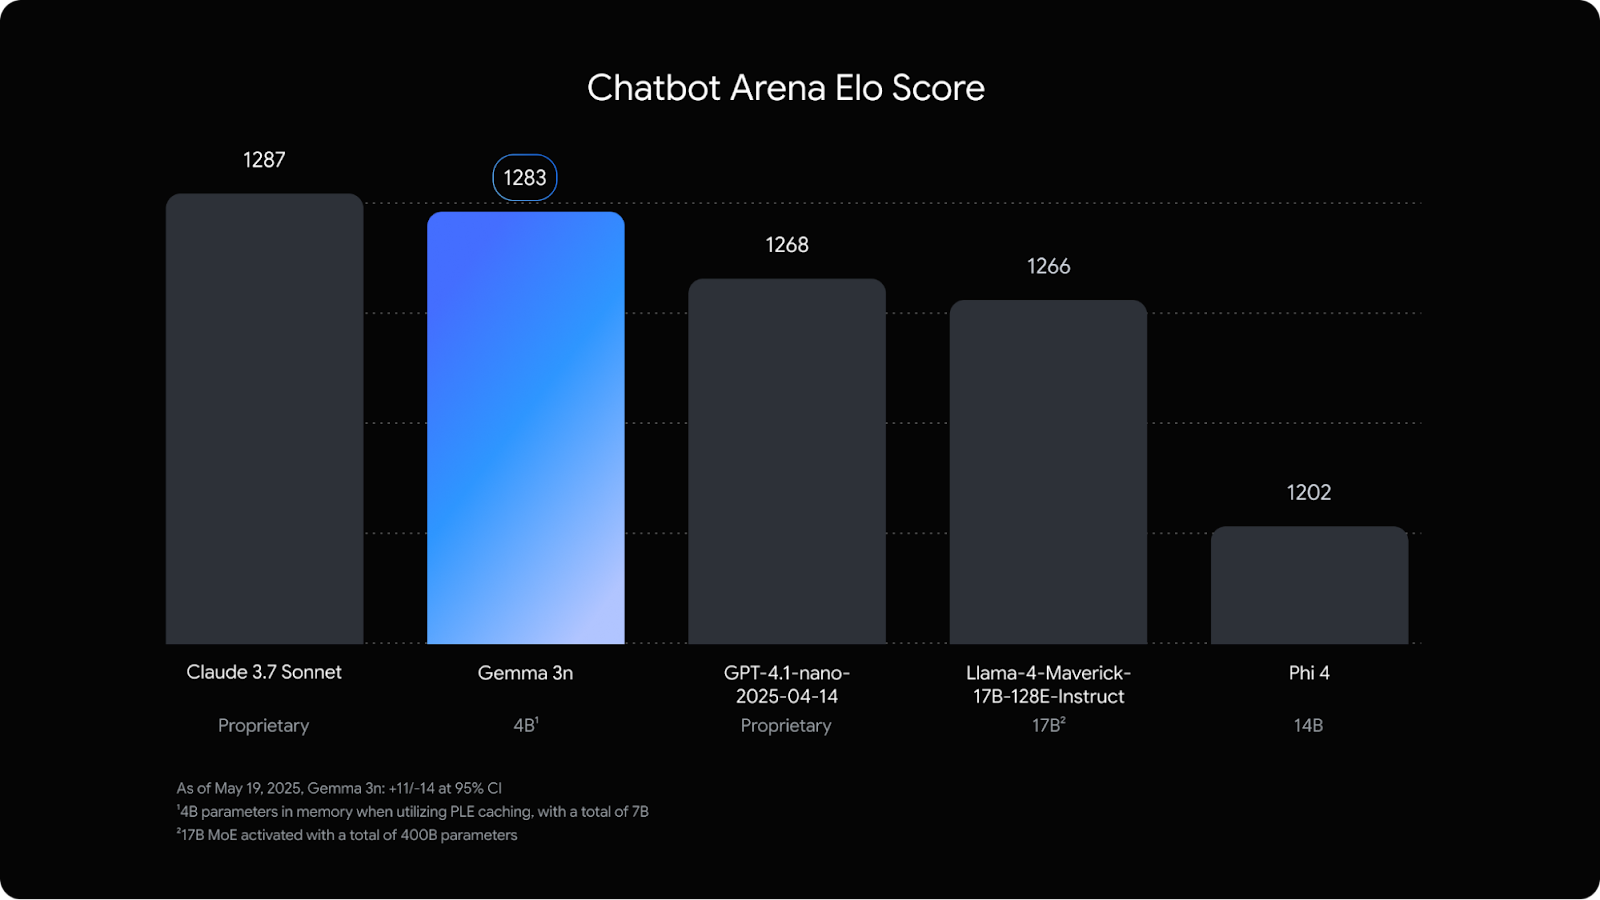
Quel che trovo notevole è che è quasi alla pari su Chatbot Arena con Claude 3.7 Sonnet, un modello molto più grande.
Fonte: Google
Questa release è rivolta soprattutto agli sviluppatori, in particolare a chi crea app mobile o embedded che possono trarre vantaggio dall’IA locale. Mentre il team di DataCamp sta preparando nuovi tutorial su Gemma 3n, ti consiglio di iniziare da questi articoli su Gemma 3:
Gemini Diffusion
La tecnologia che mi incuriosisce di più è Gemini Diffusion.
Gemini Diffusion è una nuova architettura di modello sperimentale pensata per migliorare velocità e coerenza nella generazione di testo. A differenza dei modelli linguistici tradizionali che generano token uno per volta in sequenza fissa, i modelli di diffusione affinano il rumore in più passaggi—un metodo preso in prestito dalla generazione di immagini.
Invece di prevedere direttamente la parola successiva, Gemini Diffusion parte da un’approssimazione grezza e la migliora iterativamente, risultando più adatto a compiti che beneficiano di raffinamento e correzione degli errori—come matematica, codice ed editing.
Nei primi benchmark, si segnala che genera token fino a cinque volte più velocemente dei modelli autoregressivi standard come Gemini 2.0 Flash-Lite, offrendo prestazioni simili o migliori nei compiti di ragionamento strutturato.
Per ora, l’accesso è limitato a tester selezionati. Non è stata annunciata una data di rilascio pubblica. Iscriviti alla lista d’attesa su questa pagina.
Project Mariner
Project Mariner è la proposta di Google per un agente IA che opera direttamente nel browser. È progettato per aiutare con attività complesse e multi-step—come pianificare un viaggio, fare ricerche di prodotto o riassumere contenuti densi su più schede.
In questo senso, è simile a Manus AI o Operator di OpenAI, già disponibile tramite ChatGPT. Vediamo un esempio di Mariner in azione:
Al momento, Mariner non è disponibile al pubblico, ma Google parla di un accesso più ampio in arrivo. L’accesso per sviluppatori è previsto a breve tramite la Gemini API.
Altri esempi qui:
Project Astra
Project Astra è il prototipo di Google DeepMind per un assistente IA più generalista—qualcosa che non si limita a rispondere ai prompt, ma vede, ascolta, ricorda e reagisce. È stato presentato per la prima volta l’anno scorso come progetto di ricerca e a I/O 2025 abbiamo visto meglio di cosa è capace.
Vediamolo in azione:
Non è ancora disponibile al pubblico, ma parti di Astra stanno già arrivando in Gemini Live e un rollout più ampio è previsto più avanti. Resta da vedere se diventerà un prodotto reale o resterà nella fase di ricerca, ma la direzione è chiara: Google vede in questo le basi di un assistente IA universale.
AI Mode in Search
AI Mode è la nuova esperienza di ricerca di Google che assomiglia più a un chatbot che a un motore di ricerca. È diversa dagli AI Overviews, che sono brevi sommari con IA in cima alla classica pagina dei risultati di Google che conosciamo tutti. AI Mode, invece, prende il controllo dell’interfaccia intera—è una nuova scheda in cui puoi fare domande complesse e proseguire la conversazione con follow-up.
Vediamo un esempio:
L’interfaccia ricorda molto ChatGPT o Perplexity. Inserisci un prompt e AI Mode risponde con testi più lunghi e strutturati, includendo link, citazioni, grafici e talvolta anche un’analisi completa della ricerca. Usa un approccio di “query fan-out” per suddividere la tua domanda in sottoargomenti e pescare dal web in un’unica passata.
Una funzionalità notevole è l’integrazione delle capacità agentiche di Project Mariner. Questo può farti risparmiare tempo in attività come acquistare biglietti per eventi, fare prenotazioni o verificare la disponibilità su più siti.
È chiaro che la ricerca sta vivendo un cambiamento profondo. Stiamo passando da un modello basato su liste di link a uno centrato su risposte dirette, riassunti e completamento di compiti. Questo ha grandi implicazioni su come l’informazione viene fatta emergere e consumata. I settori SEO e content marketing stanno già vedendo l’impatto.
AI Mode è in rollout negli Stati Uniti ora, con altre funzionalità in arrivo su Labs nelle prossime settimane. Puoi attivare l’esperimento in Google Labs se vuoi provarlo in anteprima.
Conclusione
Questo è il riepilogo delle novità più importanti sull’IA dal Giorno 1 di I/O 2025. Come sempre, c’è molta ambizione—ma la vera prova è come questi strumenti si comportano nelle mani di utenti e sviluppatori ogni giorno.
Alcune di queste tecnologie sono ancora agli inizi o bloccate dietro abbonamenti costosi, ma alcune funzioni stanno già arrivando a tutti gli utenti.
Sono un editor e autore che si occupa di blog, tutorial e notizie sull’IA, assicurandomi che tutto rientri in una solida strategia di contenuti e nelle best practice SEO. Ho scritto corsi di data science su Python, statistica, probabilità e visualizzazione dei dati. Ho anche pubblicato un romanzo premiato e nel tempo libero mi dedico alla sceneggiatura e alla regia.



