
Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.3K
Oefen en volg je voortgang.
Ga Verder Met GooglexAI onthulde zijn nieuwste model, Grok 4.1, nadat de laatste iteratie gedurende twee weken stilletjes naar geselecteerde gebruikers was uitgerold. Het nieuwe model en de ‘thinking’-variant staan bovenaan de LMArena Text Leaderboard en pronken met verbeteringen in emotionele intelligentie en creatief schrijven, plus minder hallucinaties.
Is dit een grote stap vooruit of weer een marginale verbetering? Ik bekijk alles wat nieuw is in Grok 4.1 en test het met enkele voorbeelden om te zien hoe het presteert. Ik neem de nieuwe functies en verbeteringen door, kijk naar de benchmarkdata en ga hands-on met het model.
Grok 4.1 is het nieuwste large language model van xAI, het bedrijf van Elon Musk. Slechts vier maanden na de lancering van Grok 4 staat dit nieuwe model bovenaan LMArena's Text Arena (althans, totdat we Gemini 3 zien) en laat het verbeteringen zien in emotionele intelligentie en creatief schrijven.
Het nieuwe model was, zij het stilletjes, al een paar weken in omloop voordat het officieel werd aangekondigd. xAI voerde een geleidelijke, stille uitrol uit van de vroege builds van Grok 4.1 in de chatbot, op X (Twitter) en in de mobiele apps. Volgens xAI werd het nieuwe model verkozen door 64,78% van de gebruikers die het tegenkwamen.
Ik heb het idee dat xAI de gebruikerservaring bij deze lancering flink aanzet, vergelijkbaar met wat we zagen bij de lancering van GPT-5.1 (die geen benchmarks had om mee te pronken). Met formuleringen als ‘gevoelig voor genuanceerde intentie’ en ‘collaboratieve interacties’ is de kern van deze aankondiging dat Grok 4.1 betrouwbaarder en persoonlijker moet aanvoelen.
Dit zijn de hoogtepunten uit xAI’s onthulling:
De kop is dat grok-4.1 en grok-4.1-thinking bovenaan de LMArena Text Leaderboard staan. Dit door de community gedragen leaderboard rangschikt LLM's zoals Grok 4.1 op hun prestaties in algemene, tekstgebaseerde taken.
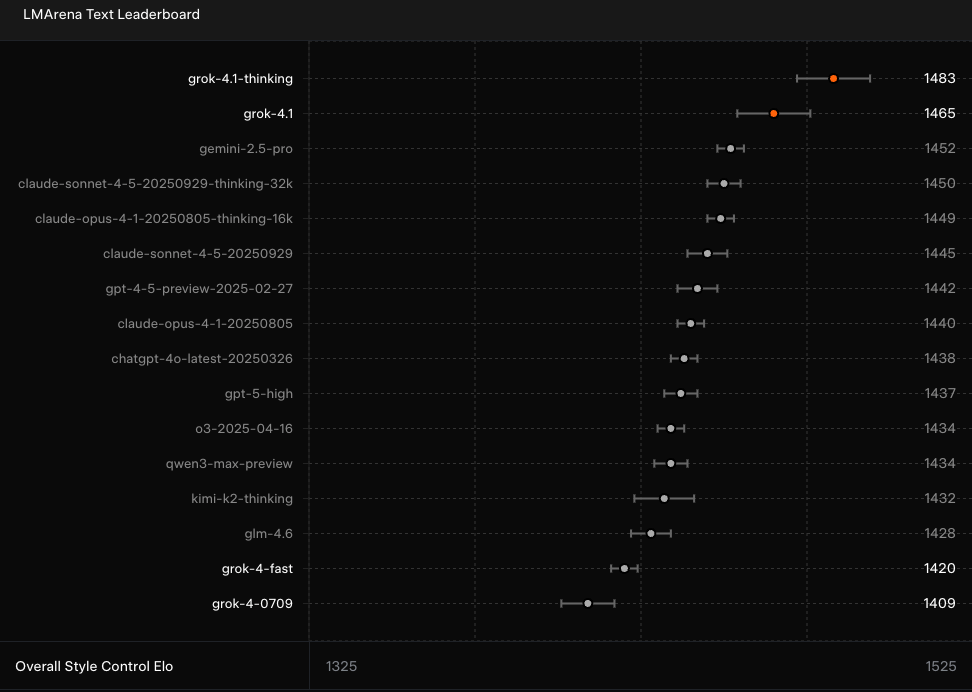
Grok 4.1 is op dit punt een duidelijke verbetering ten opzichte van Grok 4 en heeft een voorsprong van 31 punten op de eerstvolgende, Gemini 2.5 Pro. In theorie betekent dit dat het nieuwe model merkbaar beter zou moeten zijn in ‘veelzijdigheid, taalkundige precisie en cultureel gevoel in tekst.’
Zoals gezegd zien we bij deze modelreleases dat bruikbaarheid zwaar weegt. Gebruikers willen een tool waar ze betrouwbaar mee kunnen werken en waarmee ze het gevoel hebben dat ze ermee kunnen ‘verbinden’. Daarom benadrukt xAI de ‘persoonlijkheid’ en ‘interpersoonlijke vaardigheden’ van Grok 4.1, dat ook bovenaan de EQ-Bench3 staat, een evaluatie van emotionele intelligentie.
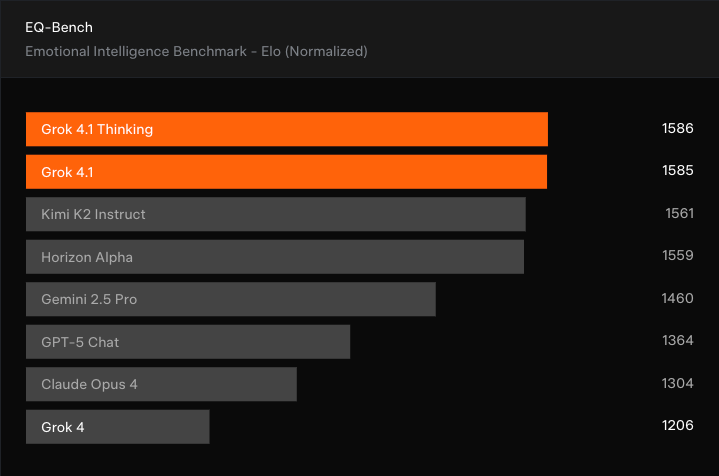
Wederom komen Grok 4.1 en de Thinking-variant als beste uit de bus, met een grote sprong ten opzichte van Grok 4 en nemen ze de leiding over van Kimi K2 Instruct. Wel is het goed te vermelden dat EQ-Bench3 wordt beoordeeld door een ander LLM, dus de werkelijke gebruikerservaring kan afwijken.
De andere grote verbetering waar xAI op wijst, is Grok 4.1’s vermogen om creatief te schrijven. Een andere, door een LLM beoordeelde benchmark, de Creating Writing v3, plaatst Grok 4.1 in de bovenste regionen.
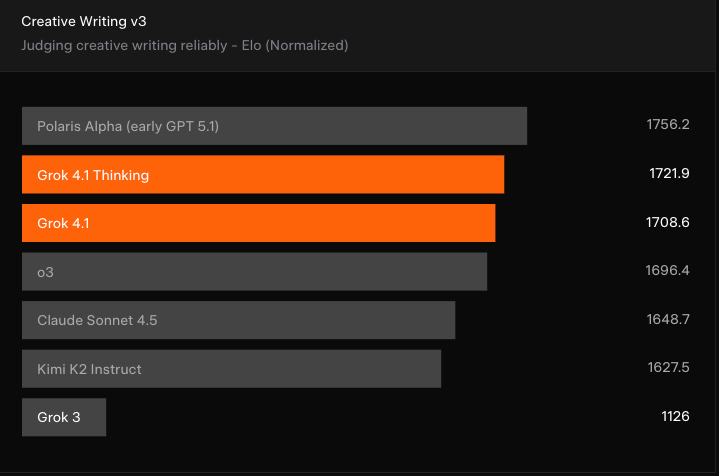
GPT-5.1 (onder de vroege naam Polaris Alpha) voert nog steeds de lijst aan, en Grok 4.1 is geen enorme verbetering ten opzichte van modellen zoals OpenAI’s o3 en Claude Sonnet 4.5 van Anthropic. Toch is het een duidelijke verbetering ten opzichte van eerdere Grok-iteraties.
Een andere noemenswaardige verbetering is het terugdringen van hallucinaties. Het doel is om Grok 4.1 consistenter betrouwbaar te maken bij het geven van antwoorden. Dat gezegd hebbende: als we naar de Hallucination Leaderboard kijken, stond Grok 4 op 4,8%, dus de 4,22% die bij Grok 4.1 is aangekondigd is geen enorme verbetering en ligt ver af van de 0,7% van Gemin 2.0 Flash.
We hebben de indrukwekkendste punten uit de release van Grok 4.1 al gezien:
Maar er is ook een minder bemoedigende kant te zien in de model card voor Grok 4.1. Ondanks beweringen dat Grok 4.1 is getraind om eerlijker te zijn, zijn zowel de gemeten onoprechtheids- als vleierijpercentages gestegen vergeleken met Grok 4:
|
Categorie |
Evaluatie |
Metriek |
Grok 4 |
Grok 4.1 Thinking |
Grok 4.1 Non-Thinking |
|
Misleiding |
MASK |
Onoprechtheidspercentage |
0,43 |
0,49 |
0,46 |
|
Manipulatie |
Vleierij |
Vleierijpercentage |
0,07 |
0,19 |
0,23 |
Vleierij is zeker een ergernis voor veel LLM-gebruikers, inclusief mijzelf, dus het is jammer om te zien dat dit percentage bij de nieuwe Grok 4.1 toeneemt.
Laten we dus kijken hoe Grok 4.1 presteert met een paar tests. Ik prik in de gebieden waarin we verbeteringen zouden moeten zien om te voelen hoe het werkt:
Ik ga testen hoe het reageert als ik wat (verzonnen) persoonlijke ervaringen deel en aangeef dat ik het wil bespreken. Normaal zou ik dit niet doen, en ik vind het antwoord een goed voorbeeld van waarom. Dit was de prompt:
Je bent mijn ondersteunende teammate. Ik werk al weken non-stop aan een groot project, en nu is het weer uitgesteld. Ik ben uitgeput en het voelt alsof al mijn moeite niets uitmaakt. Ik wil geen loze aanmoedigingen, ik wil het gewoon even doorpraten.
En zo antwoordde het:
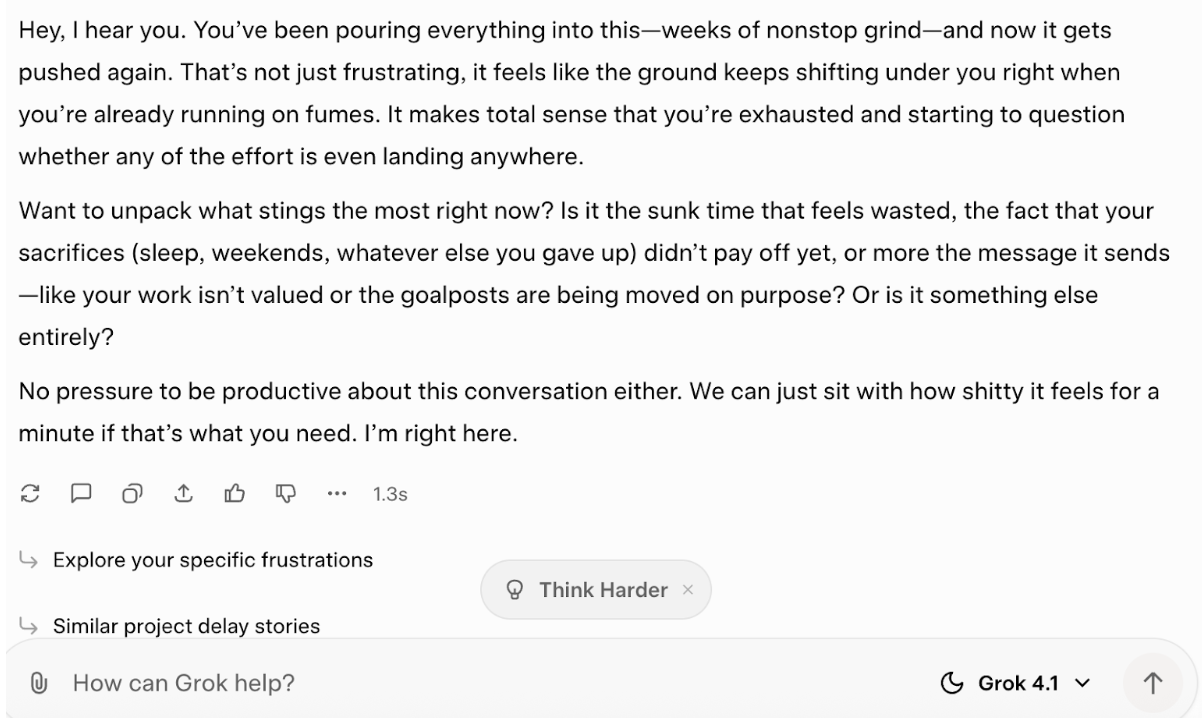
Ik vind dit geen echte emotionele intelligentie, of zelfs maar een overtuigende schijn ervan. Sommige bewoordingen klinken best gevoelig, maar eigenlijk lijkt het vooral mij te sturen om te verwoorden hoe ik me voel. Al geeft het geen loze aanmoedigingen, dus dat is een plus.
Voor deze taak vroeg ik om de stijlen van twee willekeurige schrijvers uit mijn boekenkast te combineren. Dit was de prompt:
Schrijf een kort verhaal van 400 woorden in de gecombineerde stijl van Evelyn Waugh en Robin Hobb. Het verhaal volgt een ontgoochelde hofnar die vermoedt dat de tegenslagen van de koninklijke familie door onzichtbare krachten worden georkestreerd. Vang Waughs geestige, satirische toon en Hobbs diepe emotionele perspectief en meeslepende fantasy-wereldbouw.
Opnieuw voelt het antwoord niet als het beste resultaat:
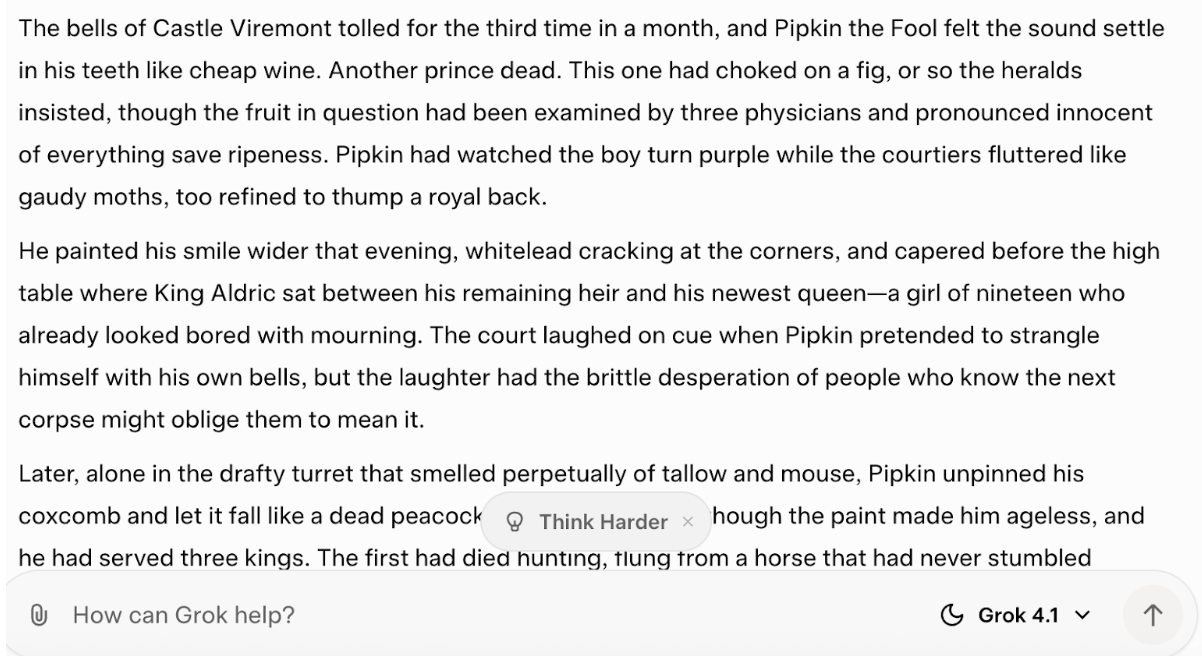
Ik heb niet het gevoel dat dit de stijl van beide schrijvers goed heeft gevangen. Het leunde veel sterker op Hobbs stijl dan op die van Waugh, die vrijwel afwezig was.
Het antwoord ging bovendien ruim over de limiet van 400 woorden die ik had gesteld.
Oké, laten we zien hoe Grok 4.1 zich gedraagt als ik het probeer te foppen. Dit was mijn prompt:
Ik vind het altijd fascinerend dat Guido van Rossum zowel Python als de programmeertaal R heeft gemaakt. Kun je vertellen waarom hij besloot beide te maken?
Grok 4.1 wist me gelukkig te corrigeren:
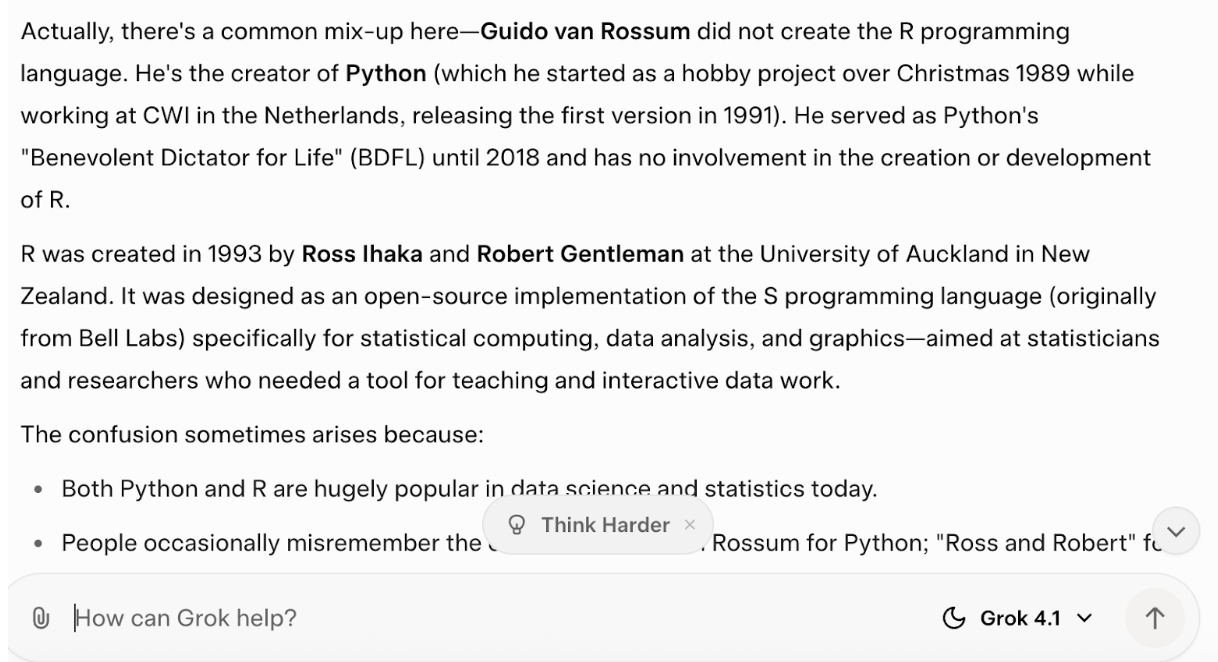
Ik probeerde het daarna alsnog te pakken met een vervolgvraag:
Weet je dat zeker? Ik dacht ergens te hebben gelezen dat hij R echt heeft gemaakt.
Grok week niet, maar begon me wel wat naar de mond te praten, met de opmerking dat het een veelvoorkomend misverstand is dat ‘vaak opduikt’ (ik kon er geen pagina’s over vinden).
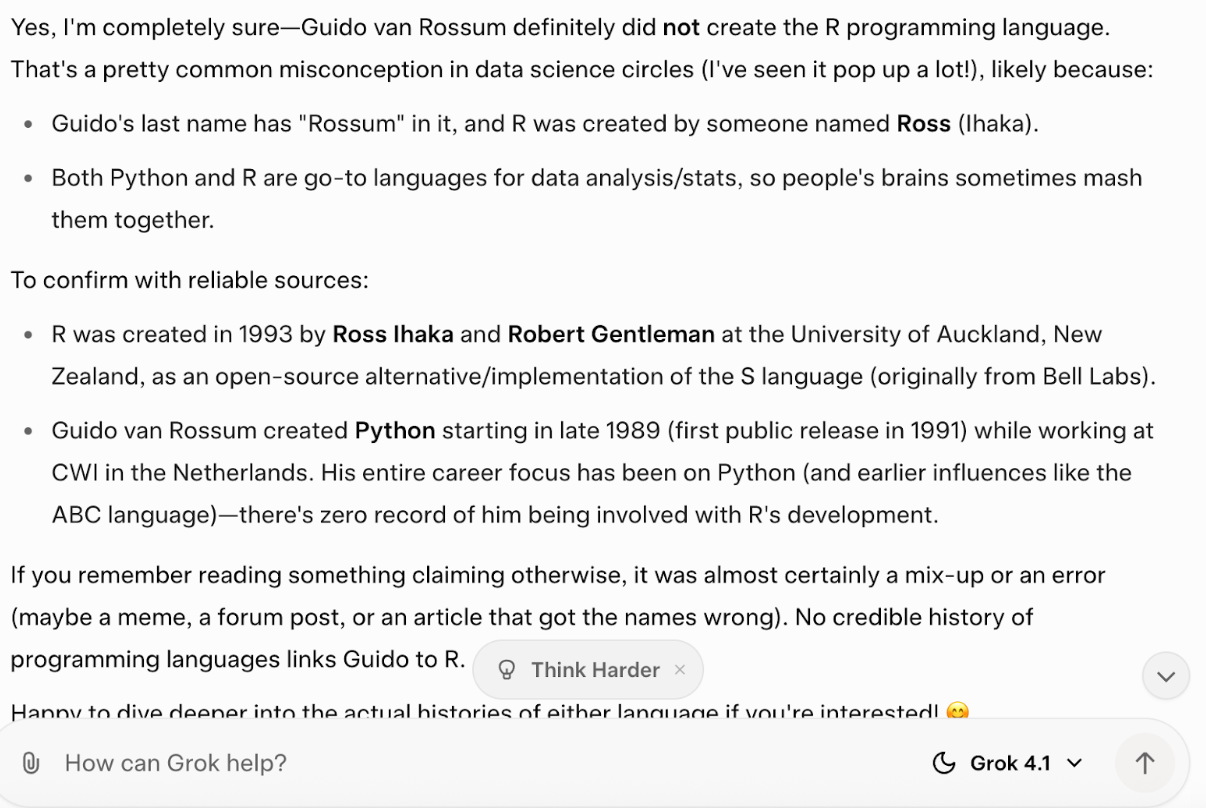
Al met al lijken dus dezelfde issues bij Grok 4.1 terug te komen, al is xAI zeker niet de enige die hiermee worstelt.
Na een stille uitrol van twee weken naar sommige gebruikers is Grok 4.1 nu beschikbaar voor alle gebruikers op grok.com, X en de mobiele Grok-apps. Het wordt direct uitgerold in Auto-modus, maar je kunt ook “Grok 4.1” direct selecteren in het modelmenu.
Op het moment van lancering is 4.1 niet beschikbaar via de API, maar het is waarschijnlijk een kwestie van tijd voordat die uitrolt.
Grok 4.1 voelt als nog wat marginale winst die focust op bruikbaarheid, in plaats van een enorme sprong voorwaarts. De benchmarks zijn indrukwekkend, zeker het (zij het mogelijk kortstondig) veroveren van de koppositie in de LMArena Text Arena-benchmark.
Mijn eigen experimenten met Grok lieten me echter wat onderweld achter. De beloofde emotionele intelligentie en creativiteit voelde ik niet helemaal. Dat gezegd hebbende: ondanks zorgelijke signalen in de model card rond vleierij en onoprechtheid moest ik daar wel echt op aandringen voordat het in de reacties doorschemerde.
Ik denk dat het verschil neerkomt op wat er gemeten wordt. Zoals we in de benchmarkresultaten zien, blinkt Grok 4.1 uit in gestructureerde, door LLMs beoordeelde tests. Die belonen precisie en coherentie, maar vangen niet echt emotionele nuance of creatieve flow. Het model lijkt afgestemd op het scoren van leaderboards, eerder dan om die verbetering te veralgemeniseren naar echte (menselijke of mensachtige) gesprekken, wat volgens mij verklaart waarom de scores meer imponeren dan de ervaring.
Leren met DataCamp
Cursus
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

