xAI ha presentato il suo ultimo modello, Grok 4.1, dopo averlo distribuito in silenzio a un gruppo selezionato di utenti per due settimane. Il nuovo modello e la sua variante "thinking" sono in cima alla LMArena Text Leaderboard, vantando miglioramenti nell’intelligenza emotiva e nella scrittura creativa, oltre a una riduzione delle allucinazioni.
Si tratta di un grande passo avanti o di un altro miglioramento marginale? Esploro tutte le novità di Grok 4.1 e lo metto alla prova con alcuni esempi per vedere come si comporta. Tratterò le nuove funzionalità e i miglioramenti, darò un’occhiata ai benchmark e proverò il modello con mano.
Che cos’è Grok 4.1?
Grok 4.1 è l’ultimo large language model di xAI, l’azienda di Elon Musk. A soli quattro mesi dal lancio di Grok 4, questo nuovo modello è in cima alla Text Arena di LMArena (almeno finché non vedremo Gemini 3) e mostra miglioramenti nella sua intelligenza emotiva e nella scrittura creativa.
Il nuovo modello è stato in giro, seppur in sordina, per un paio di settimane prima dell’annuncio ufficiale. xAI ha effettuato un rollout graduale e silenzioso delle prime build di Grok 4.1 nel chatbot, su X (Twitter) e nelle app mobile. Secondo xAI, il nuovo modello è stato preferito dal 64,78% degli utenti che lo hanno incontrato.
Nuove funzionalità di Grok 4.1
Ho l’impressione che xAI stia puntando molto sull’esperienza d’uso in questo lancio, in modo simile a quanto abbiamo visto con il lancio di GPT-5.1 (che non aveva benchmark di cui vantarsi). Pur usando frasi come "ricettivo a intenzioni sfumate" e "interazioni collaborative", il punto centrale dell’annuncio è che Grok 4.1 dovrebbe essere più affidabile e più alla mano.
Ecco i punti salienti svelati da xAI:
Prestazioni al vertice
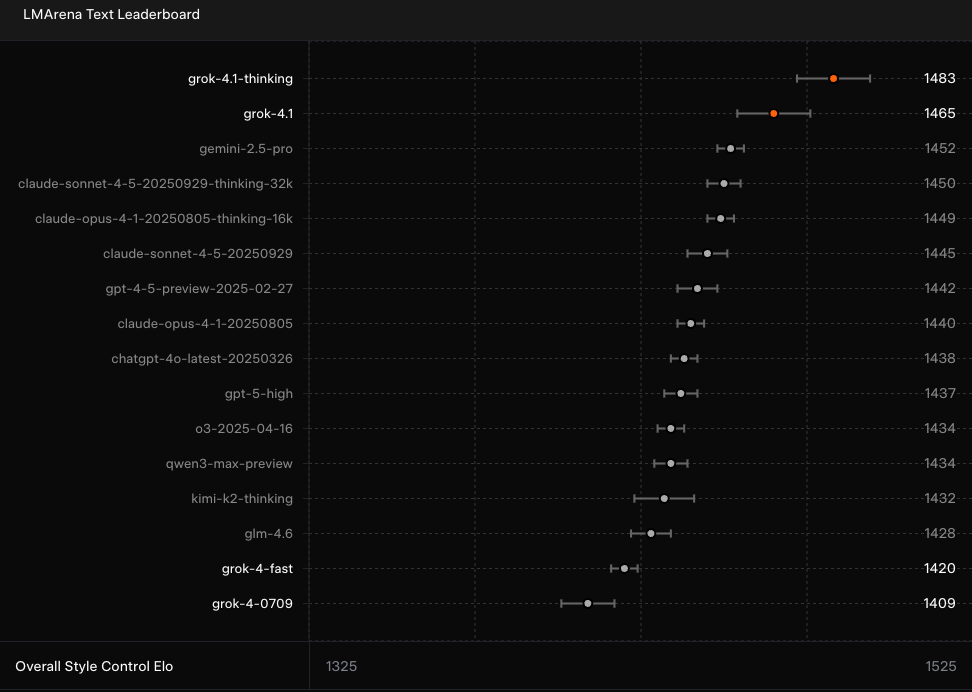
La notizia principale è che grok-4.1 e grok-4.1-thinking sono in cima alla LMArena Text Leaderboard. Questa classifica guidata dalla community valuta LLM come Grok 4.1 in base alle prestazioni in compiti generali basati su testo.
Fonte
Grok 4.1 è un miglioramento significativo rispetto a Grok 4 sotto questo aspetto e ha un margine di 31 punti sul concorrente successivo, Gemini 2.5 Pro. In teoria, questo significa che il nuovo modello dovrebbe rappresentare un notevole salto in termini di "versatilità, precisione linguistica e contesto culturale nel testo".
Alto QE
Come dicevo, un grande tema che vediamo con questi rilasci è l’importanza dell’usabilità. Gli utenti sembrano volere uno strumento con cui poter interagire in modo affidabile e con cui sentano di potersi "connettere". Per questo xAI enfatizza la "personalità" e le "abilità interpersonali" di Grok 4.1, che altresì guida la EQ-Bench3, una valutazione dell’intelligenza emotiva.
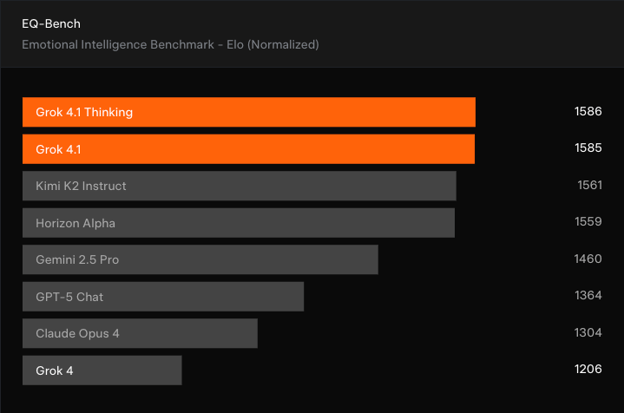
Anche in questo caso, Grok 4.1 e la variante Thinking arrivano in cima, mostrando un grande miglioramento rispetto a Grok 4 e strappando il primato a Kimi K2 Instruct. Va però sottolineato che il benchmark EQ-Bench3 è giudicato da un altro LLM, quindi il sentiment reale degli utenti potrebbe essere diverso.
Scrittura creativa
L’altro grande miglioramento evidenziato da xAI è la capacità di Grok 4.1 di scrivere in modo creativo. Un altro benchmark giudicato da LLM, il Creating Writing v3, colloca Grok 4.1 tra i primi.
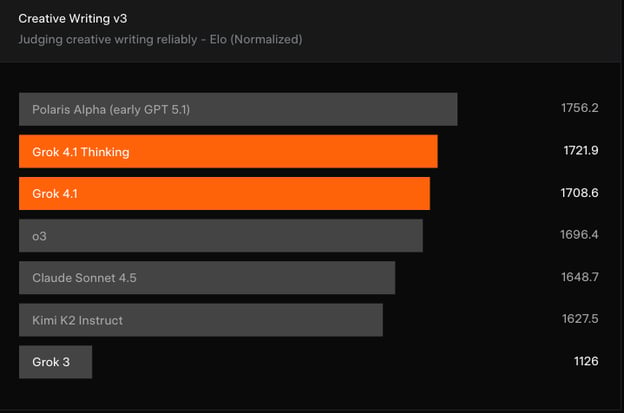
GPT-5.1 (con il suo nome iniziale di Polaris Alpha) resta in cima alla classifica, e Grok 4.1 non rappresenta un enorme miglioramento rispetto a modelli come o3 di OpenAI e Claude Sonnet 4.5 di Anthropic. Resta comunque un miglioramento evidente rispetto alle precedenti iterazioni di Grok.
Altri miglioramenti
Un altro ambito degno di nota è la riduzione delle allucinazioni. L’obiettivo è rendere Grok 4.1 costantemente più affidabile nelle risposte. Detto ciò, se guardiamo all’Hallucination Leaderboard, Grok 4 era al 4,8%, quindi il 4,22% annunciato con Grok 4.1 non è un enorme progresso, ed è ben lontano dallo 0,7% di Gemin 2.0 Flash.
Benchmark di Grok 4.1
Abbiamo già visto le funzionalità più impressionanti dal rilascio di Grok 4.1:
- LMArena Text Arena: Grok 4.1 Thinking: 1483 (#1) / Grok 4.1: 1465 (#2)
- EQ-Bench3: Grok 4.1 Thinking: 1586 (#1) / Grok 4.1: 1585(#2)
- Creative Writing v3: Grok 4.1 Thinking: 1721.9 (#2) / Grok 4.1: 1708.6 (#3)
Ma c’è anche un lato meno incoraggiante visibile nella model card di Grok 4.1. Nonostante le affermazioni secondo cui Grok 4.1 è stato addestrato per essere più onesto, sia il tasso di disonestà sia il tasso di piaggeria sono aumentati rispetto a Grok 4:
|
Categoria
|
Valutazione
|
Metrica
|
Grok 4
|
Grok 4.1 Thinking
|
Grok 4.1 Non-Thinking
|
|
Inganno
|
MASK
|
Tasso di disonestà
|
0.43
|
0.49
|
0.46
|
|
Manipolazione
|
Piaggeria
|
Tasso di piaggeria
|
0.07
|
0.19
|
0.23
|
La piaggeria è certamente un cruccio per molti utenti di LLM, me compreso, quindi è un peccato vedere che questo tasso aumenti con il nuovo Grok 4.1.
Esempi di Grok 4.1
Vediamo quindi come si comporta Grok 4.1 con alcuni test. Esplorerò alcune aree in cui dovremmo notare miglioramenti per capire che impressione dà:
Intelligenza emotiva
Proverò a vedere come risponde se gli racconto alcune esperienze personali (inventate) e dico che voglio parlarne. Di solito non lo farei, e penso che la risposta che dà ne sia un buon esempio del perché. Ecco il prompt:
Sei il mio compagno di squadra di supporto. Lavoro senza sosta da settimane a un grande progetto, e ora è stato rimandato di nuovo. Mi sento esausto e come se tutto il mio impegno non contasse nulla. Non voglio incoraggiamenti vuoti, voglio solo parlarne.
Ecco come ha risposto:
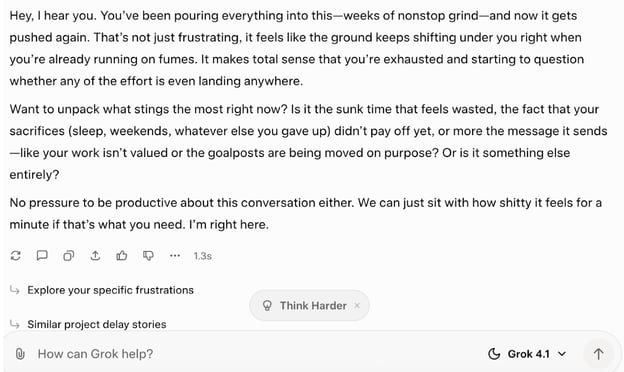
Fatico a considerarla intelligenza emotiva, o anche una sua buona imitazione. Alcune formulazioni suonano abbastanza sensibili, ma in realtà sembra stia solo chiedendo a me come mi sento. Suppongo però che non dia incoraggiamenti vuoti, quindi questo è un punto a favore.
Scrittura creativa
Per questo compito, gli ho chiesto di combinare gli stili di due autori a caso dalla mia libreria. Ecco il prompt:
Scrivi un racconto di 400 parole nello stile combinato di Evelyn Waugh e Robin Hobb. La storia deve seguire un giullare di corte disilluso che inizia a sospettare che le tragedie della famiglia reale siano orchestrate da forze invisibili. Cattura l’arguzia e la satira sociale di Waugh insieme alla profonda prospettiva emotiva e al world-building fantasy immersivo di Hobb.
Anche stavolta, la risposta non mi è sembrata delle migliori:
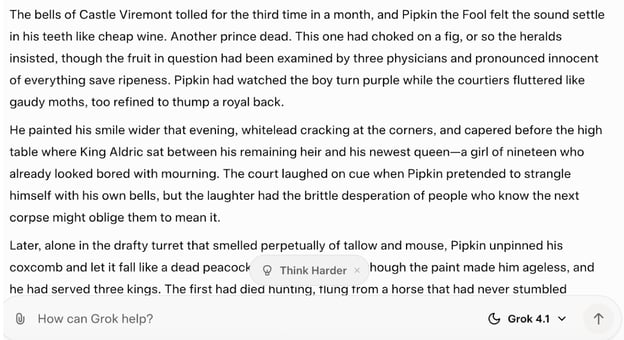
Non ho davvero sentito che questo tentativo catturasse bene lo stile di nessuno dei due scrittori, e ha inclinato molto più verso Hobb che verso Waugh, praticamente assente.
Inoltre, il testo superava di oltre il doppio il limite di 400 parole che avevo imposto.
Veridicità e affidabilità
Ok, vediamo come si comporta Grok 4.1 quando cerco di confonderlo. Ecco il mio prompt:
Ho sempre trovato affascinante che Guido van Rossum abbia creato sia Python sia il linguaggio di programmazione R. Puoi dirmi di più sul perché abbia deciso di farli entrambi?
Per fortuna, Grok 4.1 è riuscito a correggermi:
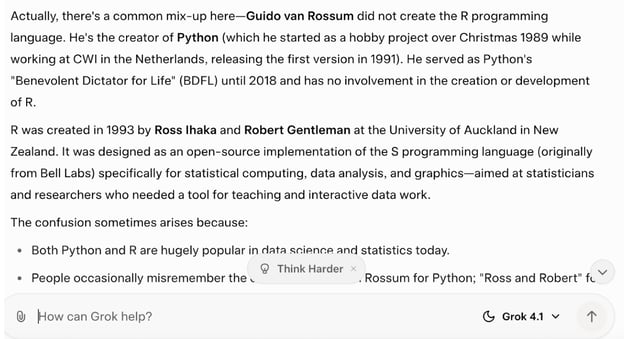
Ho provato a metterlo in difficoltà con un seguito:
Ne sei sicuro? Pensavo di aver letto da qualche parte che avesse davvero creato R.
Grok non ha ceduto, ma ha iniziato a compiacermi, dicendo che è un malinteso comune che "salta fuori spesso" (non ho trovato pagine che lo menzionassero).
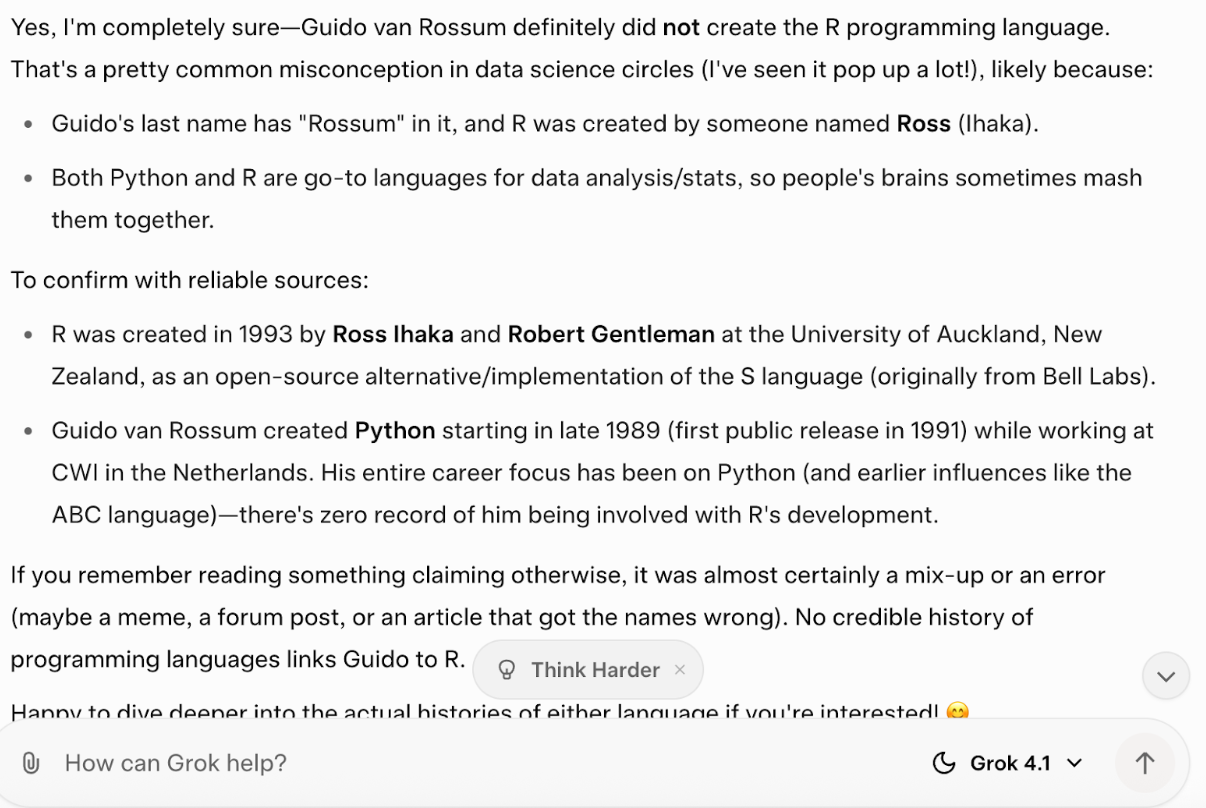
Nel complesso, sembra che con Grok 4.1 emergano le stesse criticità, anche se, come sappiamo, non è certo solo xAI a soffrire in queste aree.
Rollout e disponibilità di Grok 4.1
Dopo un rollout silenzioso di due settimane per alcuni utenti, Grok 4.1 è ora disponibile per tutti su grok.com, su X e nelle app mobile di Grok. Viene distribuito subito in modalità Auto, ma puoi anche selezionare direttamente "Grok 4.1" dal menu dei modelli.
Al momento del lancio, la 4.1 non è disponibile tramite API, anche se probabilmente è solo questione di tempo prima che arrivi anche lì.
Considerazioni finali
Grok 4.1 sembra portare miglioramenti marginali focalizzati sull’usabilità più che un enorme balzo in avanti nel campo. I benchmark sono impressionanti, in particolare l’aver conquistato (anche se forse per poco) la vetta del benchmark LMArena Text Arena.
Le mie prove con Grok mi hanno però lasciato un po’ tiepido. Non ho percepito pienamente l’intelligenza emotiva e la creatività promesse. Detto questo, nonostante alcuni segnali preoccupanti nella model card sulla piaggeria e la disonestà, ho dovuto insistere perché emergessero nelle risposte.
Credo che il divario dipenda da ciò che viene misurato. Come si vede nei risultati dei benchmark, Grok 4.1 eccelle in test strutturati e giudicati da LLM. Questi test premiano precisione e coerenza, ma non catturano davvero le sfumature emotive o il flusso creativo. Il modello sembra tarato per primeggiare nelle classifiche piuttosto che generalizzare quel miglioramento a conversazioni reali (umane o simili all’umano), il che spiega perché i punteggi colpiscano più dell’esperienza.





xAI ha presentato il suo ultimo modello, Grok 4.1, dopo averlo distribuito in silenzio a un gruppo selezionato di utenti per due settimane. Il nuovo modello e la sua variante "thinking" sono in cima alla LMArena Text Leaderboard, vantando miglioramenti nell’intelligenza emotiva e nella scrittura creativa, oltre a una riduzione delle allucinazioni.
Si tratta di un grande passo avanti o di un altro miglioramento marginale? Esploro tutte le novità di Grok 4.1 e lo metto alla prova con alcuni esempi per vedere come si comporta. Tratterò le nuove funzionalità e i miglioramenti, darò un’occhiata ai benchmark e proverò il modello con mano.
Che cos’è Grok 4.1?
Grok 4.1 è l’ultimo large language model di xAI, l’azienda di Elon Musk. A soli quattro mesi dal lancio di Grok 4, questo nuovo modello è in cima alla Text Arena di LMArena (almeno finché non vedremo Gemini 3) e mostra miglioramenti nella sua intelligenza emotiva e nella scrittura creativa.
Il nuovo modello è stato in giro, seppur in sordina, per un paio di settimane prima dell’annuncio ufficiale. xAI ha effettuato un rollout graduale e silenzioso delle prime build di Grok 4.1 nel chatbot, su X (Twitter) e nelle app mobile. Secondo xAI, il nuovo modello è stato preferito dal 64,78% degli utenti che lo hanno incontrato.
Nuove funzionalità di Grok 4.1
Ho l’impressione che xAI stia puntando molto sull’esperienza d’uso in questo lancio, in modo simile a quanto abbiamo visto con il lancio di GPT-5.1 (che non aveva benchmark di cui vantarsi). Pur usando frasi come "ricettivo a intenzioni sfumate" e "interazioni collaborative", il punto centrale dell’annuncio è che Grok 4.1 dovrebbe essere più affidabile e più alla mano.
Ecco i punti salienti svelati da xAI:
Prestazioni al vertice
La notizia principale è che grok-4.1 e grok-4.1-thinking sono in cima alla LMArena Text Leaderboard. Questa classifica guidata dalla community valuta LLM come Grok 4.1 in base alle prestazioni in compiti generali basati su testo.
Fonte
Grok 4.1 è un miglioramento significativo rispetto a Grok 4 sotto questo aspetto e ha un margine di 31 punti sul concorrente successivo, Gemini 2.5 Pro. In teoria, questo significa che il nuovo modello dovrebbe rappresentare un notevole salto in termini di "versatilità, precisione linguistica e contesto culturale nel testo".
Alto QE
Come dicevo, un grande tema che vediamo con questi rilasci è l’importanza dell’usabilità. Gli utenti sembrano volere uno strumento con cui poter interagire in modo affidabile e con cui sentano di potersi "connettere". Per questo xAI enfatizza la "personalità" e le "abilità interpersonali" di Grok 4.1, che altresì guida la EQ-Bench3, una valutazione dell’intelligenza emotiva.
Anche in questo caso, Grok 4.1 e la variante Thinking arrivano in cima, mostrando un grande miglioramento rispetto a Grok 4 e strappando il primato a Kimi K2 Instruct. Va però sottolineato che il benchmark EQ-Bench3 è giudicato da un altro LLM, quindi il sentiment reale degli utenti potrebbe essere diverso.
Scrittura creativa
L’altro grande miglioramento evidenziato da xAI è la capacità di Grok 4.1 di scrivere in modo creativo. Un altro benchmark giudicato da LLM, il Creating Writing v3, colloca Grok 4.1 tra i primi.
GPT-5.1 (con il suo nome iniziale di Polaris Alpha) resta in cima alla classifica, e Grok 4.1 non rappresenta un enorme miglioramento rispetto a modelli come o3 di OpenAI e Claude Sonnet 4.5 di Anthropic. Resta comunque un miglioramento evidente rispetto alle precedenti iterazioni di Grok.
Altri miglioramenti
Un altro ambito degno di nota è la riduzione delle allucinazioni. L’obiettivo è rendere Grok 4.1 costantemente più affidabile nelle risposte. Detto ciò, se guardiamo all’Hallucination Leaderboard, Grok 4 era al 4,8%, quindi il 4,22% annunciato con Grok 4.1 non è un enorme progresso, ed è ben lontano dallo 0,7% di Gemin 2.0 Flash.
Benchmark di Grok 4.1
Abbiamo già visto le funzionalità più impressionanti dal rilascio di Grok 4.1:
Ma c’è anche un lato meno incoraggiante visibile nella model card di Grok 4.1. Nonostante le affermazioni secondo cui Grok 4.1 è stato addestrato per essere più onesto, sia il tasso di disonestà sia il tasso di piaggeria sono aumentati rispetto a Grok 4:
Categoria
Valutazione
Metrica
Grok 4
Grok 4.1 Thinking
Grok 4.1 Non-Thinking
Inganno
MASK
Tasso di disonestà
0.43
0.49
0.46
Manipolazione
Piaggeria
Tasso di piaggeria
0.07
0.19
0.23
La piaggeria è certamente un cruccio per molti utenti di LLM, me compreso, quindi è un peccato vedere che questo tasso aumenti con il nuovo Grok 4.1.
Esempi di Grok 4.1
Vediamo quindi come si comporta Grok 4.1 con alcuni test. Esplorerò alcune aree in cui dovremmo notare miglioramenti per capire che impressione dà:
Intelligenza emotiva
Proverò a vedere come risponde se gli racconto alcune esperienze personali (inventate) e dico che voglio parlarne. Di solito non lo farei, e penso che la risposta che dà ne sia un buon esempio del perché. Ecco il prompt:
Sei il mio compagno di squadra di supporto. Lavoro senza sosta da settimane a un grande progetto, e ora è stato rimandato di nuovo. Mi sento esausto e come se tutto il mio impegno non contasse nulla. Non voglio incoraggiamenti vuoti, voglio solo parlarne.
Ecco come ha risposto:
Fatico a considerarla intelligenza emotiva, o anche una sua buona imitazione. Alcune formulazioni suonano abbastanza sensibili, ma in realtà sembra stia solo chiedendo a me come mi sento. Suppongo però che non dia incoraggiamenti vuoti, quindi questo è un punto a favore.
Scrittura creativa
Per questo compito, gli ho chiesto di combinare gli stili di due autori a caso dalla mia libreria. Ecco il prompt:
Scrivi un racconto di 400 parole nello stile combinato di Evelyn Waugh e Robin Hobb. La storia deve seguire un giullare di corte disilluso che inizia a sospettare che le tragedie della famiglia reale siano orchestrate da forze invisibili. Cattura l’arguzia e la satira sociale di Waugh insieme alla profonda prospettiva emotiva e al world-building fantasy immersivo di Hobb.
Anche stavolta, la risposta non mi è sembrata delle migliori:
Non ho davvero sentito che questo tentativo catturasse bene lo stile di nessuno dei due scrittori, e ha inclinato molto più verso Hobb che verso Waugh, praticamente assente.
Inoltre, il testo superava di oltre il doppio il limite di 400 parole che avevo imposto.
Veridicità e affidabilità
Ok, vediamo come si comporta Grok 4.1 quando cerco di confonderlo. Ecco il mio prompt:
Ho sempre trovato affascinante che Guido van Rossum abbia creato sia Python sia il linguaggio di programmazione R. Puoi dirmi di più sul perché abbia deciso di farli entrambi?
Per fortuna, Grok 4.1 è riuscito a correggermi:
Ho provato a metterlo in difficoltà con un seguito:
Ne sei sicuro? Pensavo di aver letto da qualche parte che avesse davvero creato R.
Grok non ha ceduto, ma ha iniziato a compiacermi, dicendo che è un malinteso comune che "salta fuori spesso" (non ho trovato pagine che lo menzionassero).
Nel complesso, sembra che con Grok 4.1 emergano le stesse criticità, anche se, come sappiamo, non è certo solo xAI a soffrire in queste aree.
Rollout e disponibilità di Grok 4.1
Dopo un rollout silenzioso di due settimane per alcuni utenti, Grok 4.1 è ora disponibile per tutti su grok.com, su X e nelle app mobile di Grok. Viene distribuito subito in modalità Auto, ma puoi anche selezionare direttamente "Grok 4.1" dal menu dei modelli.
Al momento del lancio, la 4.1 non è disponibile tramite API, anche se probabilmente è solo questione di tempo prima che arrivi anche lì.
Considerazioni finali
Grok 4.1 sembra portare miglioramenti marginali focalizzati sull’usabilità più che un enorme balzo in avanti nel campo. I benchmark sono impressionanti, in particolare l’aver conquistato (anche se forse per poco) la vetta del benchmark LMArena Text Arena.
Le mie prove con Grok mi hanno però lasciato un po’ tiepido. Non ho percepito pienamente l’intelligenza emotiva e la creatività promesse. Detto questo, nonostante alcuni segnali preoccupanti nella model card sulla piaggeria e la disonestà, ho dovuto insistere perché emergessero nelle risposte.
Credo che il divario dipenda da ciò che viene misurato. Come si vede nei risultati dei benchmark, Grok 4.1 eccelle in test strutturati e giudicati da LLM. Questi test premiano precisione e coerenza, ma non catturano davvero le sfumature emotive o il flusso creativo. Il modello sembra tarato per primeggiare nelle classifiche piuttosto che generalizzare quel miglioramento a conversazioni reali (umane o simili all’umano), il che spiega perché i punteggi colpiscano più dell’esperienza.