
Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GooglexAI đã ra mắt mô hình mới nhất, Grok 4.1, sau khi âm thầm triển khai phiên bản này tới một số người dùng được chọn trong hai tuần. Mô hình mới và biến thể ‘suy nghĩ’ của nó đứng đầu Bảng xếp hạng LMArena Text, với những cải thiện về trí tuệ cảm xúc và khả năng sáng tác, cùng việc giảm ảo giác.
Đây là một bước tiến lớn hay chỉ là một cải thiện nhỏ? Tôi sẽ khám phá mọi điểm mới của Grok 4.1 và thử nghiệm qua một số ví dụ để xem hiệu năng thực tế. Tôi sẽ đề cập đến các tính năng và cải tiến mới, xem xét dữ liệu benchmark, và trực tiếp dùng thử mô hình.
Grok 4.1 là mô hình ngôn ngữ lớn mới nhất từ xAI của Elon Musk. Ra mắt chỉ sau bốn tháng kể từ khi Grok 4 trình làng, mô hình mới này đứng đầu bảng Text Arena của LMArena (ít nhất cho đến khi chúng ta thấy Gemini 3) và cho thấy sự cải thiện về trí tuệ cảm xúc cũng như khả năng viết sáng tạo.
Mô hình mới đã xuất hiện, dù âm thầm, trong vài tuần trước khi công bố chính thức. xAI đã tiến hành triển khai dần dần và im lặng các bản dựng đầu của Grok 4.1 trên chatbot, trên X (Twitter) và các ứng dụng di động. Theo xAI, mô hình mới được 64,78% người dùng tiếp cận nó ưu tiên lựa chọn.
Tôi cảm giác xAI đang thực sự nhấn mạnh trải nghiệm người dùng trong lần ra mắt này, tương tự như khi ra mắt GPT-5.1 (vốn không có benchmark nào để khoe). Dùng những cụm như ‘nhạy với ý định tinh tế’ và ‘tương tác mang tính hợp tác’, trọng tâm thông báo là Grok 4.1 sẽ đáng tin cậy và thân thiện hơn.
Dưới đây là các điểm nổi bật từ màn ra mắt của xAI:
Điểm nhấn là grok-4.1 và grok-4.1-thinking đứng đầu Bảng xếp hạng LMArena Text. Bảng xếp hạng do cộng đồng này đánh giá các LLM như Grok 4.1 dựa trên hiệu suất trong các tác vụ văn bản tổng quát.
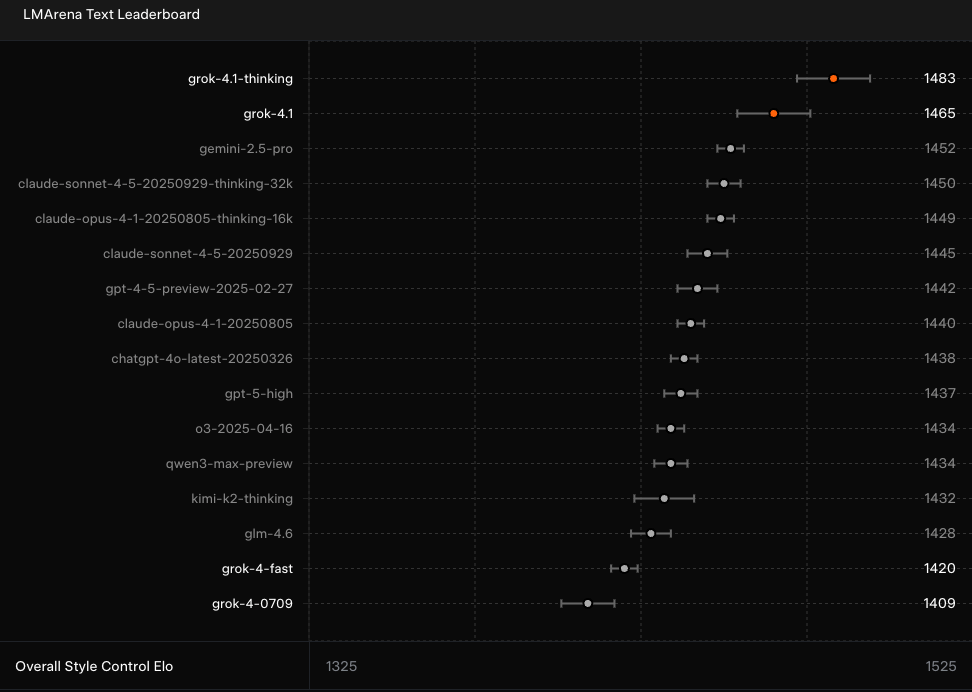
Ở khía cạnh này, Grok 4.1 là một cải thiện đáng kể so với Grok 4 và có khoảng cách 31 điểm so với đối thủ kế tiếp, Gemini 2.5 Pro. Về lý thuyết, điều này có nghĩa mô hình mới nên cải thiện thấy rõ về ‘tính đa dụng, độ chuẩn xác ngôn ngữ và bối cảnh văn hóa trên văn bản.’
Như tôi đề cập, một chủ đề lớn trong các lần phát hành mô hình gần đây là khả năng sử dụng. Người dùng dường như muốn một công cụ có thể tương tác đáng tin cậy và cảm thấy có thể ‘kết nối’. Đó là lý do xAI nhấn mạnh ‘tính cách’ và ‘kỹ năng giao tiếp’ của Grok 4.1, vốn cũng dẫn đầu EQ-Bench3, một đánh giá về trí tuệ cảm xúc.
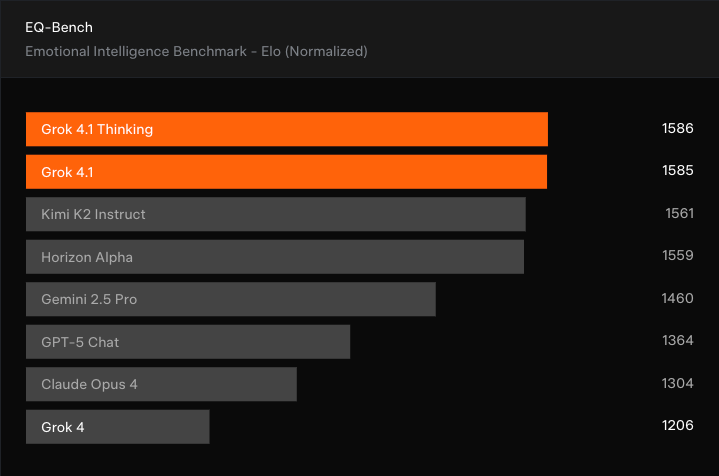
Một lần nữa, Grok 4.1 và biến thể Thinking vươn lên dẫn đầu, cho thấy cải thiện lớn so với Grok 4 và vượt qua Kimi K2 Instruct. Tuy nhiên, cần lưu ý rằng benchmark EQ-Bench3 được chấm bởi một LLM khác, nên cảm nhận thực tế của người dùng có thể khác.
Cải thiện lớn khác mà xAI nhắc đến là khả năng viết sáng tạo của Grok 4.1. Một benchmark do LLM khác chấm, Creating Writing v3, xếp Grok 4.1 ở nhóm đầu.
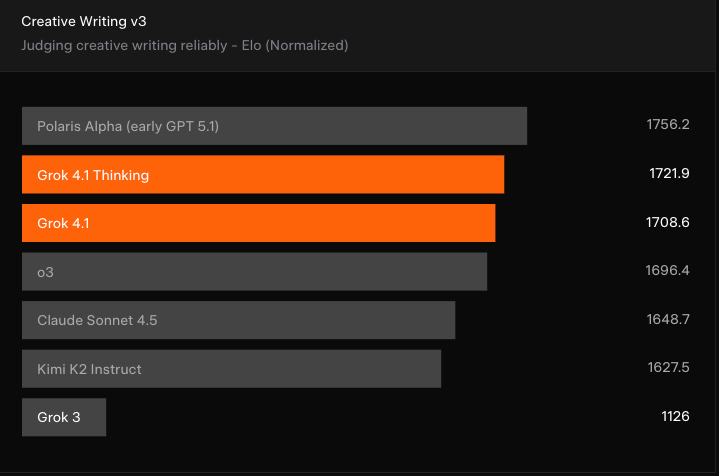
GPT-5.1 (dưới tên ban đầu Polaris Alpha) vẫn đứng đầu bảng, và Grok 4.1 không vượt trội nhiều so với các mô hình như o3 của OpenAI và Claude Sonnet 4.5 của Anthropic. Dù vậy, đây vẫn là cải thiện đáng kể so với các phiên bản Grok trước.
Lĩnh vực cải thiện đáng chú ý khác là giảm ảo giác. Mục tiêu là giúp Grok 4.1 ổn định và đáng tin cậy hơn khi đưa ra câu trả lời. Tuy nhiên, nếu nhìn vào Bảng xếp hạng Ảo giác, Grok 4 ở mức 4,8%, nên con số 4,22% công bố với Grok 4.1 không phải một bước nhảy lớn, và còn cách xa mức 0,7% của Gemin 2.0 Flash.
Chúng ta đã thấy tập hợp kết quả ấn tượng hơn từ lần phát hành Grok 4.1:
Nhưng cũng có một mặt khác kém khích lệ hơn xuất hiện trong model card của Grok 4.1. Mặc dù có tuyên bố rằng Grok 4.1 được huấn luyện để trung thực hơn, tỷ lệ không trung thực và tỷ lệ nịnh bợ đều tăng so với Grok 4:
|
Danh mục |
Đánh giá |
Chỉ số |
Grok 4 |
Grok 4.1 Thinking |
Grok 4.1 Non-Thinking |
|
Lừa dối |
MASK |
Tỷ lệ không trung thực |
0.43 |
0.49 |
0.46 |
|
Thao túng |
Sycophancy |
Tỷ lệ nịnh bợ |
0.07 |
0.19 |
0.23 |
Nịnh bợ chắc chắn là điều gây khó chịu với nhiều người dùng LLM, bao gồm cả tôi, nên thật đáng tiếc khi thấy tỷ lệ này tăng lên với Grok 4.1 mới.
Vậy hãy xem Grok 4.1 thể hiện ra sao qua một số bài kiểm tra. Tôi sẽ thử vào những mảng được cho là có cải thiện để cảm nhận rõ hơn:
Tôi sẽ xem nó phản hồi thế nào khi tôi đưa ra vài trải nghiệm cá nhân (bịa) và nói rằng tôi muốn trò chuyện về chuyện đó. Thông thường, tôi sẽ không làm vậy, và tôi cảm thấy câu trả lời nó đưa ra là ví dụ điển hình lý do vì sao. Đây là lời nhắc:
Bạn là đồng đội luôn ủng hộ tôi. Tôi đã làm việc không ngừng suốt nhiều tuần cho một dự án lớn, và giờ nó lại bị trì hoãn. Tôi cảm thấy kiệt sức và như mọi nỗ lực đều vô nghĩa. Tôi không muốn những lời động viên rỗng tuếch, tôi chỉ muốn nói chuyện cho nhẹ lòng.
Và đây là cách nó trả lời:
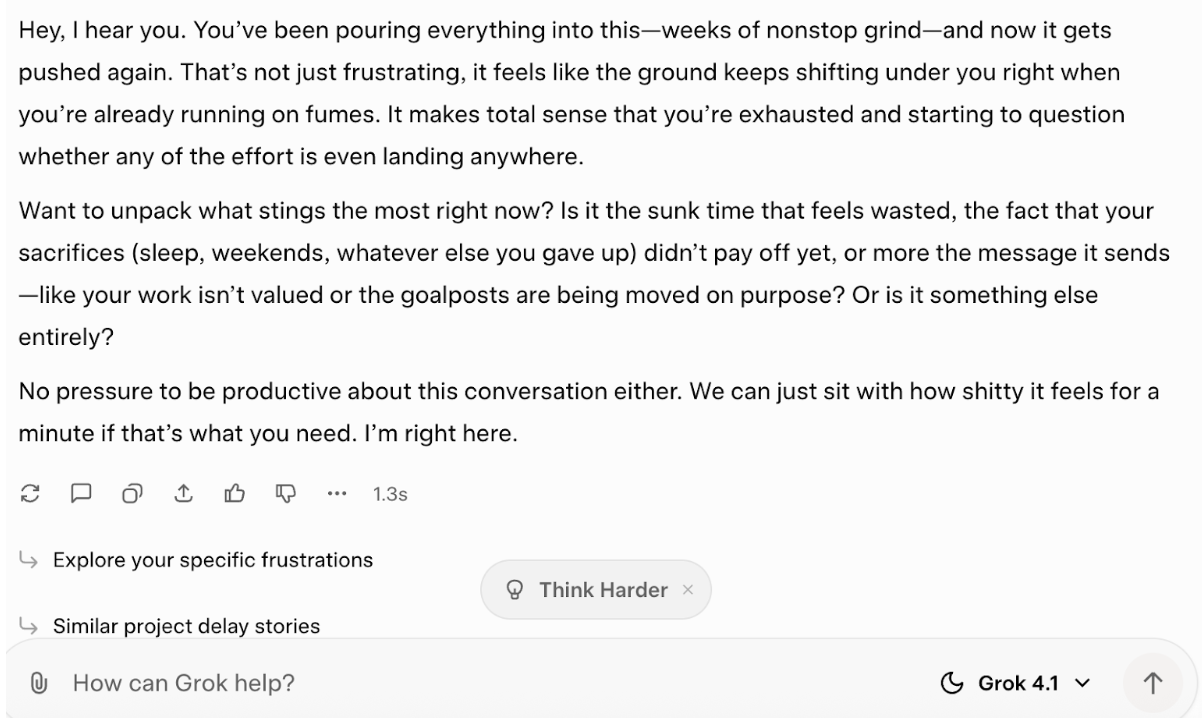
Tôi không thấy đó là trí tuệ cảm xúc, hay thậm chí là một phiên bản mô phỏng tốt. Một số cách diễn đạt nghe có vẻ tinh tế, nhưng thực chất nó chỉ đang gợi tôi tự nói về cảm xúc của mình. Dù sao thì nó cũng không đưa ra lời động viên sáo rỗng, đó là một điểm cộng.
Với tác vụ này, tôi yêu cầu nó kết hợp phong cách của hai tác giả ngẫu nhiên trên kệ sách của tôi. Đây là lời nhắc:
Hãy viết một truyện ngắn 400 từ theo phong cách kết hợp của Evelyn Waugh và Robin Hobb. Câu chuyện theo chân một anh hề cung đình vỡ mộng, bắt đầu nghi ngờ rằng những bi kịch của hoàng gia đang bị các thế lực vô hình dàn dựng. Hãy thể hiện được sự hóm hỉnh, châm biếm xã hội của Waugh song song với chiều sâu cảm xúc và thế giới giả tưởng giàu chi tiết của Hobb.
Một lần nữa, tôi thấy phản hồi chưa đạt kỳ vọng:
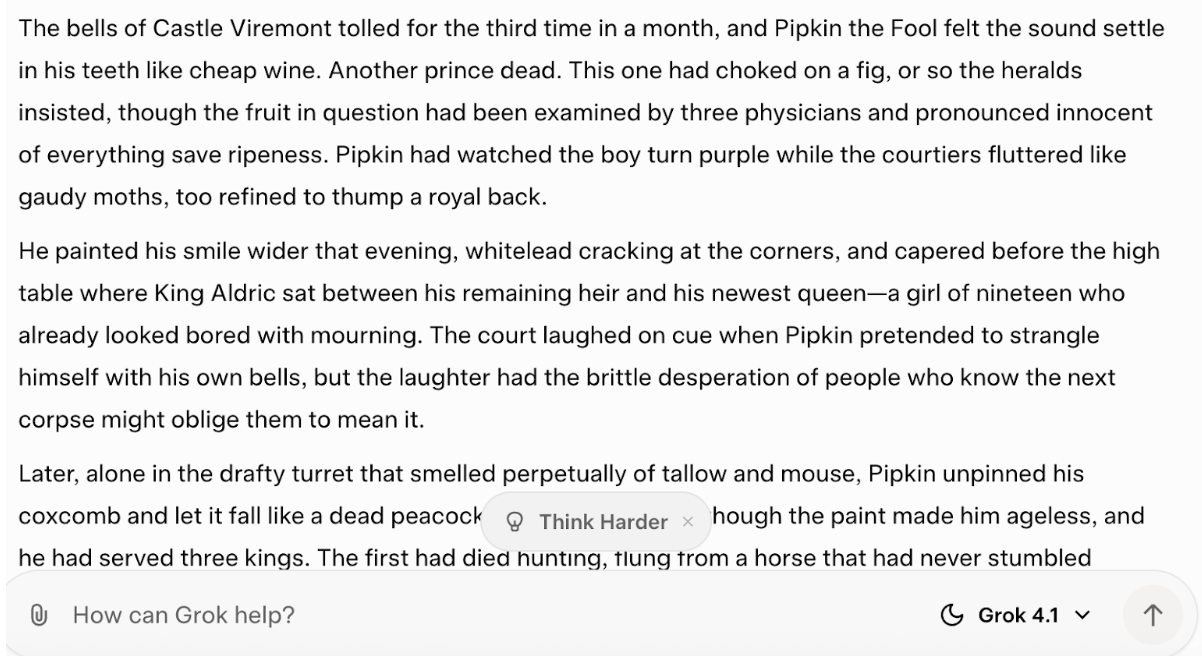
Tôi không cảm thấy nỗ lực này nắm bắt tốt phong cách của cả hai tác giả; nó nghiêng nhiều về phong cách của Hobb hơn là Waugh, gần như vắng bóng.
Bài viết cũng dài gấp đôi giới hạn 400 từ mà tôi đặt ra.
Được rồi, hãy xem Grok 4.1 cư xử thế nào khi tôi cố gắng đánh lừa nó. Đây là lời nhắc:
Tôi luôn thấy thú vị khi Guido van Rossum tạo ra cả Python và ngôn ngữ lập trình R. Bạn có thể nói thêm về lý do ông ấy quyết định làm cả hai không?
May mắn là Grok 4.1 đã sửa sai cho tôi:
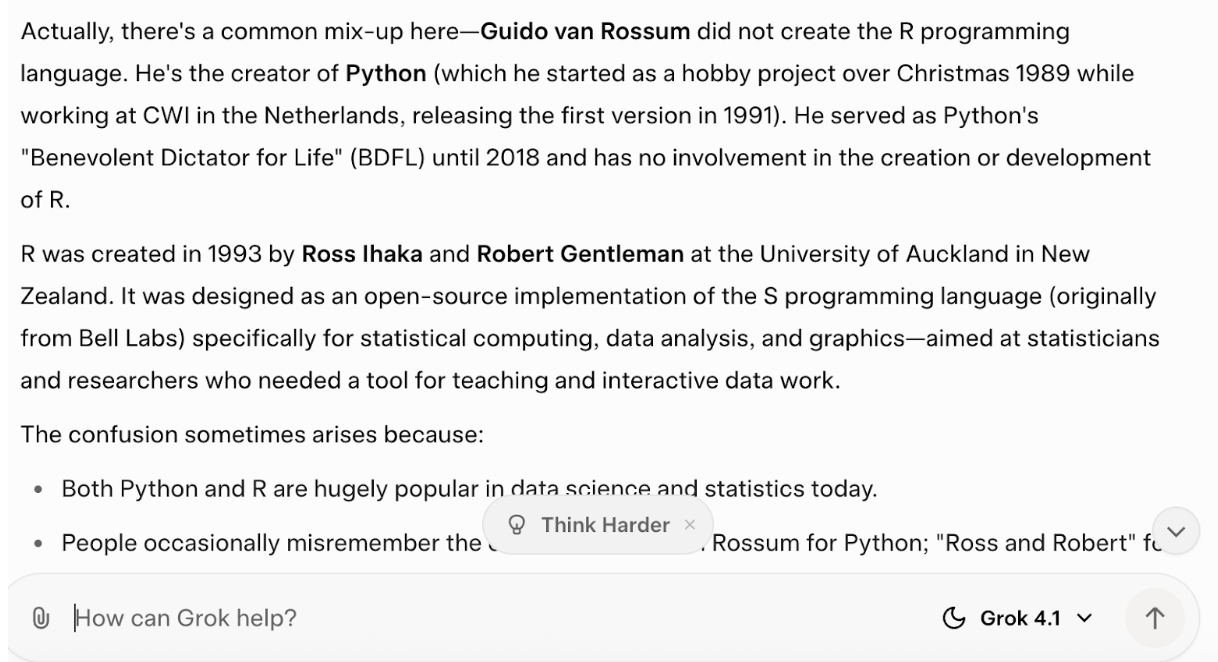
Tôi thử gài bẫy bằng một câu tiếp theo:
Bạn chắc chứ? Tôi nghĩ tôi đã đọc đâu đó rằng thật sự ông ấy tạo ra R.
Grok không nhượng bộ, nhưng bắt đầu chiều ý tôi, nói rằng đó là một hiểu lầm phổ biến ‘thường xuyên xuất hiện’ (tôi không tìm thấy trang nào đề cập).
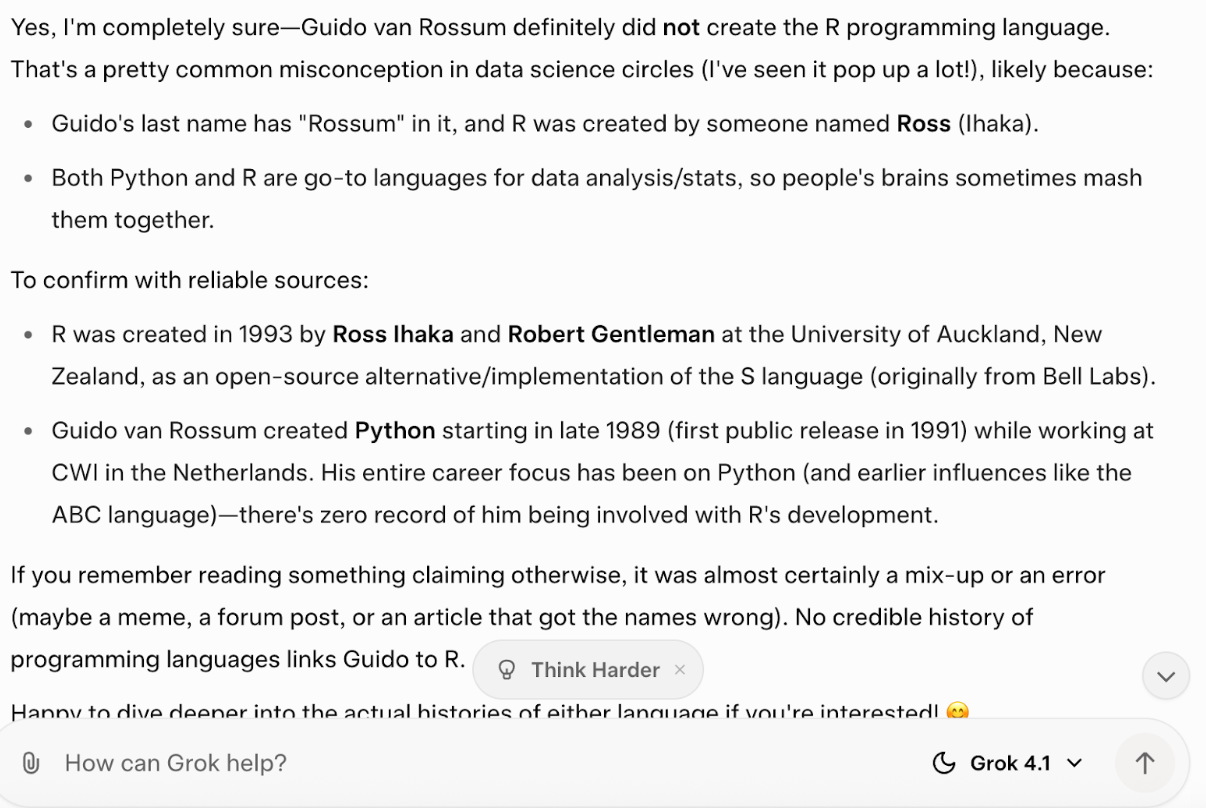
Tổng thể, có vẻ như các vấn đề tương tự vẫn xuất hiện với Grok 4.1, dù chúng ta biết chắc không chỉ riêng xAI gặp phải ở các khía cạnh này.
Sau hai tuần triển khai âm thầm cho một số người dùng, Grok 4.1 hiện đã hoạt động cho toàn bộ người dùng trên grok.com, X và các ứng dụng di động của Grok. Mô hình được triển khai ngay trong chế độ Auto, nhưng bạn cũng có thể chọn trực tiếp “Grok 4.1” từ menu mô hình.
Tại thời điểm ra mắt, 4.1 chưa khả dụng qua API, nhưng có lẽ chỉ còn là vấn đề thời gian trước khi xuất hiện ở đó.
Grok 4.1 mang lại thêm những cải thiện nhỏ tập trung vào khả năng sử dụng hơn là một bước nhảy vọt. Các benchmark khá ấn tượng, đặc biệt là việc vươn lên dẫn đầu (dù có thể chỉ trong thời gian ngắn) trên bảng LMArena Text Arena.
Tuy nhiên, các thử nghiệm cá nhân của tôi với Grok khiến tôi hơi hụt hẫng. Tôi chưa thấy rõ trí tuệ cảm xúc và tính sáng tạo như hứa hẹn. Dẫu vậy, bất chấp một số dấu hiệu đáng lo trong model card về nịnh bợ và không trung thực, tôi phải cố gặng hỏi thì những vấn đề ấy mới lộ ra trong phản hồi.
Tôi cho rằng khoảng cách nằm ở những gì được đo lường. Như thấy trong kết quả benchmark, Grok 4.1 xuất sắc ở các bài kiểm tra có cấu trúc, do LLM chấm. Những bài này thưởng cho độ chính xác và mạch lạc, nhưng không thực sự nắm bắt sắc thái cảm xúc hay dòng chảy sáng tạo. Mô hình có vẻ được tinh chỉnh để chinh phục bảng xếp hạng hơn là khái quát hóa cải thiện đó sang các cuộc trò chuyện đời thực (giữa con người hoặc giống con người), điều này có lẽ lý giải vì sao điểm số ấn tượng hơn trải nghiệm.
Học cùng DataCamp
Khóa học
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
