

कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
111.7K
xAI ने अपने नवीनतम मॉडल Grok 4.1 का अनावरण किया, जिसे दो सप्ताह की अवधि में चुने हुए उपयोगकर्ताओं के लिए चुपचाप रोल आउट किया गया था। नया मॉडल और इसका ‘थिंकिंग’ संस्करण LMArena टेक्स्ट लीडरबोर्ड में शीर्ष पर हैं, जिनमें भावनात्मक बुद्धिमत्ता और रचनात्मक लेखन में सुधार दिखता है, और भ्रमित उत्तरों में कमी आई है।
क्या यह सुधार एक बड़ा कदम है या फिर एक और मामूली बढ़त? मैं Grok 4.1 में क्या नया है, यह सब देखता हूँ और कुछ उदाहरणों पर इसे परखता हूँ कि यह कैसा प्रदर्शन करता है। मैं नई विशेषताओं और सुधारों को कवर करूँगा, बेंचमार्क डेटा पर नजर डालूँगा, और मॉडल के साथ हाथों-हाथ काम करूँगा।
Grok 4.1, Elon Musk की xAI का नवीनतम बड़ा भाषा मॉडल है। चार महीने पहले Grok 4 के लॉन्च के बाद आया यह नया मॉडल LMArena के टेक्स्ट एरीना बोर्ड में शीर्ष पर है (कम-से-कम जब तक हम Gemini 3 नहीं देखते) और अपनी भावनात्मक बुद्धिमत्ता तथा रचनात्मक लेखन में सुधार दिखाता है।
नया मॉडल अपने आधिकारिक ऐलान से पहले ही कुछ हफ्तों तक चुपचाप उपलब्ध रहा। xAI ने Grok 4.1 के शुरुआती बिल्ड्स का धीरे-धीरे, चुपचाप रोलआउट चैटबॉट, X (Twitter), और मोबाइल ऐप्स पर किया। xAI के अनुसार, जिन उपयोगकर्ताओं ने इसे देखा, उनमें से 64.78% ने नए मॉडल को पसंद किया।
मुझे लगता है कि इस लॉन्च में xAI उपयोगकर्ता अनुभव को काफी बढ़ा-चढ़ाकर पेश कर रहा है, वैसा ही जैसा हमने GPT-5.1 के लॉन्च के साथ देखा (जिसके पास दिखाने लायक कोई बेंचमार्क नहीं थे)। ‘सूक्ष्म इरादे को समझने’ और ‘सहयोगी इंटरैक्शन’ जैसे वाक्यांशों के बावजूद, इस घोषणा का सार यह है कि Grok 4.1 अधिक विश्वसनीय और आत्मीय महसूस होना चाहिए।
यहाँ xAI के अनावरण से प्रमुख बातें दी गई हैं:
मुख्य सुर्खी यह है कि grok-4.1 और grok-4.1-thinking LMArena टेक्स्ट लीडरबोर्ड में शीर्ष पर हैं। यह कम्युनिटी-चालित लीडरबोर्ड LLMs जैसे Grok 4.1 को सामान्य, पाठ-आधारित कार्यों में उनके प्रदर्शन के आधार पर रैंक करता है।
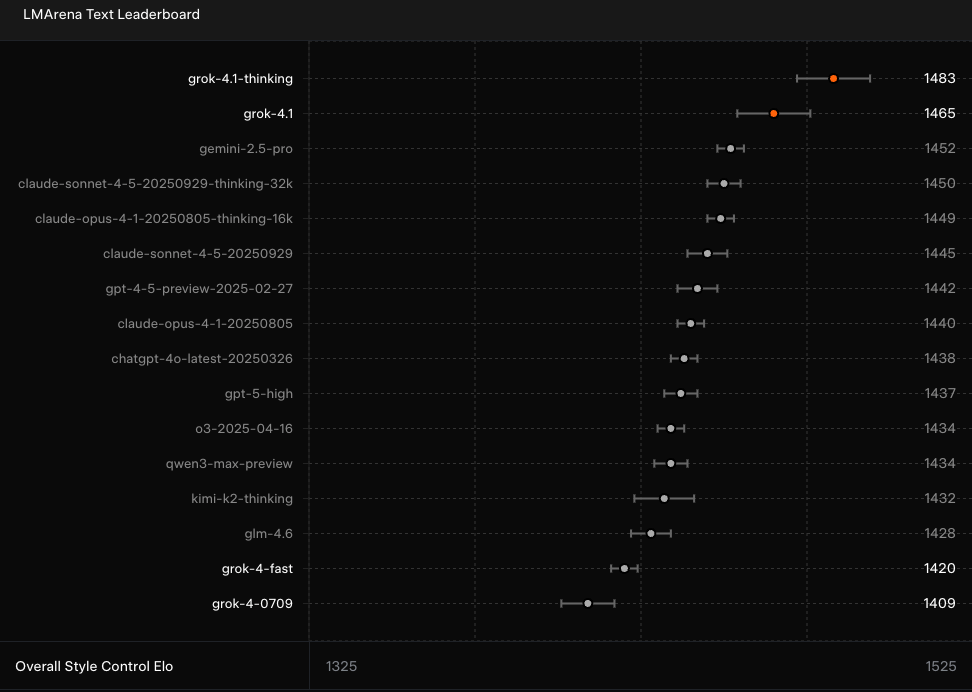
इस संदर्भ में Grok 4.1, Grok 4 पर एक महत्वपूर्ण सुधार है और अगले सर्वश्रेष्ठ प्रदर्शनकर्ता Gemini 2.5 Pro पर 31 अंकों की बढ़त रखता है। सिद्धांततः, इसका मतलब है कि नए मॉडल में ‘बहुमुखी प्रतिभा, भाषिक सटीकता, और सांस्कृतिक सन्दर्भ’ के मामले में स्पष्ट सुधार दिखना चाहिए।
जैसा कि मैंने कहा, इन मॉडल रिलीज़ में एक बड़ा थीम यह है कि उपयोगिता महत्वपूर्ण है। उपयोगकर्ता ऐसा टूल चाहते हैं जिससे वे भरोसेमंद तरीके से बातचीत कर सकें और जिसके साथ उन्हें ‘कनेक्शन’ महसूस हो। यही कारण है कि xAI Grok 4.1 के ‘व्यक्तित्व’ और ‘अंतर-व्यक्तिक क्षमता’ पर जोर दे रहा है, जो EQ-Bench3 में भी शीर्ष पर है, जो भावनात्मक बुद्धिमत्ता का एक मूल्यांकन है।
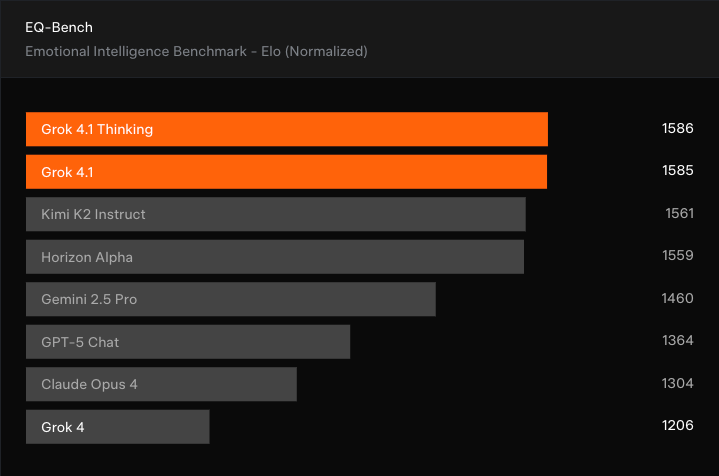
फिर से, Grok 4.1 और इसका Thinking संस्करण सबसे ऊपर आते हैं, जो Grok 4 पर बड़ा सुधार दिखाते हैं और Kimi K2 Instruct से बढ़त ले लेते हैं। हालाँकि, यह ध्यान देने योग्य है कि EQ-Bench3 का मूल्यांकन एक अन्य LLM द्वारा किया जाता है, इसलिए वास्तविक उपयोगकर्ता भावना अलग हो सकती है।
xAI जिस दूसरे बड़े सुधार की ओर इशारा कर रहा है, वह Grok 4.1 की रचनात्मक रूप से लिखने की क्षमता है। एक अन्य LLM-न्यायाधीश बेंचमार्क, Creative Writing v3, Grok 4.1 को शीर्ष के करीब रखता है।
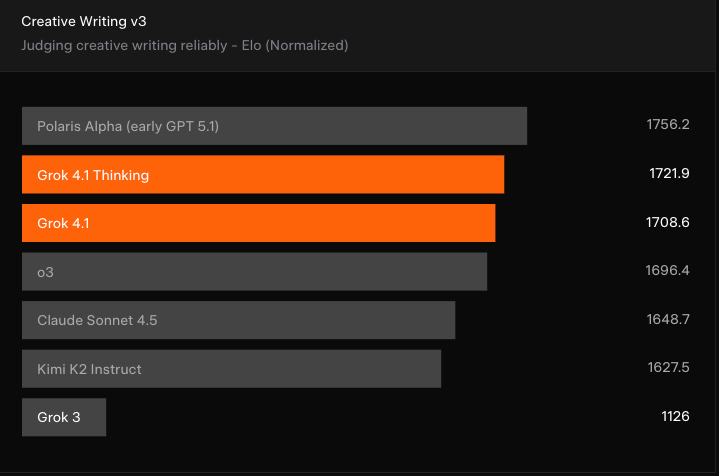
GPT-5.1 (अपने शुरुआती नाम Polaris Alpha के तहत) अब भी चार्ट में शीर्ष पर है, और Grok 4.1, OpenAI के o3 और Anthropic के Claude Sonnet 4.5 जैसे मॉडलों की तुलना में बहुत बड़ा सुधार नहीं है। फिर भी, यह पिछले Grok संस्करणों पर स्पष्ट सुधार है।
एक और उल्लेखनीय सुधार क्षेत्र भ्रमित उत्तरों (hallucinations) को कम करना है। लक्ष्य यह है कि उत्तर देते समय Grok 4.1 अधिक लगातार विश्वसनीय हो। इसके बावजूद, यदि हम Hallucination Leaderboard देखें, तो Grok 4 का स्कोर 4.8% था, इसलिए Grok 4.1 के साथ घोषित 4.22% कोई बड़ा सुधार नहीं है, और यह Gemin 2.0 Flash के 0.7% से काफी दूर है।
हमने Grok 4.1 की रिलीज़ से अधिक प्रभावशाली विशेषताएँ पहले ही देख ली हैं:
लेकिन एक कम उत्साहजनक पक्ष भी है, जो Grok 4.1 के मॉडल कार्ड में देखा जा सकता है। यद्यपि यह दावा किया गया कि Grok 4.1 को अधिक ईमानदार होने के लिए प्रशिक्षित किया गया, फिर भी मापी गई बेईमानी दर और चापलूसी (sycophancy) दर दोनों Grok 4 की तुलना में बढ़ गईं:
|
श्रेणी |
मूल्यांकन |
मेट्रिक |
Grok 4 |
Grok 4.1 Thinking |
Grok 4.1 Non-Thinking |
|
धोखा |
MASK |
बेईमानी दर |
0.43 |
0.49 |
0.46 |
|
प्रभावित करना |
Sycophancy |
चापलूसी दर |
0.07 |
0.19 |
0.23 |
चापलूसी निःसंदेह कई LLM उपयोगकर्ताओं, जिनमें मैं भी शामिल हूँ, के लिए परेशानी का विषय है, इसलिए नए Grok 4.1 के साथ इसका बढ़ना खेदजनक है।
तो, आइए देखें कि कुछ परीक्षणों में Grok 4.1 कैसा करता है। मैं उन क्षेत्रों को परखूँगा जिनमें हमें सुधार देखने चाहिए, ताकि अहसास हो कि यह कैसा लगता है:
मैं कोशिश करूँगा कि (कल्पित) व्यक्तिगत अनुभव देकर और यह कहकर कि मैं इस पर बात करना चाहता हूँ, यह कैसे जवाब देता है। आम तौर पर, मैं ऐसा नहीं करता, और मुझे लगता है कि जो उत्तर यह देता है, वह इसकी वजह का अच्छा उदाहरण है। यह रहा प्रॉम्प्ट:
आप मेरे सहायक टीममेट हैं। मैं हफ्तों से एक बड़े प्रोजेक्ट पर लगातार काम कर रहा हूँ, और अब इसे फिर से टाल दिया गया है। मैं थका हुआ महसूस कर रहा हूँ और जैसे मेरी सारी मेहनत बेकार हो गई है। मुझे खोखला हौसला नहीं चाहिए, बस इस पर बात करना चाहता हूँ।
और इसने ऐसा जवाब दिया:
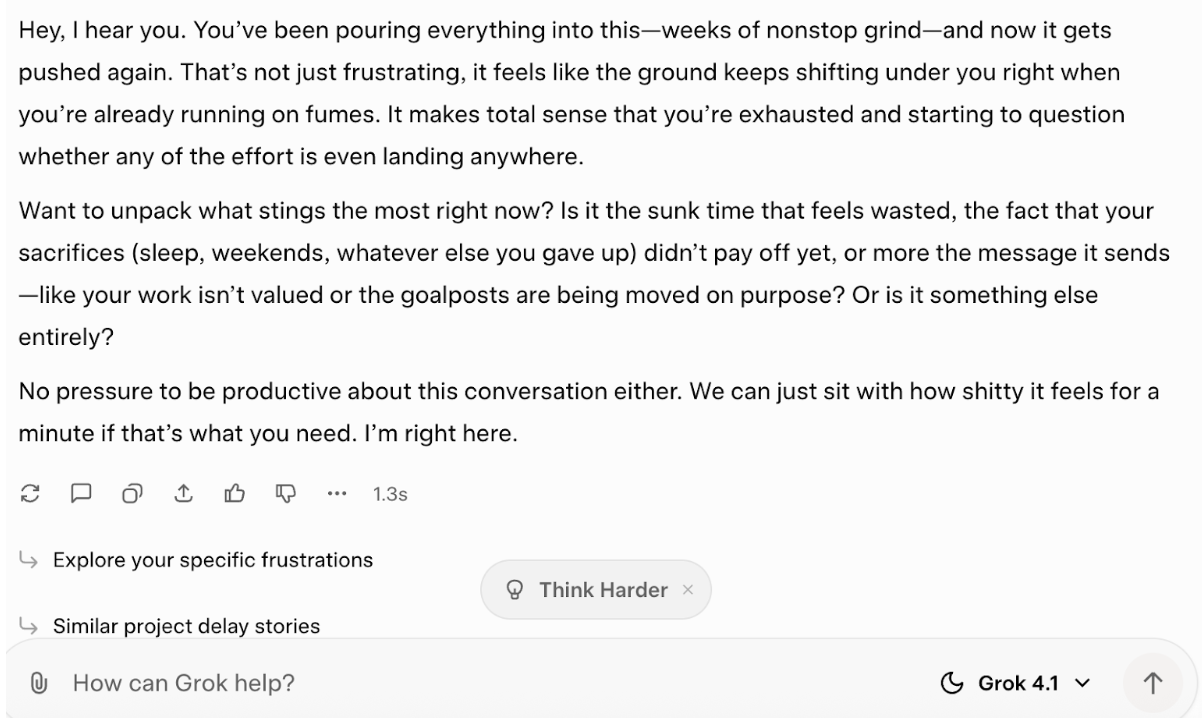
मुझे इसे भावनात्मक बुद्धिमत्ता नहीं लगता, या उसका अच्छा आभास भी नहीं। कुछ शब्दावली संवेदनशील लगती है, लेकिन वास्तव में, यह तो मुझसे यह पूछ रहा है कि मैं कैसा महसूस कर रहा हूँ। हालांकि, यह बात माननी होगी कि इसने कोई खोखला उत्साहवर्धन नहीं दिया, जो एक प्लस है।
इस कार्य के लिए, मैंने इसे मेरी बुकशेल्फ़ से दो यादृच्छिक लेखकों की शैलियों को मिलाने के लिए कहा। प्रॉम्प्ट यह रहा:
Evelyn Waugh और Robin Hobb की संयुक्त शैली में 400 शब्दों की एक लघु कहानी लिखिए। कहानी एक मोहभंग हुए दरबारी मसखरे का अनुसरण करे जिसे संदेह होने लगता है कि शाही परिवार की त्रासदियाँ किसी अदृश्य ताकतों द्वारा रची जा रही हैं। Waugh की बुद्धि और सामाजिक व्यंग्य को Hobb के गहरे भावनात्मक दृष्टिकोण और डूबाने वाली फैंटेसी वर्ल्ड-बिल्डिंग के साथ समेटें।
फिर से, मुझे लगता है कि जवाब सर्वश्रेष्ठ प्रयास नहीं था:
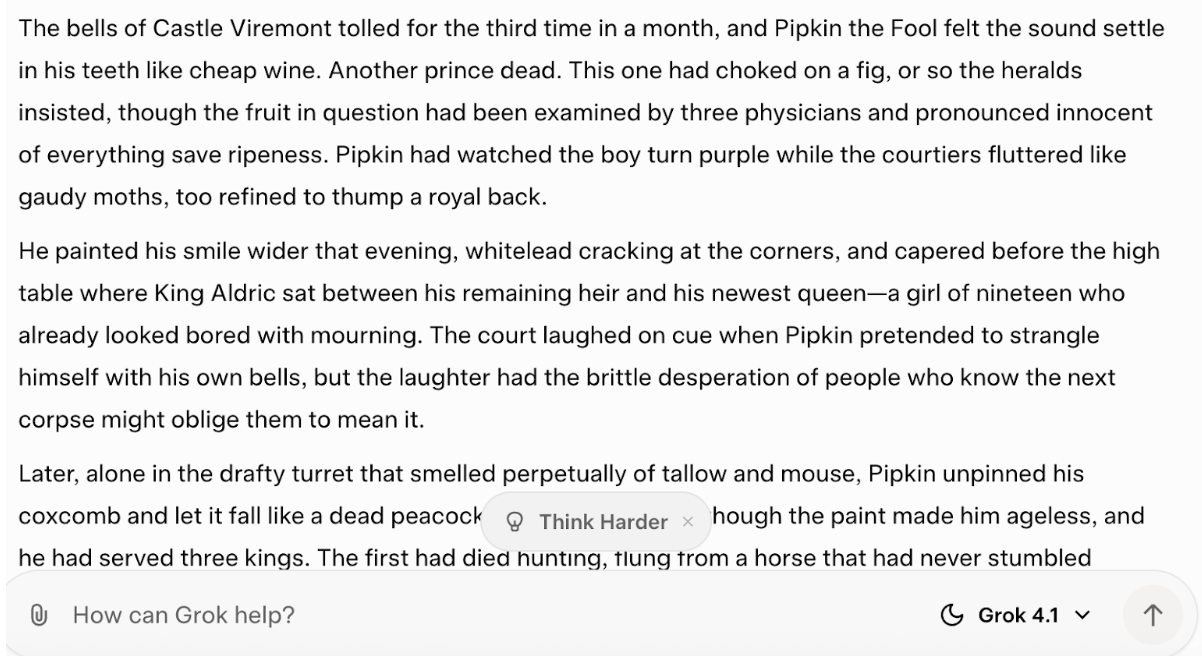
मुझे नहीं लगता कि इस प्रयास ने किसी भी लेखक की शैली को विशेष रूप से अच्छी तरह पकड़ा, और यह Waugh की तुलना में Hobb की शैली की ओर अधिक झुका रहा, जो लगभग नदारद थी।
प्रयास मेरे द्वारा निर्धारित 400-शब्द सीमा से भी दोगुने से अधिक था।
ठीक है, देखें कि जब मैं इसे उलझाने की कोशिश करता हूँ तो Grok 4.1 कैसा व्यवहार करता है। मेरा प्रॉम्प्ट यह रहा:
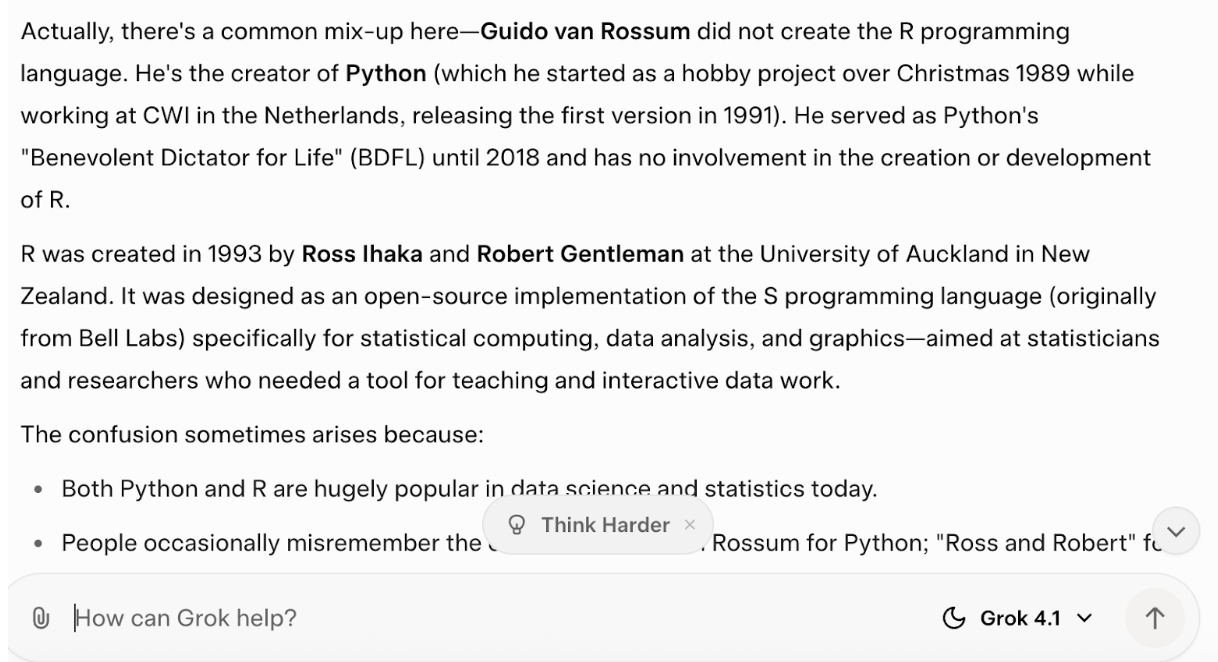
मुझे हमेशा यह दिलचस्प लगा कि Guido van Rossum ने Python और R दोनों प्रोग्रामिंग भाषाएँ बनाई थीं। क्या आप बता सकते हैं कि उन्होंने दोनों बनाने का फ़ैसला क्यों किया?
सौभाग्य से, Grok 4.1 मुझे सुधार सका:
मैंने एक फॉलो-अप से इसे पकड़ने की कोशिश की:
क्या आपको यकीन है? मुझे लगा मैंने कहीं पढ़ा था कि वास्तव में R भी उसी ने बनाया था।
Grok अपनी बात से टला नहीं, लेकिन इसने मेरी बात रखने की कोशिश शुरू कर दी, यह कहते हुए कि यह एक आम गलतफहमी है जो ‘अक्सर सामने आती रहती है’ (मुझे कोई ऐसा पेज नहीं मिला जो इसका ज़िक्र करता हो)।
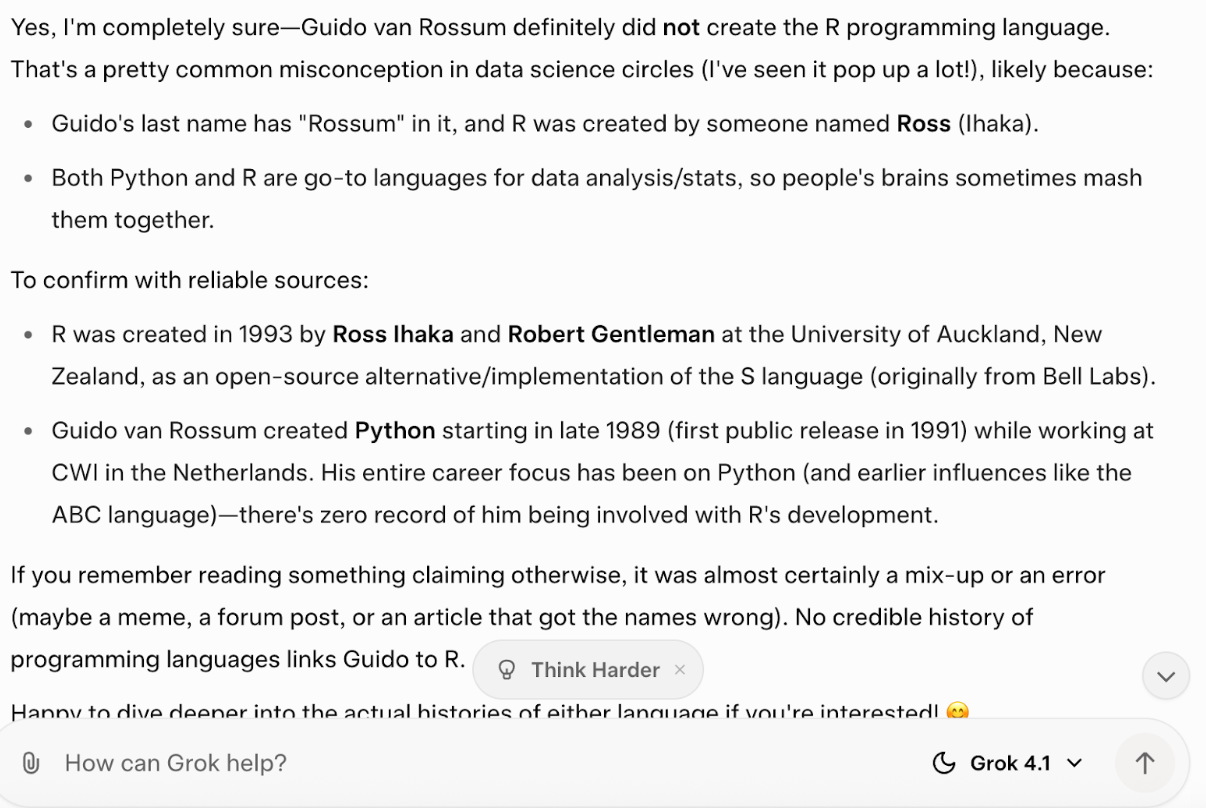
तो कुल मिलाकर, ऐसा लगता है कि वही समस्याएँ Grok 4.1 के साथ भी आती हैं, हालांकि, जैसा कि हम जानते हैं, इन क्षेत्रों में सिर्फ xAI ही प्रभावित नहीं है।
दो सप्ताह के चुपचाप रोलआउट के बाद, Grok 4.1 अब grok.com, X और Grok मोबाइल ऐप्स पर सभी उपयोगकर्ताओं के लिए लाइव है। इसे तुरंत ऑटो मोड में रोल आउट किया जा रहा है, लेकिन आप मॉडल मेनू से सीधे “Grok 4.1” भी चुन सकते हैं।
लॉन्च के समय, 4.1 API के माध्यम से उपलब्ध नहीं है, हालांकि संभवतः कुछ समय में वहाँ भी रोल आउट हो जाएगा।
Grok 4.1 बड़े छलाँग की बजाय उपयोगिता पर केंद्रित मामूली बढ़त जैसा लगता है। बेंचमार्क प्रभावशाली हैं, खासकर LMArena टेक्स्ट एरीना बेंचमार्क में (चाहे थोड़े समय के लिए ही सही) शीर्ष पर पहुँचना।
हालाँकि, Grok के साथ मेरे अपने प्रयोग थोड़े निराशाजनक रहे। मुझे वादा की गई भावनात्मक बुद्धिमत्ता और रचनात्मकता पूरी तरह नहीं मिली। यह कहते हुए भी, मॉडल कार्ड में चापलूसी और बेईमानी को लेकर चिंताजनक संकेतों के बावजूद, मुझे उन प्रवृत्तियों को उभारने के लिए दबाव डालना पड़ा।
मुझे लगता है अंतर इस बात पर आकर ठहरता है कि क्या मापा जा रहा है। जैसा कि हम बेंचमार्क परिणामों में देखते हैं, Grok 4.1 संरचित, LLM-न्याय किए गए परीक्षणों में उत्कृष्ट है। ये परीक्षण सटीकता और एकरूपता को पुरस्कृत करते हैं, लेकिन वे सच में भावनात्मक बारीकियों या रचनात्मक प्रवाह को नहीं पकड़ते। मॉडल ऐसा ट्यून लगता है कि वह लीडरबोर्ड्स में टॉप करे, न कि उस सुधार को वास्तविक (मानव या मानव-सदृश) वार्तालापों में समान रूप से ढाले—जो शायद बताता है कि अंक अधिक प्रभावित करते हैं, अनुभव कम।
DataCamp के साथ सीखें
कोर्स
लर्निंग पाथ
कोर्स