
Kursus
Supervised Learning dengan scikit-learn
4 jam
308.8K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GooglecuML dari NVIDIA adalah pustaka pembelajaran mesin yang dipercepat GPU dan merupakan bagian dari ekosistem RAPIDS AI. Kini, dalam versi beta terbuka, cuML 25.02 memungkinkan akselerasi GPU di scikit-learn, UMAP, dan HDBSCAN tanpa mengubah kode Python Anda. Ini tentu menjadi kabar menarik bagi engineer machine learning Python, ilmuwan data dan riset, developer, dan banyak profesional lain yang menantikan peningkatan kinerja model mereka.
Jangan khawatir jika Anda belum familier dengan cuML atau bahkan konsep akselerasi GPU. Saya akan mengulasnya, dan di akhir artikel ini Anda akan bisa menggunakan akselerasi GPU untuk masalah regresi, klasifikasi, reduksi dimensi, atau klasterisasi Anda.
Mari sejenak menata semua kepingan informasinya.
NVIDIA mengembangkan teknologi mutakhir yang mendukung komputasi kinerja tinggi, AI, dan data science. Anda mungkin ingat mereka sering diberitakan saat Deepseek merilis Deepseek-R1 dan orang-orang bertanya apakah Deepseek menggunakan chip NVIDIA.
Kini, NVIDIA kembali menjadi perbincangan, kali ini berkat inovasi dalam ekosistem RAPIDS AI. RAPIDS AI, jika Anda belum kenal, adalah rangkaian open-source pustaka yang dipercepat GPU untuk mempercepat alur kerja data science dan machine learning. RAPIDS dibangun di atas CUDA (Compute Unified Device Architecture), yakni platform komputasi paralel dan model API yang juga dikembangkan NVIDIA. Pustaka RAPIDS yang dipercepat GPU mencakup:
Sekarang tentang cuML: cuML menyediakan implementasi sangat optimal untuk algoritma machine learning klasik. Karena NVIDIA memiliki chip AI terbaik, algoritma-algoritma ini, yang berjalan di GPU NVIDIA, mengalami percepatan signifikan. GPU, berbeda dengan CPU, unggul dalam pemrosesan paralel, yang secara praktis berarti dapat menangani ribuan komputasi sekaligus, sehingga ideal untuk tugas seperti deep learning dan machine learning.
Jika Anda belum familier dengan scikit-learn dan Anda serius menekuni machine learning dan data science, Anda sebaiknya mendaftar kursus Supervised Learning with scikit-learn kami. Saya mengatakan ini karena scikit-learn adalah pustaka nomor satu untuk data tabular di bahasa pemrograman nomor satu untuk machine learning. Selain itu, scikit-learn cukup mudah dipelajari dengan API yang sederhana dan bekerja baik dengan pandas dan NumPy. Tidak mengherankan jika tim RAPIDS AI berfokus pada algoritma scikit-learn sebagai pilihan strategis dan alami.
NVIDIA dan cuML kini menawarkan inovasi besar untuk scikit-learn, juga UMAP dan HDBSCAN, berupa lonjakan besar dalam kecepatan kinerja. Menurut tim RAPIDS AI, ini berarti hingga 50x lebih cepat saat menggunakan scikit-learn, 60x untuk UMAP, dan 175x untuk HDBSCAN.
Perhitungan kasar saya menunjukkan bahwa algoritma yang mungkin memakan waktu lima menit di scikit-learn secara teoritis bisa dipangkas menjadi hanya enam detik. Itu perbedaan besar. Saya akan membahas ini lebih lanjut saat melihat benchmark di bawah.
Jika semua ini terdengar rumit, jangan khawatir. RAPIDS AI berkomitmen agar tidak diperlukan perubahan kode API untuk scikit-learn. Sungguh, Anda hanya perlu memuat ekstensi, seperti ini:
%load_ext cuml.accel
$ python -m cuml.accel script.pyIni bukan perubahan besar pada alur kerja yang biasa Anda gunakan, dan memang itu tujuannya. Sesekali, mungkin Anda perlu me-restart kernel dan memuat ulang ekstensi.
Menurut saya, klaim tanpa perubahan kode ini pada pandangan pertama sangat menarik. Gagasannya adalah Anda tidak perlu mengubah skrip scikit-learn yang sudah ada—bukan hanya pertama kali, tetapi seterusnya. cuML akan secara otomatis mempercepat komponen yang kompatibel di GPU NVIDIA, tetapi jika ada bagian kode yang tidak kompatibel dengan GPU NVIDIA, skrip Anda akan kembali menjalankan eksekusi di CPU ‘normal’. Sebagai penulis kode, Anda hanya akan melihat hasilnya dan tidak perlu repot menangani error atau hal lain.
Meski demikian, saya tetap memperkirakan ada kasus tepi yang mungkin memerlukan penyesuaian. Dalam pemrograman, hal bisa saja meleset, dan jarang sekali segampang kelihatannya. Dokumentasi referensi mencantumkan hal-hal yang nyaris bertentangan dengan klaim ‘tanpa perubahan kode’, atau setidaknya menambah sedikit friksi. Anda harus mengonversi list menjadi array NumPy atau DataFrame Pandas, dan label string tidak didukung, jadi pengguna harus melakukan pra-enkode label kategorikal. Mungkin Anda memang sudah melakukan ini, tetapi intinya ada hal-hal lain yang perlu dibiasakan selain sekadar memuat ekstensi.
Jika Anda berlatih statistik dasar dengan menjalankan regresi linear sederhana pada dataset mtcars, tidak banyak gunanya menggunakan akselerasi GPU untuk menemukan kemiringan dan intersep garis sedikit lebih cepat. Menghemat sepersekian detik bahkan tidak sepadan dengan memuat ekstensi. Namun jika Anda menjalankan algoritma yang lebih kompleks, waktu yang dihemat sangat berarti karena dua alasan utama.
Pertama, waktu yang dihemat signifikan bagi banyak alur kerja. Saya menyebutkan bahwa peningkatan kecepatan hingga 50x secara hipotetis akan memangkas waktu pelatihan lima menit menjadi enam detik. Itu hampir lima menit penghematan. Namun perhatikan alur kerja seorang engineer machine learning, di mana model mungkin perlu dijalankan beberapa kali untuk mencapai hasil yang baik. Jika diakumulasikan, menghemat waktu di setiap run berarti berbicara tentang produktivitas keseluruhan seorang data scientist.
Kedua, dan terkait, ilmuwan atau engineer kini bisa mulai mencoba model yang lebih kompleks. Pada contoh sebelumnya, kita mengasumsikan kecepatan untuk model dengan tingkat akurasi yang sama. Namun bagaimana jika Anda berpikir akurasinya justru lebih tinggi dengan model yang lebih kompleks? Bayangkan melakukan grid search pada berbagai parameter model dan melatih model. (Saya akan mencoba contoh kecil saya sendiri di bawah.) Jumlah kombinasi bertambah secara eksponensial, membuat biaya komputasi di CPU menjadi tidak praktis. Namun itu bukan masalah besar jika Anda memiliki peningkatan kecepatan 50x.
Manfaat ini saling melengkapi. Jika Anda menyiapkan proyek dengan tepat, Anda bisa mendapatkan model yang lebih akurat dan juga diproduksi lebih cepat, atau—dalam sudut pandang engineer machine learning—Anda bisa memiliki arsitektur model yang lebih canggih tanpa waktu pelatihan berlebihan.
NVIDIA menekankan bahwa GPU akan menghasilkan hasil yang ekuivalen secara numerik. Kabar baik, karena berarti manfaatnya tidak diiringi penurunan akurasi model.
Namun ini juga membuat saya bertanya: Mengapa hasilnya ekuivalen secara numerik dan bukan sama persis? Mungkin, sebagai akibat pemrosesan paralel, ada perbedaan kecil di output, atau terdapat perbedaan stabilitas numerik suatu metode. Mungkin pada kasus UMAP, proyeksi UMAP sedikit berbeda. Saya mengangkat ini jika Anda melihat perbedaan halus pada output antara run CPU dan GPU. NVIDIA tampaknya menyarankan agar Anda mengharapkan sebagian dari itu, dan itu normal.
Dengan catatan, jika Anda benar-benar menantang diri dan menjalankan model di GPU karena modelnya cukup kompleks sehingga CPU secara praktis tidak memadai, maka membandingkan output model tersebut dengan padanannya di CPU akan menjadi sulit.
Saya menyebutkan sebelumnya bahwa kini ada dukungan pada rilis cuML 25.02 untuk scikit-learn, UMAP, dan HDBSCAN. Namun jika Anda familier dengan scikit-learn, Anda tahu ada banyak algoritma berbeda di dalamnya. Saat ini, RAPIDS AI mendukung sebagian pustaka, namun belum semuanya. Berikut yang utama menurut tim:
Dari daftar ini, saya paling antusias dengan peningkatan kecepatan pada k-Nearest Neighbors, yang terkenal sangat intensif komputasi karena harus menghitung jarak antar semua titik data.
Tabel berikut menunjukkan estimator yang sebagian besar atau seluruhnya dijalankan dengan cuML.
| Algoritma | Pustaka / Nama Fungsi | Kategori |
|---|---|---|
| UMAP | umap.UMAP |
Reduksi Dimensi |
| PCA (Principal Component Analysis) | sklearn.decomposition.PCA |
Reduksi Dimensi |
| Truncated SVD | sklearn.decomposition.TruncatedSVD |
Reduksi Dimensi |
| t-SNE | sklearn.manifold.TSNE |
Reduksi Dimensi |
| HDBSCAN | hdbscan.HDBSCAN |
Klasterisasi |
| K-Means | sklearn.cluster.KMeans |
Klasterisasi |
| DBSCAN | sklearn.cluster.DBSCAN |
Klasterisasi |
| Random Forest Classifier | sklearn.ensemble.RandomForestClassifier |
Klasifikasi |
| Regresi Logistik | sklearn.linear_model.LogisticRegression |
Klasifikasi |
| K-Nearest Neighbors Classifier | sklearn.neighbors.KNeighborsClassifier |
Klasifikasi |
| Random Forest Regressor | sklearn.ensemble.RandomForestRegressor |
Regresi |
| Regresi Linear | sklearn.linear_model.LinearRegression |
Regresi |
| Elastic Net | sklearn.linear_model.ElasticNet |
Regresi |
| Regresi Ridge | sklearn.linear_model.Ridge |
Regresi |
| Regresi Lasso | sklearn.linear_model.Lasso |
Regresi |
| Regresi Kernel Ridge | sklearn.kernel_ridge.KernelRidge |
Regresi |
| K-Nearest Neighbors Regressor | sklearn.neighbors.KNeighborsRegressor |
Regresi |
| Pencarian Tetangga Terdekat | sklearn.neighbors.NearestNeighbors |
Pencarian Tetangga Terdekat |
Daftar lengkap metode yang didukung tersedia di dokumentasi RAPIDS AI. Kami memperkirakan lebih banyak algoritma akan segera ditambahkan. (Anda juga bisa memberi masukan untuk membantu tim menyusun prioritas.) Beberapa yang saya perhatikan belum ada: support vector regressor (sklearn.svm.SVR), Theil-Sen Regressor (sklearn.linear_model.TheilSenRegressor), mean shift clustering (sklearn.cluster.MeanShift), dan multidimensional scaling (sklearn.manifold.MDS).
Anda mungkin bertanya-tanya bagaimana semua ini bekerja. Secara garis besar, semakin banyak pustaka modern dirancang untuk otomatis mendeteksi dan menggunakan perangkat keras terbaik yang tersedia, apakah itu CPU atau GPU. Kini, saat suatu fungsi dipanggil di scikit-learn (ketika cuml.accel diaktifkan), perangkat lunak memeriksa apakah GPU yang kompatibel tersedia dan mengalihkan eksekusi ke versi yang dipercepat GPU jika ada.
RAPIDS AI membahas mekanisme agar cuml.accel bertindak seperti sklearn sebagai lapisan kompatibilitas. Dalam hal ini, lapisan kompatibilitas cuML memungkinkan kode scikit-learn berjalan di GPU NVIDIA tanpa perubahan. Ini dibangun sebagai pengganti drop-in, bertindak sebagai proksi yang mencegat pemanggilan fungsi ke scikit-learn dan mengarahkannya ke cuML.
Tim RAPIDS AI NVIDIA membagikan grafik yang membantu, yang juga saya sertakan di sini:
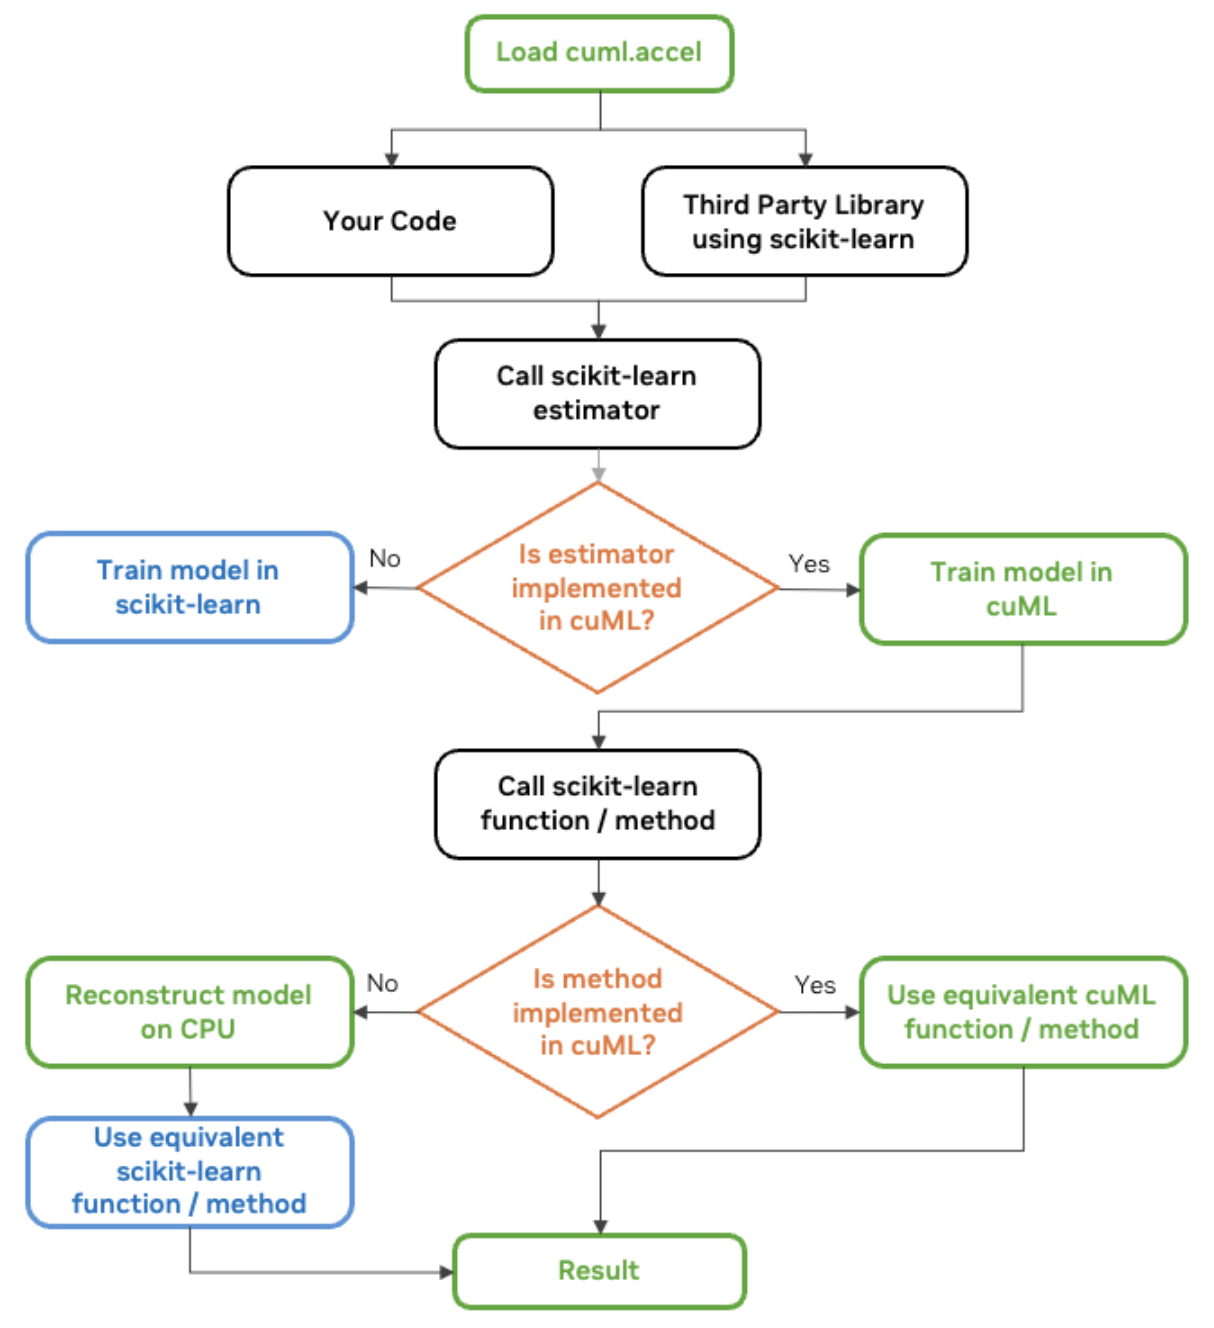
Diagram alur kerja cuML scikit-learn. Sumber: NVIDIA
cuML sudah terpasang di Google Colab, tetapi jika Anda menggunakan Jupyter notebook, aktifkan dengan perintah ini sebelum mengimpor scikit-learn:
%load_ext cuml.accel
import sklearn
Sekarang, kode Python kita yang menggunakan sklearn akan terlihat familier, dan memang itu tujuannya. Berikut contoh regresi OLS.
# Import necessary libraries
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

# Generate synthetic regression data
X, y = make_regression(n_samples=500000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Create and train an OLS regression model
ols = LinearRegression()
ols.fit(X_train, y_train)
Jika saya ingin melihat bagian mana yang berjalan di GPU alih-alih CPU, saya bisa menggunakan logger.
%load_ext cuml.accel

from cuml.common import logger;
logger.set_level(logger.level_enum.debug)
cuML: Installed accelerator for sklearn.
cuML: Successfully initialized accelerator.
cuML: Performing fit in GPUGambaran umumnya seperti itu. Sekarang, mari coba contoh yang lebih meyakinkan. Bagaimanapun, regresi linear tidak terlalu dapat diparalelkan karena penyelesaian persamaan normal atau dekomposisi QR melibatkan beberapa operasi berurutan.
Perluasan yang lebih kompleks dari regresi OLS adalah regresi ridge. Saat menggunakan regresi ridge di Python, pemanggilan Ridge() menerapkan hiperparameter default, yang mungkin tidak optimal. Nilai alpha mengendalikan seberapa besar regularisasi diterapkan. Terlalu kecil, model overfit; terlalu besar, model underfit.
%load_ext cuml.accel
import sklearn

from sklearn.linear_model import Ridge
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# Generate synthetic data
X, y = make_regression(n_samples=100000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Train a Ridge Regression model with default settings
ridge_default = Ridge()
ridge_default.fit(X_train, y_train)

# Make predictions and evaluate
y_pred_default = ridge_default.predict(X_test)
mse_default = mean_squared_error(y_test, y_pred_default)
Kode di atas melatih satu model, menggunakan satu nilai alpha dan solver. (Saya yakin default-nya 'auto'.) Jadi, meski berfungsi, ini tidak mengoptimalkan kekuatan regularisasi atau pilihan solver.
Alih-alih mengandalkan default, kita bisa mencoba cara lain. Kita bisa membuat grid search yang menguji beberapa kombinasi hiperparameter dan memilih yang terbaik.
from sklearn.model_selection import GridSearchCV

# Define Ridge Regression model
ridge = Ridge()

# Define a grid of hyperparameters to search
param_grid = {
    'alpha': [0.01, 0.1, 1.0, 10.0, 100.0],  # Different regularization strengths
    'solver': ['auto', 'svd', 'cholesky', 'lsqr', 'saga']  # Test multiple solvers
}

# Perform Grid Search with cross-validation
grid_search = GridSearchCV(ridge, param_grid, scoring='neg_mean_squared_error', cv=2, n_jobs=-1)
grid_search.fit(X_train, y_train)

# Get the best model from the search
best_ridge = grid_search.best_estimator_

# Make predictions and evaluate
y_pred_best = best_ridge.predict(X_test)
mse_best = mean_squared_error(y_test, y_pred_best)
Grid search di atas menguji semua kombinasi hiperparameter. Jika kita mendefinisikan 5 nilai untuk alpha ([0.01, 0.1, 1.0, 10.0, 100.0]), 5 opsi solver (['auto', 'svd', 'cholesky', 'lsqr', 'saga']), dan menggunakan validasi silang 2-fold, total pelatihan model yang dibutuhkan adalah 5x5x2, atau 50. Artinya alih-alih melatih satu model, kita melatih 50 model. Ini jauh lebih kompleks, sehingga GPU akan sangat berguna karena jauh lebih cepat. Karena sklearn memiliki peningkatan kecepatan (hingga) 50x, melatih 50 model ini mungkin memakan waktu sama dengan melatih satu model saja. (Saya sengaja memilih angka-angka ini untuk mengilustrasikan poin tersebut. Saya paham tidak semua model akan mengalami peningkatan kecepatan yang sama.)
NVIDIA membandingkan kinerja algoritma scikit-learn yang berjalan di CPU Intel versus GPU NVIDIA miliknya. Mereka melihat berbagai beban kerja machine learning, termasuk klasifikasi dan regresi.
Intinya, model sederhana seperti random forest turun dari menit menjadi detik waktu pelatihannya di GPU, dan model yang lebih kompleks seperti klasterisasi turun dari jam menjadi menit. Alur kerja lebih cepat di setiap kasus, tetapi untuk model yang berat komputasi dengan data berdimensi tinggi, manfaatnya makin jelas. Ini adalah area di mana GPU unggul karena menggunakan pemrosesan paralel dan itu diketahui memberikan dampak besar pada model yang memerlukan operasi matriks ekstensif, perhitungan jarak, atau optimisasi yang dilakukan secara iteratif.
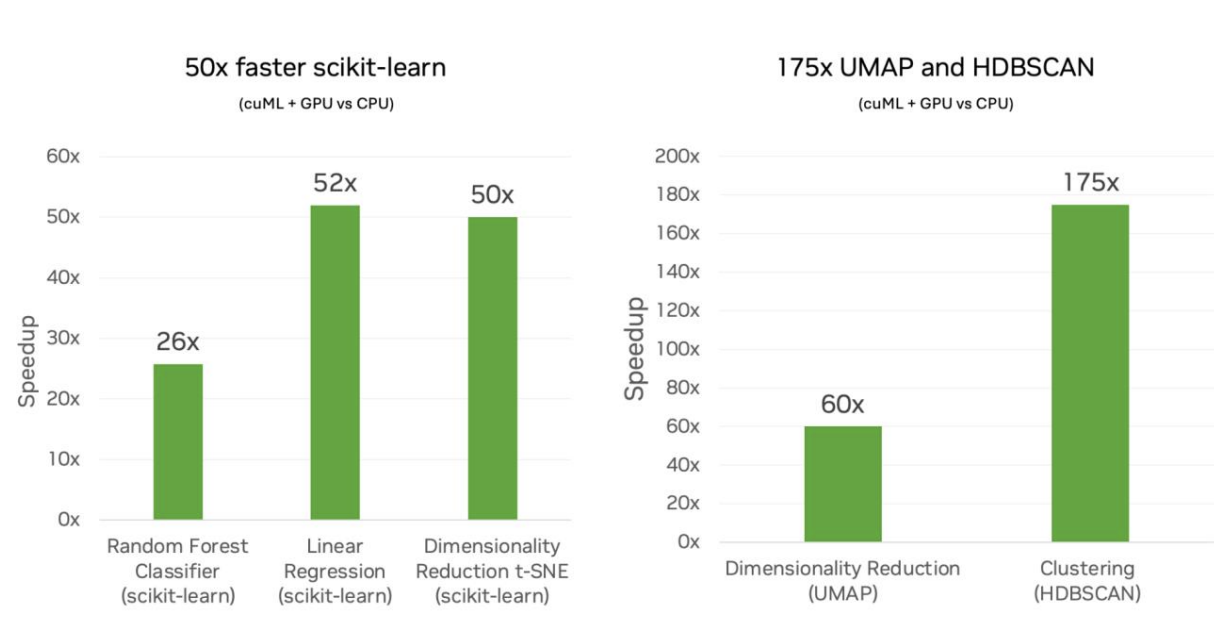
cuML scikit-learn di GPU vs scikit-learn di CPU. Sumber: NVIDIA
Saya sempat menghindari regresi linear pada contoh kode sebelumnya karena merasa perlu menunjukkan kekuatan pada hal lain. Namun di sini, saya melihat percepatan 52x untuk regresi linear. Saya akui terkejut karena itu terdengar sebagai kelipatan besar. Ini pengingat yang baik bahwa NVIDIA juga melakukan hal-hal canggih lain, seperti memastikan langkah-langkah berbeda bisa diseling (interleaved) agar GPU tidak menganggur.
Berkat cuML versi 25.02, menjalankan algoritma scikit-learn dengan GPU kini tidak terlalu sulit. Anda hanya perlu memuat ekstensi, seperti yang saya tunjukkan sebelumnya. Namun, jika Anda berada lebih dalam di alur kerja dan ingin memaksimalkan akselerasi GPU, ada hal-hal spesifik yang perlu dipertimbangkan.
NVIDIA merekomendasikan meminimalkan transfer data antara CPU dan GPU sebagai bagian dari pipeline Anda. Dengan kata lain, lakukan langkah prapemrosesan, pelatihan, dan inferensi di GPU sebelum mengirim hasil kembali ke memori host. Jangan mencampuradukkan langkah dengan melakukan prapemrosesan di CPU lalu inferensi di GPU.
Selain itu, untuk memaksimalkan efisiensi, Anda perlu mempertimbangkan CUDA-X, yaitu kumpulan pustaka yang dipercepat GPU yang dikembangkan NVIDIA. Untuk random forest, misalnya, Anda bisa menggunakan forest inference library dari cuML alih-alih milik scikit-learn.
Upaya tim RAPIDS AI sangat kompleks, sehingga akan ada sejumlah isu. Untungnya, dokumentasi keterbatasan yang diketahui dikelola dengan baik. Saya tidak ingin menyertakan semua atau sebagian keterbatasan di sini karena banyak isunya sangat teknis dan spesifik per algoritma. Selain itu, pembaruan atau patch berjalan cepat. Sebagai gantinya, saya berikan kategori umum hal-hal yang perlu dipertimbangkan.
Ada beberapa pembatasan yang berlaku di seluruh cuML, bukan hanya untuk algoritma tertentu. Contohnya termasuk pembatasan pada format input data (beberapa masalah dengan list Python), kompatibilitas versi, dan penanganan memori.
Ada perbedaan khusus untuk masing-masing algoritma machine learning. Perbedaan ini dapat memengaruhi cara model dilatih, perilaku parameter, atau cara hasil dihitung. Sebagai contoh, algoritma random forest di cuML menggunakan metode berbeda untuk memilih ambang pemisah, sehingga menghasilkan struktur pohon yang sedikit berbeda.
Ada perbedaan pada parameter, solver, dan metode inisialisasi yang didukung. Misalnya, PCA mendukung solver SVD "full" dan "auto", tetapi tidak "randomized." Dan KNN mendukung metrik Minkowski, namun tidak Mahalanobis.
Ada kalanya hasil mungkin sedikit berbeda karena paralelisme atau perbedaan solver. Ini sudah saya singgung sebelumnya. Misalnya, embedding UMAP mungkin tidak identik, tetapi skor trustworthiness tetap tinggi. Pada kasus lain, tanda komponen PCA bisa terbalik, sehingga memerlukan normalisasi. Sekali lagi, ini spesifik, dan Anda sebaiknya merujuk dokumentasi terbaru saat menjalankan algoritma tertentu.
Saya antusias dengan prospek akselerasi GPU yang sangat mudah digunakan untuk algoritma-algoritma ternama di pustaka machine learning Python paling umum. Ini akan memberi perbedaan besar pada akurasi model, serta praktis dan tidak sulit diterapkan.
Tetap ikuti perkembangan terbaru di bidang machine learning. Ikuti jalur karier Machine Learning Scientist in Python kami untuk membiasakan diri dengan teknik-teknik yang tepat. Lakukan ini agar Anda dapat memanfaatkan kemajuan terbaru sebaik mungkin. Juga, berlangganan podcast DataFramed kami. Kami bahkan memiliki episode bersama Jean-Francois Puget, Distinguished Engineer di NVIDIA & Chris Deotte, Senior Data Scientist di NVIDIA, yang membahas, antara lain, dampak akselerasi GPU.
Pelajari Python dan scikit-Learn dengan DataCamp
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



