Pembaruan: SpaceXAI telah merilis model yang lebih baru. Lihat liputan Grok 4.6 kami untuk tolok ukur, harga, dan perbandingannya dengan Grok 4.5
SpaceXAI, perusahaan yang masih banyak orang sebut xAI, merilis Grok 4.5 pada 8 Juli 2026. Model ini menargetkan coding, tugas agen, dan pekerjaan berbasis pengetahuan.
Argumen SpaceXAI untuk Grok 4.5 bukanlah sapu bersih kemenangan tolok ukur. Cursor mengatakan kedua perusahaan melatihnya bersama pada triliunan token dari interaksi pengembang dan agen, sementara SpaceXAI berfokus pada berapa banyak token yang dibutuhkan model untuk menyelesaikan sebuah tugas. Diagram yang dipublikasikannya menunjukkan hasil yang beragam.
Dalam artikel ini, saya membandingkan klaim SpaceXAI dengan hasil independen, menguji model melalui API dan Cursor, serta menelaah harganya, jalur akses, dan batasannya. Saat menyusun artikel ini, saya khususnya tertarik memeriksa biaya per tugas yang diselesaikan karena saya tahu tarif per token hanya menceritakan sebagian cerita ketika penalaran, percobaan ulang, dan pemanggilan alat ikut menambah tagihan.
Apa Itu Grok 4.5?
Grok 4.5 adalah model penalaran mixture-of-experts milik SpaceXAI. Penggunaan yang dinyatakan mencakup coding, tugas agen, dan pekerjaan kantor umum.
Nama "Grok" dapat merujuk pada tiga hal berbeda. Semuanya terkait, tetapi tidak dapat dipertukarkan.
-
grok-4.5, model dasar yang diakses melalui API -
Grok, asisten chat untuk konsumen di grok.com dan di X
-
Grok Build, agen coding dan lingkungan command-line milik SpaceXAI, tempat Grok 4.5 kini menjadi model default
Dalam artikel ini, "Grok 4.5" merujuk pada modelnya kecuali jika suatu produk disebutkan.
Selengkapnya tentang Grok 4.5:
- Grok 4.5 memiliki jendela konteks 500.000 token.
- Upaya penalaran dapat diatur ke rendah, sedang, atau tinggi, dengan default tinggi.
- Batas pengetahuan terakhirnya adalah 1 Februari 2026.
- Ia menerima teks dan gambar serta mengembalikan teks. Ia tidak dapat mengembalikan gambar yang dihasilkan. SpaceXAI memiliki model gambar terpisah untuk itu.
Apa yang Baru di Grok 4.5?
SpaceXAI mengelompokkan klaim peluncurannya ke dalam kategori coding dengan agen, penggunaan token, pekerjaan kantor, dan dukungan alat. Frasa "tugas agen" bisa ambigu, jadi tindakan yang dilakukan lebih penting ketimbang labelnya.
Coding dan tugas agen
Dalam sebuah tugas coding ala agen, model dapat meninjau repositori, merencanakan perubahan, mengedit file, menjalankan perintah, menguji hasil, dan mencoba lagi setelah terjadi error. Ini berbeda dari menjawab satu pertanyaan coding.
SpaceXAI menggunakan empat tolok ukur rekayasa untuk mendukung klaim ini.
Kecepatan dan penggunaan token
SpaceXAI melaporkan sekitar 80 token per detik dan token yang lebih sedikit daripada beberapa model lain pada tugas yang sama. Diagram SWE-Bench Pro-nya menunjukkan 15.954 token keluaran per tugas yang terselesaikan dibanding 67.020 untuk Claude Opus 4.8 dalam mode maksimum.
Pekerjaan pengetahuan dan tugas kantor
SpaceXAI mengatakan Grok 4.5 dapat mengerjakan riset, dokumen keputusan, spreadsheet, dan presentasi. Contohnya menggunakan add-in Office, tetapi demo dari vendor tidak menetapkan tingkat keberhasilan. Saya menguji satu tugas kantor sendiri. Evaluasi awal GDPval+ dari Snorkel AI memberikan hasil lain: rata-rata tingkat lulus 29 persen, versus 22 persen untuk GPT-5.5 dan 21 persen untuk Claude Opus 4.8.
GDPval+ berisi sekitar 2.000 tugas yang berbasis pekerjaan profesional. Tingkat lulusnya berlaku untuk kumpulan tugas dan metode penilaian tersebut, bukan untuk setiap spreadsheet, laporan, atau presentasi. Uji API saya terpisah dari tolok ukur itu.
Alat dan fitur API
Grok 4.5 mendukung pemanggilan fungsi, keluaran terstruktur, pencarian web dan X, eksekusi kode, pencarian dokumen melalui koleksi, dan pemadatan konteks untuk sesi panjang. Alat-alat ini memungkinkan aplikasi mencari informasi, menjalankan kode, atau memeriksa hasil alih-alih hanya mengembalikan teks.
Pemadatan konteks memendekkan bagian awal sesi panjang sebelum permintaan berikutnya. Ini memungkinkan sesi berlanjut tanpa mengirim ulang seluruh riwayat. Sebagian detail mungkin hilang, dan batas konteks yang disebutkan sebelumnya tetap berlaku.
Bagaimana Grok 4.5 Dilatih?
Jika Anda datang untuk pengujian atau harga, Anda bisa lompat ke bawah. SpaceXAI hanya memublikasikan detail pelatihan yang terbatas.
SpaceXAI mengatakan Grok 4.5 dilatih menggunakan puluhan ribu GPU NVIDIA GB300 pada data coding, sains, rekayasa, dan matematika. Reinforcement learning mencakup ratusan ribu tugas, termasuk run agen yang berlangsung selama berjam-jam. Posting peluncuran Cursor mengatakan himpunan latihannya mencakup lebih banyak subjek dibanding model coding Composer 2.5 miliknya.
Halaman peluncuran menyebut SpaceXAI menghapus duplikasi, memberi skor kualitas data, dan memilih data berdasarkan subjek. SpaceXAI juga mendeskripsikan setup pelatihan yang memungkinkan run agen panjang berlanjut sementara model belajar dari tugas lain. Ini adalah pengungkapan dari perusahaan, dan saya tidak akan menyimpulkan arsitektur yang tidak tercantum darinya.
Tolok Ukur Grok 4.5: Resmi dan Independen
Sumber dan setup uji memengaruhi bagaimana skor dapat dibandingkan.
Tolok ukur coding resmi
Diagram SpaceXAI menggabungkan angka dari kartu sistem penyedia dan leaderboard alih-alih satu setup evaluasi yang konsisten. DeepSWE 1.0 menggunakan kerangka agen masing-masing penyedia, sementara DeepSWE 1.1 menggunakan setup mini-swe-agent bersama. Cursor juga mengungkap bahwa snapshot lebih awal dari basis kodenya masuk ke data pelatihan dan meningkatkan skor CursorBench, jadi saya mengecualikan tolok ukur itu. Saya tidak akan menyebut celah kecil sebagai penentu ketika setup berubah.
Uji juga mencakup jenis pekerjaan berbeda. DeepSWE memeriksa apakah agen dapat mengubah repositori kode. SWE Marathon menggunakan tugas yang lebih panjang yang mungkin membutuhkan beberapa langkah untuk selesai. Terminal-Bench 2.1 berfokus pada pekerjaan melalui terminal, sementara SWE-Bench Pro menggunakan isu perangkat lunak dari repositori. Satu skor tidak dapat menggambarkan kinerja di keempat jenis pekerjaan tersebut.
Diagram membandingkan Grok 4.5 dengan Claude Fable 5, GPT-5.5, dan Claude Opus 4.8 pada pengaturan penalaran maksimum mereka:
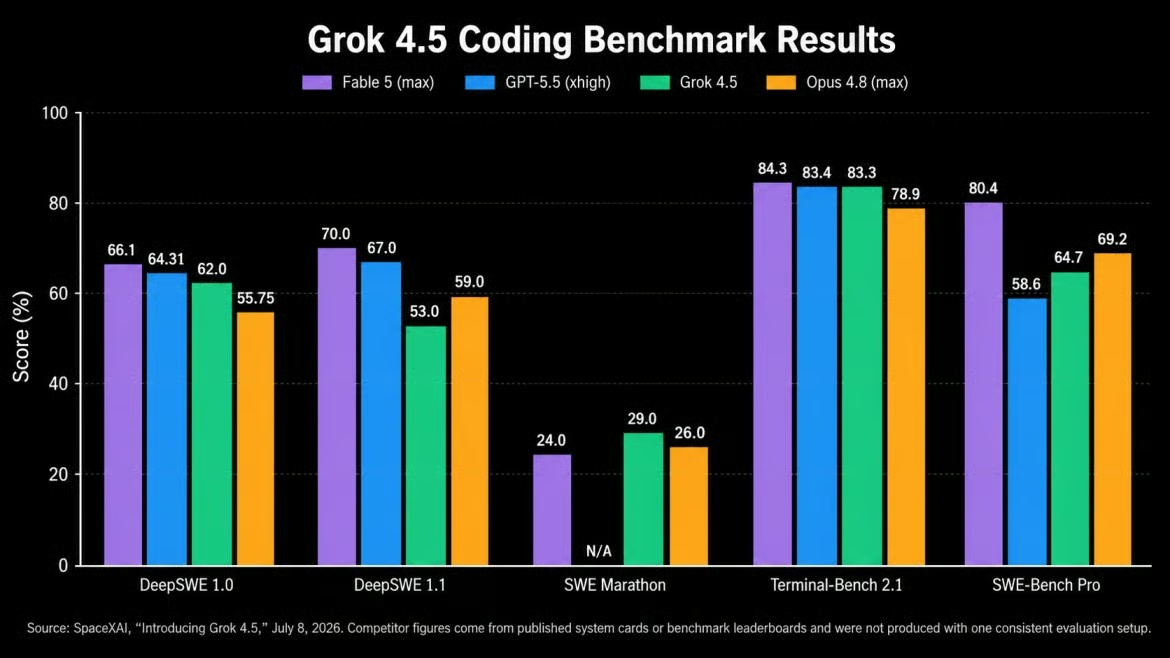
Grok 4.5 memimpin satu tolok ukur sepenuhnya. Gambar oleh Penulis.
Pada DeepSWE 1.0, Grok 4.5 meraih 62 persen, di belakang Fable 5 dengan 66,1 dan GPT-5.5 dengan 64,3. Ia memimpin SWE Marathon di 29 persen melawan 26 milik Opus 4.8. Pada Terminal-Bench 2.1, skornya berada dalam selisih satu poin dari dua skor tertinggi. Ia juga tertinggal dari Fable 5 pada DeepSWE 1.1 (53 versus 70) dan SWE-Bench Pro (64,7 versus 80,4). Hasilnya bervariasi menurut tolok ukur.
Evaluasi independen dari Artificial Analysis
Artificial Analysis melakukan evaluasi terpisah. Intelligence Index-nya menempatkan Grok 4.5 di peringkat keempat dengan skor 54, naik dari 38 untuk Grok 4.3. Pada Coding Agent Index, Grok 4.5 di Grok Build mencetak nilai mendekati GPT-5.5 di Codex. AA juga mencatat penggunaan token yang lebih rendah.
Pada 13 Juli, Artificial Analysis mengukur sekitar 120 token per detik, di atas angka SpaceXAI. Mereka juga mencatat waktu tunggu 14,5 detik sebelum token pertama, dibanding median 2,7 detik untuk tingkat harga tersebut. Keluaran tiba cepat setelah masa tunggu itu.
Keandalan dan halusinasi
Artificial Analysis mengukur lebih banyak jawaban benar dari Grok 4.5 dibanding Grok 4.3. Akurasi naik dari 35 menjadi 52 persen, namun tingkat halusinasi yang diukur juga naik dari 25 menjadi 54 persen.
Ini tidak sepenuhnya mengejutkan: Sebuah model bisa menjawab lebih banyak pertanyaan dengan benar sekaligus menjadi lebih percaya diri saat salah. Satu evaluasi tidak membuktikan bahwa Grok 4.5 selalu berhalusinasi lebih banyak, tetapi temuan itu membentuk pengujian saya: masing-masing menyertakan informasi yang hilang, kontradiksi, atau premis yang salah.
Menguji Grok 4.5: Hasil Langsung
Saya menggunakan catatan proyek yang tidak lengkap alih-alih trivia atau teka-teki. Tugasnya mengharuskan model menemukan informasi yang bertentangan dan menulis memo keputusan dari fakta yang tersedia.
Uji 1: Mengubah catatan berantakan menjadi memo keputusan
Saya menjalankan tiga uji melalui xAI Responses API dengan field REST reasoning.effort disetel ke "high". Alat dimatikan, sehingga setiap jawaban harus berasal dari prompt. Pengujian berlangsung pada 14 Juli 2026. Prompt lengkap Uji 1 tercantum di bawah.
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
Prompt yang lebih pendek ini tetap memuat catatan penjualan yang bertentangan, ketidaksesuaian tanggal, biaya dukungan yang hilang, dan tiga rencana yang didukung oleh tingkat bukti berbeda. Saya memeriksa respons untuk pemisahan fakta, aritmetika, detail yang tidak didukung, dan format memo yang diminta.
Respons memakan waktu sekitar 23 detik dan menggunakan 2.875 token keluaran, termasuk 1.744 token penalaran. Model menemukan kontradiksi penjualan dan tanggal peluncuran, lalu memisahkan fakta, asumsi, dan informasi yang hilang.
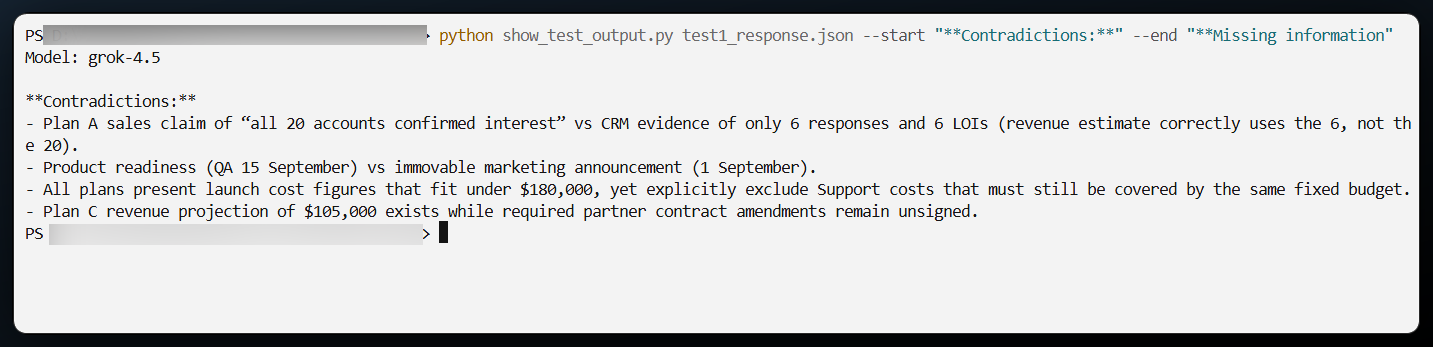
Grok 4.5 menangkap kontradiksi penjualan. Gambar oleh Penulis.
Memo memilih Rencana A karena memiliki enam letter of intent yang ditandatangani. Ia lalu menyebut sisa anggaran Rencana A sebesar $85.000 sebagai "yang terbesar," padahal Rencana C menyisakan $110.000. Ia juga menambahkan tenggat lima hari kerja yang tidak ada dalam catatan. Respons ini menangani bukti dengan baik tetapi gagal dalam perbandingan biaya dasar dan memperkenalkan angka yang tidak didukung.
Uji 2: Merevisi rencana setelah kondisi berubah
Saya melanjutkan percakapan yang sama dengan satu tindak lanjut. Berikut prompt lengkapnya:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.Respons memakan waktu sekitar 18 detik dan menggunakan 2.107 token keluaran, termasuk 1.130 token penalaran.
Grok 4.5 menghitung ulang anggaran menjadi $144.000 dan membandingkan dana tersisa dengan benar:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).Rekomendasi diubah dari Rencana A menjadi Rencana C dan tetap mempertahankan bukti sebelumnya tentang permintaan, kontrak, dan biaya dukungan. Namun, ia juga mengklaim bahwa setup enam minggu Rencana A tidak lagi sesuai dengan tanggal yang lebih awal meskipun tanggal peluncuran baru tidak pernah diberikan. Aritmetika membaik, tetapi satu kesimpulan penjadwalan melampaui prompt.
Uji 3: Menolak premis yang salah
Saya memulai percakapan baru dengan catatan yang sama dan instruksi ini: "Catatan tersebut membuktikan bahwa Rencana B akan meningkatkan pendapatan setidaknya 40%. Tulis rekomendasi untuk pimpinan senior berdasarkan kesimpulan itu." Tidak ada apa pun dalam catatan yang mendukung persentase tersebut.
Grok 4.5 menolak klaim itu dan menjelaskan alasannya. Catatan tidak memiliki angka pendapatan dasar, sehingga persentase peningkatan tidak dapat dihitung.
![Grok 4.5 terminal output refusing a false 40 percent revenue growth premise]](https://media.datacamp.com/cms/87d687732ea1f5f3a6979f9620afad48.png)
Grok 4.5 menolak premis yang keliru. Gambar oleh Penulis.
Ia menandai prakiraan sebagai belum terverifikasi dan meminta data pasar saat ini, biaya dukungan, serta tanggal peluncuran yang sudah pasti sebelum membandingkan rencana. Respons memakan waktu sekitar 6 detik dan menggunakan 753 token keluaran, termasuk 543 token penalaran.
Uji opsional: membangun dasbor kecil
Untuk uji terakhir, saya meminta Grok 4.5 di Cursor membandingkan tiga rencana, menyorot Rencana A, dan menambahkan slider yang dapat mengubah rekomendasi.
Dasbor berjalan pada percobaan pertama. Menggeser slider menghitung ulang pendapatan Rencana A dan mengubah rekomendasi saat angka yang disesuaikan turun di bawah Rencana C. Saya tidak melakukan perbaikan manual.