Kursus
Manajemen data telah menghadirkan solusi baru untuk mengatasi keterbatasan arsitektur tradisional seperti data lake dan data warehouse. Meskipun keduanya berperan penting dalam penyimpanan dan analitik data, arsitektur tersebut dapat menimbulkan tantangan dalam memenuhi kebutuhan pemrosesan data modern.
Walau dapat diskalakan dan fleksibel, data lake sering menghadapi masalah tata kelola dan kinerja. Di sisi lain, data warehouse, meskipun kuat untuk analitik, biayanya tinggi dan kurang fleksibel. Data lakehouse bertujuan menyelesaikan masalah ini dengan menggabungkan keunggulan data lake dan data warehouse sekaligus meminimalkan kelemahannya.
Dalam panduan ini, saya akan menjelaskan apa itu data lakehouse, bagaimana bedanya dengan arsitektur data tradisional, dan mengapa ia semakin populer di kalangan profesional data yang mencari solusi manajemen data terpadu.
Apa itu Data Lakehouse?
Data lakehouse adalah arsitektur yang menggabungkan skalabilitas dan penyimpanan berbiaya rendah dari data lake dengan kinerja, keandalan, dan kemampuan tata kelola dari data warehouse.
Dengan mengintegrasikan kekuatan keduanya, data lakehouse menawarkan platform terpadu untuk menyimpan, memproses, dan menganalisis semua jenis data—terstruktur, semi-terstruktur, dan tidak terstruktur.
Pendekatan terpadu ini memungkinkan fleksibilitas lebih besar dalam pemrosesan data dan mendukung beragam use case analitik, mulai dari business intelligence hingga machine learning.
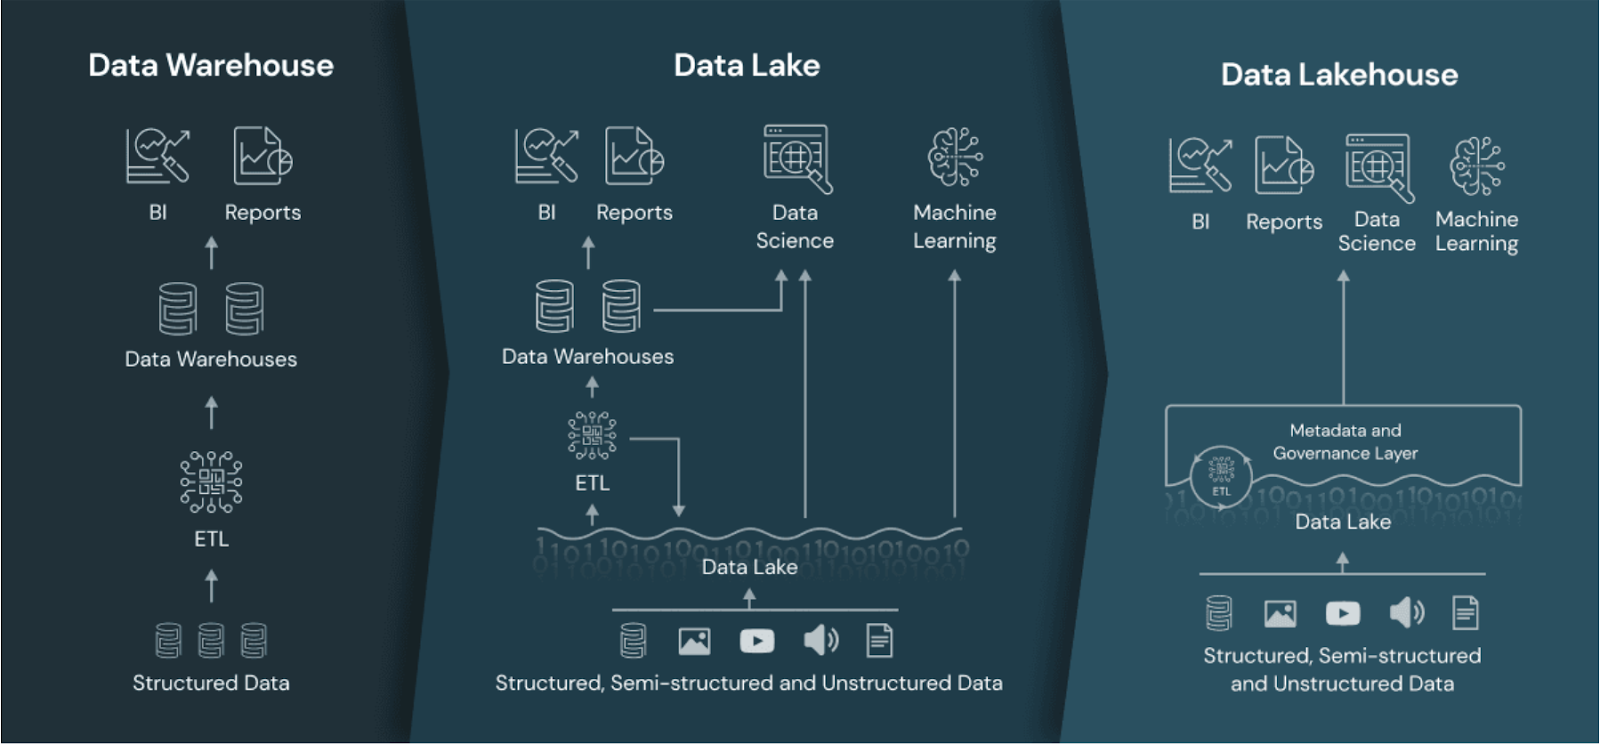
Perbandingan data lakehouse dengan data warehouse dan data lake. Sumber gambar: Databricks.
Data Lakehouse vs. Data Lake vs. Data Warehouse
Sebelum membahas lebih detail arsitektur data lakehouse, penting untuk memahami bagaimana perbandingannya dengan data warehouse dan data lake.
Data warehouse
Data warehouse dibangun untuk menyimpan data terstruktur dan menyediakan analitik serta pelaporan berkinerja tinggi.
Salah satu kekuatan terbesarnya adalah kemampuan mengeksekusi kueri cepat, sehingga sangat cocok untuk use case business intelligence dan pelaporan.
Data warehouse menggunakan skema yang terdefinisi dengan baik yang mendukung tata kelola data yang kuat. Ini memastikan data akurat, konsisten, dan mudah diakses untuk analisis.
Namun, keunggulan ini datang dengan biaya. Data warehouse umumnya mahal untuk dipelihara karena bergantung pada perangkat keras khusus dan proses transformasi data yang ekstensif, biasanya memerlukan pipeline ETL (extract, transform, load).
Struktur data warehouse yang kaku juga membuatnya kurang cocok untuk menangani data tidak terstruktur atau cepat beradaptasi dengan perubahan format data. Kurangnya fleksibilitas ini dapat menjadi keterbatasan signifikan bagi organisasi yang ingin bekerja dengan sumber data yang cepat berkembang atau data yang tidak mengikuti skema pradefinisi, seperti teks, gambar, audio, dan sebagainya.
Untuk mempelajari lebih lanjut dasar-dasar data warehousing, lihat kursus gratis Introduction to Data Warehousing.
Data lake
Data lake dirancang untuk menyimpan sejumlah besar data semi-terstruktur atau tidak terstruktur. Keunggulan utamanya terletak pada kemampuan skalanya, menjadikannya pilihan menarik bagi tim yang menangani beragam tipe data dan volume data yang masif.
Fleksibilitas data lake memungkinkan Anda menyimpan data mentah dalam format aslinya, sehingga ideal untuk eksplorasi data dan proyek sains data.
Namun, data lake sering kesulitan dalam tata kelola dan kualitas data. Karena data disimpan dalam bentuk mentah tanpa banyak struktur, menjaga konsistensi kualitas data bisa menjadi tantangan.
Kurangnya tata kelola dapat menyebabkan apa yang dikenal sebagai "rawa data" (data swamp), di mana wawasan berharga terkubur di bawah data yang buruk penataannya.
Kinerja juga menjadi perhatian penting di data lake, terutama untuk mengeksekusi kueri analitik yang kompleks. Data lake tidak dioptimalkan untuk kueri cepat atau untuk menggabungkan berbagai tipe data, seperti gambar, teks, dan audio.
Data lakehouse
Data lakehouse bertujuan untuk menggabungkan yang terbaik dari data lake dan data warehouse. Ini menawarkan solusi yang lebih seimbang dengan mengintegrasikan kemampuan skalabilitas dan penyimpanan berbiaya rendah dari data lake dengan kekuatan kinerja dan tata kelola dari data warehouse.
Secara teori, dalam lakehouse, Anda dapat menyimpan data terstruktur dan tidak terstruktur dengan biaya lebih rendah sambil memanfaatkan kemampuan yang dibutuhkan untuk analitik berkinerja tinggi.
Data lakehouse menyediakan dukungan untuk transaksi ACID, yang berarti pembaruan dan penghapusan data dapat dikelola secara andal—sesuatu yang sering kurang pada data lake tradisional. Ini memungkinkan integritas dan tata kelola data yang lebih baik, menjadikan data lakehouse lebih cocok untuk aplikasi tingkat enterprise.
Data lakehouse juga mendukung pemrosesan data real time, memungkinkan organisasi menangani data streaming dan memperoleh wawasan secara real time, yang penting dalam beberapa konteks.
Fitur dan Komponen Data Lakehouse
Bagaimana mungkin mendapatkan yang terbaik dari kedua dunia dalam satu platform? Di bagian ini, saya akan menjelaskan komponen yang memungkinkan arsitektur lakehouse.
1. Pemisahan storage dan compute dengan manajemen data terpadu
Dalam data lakehouse, storage dan compute terpisah namun terintegrasi erat, memungkinkan penggunaan sumber daya yang fleksibel dan skalabel.
Data disimpan di cloud object store yang hemat biaya, sementara sumber daya komputasi dapat diskalakan secara independen berdasarkan kebutuhan beban kerja. Pendekatan ini mengurangi kebutuhan memindahkan data antarsistem, sehingga pengguna dapat memproses data di tempat tanpa ekstraksi dan pemuatan yang ekstensif.
Dengan mengintegrasikan storage dan compute seperti ini, data lakehouse menyederhanakan manajemen data, meningkatkan efisiensi, dan mengurangi latensi, menghasilkan wawasan yang lebih cepat.
Alokasi sumber daya dinamis juga memungkinkan optimalisasi biaya yang lebih baik dan memastikan sumber daya komputasi digunakan secara efektif.
2. Penegakan skema dan tata kelola
Data lakehouse menegakkan skema untuk menjaga kualitas data sekaligus menawarkan fitur tata kelola untuk kepatuhan data.
Penegakan skema memastikan data diorganisasikan dalam format terstruktur, sehingga lebih mudah dikueri dan dianalisis. Ini membantu mencegah inkonsistensi data dan mendukung kualitas data yang lebih baik di seluruh organisasi.
Fitur tata kelola dalam data lakehouse memungkinkan Anda mengelola akses data, garis keturunan (lineage), dan kepatuhan. Dengan alat tata kelola bawaan, data lakehouse dapat mendukung persyaratan regulasi dan melindungi data sensitif. Hal ini sangat penting untuk industri seperti kesehatan dan keuangan, di mana privasi data dan kepatuhan bersifat krusial.
3. Dukungan untuk transaksi ACID
Transaksi ACID menjamin keandalan data, memungkinkan Anda mengelola pembaruan dan penghapusan dengan yakin.
Dalam data lakehouse, transaksi ACID memberikan tingkat integritas data yang sama seperti yang diharapkan dari data warehouse tradisional, namun dengan fleksibilitas tambahan untuk menangani data tidak terstruktur.
Kemampuan mendukung transaksi ACID berarti data lakehouse dapat digunakan untuk beban kerja misi-kritis di mana akurasi data sangat penting. Fitur ini menjadikan data lakehouse pilihan menarik bagi perusahaan yang harus menjaga konsistensi data di berbagai operasi data.
4. Pemrosesan data real time
Data lakehouse dapat memproses data secara real time, memungkinkan use case seperti analitik real time dan wawasan streaming. Pemrosesan data real time memungkinkan tim membuat keputusan berbasis data lebih cepat, meningkatkan daya tanggap dan adaptabilitas.
Sebagai contoh, pemrosesan data real time dapat digunakan untuk memantau interaksi pelanggan, melacak tingkat persediaan, atau mendeteksi anomali dalam transaksi keuangan. Dengan memungkinkan wawasan langsung, data lakehouse membantu Anda tetap selangkah lebih maju dari kondisi pasar yang berubah dan merespons secara proaktif terhadap peluang baru.
5. Dukungan arsitektur multi-cloud dan hybrid
Data lakehouse dapat beroperasi di lingkungan multi-cloud atau hybrid, menawarkan fleksibilitas dan skalabilitas.
Dukungan multi-cloud memungkinkan tim data menghindari keterikatan pada satu vendor dan memanfaatkan layanan terbaik dari berbagai penyedia cloud. Dukungan arsitektur hybrid memastikan sistem on-premises terintegrasi dengan lingkungan cloud, memberikan pengalaman manajemen data yang terpadu.
Fleksibilitas ini sangat bermanfaat bagi tim dengan kebutuhan infrastruktur yang kompleks atau yang sedang melakukan migrasi ke cloud.
Manfaat Menggunakan Data Lakehouse
Di bagian ini, kita akan membahas manfaat menggunakan data lakehouse untuk mengelola beragam kebutuhan pemrosesan data.
1. Skalabilitas dan fleksibilitas
Data lakehouse mewarisi skalabilitas data lake, sehingga mampu menangani kebutuhan data yang terus berkembang. Anda dapat dengan mudah menambahkan lebih banyak data tanpa khawatir batasan penyimpanan, memastikan arsitektur data Anda tumbuh seiring bisnis.
Sebagai contoh, Apache Hudi, Delta Lake, dan Apache Iceberg dapat menskalakan penyimpanan di ribuan file pada sistem object storage seperti Amazon S3, Azure Blob Storage, atau Google Cloud Storage.
Fleksibilitas juga menjadi manfaat besar, karena data lakehouse mendukung data terstruktur (misalnya catatan transaksi) dan tidak terstruktur (misalnya file log, gambar, dan video). Artinya, Anda dapat menyimpan semua data di satu tempat, apa pun formatnya, dan menggunakannya untuk berbagai use case analitik dan machine learning.
2. Efisiensi biaya
Data lakehouse menyimpan data dengan biaya lebih rendah daripada data warehouse sambil tetap mendukung analitik tingkat lanjut.
Sebagai contoh, data lakehouse yang dibangun di atas cloud object storage (seperti Amazon S3 atau Google Cloud Storage) memanfaatkan tier penyimpanan yang hemat biaya. Dikombinasikan dengan format file Apache Parquet dan ORC—yang mengompresi data untuk meminimalkan biaya penyimpanan—data lakehouse memungkinkan Anda meraih penghematan yang signifikan.
Sifat terpadu data lakehouse berarti tidak perlu memelihara sistem terpisah untuk penyimpanan dan analitik, menghasilkan efisiensi biaya dan menjadikan data lakehouse sebagai opsi yang menarik.
3. Waktu menuju wawasan lebih cepat
Kemampuan penyimpanan dan pemrosesan data yang terpadu mengurangi waktu yang dibutuhkan untuk memperoleh wawasan. Data lakehouse menghilangkan kebutuhan memindahkan data antara lingkungan penyimpanan dan komputasi, menyederhanakan alur kerja dan meminimalkan latensi.
Teknologi seperti Apache Spark dan Databricks memungkinkan data diproses langsung di dalam lakehouse, tanpa perlu memindahkannya ke lingkungan analitik terpisah.
Dengan seluruh data berada di satu tempat dan diproses secara efisien, Anda dapat dengan cepat menghasilkan wawasan yang mendorong pengambilan keputusan lebih baik. Waktu menuju wawasan yang lebih cepat ini sangat berharga bagi industri di mana ketepatan waktu informasi krusial, seperti keuangan, ritel, dan layanan kesehatan.
4. Tata kelola dan keamanan data
Penegakan skema dan fitur tata kelola data memenuhi standar kualitas dan kepatuhan data. Data lakehouse menyediakan alat untuk mengelola akses data, jejak audit, dan garis keturunan data, yang penting untuk menjaga integritas data dan memenuhi persyaratan regulasi.
Alat seperti AWS Lake Formation, Azure Purview, dan Apache Ranger menyediakan kontrol terpusat atas akses data, izin, dan jejak audit, memungkinkan Anda mengelola data secara aman dan mencegah akses tidak sah
Fitur tata kelola dan keamanan ini menjadikan data lakehouse cocok untuk perusahaan yang perlu mematuhi regulasi privasi data, seperti GDPR atau HIPAA. Dengan memastikan data dikelola dan dilindungi dengan benar, data lakehouse membantu membangun kepercayaan pada data dan wawasannya.
Use Case Data Lakehouse
Di bagian ini, mari tinjau semua kemungkinan use case untuk data lakehouse.
Analitik data modern
Tim data menggunakan data lakehouse untuk analitik real time, business intelligence, dan alur kerja machine learning. Dengan menyediakan platform data terpadu, data lakehouse memungkinkan profesional menganalisis data historis dan real time untuk memperoleh wawasan yang mendorong hasil bisnis yang lebih baik.
Sebagai contoh, peritel dapat menggunakan data lakehouse untuk menganalisis data penjualan secara real time, mengidentifikasi tren, dan menyesuaikan persediaan mereka. Institusi keuangan dapat memanfaatkan data lakehouse untuk melakukan analisis risiko dan deteksi penipuan, menggabungkan data transaksi historis dan real time untuk pandangan yang komprehensif.
Lihat kursus gratis Understanding Modern Data Architecture untuk mempelajari lebih lanjut cara kerja platform data modern, mulai dari ingestion dan serving hingga tata kelola dan orkestrasi.
Pipeline AI dan machine learning
Data lakehouse menyediakan infrastruktur untuk membangun dan menskalakan model AI dan ML, dengan akses mudah ke data terstruktur dan tidak terstruktur. Model machine learning sering memerlukan berbagai tipe data, dan data lakehouse memungkinkan semua data relevan dihimpun di satu tempat.
Akses data yang terpadu ini menyederhanakan proses pelatihan, pengujian, dan deploy model machine learning. Data scientist dapat dengan cepat bereksperimen dengan dataset berbeda, mengiterasi model, dan menskalakannya ke produksi tanpa harus khawatir tentang silo data atau perpindahan antar sistem.
Aplikasi berbasis data
Data lakehouse menjalankan aplikasi berbasis data yang membutuhkan wawasan real time dan kemampuan pengambilan keputusan. Aplikasi ini sering mengandalkan informasi mutakhir untuk memberikan pengalaman yang dipersonalisasi atau rekomendasi otomatis kepada pengguna.
Sebagai contoh, mesin rekomendasi situs e-niaga dapat menggunakan data lakehouse untuk menganalisis perilaku pengguna secara real time dan memberikan saran produk yang relevan. Demikian pula, perusahaan logistik dapat menggunakan data lakehouse untuk mengoptimalkan rute pengiriman berdasarkan data lalu lintas real time dan pola pengiriman historis.
Platform Data Lakehouse Populer
Saatnya mempelajari teknologi yang memungkinkan arsitektur data lakehouse. Di bagian ini, saya menjelaskan yang paling populer.
1. Databricks Lakehouse
Databricks memelopori arsitektur data lakehouse, menawarkan Delta Lake sebagai komponen inti platformnya. Delta Lake menambahkan keandalan dan peningkatan kinerja pada data lake, memungkinkan transaksi ACID dan memastikan kualitas data.
Databricks Lakehouse menggabungkan skalabilitas data lake dengan fitur manajemen data dari data warehouse, menyediakan platform terpadu untuk analitik dan machine learning. Integrasinya dengan Apache Spark menjadikannya pilihan menarik bagi organisasi yang memanfaatkan kemampuan pemrosesan big data.
Jika Anda ingin mempelajari platform Databricks Lakehouse dan bagaimana ia dapat memodernisasi arsitektur data serta meningkatkan proses manajemen data, lihat kursus gratis Introduction to Databricks.
2. Google BigLake
Google BigLake mengintegrasikan prinsip data lakehouse dengan ekosistem cloud yang sudah ada, menyediakan platform terpadu untuk penyimpanan dan analitik data. BigLake memungkinkan pengguna mengelola data terstruktur dan tidak terstruktur, sehingga memudahkan analitik lintas berbagai tipe data.
Dengan integrasi layanan Google Cloud, BigLake menyediakan solusi komprehensif bagi tim data yang ingin menggunakan alat cloud-native untuk kebutuhan data mereka. Ini mendukung pemrosesan batch dan real time, sehingga cocok untuk berbagai use case.
3. AWS Lake Formation
AWS Lake Formation menyediakan alat untuk menyiapkan data lakehouse menggunakan layanan cloud AWS, dengan integrasi dan pengelolaan yang mulus. Dengan AWS Lake Formation, Anda dapat dengan mudah mengimpor, mengatalogkan, dan mengamankan data, menciptakan data lakehouse terpadu.
AWS Lake Formation juga terintegrasi dengan layanan analitik AWS lainnya, seperti Amazon Redshift dan AWS Glue, menyediakan rangkaian lengkap alat untuk pemrosesan dan analitik data. Ini menjadikannya opsi menarik bagi organisasi yang sudah menggunakan AWS untuk infrastrukturnya.
4. Snowflake
Arsitektur Snowflake berkembang untuk mendukung kemampuan data lakehouse, memungkinkan pengguna mengelola data terstruktur dan semi-terstruktur secara efisien. Snowflake menyediakan analitik berkinerja tinggi sekaligus menawarkan fleksibilitas dalam penyimpanan dan manajemen data.
Fitur data lakehouse Snowflake memungkinkan Anda menggabungkan berbagai tipe data dan melakukan analitik tingkat lanjut tanpa memerlukan banyak sistem. Desain cloud-native dan dukungan untuk deployment multi-cloud menjadikannya pilihan populer bagi tim yang ingin memodernisasi infrastruktur data mereka.
Jika Anda tertarik pada Snowflake, lihat kursus Introduction to Snowflake.
5. Azure Synapse Analytics
Microsoft Azure Synapse Analytics menggabungkan kemampuan big data dan data warehousing ke dalam solusi data lakehouse terpadu.
Synapse memungkinkan tim menganalisis data terstruktur dan tidak terstruktur menggunakan berbagai alat, termasuk SQL, Apache Spark, dan Data Explorer. Integrasi mendalamnya dengan layanan Azure lain, seperti Azure Data Lake Storage dan Power BI, memberikan pengalaman mulus untuk pemrosesan data end-to-end, analitik, dan visualisasi, menjadikannya pilihan ideal bagi organisasi dalam ekosistem Azure.
6. Apache Hudi
Apache Hudi adalah proyek open-source yang menghadirkan kemampuan transaksional ke data lake. Ia mendukung transaksi ACID, upsert, dan versi data.
Hudi terintegrasi baik dengan platform penyimpanan cloud seperti Amazon S3 dan Google Cloud Storage, sehingga cocok untuk analitik real time dan pipeline machine learning. Dengan dukungan untuk mesin big data populer seperti Apache Spark dan Presto, Hudi menawarkan fleksibilitas untuk membangun data lakehouse kustom berbasis teknologi open-source.
7. Dremio
Dremio menyediakan platform data lakehouse terbuka untuk analitik cepat dan beban kerja BI langsung di data lake cloud.
Dengan pendekatan berbasis SQL dan integrasi dengan Apache Arrow, Dremio memungkinkan tim melakukan analitik berkinerja tinggi tanpa pemindahan data. Ini sangat bermanfaat bagi organisasi yang ingin mendukung kueri berbasis SQL pada data lake mereka, menjadikannya pilihan populer bagi tim data yang memprioritaskan kecepatan dan efisiensi.
Perbandingan Platform Data Lakehouse
Seperti yang dapat Anda bayangkan, tidak semua teknologi yang mendukung arsitektur data lakehouse diciptakan sama. Tabel berikut membandingkannya dalam beberapa kategori:
|
Platform |
Jenis Penyimpanan Utama |
Mendukung Data Terstruktur & Tidak Terstruktur |
Mesin Komputasi |
Transaksi ACID |
Pemrosesan Real time |
Integrasi dengan ML/AI |
Use Case Ideal |
|
Databricks Lakehouse |
Delta Lake (Apache Parquet) |
Ya |
Apache Spark |
Ya |
Ya |
Kuat (MLflow, Spark ML) |
Big data analytics, AI/ML |
|
Google BigLake |
Google Cloud Storage |
Ya |
Google BigQuery |
Ya |
Ya |
Terintegrasi dengan Google Cloud AI |
Analitik cloud-native |
|
AWS Lake Formation |
Amazon S3 |
Ya |
Amazon Redshift / AWS Glue |
Ya |
Terbatas |
Integrasi Amazon SageMaker |
Data lakehouse berfokus AWS |
|
Snowflake |
Proprietary (Berbasis Cloud) |
Utamanya Terstruktur |
Snowflake Compute |
Ya |
Terbatas |
Terbatas |
Multi-cloud, analitik berkinerja tinggi |
|
Azure Synapse Analytics |
Azure Data Lake Storage |
Ya |
SQL, Apache Spark, Data Explorer |
Ya |
Ya |
Kuat (Azure ML, Power BI) |
Analitik ekosistem Microsoft |
|
Apache Hudi |
Cloud Object Storage (mis., S3, GCS) |
Ya |
Apache Spark, Presto |
Ya |
Ya |
Dukungan ML Eksternal |
Data lake real time open-source |
|
Dremio |
Cloud Data Lakes |
Ya |
Dremio (Apache Arrow) |
Tidak |
Ya |
Tidak Ada Integrasi Native |
SQL berkinerja tinggi di cloud lakes |
Tantangan dan Pertimbangan dalam Menerapkan Data Lakehouse
Beberapa hal terdengar terlalu bagus untuk menjadi kenyataan, dan data lakehouse tidak terkecuali. Ia seolah menawarkan semuanya, tetapi juga memiliki beberapa kelemahan. Mari kita tinjau di bagian ini.
1. Integrasi dengan sistem yang ada
Mengintegrasikan data lakehouse dengan sistem lama bisa kompleks dan memerlukan perencanaan yang cermat. Tim mungkin perlu memigrasikan data dari data lake atau warehouse yang ada, yang dapat memakan waktu dan sumber daya.
Masalah kompatibilitas juga dapat muncul saat berintegrasi dengan sistem lama yang tidak dirancang untuk bekerja dengan arsitektur data modern. Untuk berhasil menerapkan data lakehouse, Anda harus mengevaluasi infrastruktur saat ini, merencanakan migrasi data, dan memastikan semua sistem dapat bekerja selaras.
2. Mengelola tata kelola dan keamanan data
Menyeimbangkan skalabilitas dengan tata kelola dan keamanan bisa menjadi tantangan, terutama di industri yang teregulasi. Data lakehouse harus menyediakan alat tata kelola yang kuat untuk mengelola akses data, garis keturunan, dan kepatuhan sambil mempertahankan skalabilitas untuk menangani dataset besar.
Pertimbangan penting lainnya adalah memastikan data sensitif diamankan dengan benar. Anda perlu menerapkan kontrol akses, enkripsi, dan audit untuk melindungi data dan memenuhi persyaratan regulasi. Ini bisa sangat menantang di lingkungan hybrid dan multi-cloud, di mana data tersebar di berbagai lokasi.
3. Pertukaran antara biaya dan kinerja
Saat menerapkan data lakehouse, menemukan keseimbangan yang tepat antara efisiensi biaya dan kinerja bisa menantang. Meskipun data lakehouse menawarkan penyimpanan yang hemat biaya, mencapai analitik berkinerja tinggi mungkin memerlukan investasi tambahan pada sumber daya komputasi.
Anda perlu mengevaluasi kebutuhan beban kerja dengan cermat dan menentukan cara paling hemat biaya untuk memenuhi kebutuhan kinerja. Ini dapat melibatkan optimalisasi alokasi sumber daya, memilih layanan cloud yang tepat, atau menyesuaikan konfigurasi data lakehouse agar tujuan biaya dan kinerja tercapai.
Kesimpulan
Data lakehouse merepresentasikan evolusi signifikan dalam arsitektur data, menggabungkan kekuatan data lake dan data warehouse dalam satu platform terpadu!
Dengan penegakan skema, dukungan untuk transaksi ACID, skalabilitas, dan pemrosesan data real time, data lakehouse menawarkan solusi yang kuat untuk kebutuhan data modern.
Data lakehouse memberikan opsi yang menarik bagi tim data yang ingin menyederhanakan lanskap data mereka dan meningkatkan kemampuan analitik.
Jelajahi kursus gratis Understanding Data Engineering untuk mempelajari lebih lanjut tentang data lakehouse dan teknologi rekayasa data yang sedang berkembang.
FAQs
Mengapa data lakehouse menjadi populer?
Data lakehouse menggabungkan skalabilitas dengan analitik yang kuat, sehingga hemat biaya bagi perusahaan yang mencari fleksibilitas, kinerja tinggi, dan wawasan data real time.
Tantangan apa yang dihadapi data lakehouse dibandingkan arsitektur data tradisional?
Data lakehouse harus menyeimbangkan kinerja untuk data terstruktur dan tidak terstruktur, yang bisa kompleks. Penerapan tata kelola dan keamanan di berbagai tipe data serta integrasi dengan sistem lama juga menghadirkan tantangan.
Bagaimana data lakehouse menangani manajemen metadata?
Data lakehouse menggunakan lapisan metadata (seperti penanganan metadata Delta Lake) untuk mengorganisasi, menegakkan skema, dan mengoptimalkan kueri, meningkatkan penemuan data, tata kelola, dan kinerja.
Dapatkah data lakehouse menggantikan data lake dan data warehouse sekaligus?
Meskipun lakehouse sering dapat menggantikan data lake dan warehouse, beberapa use case khusus mungkin tetap memerlukan sistem tersendiri. Untuk sebagian besar kebutuhan, lakehouse menyediakan solusi terpadu dan fleksibel.
Bagaimana data lakehouse mendukung versioning data?
Teknologi seperti Delta Lake dan Apache Hudi memungkinkan versi data, sehingga pengguna dapat melacak perubahan, melakukan rollback, dan memastikan konsistensi data dari waktu ke waktu.
Apa peran data lakehouse dalam demokratisasi data?
Lakehouse mendorong demokratisasi data dengan menawarkan satu platform tempat semua data dapat diakses dan ditata kelola, memberdayakan tim yang lebih luas untuk mengakses dan memanfaatkan data secara aman.

