Vai al contenuto principale
Data Engineering
Machine Learning

Che cos'è un data lakehouse? Architettura, tecnologia e casi d'uso

Scopri come i data lakehouse uniscono i punti di forza di data lake e warehouse, offrendo una soluzione potente per gestione e analytics dei dati!
Moez Ali's photo
Moez Ali
Aggiornato · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.

La gestione dei dati ha visto l'emergere di nuove soluzioni per affrontare i limiti delle architetture tradizionali come data lake e data warehouse. Sebbene entrambe le architetture siano state fondamentali per l'archiviazione e l'analisi dei dati, possono presentare sfide nel rispondere alle esigenze della elaborazione dati moderna.

Nonostante la scalabilità e la flessibilità, i data lake spesso si scontrano con problemi di governance e prestazioni. I data warehouse, invece, pur essendo potenti per l'analisi, sono costosi e meno flessibili. Il data lakehouse punta a risolvere questi problemi combinando i punti di forza di data lake e data warehouse, minimizzandone al contempo le debolezze.

In questa guida ti spiegherò cos'è un data lakehouse, in cosa differisce dalle architetture dati tradizionali e perché sta guadagnando popolarità tra i professionisti dei dati alla ricerca di una soluzione unificata per la gestione dei dati.

Che cos'è un data lakehouse?

Un data lakehouse è un'architettura che combina la scalabilità e l'archiviazione a basso costo dei data lake con le capacità di prestazioni, affidabilità e governance dei data warehouse. 

Integrando i punti di forza di entrambe le architetture, un data lakehouse offre una piattaforma unificata per archiviare, elaborare e analizzare tutti i tipi di dati—strutturati, semi-strutturati e non strutturati.

L'approccio unificato consente maggiore flessibilità nell'elaborazione dei dati e supporta un'ampia gamma di casi d'uso analitici, dalla business intelligence al machine learning.
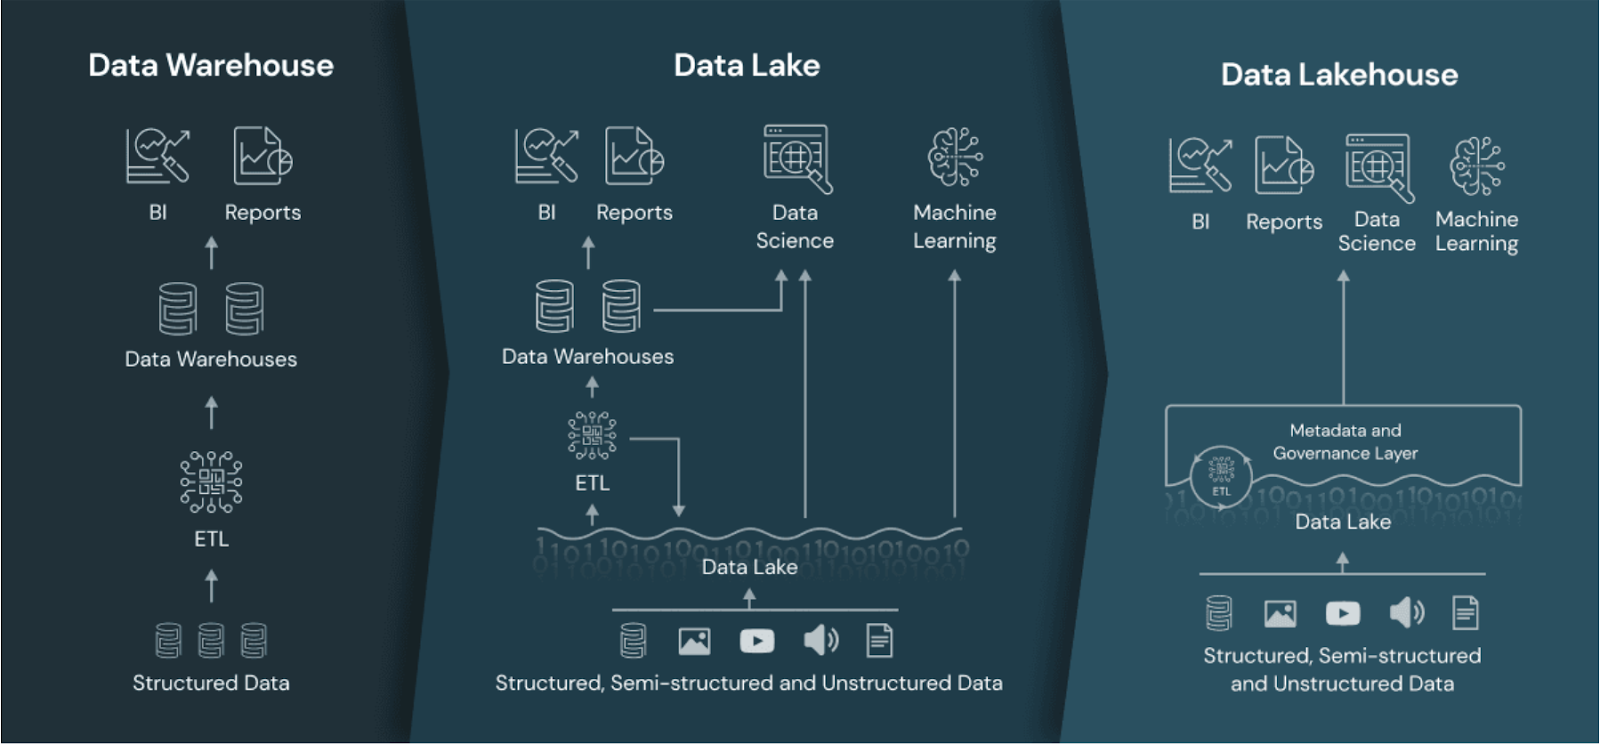
Un'immagine che mostra l'architettura del data warehouse, seguita dal data lake e poi dal data lakehouse

Il data lakehouse rispetto a data warehouse e data lake. Fonte immagine: Databricks.

Data lakehouse vs. data lake vs. data warehouse

Prima di esplorare nel dettaglio l'architettura del data lakehouse, è importante capire come si confronta con data warehouse e data lake.

Data warehouse

I data warehouse sono costruiti per archiviare dati strutturati e fornire analisi e reportistica ad alte prestazioni. 

Uno dei loro maggiori punti di forza è la capacità di eseguire query veloci, il che li rende ideali per casi d'uso di business intelligence e reportistica.

I data warehouse utilizzano uno schema ben definito che supporta una forte governance dei dati. Questo assicura che i dati siano accurati, coerenti e facilmente accessibili per l'analisi.

Tuttavia, questi vantaggi hanno un costo. I data warehouse sono generalmente costosi da mantenere perché si basano su hardware specializzato e su processi di trasformazione dei dati estesi, che di solito richiedono pipeline ETL (extract, transform, load). 

La struttura rigida dei data warehouse li rende inoltre meno adatti a gestire dati non strutturati o ad adattarsi rapidamente ai cambiamenti nei formati dei dati. Questa mancanza di flessibilità può rappresentare un limite significativo per le organizzazioni che vogliono lavorare con fonti di dati in rapida evoluzione o con dati che non rispettano uno schema predefinito, come testo, immagini, audio, ecc.

Per approfondire le basi del data warehousing, dai un'occhiata al corso gratuito Introduction to Data Warehousing.

Data lake

I data lake sono progettati per archiviare grandi quantità di dati semi-strutturati o non strutturati. Il loro principale vantaggio risiede nella capacità di scalare, rendendoli una scelta interessante per i team che gestiscono tipologie di dati diverse e volumi massicci. 

La flessibilità dei data lake ti permette di archiviare dati grezzi nel loro formato nativo, rendendoli ideali per esplorazioni dati e progetti di data science.

Tuttavia, i data lake spesso faticano con governance e qualità dei dati. Poiché i dati sono archiviati in forma grezza e con poca struttura, garantire una qualità costante può essere impegnativo. 

La mancanza di governance può portare a quello che viene comunemente chiamato "data swamp", dove le informazioni preziose sono sepolte sotto dati mal organizzati.

Le prestazioni sono un'altra criticità nei data lake, in particolare per l'esecuzione di query analitiche complesse. I data lake non sono ottimizzati per interrogazioni rapide o per combinare tipi di dati diversi, come immagini, testo e audio.

Data lakehouse

Un data lakehouse mira a combinare il meglio di data lake e data warehouse. Offre una soluzione più bilanciata integrando la scalabilità e l'archiviazione economica dei data lake con le prestazioni e i punti di forza in termini di governance dei data warehouse. 

In teoria, in un lakehouse puoi archiviare dati strutturati e non strutturati a costi inferiori, sfruttando al contempo le capacità necessarie per analisi ad alte prestazioni.

I data lakehouse offrono supporto per le transazioni ACID, il che significa che aggiornamenti ed eliminazioni dei dati possono essere gestiti in modo affidabile, aspetto spesso carente nei data lake tradizionali. Questo consente una migliore integrità e governance dei dati, rendendo i data lakehouse più adatti ad applicazioni di livello enterprise.

I data lakehouse supportano anche l'elaborazione dei dati in tempo reale, consentendo alle organizzazioni di gestire dati in streaming e ottenere insight in real time, importante in alcuni contesti. 

Funzionalità e componenti di un data lakehouse

Come è possibile avere il meglio di entrambi i mondi in un'unica piattaforma? In questa sezione ti spiego i componenti che rendono possibile l'architettura lakehouse.

1. Separazione di storage e compute con gestione dati unificata

In un data lakehouse, storage e compute sono separati ma strettamente integrati, consentendo un uso delle risorse flessibile e scalabile.

I dati sono archiviati in un object storage cloud economico, mentre le risorse di calcolo possono essere scalate in modo indipendente in base ai carichi di lavoro. Questo approccio riduce la necessità di spostare i dati tra sistemi, permettendo di elaborarli in loco senza ampie fasi di estrazione e caricamento. 

Integrando storage e compute in questo modo, i data lakehouse semplificano la gestione dei dati, migliorano l'efficienza e riducono la latenza, portando a insight più rapidi. 

L'allocazione dinamica delle risorse consente anche una migliore ottimizzazione dei costi e assicura un uso efficace del compute.

2. Enforcement dello schema e governance

I data lakehouse applicano schemi per mantenere la qualità dei dati e offrono funzionalità di governance per la conformità.

L'enforcement dello schema garantisce che i dati siano organizzati in un formato strutturato, rendendoli più facili da interrogare e analizzare. Questo aiuta a prevenire incoerenze e supporta una migliore qualità dei dati in tutta l'organizzazione.

Le funzionalità di governance nei data lakehouse ti consentono di gestire accesso ai dati, lineage e conformità. Con strumenti di governance integrati, i data lakehouse possono supportare i requisiti normativi e proteggere i dati sensibili. Ciò è particolarmente importante per settori come sanità e finanza, dove privacy e conformità dei dati sono cruciali.

3. Supporto per transazioni ACID

Le transazioni ACID garantiscono l'affidabilità dei dati, permettendoti di gestire aggiornamenti ed eliminazioni con sicurezza. 

In un data lakehouse, le transazioni ACID offrono lo stesso livello di integrità dei dati atteso da un data warehouse tradizionale, ma con la flessibilità aggiuntiva di gestire dati non strutturati.

La capacità di supportare transazioni ACID rende i data lakehouse utilizzabili per carichi di lavoro mission-critical in cui l'accuratezza dei dati è essenziale. Questa caratteristica li rende una scelta interessante per le aziende che devono mantenere la coerenza dei dati in diverse operazioni.

4. Elaborazione dati in tempo reale

I data lakehouse possono elaborare dati in tempo reale, abilitando casi d'uso come analytics real-time e insight da streaming. L'elaborazione in tempo reale consente ai team di prendere decisioni data-driven più rapidamente, migliorando reattività e adattabilità.

Per esempio, l'elaborazione in tempo reale può essere usata per monitorare le interazioni dei clienti, tracciare i livelli di inventario o rilevare anomalie nelle transazioni finanziarie. Offrendo insight immediati, i data lakehouse ti aiutano ad anticipare i cambiamenti del mercato e a rispondere in modo proattivo alle nuove opportunità.

5. Supporto per architetture multi-cloud e ibride

I data lakehouse possono operare in ambienti multi-cloud o ibridi, offrendo flessibilità e scalabilità. 

Il supporto multi-cloud consente ai team dati di evitare il lock-in del fornitore e sfruttare i servizi migliori dei diversi provider cloud. Il supporto per architetture ibride garantisce che i sistemi on-premises si integrino con gli ambienti cloud, fornendo un'esperienza unificata di gestione dei dati.

Questa flessibilità è particolarmente utile per i team con esigenze infrastrutturali complesse o in fase di migrazione al cloud.

Vantaggi dell'uso di un data lakehouse

In questa sezione discuteremo i vantaggi dell'utilizzo di un data lakehouse per gestire esigenze di elaborazione dati diverse.

1. Scalabilità e flessibilità

I data lakehouse ereditano la scalabilità dei data lake, risultando capaci di gestire esigenze di dati in crescita. Puoi aggiungere facilmente nuovi dati senza preoccuparti dei limiti di archiviazione, assicurando che l'architettura cresca insieme al business.

Per esempio, Apache Hudi, Delta Lake e Apache Iceberg possono scalare l'archiviazione su migliaia di file in sistemi di object storage come Amazon S3, Azure Blob Storage o Google Cloud Storage.

La flessibilità è un altro grande vantaggio, poiché i data lakehouse supportano dati strutturati (ad es. registri transazionali) e non strutturati (ad es. file di log, immagini e video). Significa che puoi archiviare tutti i tuoi dati in un unico posto, a prescindere dal formato, e usarli per vari casi d'uso di analytics e machine learning.

2. Efficienza dei costi

I data lakehouse archiviano i dati a un costo inferiore rispetto ai data warehouse, pur supportando analisi avanzate. 

Ad esempio, i data lakehouse basati su object storage cloud (come Amazon S3 o Google Cloud Storage) sfruttano livelli di archiviazione economici. Unito ai formati di file Apache Parquet e ORC—che comprimono i dati per ridurre i costi di storage—il lakehouse permette di ottenere risparmi sostanziali.

La natura unificata dei data lakehouse elimina la necessità di mantenere sistemi separati per archiviazione e analisi, con un conseguente aumento dell'efficienza dei costi e rendendo i data lakehouse una scelta allettante.

3. Insight più rapidi

L'archiviazione e l'elaborazione dei dati unificate riducono il tempo necessario per ottenere insight. I data lakehouse eliminano la necessità di spostare i dati tra ambienti di archiviazione e di calcolo, snellendo i flussi di lavoro e minimizzando la latenza.

Tecnologie come Apache Spark e Databricks permettono di elaborare i dati direttamente all'interno del lakehouse, senza doverli spostare in ambienti analitici separati.

Avendo tutti i dati in un unico posto e processandoli in modo efficiente, puoi generare rapidamente insight che guidano decisioni migliori. Questo time-to-insight più veloce è particolarmente prezioso in settori dove l'informazione tempestiva è cruciale, come finanza, retail e sanità.

4. Governance e sicurezza dei dati

L'enforcement dello schema e le funzionalità di data governance soddisfano gli standard di qualità e conformità. I data lakehouse forniscono strumenti per gestire accessi, audit trail e lineage, essenziali per mantenere l'integrità dei dati e rispettare i requisiti normativi.

Strumenti come AWS Lake Formation, Azure Purview e Apache Ranger offrono controllo centralizzato su accessi, permessi e audit trail, permettendoti di gestire i dati in sicurezza e prevenire accessi non autorizzati

Queste funzionalità di governance e sicurezza rendono i data lakehouse adatti alle imprese che devono rispettare normative sulla privacy dei dati, come GDPR o HIPAA. Garantendo una gestione e protezione adeguata dei dati, i data lakehouse aiutano a costruire fiducia nei dati e negli insight che ne derivano.

Casi d'uso dei data lakehouse

In questa sezione rivediamo tutti i possibili casi d'uso del data lakehouse.

Analisi dati moderne

I team dati usano i data lakehouse per analytics in tempo reale, business intelligence e workflow di machine learning. Offrendo una piattaforma dati unificata, i data lakehouse consentono ai professionisti di analizzare dati storici e real-time, ottenendo insight che guidano risultati di business migliori.

Per esempio, i retailer possono usare i data lakehouse per analizzare in tempo reale i dati di vendita, identificare trend e regolare di conseguenza l'inventario. Le istituzioni finanziarie possono sfruttare i data lakehouse per eseguire analisi del rischio e rilevamento frodi, combinando dati storici e transazionali in tempo reale per una visione completa.

Dai un'occhiata al corso gratuito Understanding Modern Data Architecture per saperne di più su come funzionano le piattaforme dati moderne, dall'ingestion e serving fino a governance e orchestrazione.

Pipeline di AI e machine learning

I data lakehouse forniscono l'infrastruttura per creare e scalare modelli di AI e ML, con accesso facilitato a dati strutturati e non strutturati. I modelli di machine learning richiedono spesso una varietà di tipi di dati e i data lakehouse rendono possibile riunire tutti i dati rilevanti in un unico luogo.

Questo accesso unificato ai dati semplifica il processo di training, testing e deployment dei modelli di machine learning. I data scientist possono sperimentare rapidamente con dataset diversi, iterare sui modelli e scalarli in produzione senza doversi preoccupare di silos di dati o spostamenti tra sistemi.

Applicazioni data-driven

I data lakehouse alimentano applicazioni data-driven che richiedono insight e capacità decisionali in tempo reale. Queste applicazioni si basano spesso su informazioni aggiornate per offrire esperienze personalizzate o raccomandazioni automatiche.

Per esempio, un motore di raccomandazione di un sito e-commerce può usare un data lakehouse per analizzare in tempo reale il comportamento degli utenti e proporre prodotti pertinenti. Allo stesso modo, le aziende di logistica possono usare i data lakehouse per ottimizzare i percorsi di consegna basandosi su dati di traffico in tempo reale e pattern storici di consegna.

Piattaforme data lakehouse più diffuse

È il momento di conoscere le tecnologie che rendono possibile l'architettura del data lakehouse. In questa sezione spiego le più popolari. 

1. Databricks Lakehouse

Databricks ha aperto la strada all'architettura data lakehouse, offrendo Delta Lake come componente centrale della sua piattaforma. Delta Lake aggiunge affidabilità e miglioramenti prestazionali ai data lake, abilitando transazioni ACID e garantendo la qualità dei dati.

Databricks Lakehouse combina la scalabilità dei data lake con le funzionalità di gestione dei dati dei data warehouse, fornendo una piattaforma unificata per analytics e machine learning. La sua integrazione con Apache Spark la rende una scelta interessante per le organizzazioni che sfruttano capacità di elaborazione big data.

Se vuoi conoscere la piattaforma Databricks Lakehouse e come può modernizzare le architetture dati e migliorare i processi di gestione dei dati, esplora il corso gratuito Introduction to Databricks.

2. Google BigLake

BigLake di Google integra i principi del data lakehouse con il suo ecosistema cloud esistente, fornendo una piattaforma unificata di archiviazione e analisi. BigLake consente di gestire dati strutturati e non strutturati, semplificando l'esecuzione di analisi su tipi di dati differenti.

Grazie all'integrazione con i servizi di Google Cloud, BigLake offre una soluzione completa per i team dati che vogliono utilizzare strumenti cloud-native per le proprie esigenze. Supporta sia l'elaborazione batch che quella in tempo reale, rendendolo adatto a un'ampia gamma di casi d'uso.

3. AWS Lake Formation

AWS Lake Formation fornisce strumenti per configurare un data lakehouse utilizzando i servizi cloud di AWS, offrendo integrazione e gestione senza soluzione di continuità. Con AWS Lake Formation puoi acquisire, catalogare e proteggere facilmente i dati, creando un data lakehouse unificato.

AWS Lake Formation si integra anche con altri servizi di analytics AWS, come Amazon Redshift e AWS Glue, fornendo una suite completa di strumenti per elaborazione e analisi dei dati. Questo lo rende una scelta interessante per le organizzazioni che già utilizzano AWS per la propria infrastruttura.

4. Snowflake

L'architettura di Snowflake sta evolvendo per supportare capacità di data lakehouse, consentendo agli utenti di gestire in modo efficiente dati strutturati e semi-strutturati. Snowflake offre analytics ad alte prestazioni e, al tempo stesso, flessibilità nell'archiviazione e gestione dei dati.

Le funzionalità lakehouse di Snowflake ti permettono di combinare diversi tipi di dati ed eseguire analisi avanzate senza dover ricorrere a sistemi multipli. Il suo design cloud-native e il supporto per deployment multi-cloud lo rendono una scelta popolare per i team che vogliono modernizzare l'infrastruttura dati.

Se ti interessa Snowflake, scopri il corso Introduction to Snowflake.

5. Azure Synapse Analytics

Azure Synapse Analytics di Microsoft combina funzionalità di big data e data warehousing in una soluzione lakehouse unificata. 

Synapse consente ai team di analizzare dati strutturati e non strutturati utilizzando vari strumenti, inclusi SQL, Apache Spark e Data Explorer. La profonda integrazione con altri servizi Azure, come Azure Data Lake Storage e Power BI, offre un'esperienza fluida per l'intero ciclo di vita dei dati—dalla lavorazione all'analisi fino alla visualizzazione—rendendolo un'opzione ideale per le organizzazioni nell'ecosistema Azure.

6. Apache Hudi

Apache Hudi è un progetto open source che porta funzionalità transazionali nei data lake. Supporta transazioni ACID, upsert e versioning dei dati. 

Hudi si integra bene con piattaforme di storage cloud come Amazon S3 e Google Cloud Storage, rendendolo adatto ad analytics in tempo reale e pipeline di machine learning. Con il supporto per motori big data popolari come Apache Spark e Presto, Hudi offre flessibilità per costruire un data lakehouse personalizzato su tecnologia open source.

7. Dremio

Dremio fornisce una piattaforma open data lakehouse per analytics e carichi BI veloci direttamente sui data lake in cloud. 

Con il suo approccio basato su SQL e l'integrazione con Apache Arrow, Dremio consente ai team di eseguire analytics ad alte prestazioni senza spostamento dei dati. È particolarmente utile per le organizzazioni che vogliono supportare query SQL sui propri data lake, risultando una scelta popolare per i team dati che danno priorità a velocità ed efficienza.

Confronto tra piattaforme data lakehouse

Come puoi immaginare, non tutte le tecnologie che supportano l'architettura lakehouse sono uguali. La tabella seguente le confronta in diverse categorie:

Piattaforma

Tipo di archiviazione primario

Supporta dati strutturati e non strutturati

Motore di calcolo

Transazioni ACID

Elaborazione in tempo reale

Integrazione con ML/AI

Caso d'uso ideale

Databricks Lakehouse

Delta Lake (Apache Parquet)

Sì

Apache Spark

Sì

Sì

Forte (MLflow, Spark ML)

Big data analytics, AI/ML

Google BigLake

Google Cloud Storage

Sì

Google BigQuery

Sì

Sì

Integrato con Google Cloud AI

Analytics cloud-native

AWS Lake Formation

Amazon S3

Sì

Amazon Redshift / AWS Glue

Sì

Limitata

Integrazione con Amazon SageMaker

Data lakehouse incentrato su AWS

Snowflake

Proprietario (basato su cloud)

Principalmente strutturati

Snowflake Compute

Sì

Limitata

Limitata

Analytics multi-cloud ad alte prestazioni

Azure Synapse Analytics

Azure Data Lake Storage

Sì

SQL, Apache Spark, Data Explorer

Sì

Sì

Forte (Azure ML, Power BI)

Analytics nell'ecosistema Microsoft

Apache Hudi

Cloud Object Storage (es., S3, GCS)

Sì

Apache Spark, Presto

Sì

Sì

Supporto ML esterno

Data lake open source in tempo reale

Dremio

Cloud Data Lake

Sì

Dremio (Apache Arrow)

No

Sì

Nessuna integrazione nativa

SQL ad alte prestazioni sui data lake in cloud

Sfide e considerazioni per l'implementazione di un data lakehouse

Alcune cose sono troppo belle per essere vere, e il data lakehouse non fa eccezione. Sembra offrire tutto, ma presenta anche alcuni lati negativi. Rivediamoli in questa sezione.

1. Integrazione con i sistemi esistenti

Integrare un data lakehouse con sistemi legacy può essere complesso e richiede un'attenta pianificazione. I team potrebbero dover migrare dati da data lake o warehouse esistenti, un'operazione dispendiosa in termini di tempo e risorse.

Possono sorgere anche problemi di compatibilità quando si integrano sistemi più datati non progettati per lavorare con architetture dati moderne. Per implementare con successo un data lakehouse, devi valutare l'infrastruttura attuale, pianificare la migrazione dei dati e garantire che tutti i sistemi possano operare in armonia.

2. Gestione di governance e sicurezza dei dati

Bilanciare scalabilità con governance e sicurezza può essere impegnativo, soprattutto in settori regolamentati. I data lakehouse devono fornire strumenti di governance solidi per gestire accesso, lineage e conformità, mantenendo al contempo la scalabilità necessaria a gestire grandi dataset.

Un'altra considerazione critica è garantire che i dati sensibili siano adeguatamente protetti. Devi implementare controlli di accesso, crittografia e auditing per proteggere i dati e rispettare i requisiti normativi. Ciò può essere particolarmente sfidante in ambienti ibridi e multi-cloud, dove i dati sono distribuiti in posizioni diverse.

3. Compromessi tra costi e prestazioni

Nell'implementare un data lakehouse, trovare il giusto equilibrio tra efficienza dei costi e prestazioni può essere difficile. Sebbene i data lakehouse offrano storage economico, ottenere analisi ad alte prestazioni può richiedere ulteriori investimenti in risorse di calcolo.

Devi valutare attentamente i requisiti dei carichi di lavoro e determinare il modo più conveniente per soddisfare le esigenze di performance. Questo può comportare l'ottimizzazione dell'allocazione delle risorse, la scelta dei servizi cloud più adatti o la regolazione della configurazione del lakehouse affinché siano soddisfatti sia gli obiettivi di costo sia quelli di prestazioni.

Conclusione

I data lakehouse rappresentano un'evoluzione significativa dell'architettura dati, combinando i punti di forza di data lake e data warehouse in un'unica piattaforma unificata! 

Con enforcement dello schema, supporto alle transazioni ACID, scalabilità ed elaborazione dati in tempo reale, i data lakehouse offrono una soluzione potente per le esigenze dati moderne. 

I data lakehouse rappresentano un'opzione convincente per i team dati che vogliono semplificare il panorama dei dati e migliorare le capacità analitiche.

Esplora il corso gratuito Understanding Data Engineering per saperne di più sui data lakehouse e su altre tecnologie emergenti di data engineering.

FAQs

Perché i data lakehouse stanno diventando popolari?

I data lakehouse combinano scalabilità e analytics robusti, risultando convenienti per le aziende che cercano flessibilità, alte prestazioni e insight sui dati in tempo reale.

Quali sfide affrontano i data lakehouse rispetto alle architetture dati tradizionali?

I data lakehouse devono bilanciare le prestazioni per dati strutturati e non strutturati, cosa che può essere complessa. Implementare governance e sicurezza su tipologie di dati eterogenee e integrare sistemi legacy presenta ulteriori sfide.

Come gestisce un data lakehouse la gestione dei metadati?

I data lakehouse utilizzano layer di metadata (come la gestione dei metadati di Delta Lake) per organizzare, applicare schemi e ottimizzare le query, migliorando discovery, governance e prestazioni.

I data lakehouse possono sostituire sia i data lake sia i data warehouse?

Sebbene i lakehouse possano spesso sostituire data lake e data warehouse, alcuni casi d'uso specializzati potrebbero richiedere sistemi dedicati. Per la maggior parte delle esigenze, i lakehouse offrono una soluzione unificata e flessibile.

Come supportano i data lakehouse il versioning dei dati?

Tecnologie come Delta Lake e Apache Hudi consentono il versioning dei dati, permettendo di tracciare le modifiche, eseguire rollback e garantire la coerenza nel tempo.

Che ruolo hanno i data lakehouse nella democratizzazione dei dati?

I lakehouse promuovono la democratizzazione dei dati offrendo un'unica piattaforma in cui tutti i dati sono accessibili e governati, consentendo a team più ampi di accedere e sfruttare i dati in sicurezza.


Moez Ali's photo
Author
Moez Ali
LinkedIn
Twitter

Data Scientist, fondatore e creatore di PyCaret

Argomenti
Data Engineering
Machine Learning

Approfondisci il data engineering con questi corsi!

Corso

Introduzione al Data Engineering

4 ore
130.4K
Scopri il mondo dell'ingegneria dei dati in questo breve corso, che parla di strumenti e argomenti come ETL e cloud computing.
Vedi i dettagliInizia Il Corso

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.
Mostra altro
Correlato

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra altro

