Kurs
Veri yönetimi, veri gölleri ve veri ambarları gibi geleneksel mimarilerin sınırlamalarını gidermek için yeni çözümlerin ortaya çıktığını gördü. Her iki mimari de veri depolama ve analitik için önemli olsa da, modern veri işleme ihtiyaçlarını karşılamada zorluklar çıkarabilir.
Ölçeklenebilir ve esnek olmasına rağmen, veri gölleri sıklıkla yönetişim ve performans sorunlarıyla karşılaşır. Öte yandan, veri ambarları analitik açısından güçlü olsa da maliyetlidir ve daha az esnektir. Veri lakehouse yaklaşımı, veri göllerinin ve veri ambarlarının güçlü yönlerini birleştirirken zayıflıklarını en aza indirerek bu sorunları çözmeyi amaçlar.
Bu rehberde, bir veri lakehouse’un ne olduğunu, geleneksel veri mimarilerinden nasıl farklılaştığını ve neden birleşik bir veri yönetimi çözümü arayan veri profesyonelleri arasında giderek daha popüler hale geldiğini anlatacağım.
Veri Lakehouse Nedir?
Veri lakehouse, veri göllerinin ölçeklenebilirliği ve düşük maliyetli depolamasını, veri ambarlarının performans, güvenilirlik ve yönetişim yetenekleriyle birleştiren bir mimaridir.
Her iki mimarinin güçlü yönlerini entegre ederek, bir veri lakehouse yapılandırılmış, yarı yapılandırılmış ve yapılandırılmamış tüm veri türlerini depolamak, işlemek ve analiz etmek için birleşik bir platform sunar.
Bu birleşik yaklaşım, veri işlemeye daha fazla esneklik sağlar ve iş zekâsından makine öğrenmesine kadar geniş bir analitik kullanım alanını destekler.
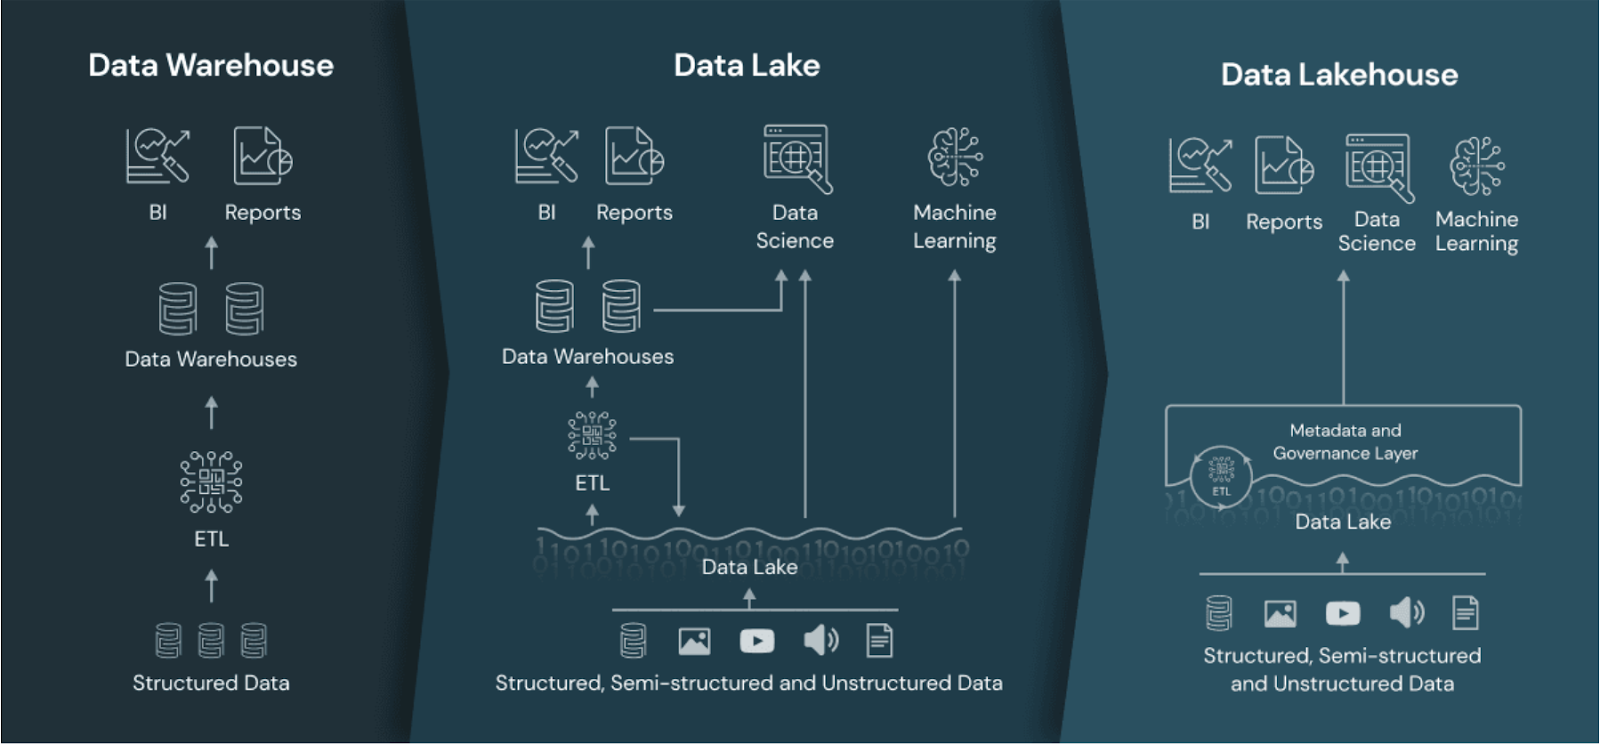
Veri lakehouse’un veri ambarı ve veri gölü ile karşılaştırılması. Görsel kaynağı: Databricks.
Veri Lakehouse vs. Veri Gölü vs. Veri Ambarı
Veri lakehouse mimarisini daha ayrıntılı incelemeden önce, veri ambarları ve veri gölleriyle nasıl karşılaştırıldığını anlamak önemlidir.
Veri ambarı
Veri ambarları yapılandırılmış veriyi depolamak ve yüksek performanslı analitik ve raporlama sağlamak için tasarlanmıştır.
En büyük güçlü yönlerinden biri hızlı sorgular çalıştırabilmeleridir; bu da onları iş zekâsı ve raporlama kullanım senaryoları için uygun kılar.
Veri ambarları, güçlü veri yönetişimini destekleyen iyi tanımlanmış bir şema kullanır. Bu, verinin analiz için doğru, tutarlı ve kolay erişilebilir olmasını sağlar.
Ancak bu avantajların bir bedeli vardır. Veri ambarlarını sürdürmek genellikle pahalıdır; çünkü özel donanım ve genellikle ETL (çıkar, dönüştür, yükle) hatları gerektiren kapsamlı veri dönüşüm süreçlerine dayanırlar.
Veri ambarlarının katı yapısı, yapılandırılmamış veriyi ele almak veya veri formatı değişikliklerine hızlı uyum sağlamak için de daha az uygundur. Bu esneklik eksikliği, hızla gelişen veri kaynaklarıyla çalışmayı hedefleyen veya önceden tanımlanmış bir şemaya uymayan metin, görsel, ses vb. gibi verilerle uğraşan kuruluşlar için önemli bir sınırlama olabilir.
Veri ambarı temelleri hakkında daha fazla bilgi edinmek için ücretsiz Introduction to Data Warehousing kursuna göz atın.
Veri gölü
Veri gölleri, büyük miktarda yarı yapılandırılmış veya yapılandırılmamış veriyi depolamak için tasarlanmıştır. Temel avantajları, ölçeklenebilir olmalarıdır; bu da onları çeşitli veri türleri ve çok büyük veri hacimleriyle uğraşan ekipler için cazip bir seçenek yapar.
Veri göllerinin esnekliği, ham veriyi yerel formatında depolamanıza olanak tanır; bu da onları veri keşfi ve veri bilimi projeleri için ideal kılar.
Bununla birlikte, veri gölleri genellikle veri yönetişimi ve veri kalitesiyle ilgili zorlanır. Veriler, fazla yapı olmaksızın ham biçimde depolandığı için tutarlı veri kalitesini sağlamak zor olabilir.
Bu yönetişim eksikliği, değerli içgörülerin kötü organize edilmiş verilerin altında gömülü kaldığı, yaygın olarak “veri bataklığı” olarak bilinen duruma yol açabilir.
Performans da veri göllerinde, özellikle karmaşık analitik sorguların yürütülmesinde kritik bir endişedir. Veri gölleri hızlı sorgulama veya görseller, metin ve ses gibi farklı veri türlerini birleştirme için optimize edilmemiştir.
Veri lakehouse
Veri lakehouse, veri gölleri ve veri ambarlarının en iyilerini bir araya getirmeyi amaçlar. Veri göllerinin ölçeklenebilirliği ve düşük maliyetli depolama yeteneklerini, veri ambarlarının performans ve yönetişim güçlü yönleriyle entegre ederek daha dengeli bir çözüm sunar.
Teoride, bir lakehouse’ta hem yapılandırılmış hem de yapılandırılmamış veriyi daha düşük maliyetle depolarken yüksek performanslı analitik için gerekli yeteneklerden yararlanabilirsiniz.
Veri lakehouse’lar ACID işlemleri için destek sunar; bu, veri güncellemeleri ve silmelerinin güvenilir şekilde yönetilebileceği anlamına gelir ki bu, geleneksel veri göllerinde çoğu zaman eksiktir. Bu da daha iyi veri bütünlüğü ve yönetişim sağlar; lakehouse’ları kurumsal ölçekte uygulamalar için daha uygun hale getirir.
Veri lakehouse’lar ayrıca gerçek zamanlı veri işlemeyi destekler; bu da kuruluşların akış verisini ele almasına ve gerçek zamanlı içgörüler elde etmesine olanak tanır; bazı ortamlarda bu kritiktir.
Bir Veri Lakehouse’un Özellikleri ve Bileşenleri
Tek bir platformda iki dünyanın en iyisine nasıl sahip olunur? Bu bölümde, lakehouse mimarisini mümkün kılan bileşenleri açıklayacağım.
1. Birleşik veri yönetimiyle depolama ve işlemeyi ayırma
Bir veri lakehouse’ta depolama ve işlem ayrıdır ancak sıkı şekilde entegredir; bu da esnek ve ölçeklenebilir kaynak kullanımına olanak tanır.
Veri, maliyet etkin bir bulut nesne deposunda saklanırken, işlem kaynakları iş yükü taleplerine göre bağımsız olarak ölçeklenebilir. Bu yaklaşım, veriyi sistemler arasında taşımaya duyulan ihtiyacı azaltır; kullanıcıların kapsamlı çıkarma ve yükleme olmadan veriyi yerinde işlemesine olanak tanır.
Depolama ve işlemenin bu şekilde entegre edilmesi, veri yönetimini sadeleştirir, verimliliği artırır ve gecikmeyi düşürerek daha hızlı içgörüler sağlar.
Dinamik kaynak tahsisi aynı zamanda daha iyi maliyet optimizasyonu sağlar ve işlem kaynaklarının etkin kullanılmasını güvence altına alır.
2. Şema zorlaması ve yönetişim
Veri lakehouse’lar, veri kalitesini korumak için şemaları uygular ve veri uyumluluğu için yönetişim özellikleri sunar.
Şema zorlaması, verinin yapılandırılmış bir formatta düzenlenmesini sağlayarak sorgulamayı ve analiz etmeyi kolaylaştırır. Bu, veri tutarsızlıklarını önlemeye yardımcı olur ve kuruluş genelinde daha iyi veri kalitesini destekler.
Veri lakehouse’lardaki yönetişim özellikleri, veri erişimi, soy kütüğü (lineage) ve uyumluluğu yönetmenize olanak tanır. Yerleşik yönetişim araçlarıyla, veri lakehouse’lar düzenleyici gereklilikleri destekleyebilir ve hassas veriyi koruyabilir. Bu, veri gizliliği ve uyumluluğun kritik olduğu sağlık ve finans gibi sektörler için özellikle önemlidir.
3. ACID işlemleri için destek
ACID işlemleri, veri güvenilirliğini sağlar ve güncellemeleri ile silmeleri güvenle yönetmenize imkân tanır.
Bir veri lakehouse’ta ACID işlemleri, geleneksel bir veri ambarından beklenen veri bütünlüğü seviyesini sunar; buna ek olarak yapılandırılmamış veriyi ele alma esnekliğini sağlar.
ACID işlemlerini destekleyebilmek, veri lakehouse’ların veri doğruluğunun hayati olduğu kritik iş yükleri için kullanılabileceği anlamına gelir. Bu özellik, farklı veri işlemleri arasında tutarlılığı koruması gereken işletmeler için lakehouse’ları cazip kılar.
4. Gerçek zamanlı veri işleme
Veri lakehouse’lar veriyi gerçek zamanlı işleyebilir; bu da gerçek zamanlı analitik ve akış içgörüleri gibi kullanım senaryolarını mümkün kılar. Gerçek zamanlı veri işleme, ekiplerin daha hızlı veri odaklı kararlar almasını sağlayarak çevikliği ve uyum yeteneğini artırır.
Örneğin, gerçek zamanlı veri işleme müşteri etkileşimlerini izlemek, stok seviyelerini takip etmek veya finansal işlemlerde anormallikleri tespit etmek için kullanılabilir. Anında içgörü sağlayarak, veri lakehouse’lar değişen pazar koşullarının önünde olmanıza ve yeni fırsatlara proaktif yanıt vermenize yardımcı olur.
5. Çoklu bulut ve hibrit mimari desteği
Veri lakehouse’lar çoklu bulut veya hibrit ortamlarda çalışabilir; bu da esneklik ve ölçeklenebilirlik sunar.
Çoklu bulut desteği, veri ekiplerinin satıcıya bağımlılığı önlemesine ve farklı bulut sağlayıcılarının en iyi hizmetlerinden yararlanmasına olanak tanır. Hibrit mimari desteği, şirket içi sistemlerin bulut ortamlarıyla entegre olmasını sağlayarak birleşik bir veri yönetimi deneyimi sunar.
Bu esneklik, özellikle karmaşık altyapı ihtiyaçları olan veya buluta geçiş sürecinde olan ekipler için faydalıdır.
Veri Lakehouse Kullanmanın Faydaları
Bu bölümde, farklı veri işleme ihtiyaçlarını yönetmek için bir veri lakehouse kullanmanın faydalarını ele alacağız.
1. Ölçeklenebilirlik ve esneklik
Veri lakehouse’lar, veri göllerinin ölçeklenebilirliğini miras alır; bu da artan veri ihtiyaçlarını karşılayabilecekleri anlamına gelir. Depolama sınırlamalarını dert etmeden kolayca daha fazla veri ekleyebilir, böylece veri mimarinizin işinizle birlikte büyümesini sağlayabilirsiniz.
Örneğin, Apache Hudi, Delta Lake ve Apache Iceberg; Amazon S3, Azure Blob Storage veya Google Cloud Storage gibi nesne depolama sistemlerinde binlerce dosya arasında depolamayı ölçekleyebilir.
Esneklik bir diğer önemli faydadır; çünkü veri lakehouse’lar hem yapılandırılmış (ör. işlem kayıtları) hem de yapılandırılmamış veriyi (ör. günlük dosyaları, görseller ve videolar) destekler. Bu da formatı ne olursa olsun tüm verinizi tek yerde depolayabileceğiniz ve çeşitli analitik ve makine öğrenmesi kullanım senaryolarında değerlendirebileceğiniz anlamına gelir.
2. Maliyet etkinliği
Veri lakehouse’lar, veriyi veri ambarlarına kıyasla daha düşük maliyetle depolar ve yine de gelişmiş analitiği destekler.
Örneğin, bulut nesne depolaması (Amazon S3 veya Google Cloud Storage gibi) üzerinde inşa edilen veri lakehouse’lar, bu hizmetlerin uygun maliyetli depolama katmanlarından yararlanır. Apache Parquet ve ORC dosya formatlarıyla—veriyi sıkıştırarak depolama maliyetlerini en aza indiren—birlikte, veri lakehouse’lar kayda değer tasarruflar sağlar.
Veri lakehouse’ların birleşik doğası, depolama ve analitik için ayrı sistemler sürdürme ihtiyacını ortadan kaldırır; bu da maliyet etkinliği sağlar ve lakehouse’ları cazip bir seçenek haline getirir.
3. Daha hızlı içgörüye ulaşma
Birleşik veri depolama ve işleme yetenekleri, içgörü elde etmek için gereken süreyi azaltır. Veri lakehouse’lar, veriyi depolama ve işlem ortamları arasında taşımaya duyulan ihtiyacı ortadan kaldırarak iş akışlarını sadeleştirir ve gecikmeyi en aza indirir.
Apache Spark ve Databricks gibi teknolojiler, verinin doğrudan lakehouse içinde işlenmesini sağlar; böylece ayrı analitik ortamlara taşımaya gerek kalmaz.
Tüm verinin tek yerde bulunması ve verimli şekilde işlenmesi sayesinde, daha iyi karar almayı sağlayan içgörüleri hızla üretebilirsiniz. Bu hızlı içgörüye ulaşma süresi, zamanında bilginin kritik olduğu finans, perakende ve sağlık gibi sektörlerde özellikle değerlidir.
4. Veri yönetişimi ve güvenlik
Şema zorlaması ve veri yönetişimi özellikleri, veri kalitesi ve uyumluluk standartlarını karşılar. Veri lakehouse’lar, veri erişimi, denetim izleri ve veri soy kütüğünü yönetmek için araçlar sağlar; bu da veri bütünlüğünü korumak ve düzenleyici gereklilikleri karşılamak için esastır.
AWS Lake Formation, Azure Purview ve Apache Ranger gibi araçlar, veri erişimi, izinler ve denetim izleri üzerinde merkezi kontrol sağlayarak veriyi güvenli biçimde yönetmenize ve yetkisiz erişimi önlemenize olanak tanır
Bu yönetişim ve güvenlik özellikleri, GDPR veya HIPAA gibi veri gizliliği düzenlemelerine uyması gereken işletmeler için lakehouse’ları uygun kılar. Verinin doğru şekilde yönetilmesini ve korunmasını sağlayarak, veri lakehouse’lar veriye ve elde edilen içgörülere güven inşa etmeye yardımcı olur.
Veri Lakehouse Kullanım Alanları
Bu bölümde, veri lakehouse için olası tüm kullanım senaryolarını gözden geçirelim.
Modern veri analitiği
Veri ekipleri, gerçek zamanlı analitik, iş zekâsı ve makine öğrenmesi iş akışları için veri lakehouse’ları kullanır. Birleşik bir veri platformu sunarak, lakehouse’lar profesyonellerin geçmiş ve gerçek zamanlı veriyi analiz etmesini ve daha iyi iş sonuçlarını destekleyen içgörüler elde etmesini sağlar.
Örneğin, perakendeciler veri lakehouse’ları kullanarak satış verilerini gerçek zamanlı analiz edebilir, trendleri belirleyebilir ve stoklarını buna göre ayarlayabilir. Finans kuruluşları, geçmiş ve gerçek zamanlı işlem verilerini birleştirerek kapsamlı bir görünüm için risk analizi ve sahtekarlık tespiti gerçekleştirmek üzere lakehouse’lardan yararlanabilir.
Modern veri platformlarının alma ve sunumdan yönetişim ve orkestrasyona kadar nasıl çalıştığı hakkında daha fazla bilgi için ücretsiz Understanding Modern Data Architecture kursuna göz atın.
Yapay zekâ ve makine öğrenmesi hatları
Veri lakehouse’lar, yapılandırılmış ve yapılandırılmamış veriye kolay erişimle, yapay zekâ ve ML modelleri inşa etmek ve ölçeklemek için gerekli altyapıyı sağlar. Makine öğrenmesi modelleri sıklıkla çeşitli veri türlerine ihtiyaç duyar ve lakehouse’lar ilgili tüm veriyi tek yerde bir araya getirmeyi mümkün kılar.
Bu birleşik veri erişimi, makine öğrenmesi modellerini eğitme, test etme ve yayına alma süreçlerini basitleştirir. Veri bilimcileri, farklı veri kümeleriyle hızla deney yapabilir, modeller üzerinde yineleme yapabilir ve veriyi silolardan çıkarmak veya sistemler arasında taşımak zorunda kalmadan üretime ölçekleyebilir.
Veri odaklı uygulamalar
Veri lakehouse’lar, gerçek zamanlı içgörü ve karar verme yetenekleri gerektiren veri odaklı uygulamaları güçlendirir. Bu uygulamalar, kullanıcılara kişiselleştirilmiş deneyimler veya otomatik öneriler sunmak için genellikle güncel bilgilere dayanır.
Örneğin, bir e-ticaret sitesi öneri motoru, kullanıcı davranışını gerçek zamanlı analiz etmek ve ilgili ürün önerileri sunmak için bir lakehouse kullanabilir. Benzer şekilde, lojistik şirketleri gerçek zamanlı trafik verileri ve geçmiş teslimat kalıplarına dayalı olarak teslimat rotalarını optimize etmek için lakehouse’lardan yararlanabilir.
Popüler Veri Lakehouse Platformları
Artık veri lakehouse mimarisini mümkün kılan teknolojileri öğrenme zamanı. Bu bölümde en popüler olanları açıklıyorum.
1. Databricks Lakehouse
Databricks, platformunun temel bir bileşeni olarak Delta Lake sunarak veri lakehouse mimarisine öncülük etmiştir. Delta Lake, veri göllerine güvenilirlik ve performans iyileştirmeleri ekleyerek ACID işlemlerini mümkün kılar ve veri kalitesini güvence altına alır.
Databricks Lakehouse, veri göllerinin ölçeklenebilirliğini veri ambarlarının veri yönetimi özellikleriyle birleştirerek analitik ve makine öğrenmesi için birleşik bir platform sağlar. Apache Spark ile entegrasyonu, büyük veri işleme yeteneklerinden yararlanan kuruluşlar için onu cazip bir seçenek yapar.
Databricks Lakehouse platformu ve veri mimarilerini nasıl modernleştirip veri yönetimi süreçlerini nasıl iyileştirebileceği hakkında bilgi edinmek isterseniz, ücretsiz Introduction to Databricks kursuna göz atın.
2. Google BigLake
Google’ın BigLake’i, mevcut bulut ekosistemiyle lakehouse ilkelerini entegre ederek birleşik bir veri depolama ve analitik platformu sunar. BigLake, kullanıcıların yapılandırılmış ve yapılandırılmamış veriyi yönetmesine olanak tanır; böylece farklı veri türleri üzerinde analitik yapmayı kolaylaştırır.
Google Cloud hizmetleriyle entegrasyon sayesinde BigLake, veri ihtiyaçları için bulut-yerel araçlar kullanmak isteyen veri ekipleri için kapsamlı bir çözüm sunar. Hem toplu (batch) hem de gerçek zamanlı işlemeyi desteklediğinden, geniş bir kullanım yelpazesi için uygundur.
3. AWS Lake Formation
AWS Lake Formation, AWS’in bulut hizmetlerini kullanarak bir veri lakehouse kurmak için araçlar sunar; sorunsuz entegrasyon ve yönetim sağlar. AWS Lake Formation ile veri kolayca alınabilir, kataloglanabilir ve güvence altına alınabilir; böylece birleşik bir lakehouse oluşturabilirsiniz.
AWS Lake Formation ayrıca Amazon Redshift ve AWS Glue gibi diğer AWS analitik hizmetleriyle entegre olur; veri işleme ve analitik için tam bir araç seti sağlar. Bu da altyapısı için zaten AWS kullanan kuruluşlar için onu cazip bir seçenek haline getirir.
4. Snowflake
Snowflake’in mimarisi, lakehouse yeteneklerini destekleyecek şekilde evrilmekte; kullanıcıların yapılandırılmış ve yarı yapılandırılmış veriyi verimli biçimde yönetmesine olanak tanımaktadır. Snowflake, veri depolama ve yönetiminde esneklik sunarken yüksek performanslı analitik sağlar.
Snowflake’in lakehouse özellikleri, farklı veri türlerini bir araya getirmenizi ve birden fazla sisteme ihtiyaç duymadan gelişmiş analitik yapmanızı mümkün kılar. Bulut-yerel tasarımı ve çoklu bulut dağıtımlarını desteklemesi, veri altyapısını modernleştirmek isteyen ekipler için onu popüler bir seçenek yapar.
Snowflake ilginizi çekiyorsa, Introduction to Snowflake kursuna göz atın.
5. Azure Synapse Analytics
Microsoft’un Azure Synapse Analytics ürünü, büyük veri ve veri ambarı yeteneklerini birleşik bir lakehouse çözümünde bir araya getirir.
Synapse, SQL, Apache Spark ve Data Explorer dahil olmak üzere çeşitli araçlarla hem yapılandırılmış hem de yapılandırılmamış veriyi analiz etmeyi mümkün kılar. Azure Data Lake Storage ve Power BI gibi diğer Azure hizmetleriyle derin entegrasyonu, uçtan uca veri işleme, analitik ve görselleştirme için kesintisiz bir deneyim sunar; bu da onu Azure ekosistemi içindeki kuruluşlar için ideal bir seçenek yapar.
6. Apache Hudi
Apache Hudi, veri göllerine işlemsel yetenekler kazandıran açık kaynaklı bir projedir. ACID işlemleri, upsert’lar ve veri sürümlemesini destekler.
Hudi, Amazon S3 ve Google Cloud Storage gibi bulut depolama platformlarıyla iyi entegre olur; bu da onu gerçek zamanlı analitik ve makine öğrenmesi hatları için uygun kılar. Apache Spark ve Presto gibi popüler büyük veri motorlarını destekleyen Hudi, açık kaynak teknolojilerle özel bir lakehouse inşa etmek için esneklik sunar.
7. Dremio
Dremio, bulut veri gölleri üzerinde hızlı analitik ve BI iş yükleri için açık bir lakehouse platformu sunar.
SQL tabanlı yaklaşımı ve Apache Arrow ile entegrasyonu sayesinde Dremio, veri taşımaya gerek olmadan yüksek performanslı analitik yapmayı mümkün kılar. Veri göllerinde SQL tabanlı sorgulama desteği arayan ve hız ile verimliliğe öncelik veren veri ekipleri için popüler bir tercihtir.
Veri Lakehouse Platformlarının Karşılaştırması
Tahmin edebileceğiniz gibi, lakehouse mimarisini destekleyen tüm teknolojiler aynı değildir. Aşağıdaki tablo, onları çeşitli kategorilerde karşılaştırır:
|
Platform |
Birincil Depolama Türü |
Yapılandırılmış ve Yapılandırılmamış Veriyi Destekler |
İşlem Motoru |
ACID İşlemleri |
Gerçek Zamanlı İşleme |
ML/AI ile Entegrasyon |
İdeal Kullanım Senaryosu |
|
Databricks Lakehouse |
Delta Lake (Apache Parquet) |
Evet |
Apache Spark |
Evet |
Evet |
Güçlü (MLflow, Spark ML) |
Büyük veri analitiği, AI/ML |
|
Google BigLake |
Google Cloud Storage |
Evet |
Google BigQuery |
Evet |
Evet |
Google Cloud AI ile Entegre |
Bulut-yerel analitik |
|
AWS Lake Formation |
Amazon S3 |
Evet |
Amazon Redshift / AWS Glue |
Evet |
Sınırlı |
Amazon SageMaker Entegrasyonu |
AWS merkezli lakehouse |
|
Snowflake |
Tescilli (Bulut tabanlı) |
Ağırlıkla Yapılandırılmış |
Snowflake Compute |
Evet |
Sınırlı |
Sınırlı |
Çoklu bulut, yüksek performanslı analitik |
|
Azure Synapse Analytics |
Azure Data Lake Storage |
Evet |
SQL, Apache Spark, Data Explorer |
Evet |
Evet |
Güçlü (Azure ML, Power BI) |
Microsoft ekosistemi analitiği |
|
Apache Hudi |
Bulut Nesne Deposu (örn. S3, GCS) |
Evet |
Apache Spark, Presto |
Evet |
Evet |
Harici ML Desteği |
Açık kaynak gerçek zamanlı veri gölleri |
|
Dremio |
Bulut Veri Gölleri |
Evet |
Dremio (Apache Arrow) |
Hayır |
Evet |
Yerel Entegrasyon Yok |
Bulut göllerinde yüksek performanslı SQL |
Bir Veri Lakehouse Uygulamanın Zorlukları ve Dikkat Edilecekler
Bazı şeyler kulağa gerçek olamayacak kadar iyi gelir; veri lakehouse da istisna değildir. Görünüşte her şeyi sunar, ancak bazı eksileri de vardır. Bu bölümde bunları inceleyelim.
1. Mevcut sistemlerle entegrasyon
Bir lakehouse’u eski (legacy) sistemlerle entegre etmek karmaşık olabilir ve dikkatli planlama gerektirir. Ekiplerin mevcut veri göllerinden veya ambarlarından veri taşımaları gerekebilir; bu da zaman ve kaynak açısından yoğun olabilir.
Modern veri mimarileriyle çalışmak üzere tasarlanmamış eski sistemlerle entegrasyonda uyumluluk sorunları da ortaya çıkabilir. Bir lakehouse’u başarıyla uygulamak için mevcut altyapınızı değerlendirmeli, veri geçişini planlamalı ve tüm sistemlerin uyum içinde çalışabildiğinden emin olmalısınız.
2. Veri yönetişimi ve güvenliği yönetmek
Özellikle düzenlemeye tabi sektörlerde, ölçeklenebilirliği yönetişim ve güvenlikle dengelemek zor olabilir. Veri lakehouse’lar, büyük veri kümelerini ele almak için gereken ölçeklenebilirliği korurken, veri erişimi, soy kütüğü ve uyumluluğu yönetmek için sağlam yönetişim araçları sağlamalıdır.
Bir diğer kritik husus, hassas verinin uygun şekilde güvence altına alınmasıdır. Verinizi korumak ve düzenleyici gereklilikleri karşılamak için erişim kontrolleri, şifreleme ve denetim uygulamanız gerekir. Verinin farklı konumlara dağıtıldığı hibrit ve çoklu bulut ortamlarında bu özellikle zorlayıcı olabilir.
3. Maliyet-performans ödünleşimleri
Bir lakehouse uygularken maliyet etkinliği ile performans arasında doğru dengeyi bulmak zor olabilir. Lakehouse’lar uygun maliyetli depolama sunsa da yüksek performanslı analitiğe ulaşmak, işlem kaynaklarına ek yatırım gerektirebilir.
İş yükü gereksinimlerini dikkatle değerlendirmeniz ve performans ihtiyaçlarınızı en uygun maliyetle karşılamanın yolunu belirlemeniz gerekir. Bu, kaynak tahsisini optimize etmeyi, doğru bulut hizmetlerini seçmeyi veya hem maliyet hem de performans hedeflerinin karşılandığından emin olmak için lakehouse yapılandırmasını ayarlamayı içerebilir.
Sonuç
Veri lakehouse’lar, veri göllerinin ve veri ambarlarının güçlü yönlerini tek ve birleşik bir platformda bir araya getirerek veri mimarisinde önemli bir evrimi temsil eder!
Şema zorlaması, ACID işlemleri desteği, ölçeklenebilirlik ve gerçek zamanlı veri işleme ile veri lakehouse’lar modern veri ihtiyaçları için güçlü bir çözüm sunar.
Veri lakehouse’lar, veri ortamını sadeleştirmek ve analitik yeteneklerini geliştirmek isteyen veri ekipleri için etkileyici bir seçenektir.
Veri lakehouse’lar ve diğer gelişen veri mühendisliği teknolojileri hakkında daha fazla bilgi edinmek için ücretsiz Understanding Data Engineering kursunu keşfedin.
SSS
Veri lakehouse’lar neden popüler hale geliyor?
Veri lakehouse’lar, ölçeklenebilirliği sağlam analitikle birleştirerek esneklik, yüksek performans ve gerçek zamanlı veri içgörüleri arayan şirketler için maliyet etkin bir çözüm sunar.
Veri lakehouse’ların, geleneksel veri mimarilerine kıyasla karşılaştığı zorluklar nelerdir?
Veri lakehouse’ların, yapılandırılmış ve yapılandırılmamış veri için performansı dengelemesi gerekir; bu da karmaşık olabilir. Farklı veri türlerinde yönetişim ve güvenliği uygulamak ve eski sistemlerle entegrasyon da zorluklar yaratır.
Bir veri lakehouse, meta veri yönetimini nasıl ele alır?
Veri lakehouse’lar, (Delta Lake’in meta veri işleme özellikleri gibi) meta veri katmanları kullanarak veriyi düzenler, şemaları uygular ve sorguları optimize eder; böylece veri keşfi, yönetişim ve performans iyileşir.
Veri lakehouse’lar hem veri göllerinin hem de veri ambarlarının yerini alabilir mi?
Lakehouse’lar çoğu zaman veri göllerini ve veri ambarlarını değiştirebilse de bazı özel kullanım durumları hâlâ özel sistemler gerektirebilir. Çoğu ihtiyaç için lakehouse’lar birleşik ve esnek bir çözüm sunar.
Veri lakehouse’lar veri sürümlemesini nasıl destekler?
Delta Lake ve Apache Hudi gibi teknolojiler, kullanıcıların değişiklikleri izlemesini, geri almalar yapmasını ve zaman içinde veri tutarlılığını sağlamasını mümkün kılan veri sürümlemesini destekler.
Veri lakehouse’lar veri demokratikleşmesinde nasıl bir rol oynar?
Lakehouse’lar, tüm verinin erişilebilir ve yönetilen olduğu tek bir platform sunarak veri demokratikleşmesini teşvik eder; daha geniş ekiplerin veriye güvenli şekilde erişmesini ve veriden yararlanmasını sağlar.


