
कोर्स
Introduction to Data Engineering
4 घंटा
130.1K
डेटा प्रबंधन में डेटा लेक और डेटा वेयरहाउस जैसी पारंपरिक आर्किटेक्चर की सीमाओं का समाधान करने के लिए नए समाधान उभरे हैं। यद्यपि दोनों आर्किटेक्चर डेटा स्टोरेज और एनालिटिक्स में महत्वपूर्ण रहे हैं, वे आधुनिक डेटा प्रोसेसिंग आवश्यकताओं को पूरा करने में चुनौतियाँ पेश कर सकते हैं।
स्केलेबल और लचीला होने के बावजूद, डेटा लेक अक्सर गवर्नेंस और प्रदर्शन संबंधी समस्याओं का सामना करते हैं। दूसरी ओर, डेटा वेयरहाउस एनालिटिक्स के लिए शक्तिशाली होने के बावजूद महंगे और कम लचीले होते हैं। डेटा लेकहाउस का उद्देश्य डेटा लेक और वेयरहाउस की ताकतों को मिलाकर, उनकी कमजोरियों को कम करते हुए, इन समस्याओं का समाधान करना है।
इस गाइड में, मैं बताऊँगा कि डेटा लेकहाउस क्या है, यह पारंपरिक डेटा आर्किटेक्चर से कैसे अलग है, और एकीकृत डेटा प्रबंधन समाधान की तलाश कर रहे डेटा प्रोफेशनल्स के बीच यह क्यों लोकप्रिय हो रहा है।
डेटा लेकहाउस एक ऐसा आर्किटेक्चर है जो डेटा लेक की स्केलेबिलिटी और कम लागत वाले स्टोरेज को डेटा वेयरहाउस के प्रदर्शन, विश्वसनीयता और गवर्नेंस क्षमताओं के साथ जोड़ता है।
दोनों आर्किटेक्चर की ताकतों को एकीकृत करके, डेटा लेकहाउस एक एकीकृत प्लेटफ़ॉर्म प्रदान करता है जो हर तरह के डेटा—स्ट्रक्चर्ड, सेमी-स्ट्रक्चर्ड और अनस्ट्रक्चर्ड—का स्टोरेज, प्रोसेसिंग और विश्लेषण करने में सक्षम है।
यह एकीकृत दृष्टिकोण डेटा प्रोसेसिंग में अधिक लचीलापन देता है और बिज़नेस इंटेलिजेंस से लेकर मशीन लर्निंग तक विभिन्न एनालिटिक्स उपयोग मामलों का समर्थन करता है।
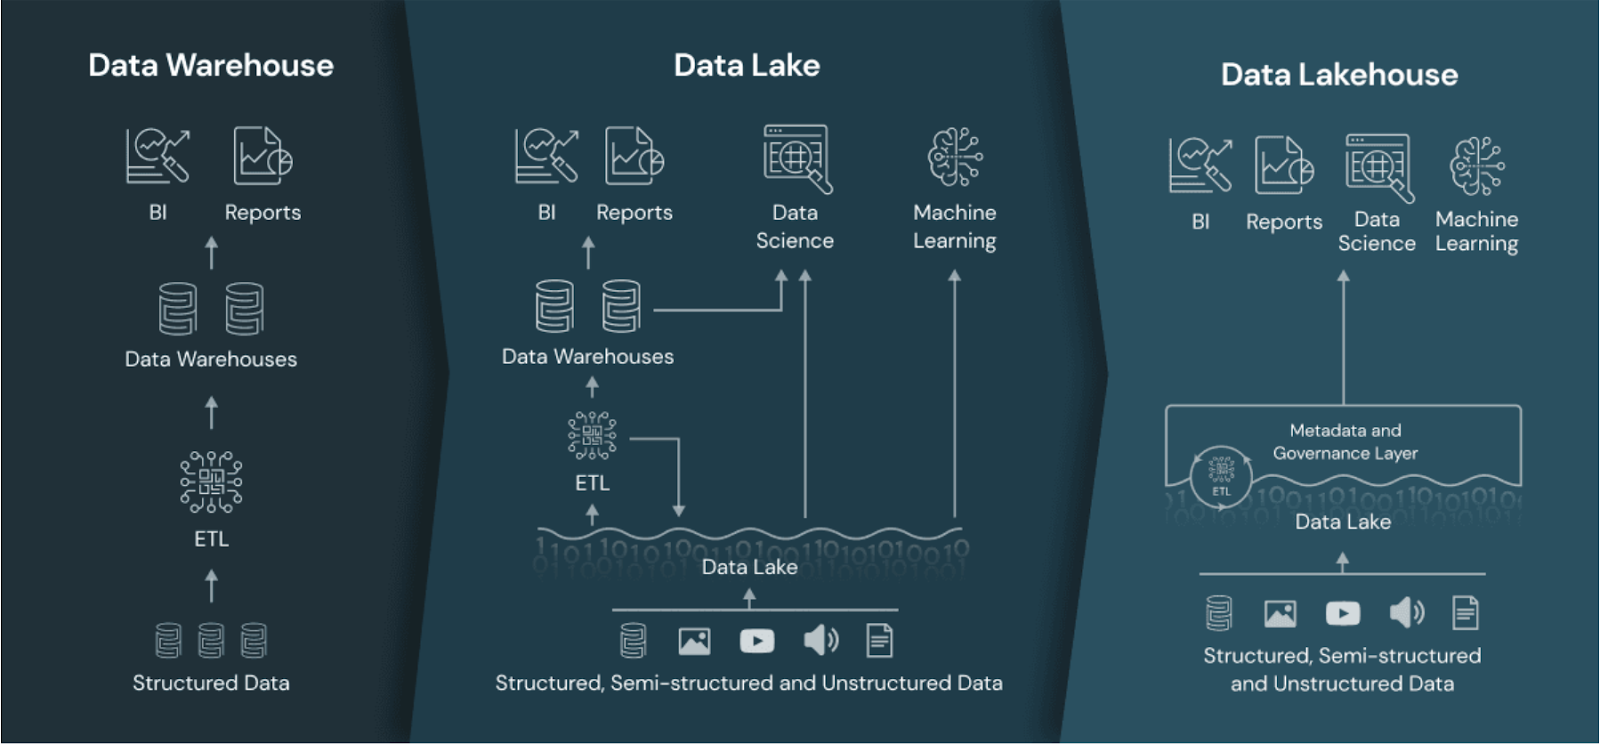
डेटा वेयरहाउस और डेटा लेक की तुलना में डेटा लेकहाउस। छवि स्रोत: Databricks.
डेटा लेकहाउस आर्किटेक्चर को विस्तार से समझने से पहले, यह जानना महत्वपूर्ण है कि यह डेटा वेयरहाउस और डेटा लेक से कैसे तुलना करता है।
डेटा वेयरहाउस स्ट्रक्चर्ड डेटा को स्टोर करने और उच्च-प्रदर्शन एनालिटिक्स व रिपोर्टिंग प्रदान करने के लिए बनाए जाते हैं।
इनकी सबसे बड़ी ताकतों में से एक तेज़ क्वेरी निष्पादन की क्षमता है, जो उन्हें बिज़नेस इंटेलिजेंस और रिपोर्टिंग उपयोग मामलों के लिए उपयुक्त बनाती है।
डेटा वेयरहाउस एक सुव्यवस्थित स्कीमा का उपयोग करते हैं जो मजबूत डेटा गवर्नेंस का समर्थन करता है। इससे डेटा सटीक, संगत और विश्लेषण के लिए आसानी से सुलभ रहता है।
हालाँकि, ये फायदे कीमत के साथ आते हैं। डेटा वेयरहाउस का रखरखाव आमतौर पर महंगा होता है क्योंकि वे विशेष हार्डवेयर और विस्तृत डेटा ट्रांसफ़ॉर्मेशन प्रक्रियाओं पर निर्भर करते हैं, जिनमें आमतौर पर ETL (extract, transform, load) पाइपलाइन्स की आवश्यकता होती है।
डेटा वेयरहाउस की कठोर संरचना उन्हें अनस्ट्रक्चर्ड डेटा को संभालने या डेटा फ़ॉर्मैट में तेज़ बदलावों के अनुरूप ढालने के लिए कम उपयुक्त बनाती है। यह लचीलापन की कमी उन संगठनों के लिए एक बड़ी सीमा हो सकती है जो तीव्रता से विकसित हो रहे डेटा स्रोतों या पूर्व-परिभाषित स्कीमा में फिट न होने वाले डेटा, जैसे टेक्स्ट, इमेज, ऑडियो आदि, के साथ काम करना चाहते हैं।
डेटा वेयरहाउसिंग की बुनियादी बातों के बारे में अधिक जानने के लिए, Introduction to Data Warehousing मुफ़्त कोर्स देखें।
डेटा लेक बड़े पैमाने पर सेमी-स्ट्रक्चर्ड या अनस्ट्रक्चर्ड डेटा को स्टोर करने के लिए बनाए जाते हैं। इनका प्रमुख लाभ स्केल करने की क्षमता है, जो विविध डेटा प्रकारों और विशाल डेटा वॉल्यूम से निपटने वाली टीमों के लिए इन्हें आकर्षक विकल्प बनाता है।
डेटा लेक की लचीलापन आपको रॉ डेटा को उसके मूल फ़ॉर्मैट में स्टोर करने देता है, जिससे वे डेटा एक्सप्लोरेशन और साइंस प्रोजेक्ट्स के लिए उपयुक्त बनते हैं।
हालाँकि, डेटा लेक अक्सर डेटा गवर्नेंस और डेटा गुणवत्ता के साथ जूझते हैं। चूँकि डेटा को बिना अधिक संरचना के रॉ रूप में स्टोर किया जाता है, लगातार डेटा गुणवत्ता सुनिश्चित करना चुनौतीपूर्ण हो सकता है।
गवर्नेंस की कमी अक्सर तथाकथित "डेटा स्वैम्प" की ओर ले जाती है, जहाँ मूल्यवान इनसाइट्स अव्यवस्थित डेटा के नीचे दब जाती हैं।
प्रदर्शन भी डेटा लेक में एक अहम चिंता है, खासकर जटिल विश्लेषणात्मक क्वेरीज चलाने के लिए। डेटा लेक तेज़ क्वेरींग या इमेज, टेक्स्ट और ऑडियो जैसे भिन्न डेटा प्रकारों को संयोजित करने के लिए अनुकूलित नहीं होते।
डेटा लेकहाउस का लक्ष्य डेटा लेक और डेटा वेयरहाउस की खूबियों को समाहित करना है। यह डेटा लेक की स्केलेबिलिटी और कम लागत वाले स्टोरेज को डेटा वेयरहाउस के प्रदर्शन और गवर्नेंस की ताकतों के साथ जोड़कर अधिक संतुलित समाधान प्रदान करता है।
सैद्धांतिक रूप से, लेकहाउस में आप स्ट्रक्चर्ड और अनस्ट्रक्चर्ड डेटा को कम लागत पर स्टोर कर सकते हैं, साथ ही उच्च-प्रदर्शन एनालिटिक्स के लिए आवश्यक क्षमताओं का लाभ उठा सकते हैं।
डेटा लेकहाउस ACID ट्रांज़ैक्शंस का समर्थन प्रदान करते हैं, यानी डेटा अपडेट्स और डिलीट्स को विश्वसनीय तरीके से प्रबंधित किया जा सकता है, जो पारंपरिक डेटा लेक में अक्सर नहीं होता। इससे बेहतर डेटा अखंडता और गवर्नेंस संभव होती है, जिससे डेटा लेकहाउस एंटरप्राइज़-ग्रेड अनुप्रयोगों के लिए अधिक उपयुक्त बनते हैं।
डेटा लेकहाउस रियल-टाइम डेटा प्रोसेसिंग का भी समर्थन करते हैं, जिससे संगठन स्ट्रीमिंग डेटा को संभाल सकें और रियल-टाइम इनसाइट्स प्राप्त कर सकें, जो कुछ परिस्थितियों में महत्वपूर्ण है।
एक ही प्लेटफ़ॉर्म में दोनों दुनियाओं की बेहतरीन बातें कैसे संभव हैं? इस खंड में, मैं वे घटक समझाऊँगा जो लेकहाउस आर्किटेक्चर को संभव बनाते हैं।
डेटा लेकहाउस में स्टोरेज और कंप्यूट अलग होते हैं लेकिन कड़े रूप से एकीकृत रहते हैं, जिससे संसाधनों का लचीला, स्केलेबल उपयोग संभव होता है।
डेटा किफायती क्लाउड ऑब्जेक्ट स्टोर में रखा जाता है, जबकि कंप्यूट संसाधनों को वर्कलोड की मांग के अनुसार स्वतंत्र रूप से स्केल किया जा सकता है। यह दृष्टिकोण प्रणालियों के बीच डेटा स्थानांतरित करने की आवश्यकता को कम करता है, जिससे उपयोगकर्ता व्यापक एक्सट्रैक्शन और लोडिंग के बिना इन्हीं स्थानों पर डेटा प्रोसेस कर सकते हैं।
इस तरह स्टोरेज और कंप्यूट को एकीकृत करने से डेटा लेकहाउस डेटा प्रबंधन को सुव्यवस्थित करते हैं, दक्षता में सुधार लाते हैं और लेटेंसी कम करते हैं, जिससे तेज़ इनसाइट्स मिलती हैं।
डायनेमिक संसाधन आवंटन बेहतर लागत अनुकूलन को भी सक्षम करता है और सुनिश्चित करता है कि कंप्यूट संसाधन प्रभावी ढंग से उपयोग हों।
डेटा लेकहाउस डेटा गुणवत्ता बनाए रखने के लिए स्कीमा लागू करते हैं और अनुपालन हेतु गवर्नेंस सुविधाएँ प्रदान करते हैं।
स्कीमा प्रवर्तन सुनिश्चित करता है कि डेटा संरचित फ़ॉर्मैट में संगठित हो, जिससे क्वेरी और विश्लेषण करना आसान हो जाता है। यह डेटा असंगतियों को रोकने में मदद करता है और पूरे संगठन में बेहतर डेटा गुणवत्ता का समर्थन करता है।
डेटा लेकहाउस में गवर्नेंस सुविधाएँ डेटा ऐक्सेस, लीनिएज और अनुपालन प्रबंधित करने में सक्षम बनाती हैं। बिल्ट-इन गवर्नेंस टूल्स के साथ, डेटा लेकहाउस नियामक आवश्यकताओं का समर्थन कर सकते हैं और संवेदनशील डेटा की सुरक्षा कर सकते हैं। यह विशेष रूप से हेल्थकेयर और वित्त जैसे उद्योगों के लिए महत्वपूर्ण है, जहाँ डेटा गोपनीयता और अनुपालन निर्णायक होते हैं।
ACID ट्रांज़ैक्शंस डेटा विश्वसनीयता सुनिश्चित करते हैं, जिससे आप अपडेट्स और डिलीट्स को भरोसे के साथ प्रबंधित कर सकते हैं।
डेटा लेकहाउस में ACID ट्रांज़ैक्शंस पारंपरिक डेटा वेयरहाउस से अपेक्षित डेटा अखंडता का वही स्तर प्रदान करते हैं, साथ ही अनस्ट्रक्चर्ड डेटा को संभालने की अतिरिक्त लचीलापन भी देते हैं।
ACID ट्रांज़ैक्शंस के समर्थन का अर्थ है कि डेटा लेकहाउस मिशन-क्रिटिकल वर्कलोड्स के लिए उपयोग किए जा सकते हैं, जहाँ डेटा शुद्धता आवश्यक है। यह फ़ीचर उन एंटरप्राइज़ के लिए डेटा लेकहाउस को आकर्षक बनाता है जिन्हें विभिन्न डेटा ऑपरेशंस में डेटा सुसंगतता बनाए रखनी होती है।
डेटा लेकहाउस रियल-टाइम में डेटा प्रोसेस कर सकते हैं, जिससे रियल-टाइम एनालिटिक्स और स्ट्रीमिंग इनसाइट्स जैसे उपयोग मामलों को सक्षम किया जा सकता है। रियल-टाइम डेटा प्रोसेसिंग टीमों को तेज़ी से डेटा-आधारित निर्णय लेने में सक्षम बनाती है, जिससे प्रत्युत्तर क्षमता और अनुकूलनशीलता में सुधार होता है।
उदाहरण के लिए, रियल-टाइम डेटा प्रोसेसिंग का उपयोग ग्राहक इंटरैक्शन की निगरानी, इन्वेंटरी स्तरों को ट्रैक करने या वित्तीय लेनदेन में विसंगतियों का पता लगाने के लिए किया जा सकता है। तत्काल इनसाइट्स सक्षम करके, डेटा लेकहाउस आपको बदलती बाज़ार स्थितियों से आगे रहने और नए अवसरों पर सक्रिय रूप से प्रतिक्रिया देने में मदद करते हैं।
डेटा लेकहाउस मल्टी-क्लाउड या हाइब्रिड परिवेश में काम कर सकते हैं, जो लचीलापन और स्केलेबिलिटी प्रदान करते हैं।
मल्टी-क्लाउड समर्थन डेटा टीमों को वेंडर लॉक-इन से बचने और अलग-अलग क्लाउड प्रदाताओं की सर्वश्रेष्ठ सेवाओं का लाभ उठाने में सक्षम बनाता है। हाइब्रिड आर्किटेक्चर समर्थन यह सुनिश्चित करता है कि ऑन-प्रिमाइसेस सिस्टम क्लाउड परिवेश के साथ एकीकृत हों, जिससे एकीकृत डेटा प्रबंधन अनुभव मिलता है।
यह लचीलापन विशेष रूप से जटिल इन्फ्रास्ट्रक्चर आवश्यकताओं वाली टीमों या क्लाउड माइग्रेशन से गुजर रही टीमों के लिए लाभकारी है।
इस खंड में, हम विविध डेटा प्रोसेसिंग आवश्यकताओं के प्रबंधन के लिए डेटा लेकहाउस का उपयोग करने के लाभों पर चर्चा करेंगे।
डेटा लेकहाउस डेटा लेक की स्केलेबिलिटी को विरासत में लेते हैं, जिससे वे बढ़ती डेटा आवश्यकताओं को संभालने में सक्षम होते हैं। आप स्टोरेज सीमाओं की चिंता किए बिना आसानी से अधिक डेटा जोड़ सकते हैं, यह सुनिश्चित करते हुए कि आपकी डेटा आर्किटेक्चर व्यवसाय के साथ-साथ बढ़े।
उदाहरण के लिए, Apache Hudi, Delta Lake, और Apache Iceberg Amazon S3, Azure Blob Storage, या Google Cloud Storage जैसे ऑब्जेक्ट स्टोरेज सिस्टम में हज़ारों फ़ाइलों में स्टोरेज को स्केल कर सकते हैं।
लचीलापन एक और बड़ा लाभ है, क्योंकि डेटा लेकहाउस स्ट्रक्चर्ड (जैसे लेनदेन रिकॉर्ड) और अनस्ट्रक्चर्ड डेटा (जैसे लॉग फ़ाइलें, इमेज और वीडियो) का समर्थन करते हैं। इसका अर्थ है कि आप अपने सभी डेटा को एक ही स्थान पर रख सकते हैं, फ़ॉर्मैट चाहे जो भी हो, और इसे विभिन्न एनालिटिक्स और मशीन लर्निंग उपयोग मामलों के लिए इस्तेमाल कर सकते हैं।
डेटा लेकहाउस डेटा वेयरहाउस की तुलना में कम लागत पर डेटा स्टोर करते हैं, जबकि उन्नत एनालिटिक्स का समर्थन जारी रखते हैं।
उदाहरण के लिए, क्लाउड ऑब्जेक्ट स्टोरेज (जैसे Amazon S3 या Google Cloud Storage) पर बने डेटा लेकहाउस उनके किफायती स्टोरेज टियर का लाभ उठाते हैं। Apache Parquet और ORC फ़ाइल फ़ॉर्मैट्स के साथ—जो डेटा को कंप्रेस करके स्टोरेज लागत कम करते हैं—डेटा लेकहाउस आपको महत्वपूर्ण बचत दिलाते हैं।
डेटा लेकहाउस की एकीकृत प्रकृति का अर्थ है कि स्टोरेज और एनालिटिक्स के लिए अलग-अलग सिस्टम बनाए रखने की आवश्यकता नहीं होती, जिससे लागत दक्षता मिलती है और डेटा लेकहाउस आकर्षक विकल्प बनते हैं।
एकीकृत डेटा स्टोरेज और प्रोसेसिंग क्षमताएँ इनसाइट्स निकालने में लगने वाला समय कम करती हैं। डेटा लेकहाउस स्टोरेज और कंप्यूट परिवेशों के बीच डेटा स्थानांतरित करने की आवश्यकता समाप्त कर देते हैं, जिससे वर्कफ़्लो सुगम होते हैं और लेटेंसी घटती है।
Apache Spark और Databricks जैसी तकनीकें डेटा को सीधे लेकहाउस के भीतर प्रोसेस करने देती हैं, इसे अलग एनालिटिक्स परिवेश में ले जाने की आवश्यकता समाप्त करती हैं।
सारा डेटा एक ही स्थान पर होने और उसे कुशलतापूर्वक प्रोसेस करने से, आप तेज़ी से ऐसी इनसाइट्स उत्पन्न कर सकते हैं जो बेहतर फैसले लेने में मदद करें। यह तेज़ समय-से-इनसाइट विशेष रूप से उन उद्योगों में मूल्यवान है, जहाँ समय पर सूचना निर्णायक होती है, जैसे वित्त, रिटेल और हेल्थकेयर।
स्कीमा प्रवर्तन और डेटा गवर्नेंस फ़ीचर्स डेटा गुणवत्ता और अनुपालन मानकों को पूरा करते हैं। डेटा लेकहाउस डेटा ऐक्सेस, ऑडिट ट्रेल्स और डेटा लीनिएज प्रबंधित करने के उपकरण प्रदान करते हैं, जो डेटा अखंडता बनाए रखने और नियामक आवश्यकताओं को पूरा करने के लिए आवश्यक हैं।
AWS Lake Formation, Azure Purview और Apache Ranger जैसे टूल्स डेटा ऐक्सेस, अनुमतियों और ऑडिट ट्रेल्स पर केंद्रीकृत नियंत्रण प्रदान करते हैं, जिससे आप डेटा को सुरक्षित रूप से प्रबंधित कर सकें और अनधिकृत ऐक्सेस रोक सकें
ये गवर्नेंस और सुरक्षा सुविधाएँ डेटा लेकहाउस को उन एंटरप्राइज़ के लिए उपयुक्त बनाती हैं जिन्हें GDPR या HIPAA जैसे डेटा गोपनीयता विनियमों का पालन करना होता है। यह सुनिश्चित करके कि डेटा सही ढंग से प्रबंधित और संरक्षित है, डेटा लेकहाउस डेटा और उससे निकली इनसाइट्स में भरोसा बनाने में मदद करते हैं।
इस खंड में, आइए डेटा लेकहाउस के सभी संभावित उपयोग मामलों की समीक्षा करें।
डेटा टीमें रियल-टाइम एनालिटिक्स, बिज़नेस इंटेलिजेंस और मशीन लर्निंग वर्कफ़्लोज़ के लिए डेटा लेकहाउस का उपयोग करती हैं। एकीकृत डेटा प्लेटफ़ॉर्म प्रदान करके, डेटा लेकहाउस प्रोफेशनल्स को ऐतिहासिक और रियल-टाइम डेटा का विश्लेषण करने में सक्षम बनाते हैं, जिससे बेहतर व्यावसायिक परिणामों को बढ़ावा देने वाली इनसाइट्स मिलती हैं।
उदाहरण के लिए, रिटेलर रियल-टाइम में बिक्री डेटा का विश्लेषण करने, रुझान पहचानने और तदनुसार अपनी इन्वेंटरी समायोजित करने के लिए डेटा लेकहाउस का उपयोग कर सकते हैं। वित्तीय संस्थान जोखिम विश्लेषण और धोखाधड़ी का पता लगाने के लिए डेटा लेकहाउस का लाभ उठा सकते हैं, जिसके लिए ऐतिहासिक और रियल-टाइम लेनदेन डेटा को मिलाकर समग्र दृष्टि प्राप्त की जाती है।
आधुनिक डेटा प्लेटफ़ॉर्म इन्गेस्टन और सर्विंग से लेकर गवर्नेंस और ऑर्केस्ट्रेशन तक कैसे काम करते हैं, यह जानने के लिए मुफ़्त Understanding Modern Data Architecture कोर्स देखें।
डेटा लेकहाउस स्ट्रक्चर्ड और अनस्ट्रक्चर्ड डेटा तक आसान पहुँच के साथ AI और ML मॉडल बनाने और स्केल करने के लिए इन्फ्रास्ट्रक्चर प्रदान करते हैं। मशीन लर्निंग मॉडल अक्सर विभिन्न प्रकार के डेटा की आवश्यकता रखते हैं, और डेटा लेकहाउस सभी प्रासंगिक डेटा को एक जगह लाना संभव बनाते हैं।
यह एकीकृत डेटा एक्सेस मशीन लर्निंग मॉडलों के ट्रेनिंग, टेस्टिंग और डिप्लॉयमेंट की प्रक्रिया को सरल बनाता है। डेटा साइंटिस्ट्स अलग-अलग डेटासेट्स के साथ शीघ्र प्रयोग कर सकते हैं, मॉडलों पर इटरेशन कर सकते हैं और उन्हें प्रोडक्शन के लिए स्केल कर सकते हैं, बिना डेटा साइलोज़ या सिस्टमों के बीच मूवमेंट की चिंता किए।
डेटा लेकहाउस ऐसे डेटा-चालित अनुप्रयोगों को शक्ति देते हैं जिन्हें रियल-टाइम इनसाइट्स और निर्णय लेने की क्षमताओं की आवश्यकता होती है। ये अनुप्रयोग अक्सर उपयोगकर्ताओं को वैयक्तिकृत अनुभव या स्वचालित सिफ़ारिशें देने के लिए अद्यतन जानकारी पर निर्भर करते हैं।
उदाहरण के लिए, किसी ई-कॉमर्स साइट का सिफ़ारिश इंजन रियल-टाइम में उपयोगकर्ता व्यवहार का विश्लेषण करने और प्रासंगिक उत्पाद सुझाव देने के लिए डेटा लेकहाउस का उपयोग कर सकता है। इसी तरह, लॉजिस्टिक्स कंपनियाँ रियल-टाइम ट्रैफ़िक डेटा और ऐतिहासिक डिलीवरी पैटर्न के आधार पर डिलीवरी मार्गों का अनुकूलन करने के लिए डेटा लेकहाउस का उपयोग कर सकती हैं।
अब समय है उन तकनीकों के बारे में जानने का जो डेटा लेकहाउस आर्किटेक्चर को संभव बनाती हैं। इस खंड में, मैं सबसे लोकप्रिय विकल्पों की व्याख्या करूँगा।
Databricks ने डेटा लेकहाउस आर्किटेक्चर का मार्ग प्रशस्त किया है और अपने प्लेटफ़ॉर्म के मुख्य घटक के रूप में Delta Lake प्रदान करता है। Delta Lake डेटा लेक में विश्वसनीयता और प्रदर्शन सुधार जोड़ता है, ACID ट्रांज़ैक्शंस सक्षम करता है और डेटा गुणवत्ता सुनिश्चित करता है।
Databricks Lakehouse डेटा लेक की स्केलेबिलिटी को डेटा वेयरहाउस की डेटा प्रबंधन विशेषताओं के साथ जोड़ता है, एनालिटिक्स और मशीन लर्निंग के लिए एकीकृत प्लेटफ़ॉर्म प्रदान करता है। Apache Spark के साथ इसका एकीकरण उन संगठनों के लिए इसे आकर्षक विकल्प बनाता है जो बिग डेटा प्रोसेसिंग क्षमताओं का लाभ उठाना चाहते हैं।
यदि आप Databricks Lakehouse प्लेटफ़ॉर्म के बारे में जानना चाहते हैं और यह कैसे डेटा आर्किटेक्चर को आधुनिक बना सकता है और डेटा प्रबंधन प्रक्रियाओं में सुधार कर सकता है, तो मुफ़्त Introduction to Databricks कोर्स देखें।
Google का BigLake अपने मौजूदा क्लाउड इकोसिस्टम के साथ डेटा लेकहाउस सिद्धांतों को एकीकृत करता है, एक एकीकृत डेटा स्टोरेज और एनालिटिक्स प्लेटफ़ॉर्म प्रदान करता है। BigLake उपयोगकर्ताओं को स्ट्रक्चर्ड और अनस्ट्रक्चर्ड दोनों डेटा प्रबंधित करने देता है, जिससे अलग-अलग डेटा प्रकारों पर एनालिटिक्स करना आसान हो जाता है।
Google Cloud सेवाओं के साथ एकीकरण के साथ, BigLake डेटा टीमों को उनकी डेटा आवश्यकताओं के लिए क्लाउड-नेटिव टूल्स का उपयोग करने हेतु एक व्यापक समाधान प्रदान करता है। यह बैच और रियल-टाइम दोनों प्रोसेसिंग का समर्थन करता है, जिससे यह व्यापक उपयोग मामलों के लिए उपयुक्त बनता है।
AWS Lake Formation AWS की क्लाउड सेवाओं का उपयोग करके डेटा लेकहाउस स्थापित करने के उपकरण प्रदान करता है, जो निर्बाध एकीकरण और प्रबंधन देता है। AWS Lake Formation के साथ, आप आसानी से डेटा इन्गेस्ट, कैटलॉग और सुरक्षित करके एक एकीकृत डेटा लेकहाउस बना सकते हैं।
AWS Lake Formation अन्य AWS एनालिटिक्स सेवाओं, जैसे Amazon Redshift और AWS Glue, के साथ भी एकीकृत होता है, डेटा प्रोसेसिंग और एनालिटिक्स के लिए टूल्स का पूरा सूट प्रदान करता है। इससे यह उन संगठनों के लिए आकर्षक विकल्प बनता है जो पहले से ही अपने इन्फ्रास्ट्रक्चर के लिए AWS का उपयोग कर रहे हैं।
Snowflake की आर्किटेक्चर डेटा लेकहाउस क्षमताओं का समर्थन करने की दिशा में विकसित हो रही है, जिससे उपयोगकर्ता स्ट्रक्चर्ड और सेमी-स्ट्रक्चर्ड डेटा को दक्षता से प्रबंधित कर सकें। Snowflake उच्च-प्रदर्शन एनालिटिक्स प्रदान करता है, साथ ही डेटा स्टोरेज और प्रबंधन में लचीलापन भी देता है।
Snowflake की डेटा लेकहाउस विशेषताएँ आपको अलग-अलग डेटा प्रकारों को जोड़ने और उन्नत एनालिटिक्स करने की अनुमति देती हैं, बिना कई सिस्टमों की ज़रूरत के। इसका क्लाउड-नेटिव डिज़ाइन और मल्टी-क्लाउड डिप्लॉयमेंट्स का समर्थन उन टीमों के लिए इसे लोकप्रिय विकल्प बनाता है जो अपनी डेटा इन्फ्रास्ट्रक्चर को आधुनिक बनाना चाहती हैं।
यदि आप Snowflake में रुचि रखते हैं, तो Introduction to Snowflake कोर्स देखें।
Microsoft का Azure Synapse Analytics बिग डेटा और डेटा वेयरहाउसिंग क्षमताओं को एकीकृत डेटा लेकहाउस समाधान में जोड़ता है।
Synapse टीमों को SQL, Apache Spark और Data Explorer सहित विभिन्न टूल्स का उपयोग करके स्ट्रक्चर्ड और अनस्ट्रक्चर्ड दोनों डेटा का विश्लेषण करने में सक्षम बनाता है। Azure Data Lake Storage और Power BI जैसी अन्य Azure सेवाओं के साथ इसका गहरा एकीकरण एंड-टू-एंड डेटा प्रोसेसिंग, एनालिटिक्स और विज़ुअलाइज़ेशन के लिए निर्बाध अनुभव प्रदान करता है, जो Azure इकोसिस्टम के भीतर संगठनों के लिए इसे आदर्श विकल्प बनाता है।
Apache Hudi एक ओपन-सोर्स प्रोजेक्ट है जो डेटा लेक में ट्रांज़ैक्शनल क्षमताएँ लाता है। यह ACID ट्रांज़ैक्शंस, अपसर्ट्स और डेटा वर्ज़निंग का समर्थन करता है।
Hudi Amazon S3 और Google Cloud Storage जैसे क्लाउड स्टोरेज प्लेटफ़ॉर्म्स के साथ अच्छी तरह एकीकृत होता है, जिससे यह रियल-टाइम एनालिटिक्स और मशीन लर्निंग पाइपलाइन्स के लिए उपयुक्त बनता है। Apache Spark और Presto जैसे लोकप्रिय बिग डेटा इंजनों के समर्थन के साथ, Hudi ओपन-सोर्स टेक्नोलॉजी पर कस्टम डेटा लेकहाउस बनाने के लिए लचीलापन प्रदान करता है।
Dremio क्लाउड डेटा लेक्स पर सीधे तेज़ एनालिटिक्स और BI वर्कलोड्स के लिए एक ओपन डेटा लेकहाउस प्लेटफ़ॉर्म प्रदान करता है।
अपने SQL-आधारित दृष्टिकोण और Apache Arrow के साथ एकीकरण के साथ, Dremio टीमों को बिना डेटा मूवमेंट के उच्च-प्रदर्शन एनालिटिक्स करने देता है। यह उन संगठनों के लिए विशेष रूप से लाभकारी है जो अपने डेटा लेक्स पर SQL-आधारित क्वेरीज़ का समर्थन करना चाहते हैं, जिससे यह गति और दक्षता को प्राथमिकता देने वाली डेटा टीमों के लिए लोकप्रिय विकल्प बनता है।
जैसा कि आप कल्पना कर सकते हैं, डेटा लेकहाउस आर्किटेक्चर का समर्थन करने वाली सभी तकनीकें समान नहीं होतीं। निम्न तालिका कई श्रेणियों में उनकी तुलना करती है:
|
प्लेटफ़ॉर्म |
प्राथमिक स्टोरेज प्रकार |
स्ट्रक्चर्ड और अनस्ट्रक्चर्ड डेटा का समर्थन |
कंप्यूट इंजन |
ACID ट्रांज़ैक्शंस |
रियल-टाइम प्रोसेसिंग |
ML/AI के साथ एकीकरण |
आदर्श उपयोग मामला |
|
Databricks Lakehouse |
Delta Lake (Apache Parquet) |
हाँ |
Apache Spark |
हाँ |
हाँ |
मज़बूत (MLflow, Spark ML) |
बिग डेटा एनालिटिक्स, AI/ML |
|
Google BigLake |
Google Cloud Storage |
हाँ |
Google BigQuery |
हाँ |
हाँ |
Google Cloud AI के साथ एकीकृत |
क्लाउड-नेटिव एनालिटिक्स |
|
AWS Lake Formation |
Amazon S3 |
हाँ |
Amazon Redshift / AWS Glue |
हाँ |
सीमित |
Amazon SageMaker एकीकरण |
AWS-केंद्रित डेटा लेकहाउस |
|
Snowflake |
स्वामित्व (क्लाउड-आधारित) |
मुख्यतः स्ट्रक्चर्ड |
Snowflake Compute |
हाँ |
सीमित |
सीमित |
मल्टी-क्लाउड, उच्च-प्रदर्शन एनालिटिक्स |
|
Azure Synapse Analytics |
Azure Data Lake Storage |
हाँ |
SQL, Apache Spark, Data Explorer |
हाँ |
हाँ |
मज़बूत (Azure ML, Power BI) |
Microsoft इकोसिस्टम एनालिटिक्स |
|
Apache Hudi |
क्लाउड ऑब्जेक्ट स्टोरेज (जैसे, S3, GCS) |
हाँ |
Apache Spark, Presto |
हाँ |
हाँ |
बाहरी ML समर्थन |
ओपन-सोर्स रियल-टाइम डेटा लेक्स |
|
Dremio |
क्लाउड डेटा लेक्स |
हाँ |
Dremio (Apache Arrow) |
नहीं |
हाँ |
कोई नेटिव एकीकरण नहीं |
क्लाउड लेक्स पर उच्च-प्रदर्शन SQL |
कुछ चीज़ें बहुत अच्छी लगती हैं, और डेटा लेकहाउस भी इसका अपवाद नहीं। यह सब कुछ देता हुआ प्रतीत होता है, लेकिन इसके कुछ नकारात्मक पहलू भी हैं। आइए इस खंड में उनकी समीक्षा करें।
लेगेसी सिस्टम्स के साथ डेटा लेकहाउस का एकीकरण जटिल हो सकता है और सावधानीपूर्वक योजना की आवश्यकता होती है। टीमों को मौजूदा डेटा लेक या वेयरहाउस से डेटा माइग्रेट करना पड़ सकता है, जो समय लेने वाला और संसाधन-गहन हो सकता है।
पुराने सिस्टमों के साथ एकीकरण के दौरान संगतता समस्याएँ भी उत्पन्न हो सकती हैं, जो आधुनिक डेटा आर्किटेक्चर के साथ काम करने के लिए डिज़ाइन नहीं किए गए हैं। डेटा लेकहाउस को सफलतापूर्वक लागू करने के लिए, आपको अपने मौजूदा इन्फ्रास्ट्रक्चर का मूल्यांकन करना होगा, डेटा माइग्रेशन की योजना बनानी होगी, और सुनिश्चित करना होगा कि सभी सिस्टम मिलकर सामंजस्य से काम कर सकें।
स्केलेबिलिटी को गवर्नेंस और सुरक्षा के साथ संतुलित करना चुनौतीपूर्ण हो सकता है, खासकर विनियमित उद्योगों में। डेटा लेकहाउस को डेटा ऐक्सेस, लीनिएज और अनुपालन प्रबंधित करने के लिए मजबूत गवर्नेंस टूल्स प्रदान करने चाहिए, साथ ही बड़े डेटासेट्स को संभालने के लिए आवश्यक स्केलेबिलिटी भी बनाए रखनी चाहिए।
एक और महत्वपूर्ण विचार यह सुनिश्चित करना है कि संवेदनशील डेटा उचित रूप से सुरक्षित हो। आपको अपने डेटा की सुरक्षा और नियामक आवश्यकताओं को पूरा करने के लिए ऐक्सेस कंट्रोल, एन्क्रिप्शन और ऑडिटिंग लागू करनी होंगी। यह हाइब्रिड और मल्टी-क्लाउड परिवेश में विशेष रूप से चुनौतीपूर्ण हो सकता है, जहाँ डेटा अलग-अलग स्थानों में वितरित होता है।
डेटा लेकहाउस लागू करते समय, लागत दक्षता और प्रदर्शन के बीच सही संतुलन खोजना चुनौतीपूर्ण हो सकता है। यद्यपि डेटा लेकहाउस किफायती स्टोरेज प्रदान करते हैं, उच्च-प्रदर्शन एनालिटिक्स हासिल करने के लिए कंप्यूट संसाधनों में अतिरिक्त निवेश की आवश्यकता हो सकती है।
आपको वर्कलोड आवश्यकताओं का सावधानीपूर्वक मूल्यांकन करना होगा और अपनी प्रदर्शन आवश्यकताओं को पूरा करने का सबसे किफायती तरीका निर्धारित करना होगा। इसमें संसाधन आवंटन का अनुकूलन, सही क्लाउड सेवाओं का चुनाव, या डेटा लेकहाउस के कॉन्फ़िगरेशन में समायोजन शामिल हो सकता है ताकि लागत और प्रदर्शन दोनों लक्ष्य पूरे हों।
डेटा लेकहाउस डेटा आर्किटेक्चर में एक महत्वपूर्ण विकास का प्रतिनिधित्व करते हैं, जो डेटा लेक और डेटा वेयरहाउस की ताकतों को एक एकीकृत प्लेटफ़ॉर्म में समेटते हैं!
स्कीमा प्रवर्तन, ACID ट्रांज़ैक्शंस का समर्थन, स्केलेबिलिटी और रियल-टाइम डेटा प्रोसेसिंग के साथ, डेटा लेकहाउस आधुनिक डेटा आवश्यकताओं के लिए एक शक्तिशाली समाधान प्रदान करते हैं।
डेटा लेकहाउस उन डेटा टीमों के लिए एक प्रभावशाली विकल्प प्रदान करते हैं जो अपने डेटा परिदृश्य को सरल बनाना और एनालिटिक्स क्षमताओं में सुधार करना चाहती हैं।
डेटा लेकहाउस और अन्य उभरती डेटा इंजीनियरिंग तकनीकों के बारे में अधिक जानने के लिए Understanding Data Engineering मुफ़्त कोर्स देखें।
डेटा लेकहाउस स्केलेबिलिटी को मज़बूत एनालिटिक्स के साथ जोड़ते हैं, जिससे वे लचीलापन, उच्च प्रदर्शन और रियल-टाइम डेटा इनसाइट्स चाहने वाली कंपनियों के लिए किफायती बनते हैं।
डेटा लेकहाउस को स्ट्रक्चर्ड और अनस्ट्रक्चर्ड डेटा दोनों के लिए प्रदर्शन संतुलित करना पड़ता है, जो जटिल हो सकता है। विविध डेटा प्रकारों में गवर्नेंस और सुरक्षा लागू करना, तथा लेगेसी सिस्टम्स के साथ एकीकरण भी चुनौतियाँ प्रस्तुत करते हैं।
डेटा लेकहाउस मेटाडेटा लेयर्स (जैसे Delta Lake की मेटाडेटा हैंडलिंग) का उपयोग करके संगठन, स्कीमा प्रवर्तन और क्वेरी अनुकूलन करते हैं, जिससे डेटा डिस्कवरी, गवर्नेंस और प्रदर्शन में सुधार होता है।
हालाँकि लेकहाउस अक्सर डेटा लेक और वेयरहाउस दोनों को बदल सकते हैं, कुछ विशिष्ट उपयोग मामलों में अभी भी समर्पित सिस्टमों की आवश्यकता हो सकती है। अधिकांश आवश्यकताओं के लिए, लेकहाउस एक एकीकृत, लचीला समाधान प्रदान करते हैं।
Delta Lake और Apache Hudi जैसी तकनीकें डेटा वर्ज़निंग सक्षम करती हैं, जिससे उपयोगकर्ता बदलाव ट्रैक कर सकें, रोलबैक कर सकें और समय के साथ डेटा सुसंगतता सुनिश्चित कर सकें।
लेकहाउस एक ऐसा एकल प्लेटफ़ॉर्म उपलब्ध कराकर डेटा लोकतंत्रीकरण को बढ़ावा देते हैं जहाँ सारा डेटा सुलभ और गवर्न्ड होता है, जिससे व्यापक टीमें सुरक्षित रूप से डेटा तक पहुँचकर उसका लाभ उठा पाती हैं।
इन कोर्सेस के साथ डेटा इंजीनियरिंग के बारे में और जानें!
कोर्स
कोर्स
कोर्स