
Cursus
Introductie tot Data Engineering
4 uur
130.4K

Oefen en volg je voortgang.
Ga Verder Met GoogleIn datamanagement zijn nieuwe oplossingen ontstaan om de beperkingen van traditionele architecturen zoals data lakes en data warehouses aan te pakken. Hoewel beide architecturen essentieel zijn geweest voor dataopslag en -analyse, kunnen ze uitdagingen opleveren voor moderne dataverwerking.
Ondanks hun schaalbaarheid en flexibiliteit kampen data lakes vaak met governance- en prestatieproblemen. Data warehouses daarentegen zijn krachtig voor analytics, maar duur en minder flexibel. Het data lakehouse wil deze problemen oplossen door de sterke punten van data lakes en warehouses te combineren en tegelijk hun zwaktes te minimaliseren.
In deze gids leg ik uit wat een data lakehouse is, hoe het verschilt van traditionele dataarchitecturen en waarom het aan populariteit wint onder dataprofessionals die op zoek zijn naar een uniforme oplossing voor datamanagement.
Een data lakehouse is een architectuur die de schaalbaarheid en goedkope opslag van data lakes combineert met de prestaties, betrouwbaarheid en governancemogelijkheden van data warehouses.
Door de sterke punten van beide architecturen te integreren, biedt een data lakehouse een uniform platform voor het opslaan, verwerken en analyseren van alle soorten data—gestructureerd, semigestructureerd en ongestructureerd.
Deze uniforme aanpak zorgt voor meer flexibiliteit in dataverwerking en ondersteunt een breed scala aan analytics-use-cases, van business intelligence tot machine learning.
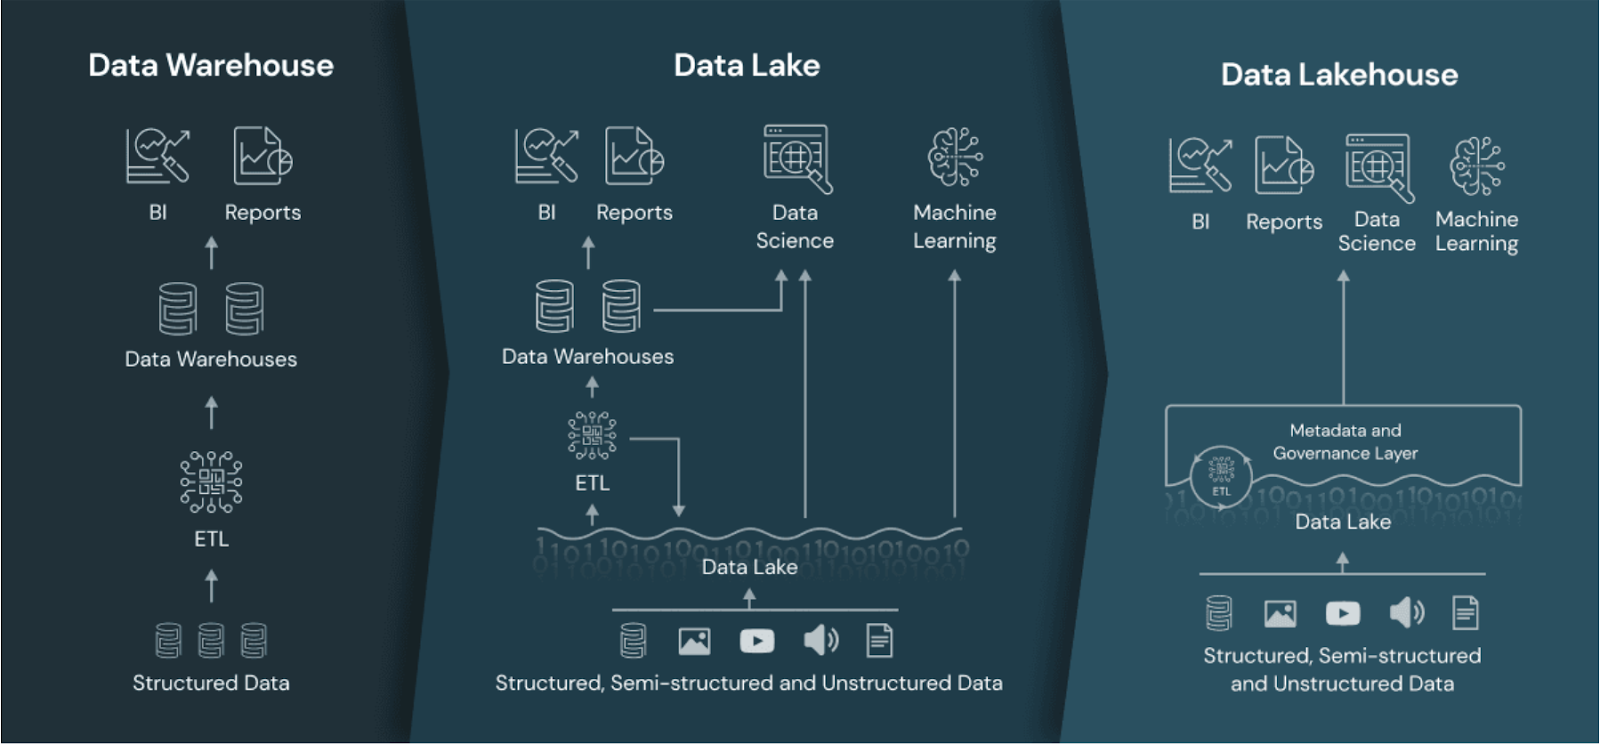
Het data lakehouse vergeleken met het data warehouse en data lake. Afbeeldingsbron: Databricks.
Voordat we de data-lakehousearchitectuur in detail verkennen, is het belangrijk te begrijpen hoe deze zich verhoudt tot data warehouses en data lakes.
Data warehouses zijn gebouwd om gestructureerde data op te slaan en analytics en rapportages met hoge prestaties te leveren.
Een van hun grootste sterke punten is het uitvoeren van snelle queries, waardoor ze zeer geschikt zijn voor business intelligence en rapportages.
Data warehouses gebruiken een goed gedefinieerd schema dat sterke datagovernance ondersteunt. Dit zorgt ervoor dat data accuraat, consistent en gemakkelijk toegankelijk is voor analyse.
Deze voordelen hebben echter een prijs. Data warehouses zijn doorgaans duur in onderhoud omdat ze afhankelijk zijn van gespecialiseerde hardware en uitgebreide datatransformatieprocessen, meestal via ETL-pijplijnen (extract, transform, load).
De rigide structuur van data warehouses maakt ze ook minder geschikt voor het verwerken van ongestructureerde data of voor het snel aanpassen aan wijzigingen in dataformaten. Dit gebrek aan flexibiliteit kan een aanzienlijke beperking zijn voor organisaties die willen werken met snel evoluerende databronnen of data die niet aan een vooraf gedefinieerd schema voldoet, zoals tekst, afbeeldingen, audio, enz.
Wil je meer leren over de basis van datawarehousing? Bekijk dan de gratis cursus Introduction to Data Warehousing.
Data lakes zijn ontworpen om grote hoeveelheden semigestructureerde of ongestructureerde data op te slaan. Hun grootste voordeel is schaalbaarheid, waardoor ze aantrekkelijk zijn voor teams die met diverse datatypes en enorme volumes werken.
De flexibiliteit van data lakes stelt je in staat ruwe data in het oorspronkelijke formaat op te slaan, wat ze ideaal maakt voor data-exploratie en datascienceprojecten.
Toch hebben data lakes vaak moeite met datagovernance en datakwaliteit. Omdat data in ruwe vorm zonder veel structuur wordt opgeslagen, is het lastig om consistente kwaliteit te borgen.
Het gebrek aan governance kan leiden tot wat vaak een "data swamp" wordt genoemd, waar waardevolle inzichten verdrinken in slecht geordende data.
Prestaties zijn nog een belangrijk aandachtspunt, vooral voor complexe analytische queries. Data lakes zijn niet geoptimaliseerd voor snelle query’s of het combineren van verschillende datatypes, zoals beelden, tekst en audio.
Een data lakehouse wil het beste van data lakes en data warehouses combineren. Het biedt een meer gebalanceerde oplossing door de schaalbaarheid en goedkope opslag van data lakes te integreren met de prestaties en governance van data warehouses.
In theorie kun je in een lakehouse gestructureerde en ongestructureerde data tegen lagere kosten opslaan en toch profiteren van mogelijkheden voor analytics met hoge prestaties.
Data lakehouses bieden ondersteuning voor ACID-transacties, wat betekent dat updates en deletes betrouwbaar beheerd kunnen worden—iets wat in traditionele data lakes vaak ontbreekt. Dit zorgt voor betere dataintegriteit en governance, waardoor data lakehouses geschikter zijn voor bedrijfskritische toepassingen.
Data lakehouses ondersteunen ook realtime dataverwerking, zodat organisaties streamingdata aankunnen en realtime inzichten kunnen afleiden—van belang in bepaalde situaties.
Hoe kun je het beste van twee werelden in één platform verenigen? In deze sectie leg ik de componenten uit die de lakehousearchitectuur mogelijk maken.
In een data lakehouse zijn storage en compute gescheiden maar sterk geïntegreerd, waardoor middelen flexibel en schaalbaar inzetbaar zijn.
Data wordt opgeslagen in een kosteneffectieve cloud object store, terwijl compute-resources onafhankelijk kunnen worden opgeschaald op basis van de werklast. Deze aanpak vermindert de noodzaak om data tussen systemen te verplaatsen, zodat je data ter plekke kunt verwerken zonder uitgebreide extractie en laadprocessen.
Door storage en compute op deze manier te integreren, stroomlijnen data lakehouses het databeheer, verhogen ze de efficiëntie en verlagen ze de latentie, wat leidt tot snellere inzichten.
Dynamische toewijzing van resources maakt bovendien betere kostenoptimalisatie mogelijk en zorgt dat compute-middelen effectief worden benut.
Data lakehouses handhaven schema’s om datakwaliteit te borgen en bieden governancefuncties voor datacompliance.
Schemahandhaving zorgt ervoor dat data in een gestructureerd formaat is georganiseerd, wat het eenvoudiger maakt om te bevragen en te analyseren. Dit helpt inconsistenties te voorkomen en ondersteunt betere datakwaliteit binnen de hele organisatie.
Governancefuncties in data lakehouses stellen je in staat om datatoegang, herkomst en compliance te beheren. Met ingebouwde governancetools kunnen lakehouses voldoen aan wettelijke vereisten en gevoelige data beschermen. Dit is vooral belangrijk in sectoren zoals de zorg en de financiële sector, waar dataprivacy en compliance cruciaal zijn.
ACID-transacties borgen betrouwbaarheid, zodat je updates en deletes met vertrouwen kunt uitvoeren.
In een data lakehouse bieden ACID-transacties hetzelfde niveau van dataintegriteit als een traditioneel data warehouse, met de extra flexibiliteit om ongestructureerde data te verwerken.
Dankzij ondersteuning voor ACID-transacties kunnen lakehouses worden ingezet voor bedrijfskritische werklasten waarbij nauwkeurigheid essentieel is. Dit maakt ze aantrekkelijk voor ondernemingen die consistentie over verschillende dataoperaties heen moeten waarborgen.
Data lakehouses kunnen data in realtime verwerken, wat use-cases als realtime analytics en streaming-inzichten mogelijk maakt. Realtime verwerking stelt teams in staat sneller datagedreven beslissingen te nemen, wat de wendbaarheid vergroot.
Zo kun je klantinteracties monitoren, voorraden bijhouden of afwijkingen in financiële transacties detecteren. Door directe inzichten te bieden, helpen lakehouses je vooruit te lopen op veranderende marktomstandigheden en proactief op nieuwe kansen te reageren.
Data lakehouses kunnen draaien in multi-cloud- of hybride omgevingen en bieden daarmee flexibiliteit en schaalbaarheid.
Met multi-cloudondersteuning voorkom je vendor lock-in en kun je de beste diensten van verschillende cloudproviders benutten. Hybride ondersteuning zorgt dat on-premises systemen integreren met cloudomgevingen voor een uniforme datamanagementervaring.
Deze flexibiliteit is vooral waardevol voor teams met complexe infrastructuurbehoeften of tijdens cloudmigraties.
In deze sectie bespreken we de voordelen van een data lakehouse voor uiteenlopende dataverwerkingsbehoeften.
Data lakehouses erven de schaalbaarheid van data lakes, waardoor ze kunnen meegroeien met je databehoeften. Je kunt eenvoudig meer data toevoegen zonder je zorgen te maken over opslaglimieten, zodat je architectuur meegroeit met het bedrijf.
Zo kunnen Apache Hudi, Delta Lake en Apache Iceberg opslag schalen over duizenden bestanden in objectstores zoals Amazon S3, Azure Blob Storage of Google Cloud Storage.
Flexibiliteit is een tweede groot voordeel, omdat lakehouses zowel gestructureerde data (bijv. transactiegegevens) als ongestructureerde data (bijv. logbestanden, afbeeldingen en video’s) ondersteunen. Je kunt al je data op één plek opslaan, ongeacht het formaat, en die inzetten voor uiteenlopende analytics- en ML-use-cases.
Data lakehouses slaan data goedkoper op dan data warehouses, terwijl ze toch geavanceerde analytics ondersteunen.
Lakehouses die op cloud object storage (zoals Amazon S3 of Google Cloud Storage) zijn gebouwd, benutten de voordelige opslagklassen. In combinatie met Apache Parquet- en ORC-bestandsindelingen—die data comprimeren om opslagkosten te verlagen—kun je aanzienlijke besparingen realiseren.
Doordat lakehouses een uniforme oplossing bieden, hoef je geen gescheiden systemen voor opslag en analytics te onderhouden, wat kosten bespaart en lakehouses aantrekkelijk maakt.
Uniforme dataopslag en -verwerking verkorten de tijd tot inzichten. Lakehouses elimineren de noodzaak om data tussen opslag- en compute-omgevingen te verplaatsen, wat workflows stroomlijnt en latentie minimaliseert.
Technologieën zoals Apache Spark en Databricks maken het mogelijk om data direct binnen het lakehouse te verwerken, zonder verplaatsing naar aparte analyticsomgevingen.
Door alle data op één plek te hebben en die efficiënt te verwerken, kun je snel inzichten genereren die betere beslissingen ondersteunen. Dit is vooral waardevol in sectoren waar tijdigheid cruciaal is, zoals finance, retail en de zorg.
Schemahandhaving en datagovernancefuncties voldoen aan eisen voor kwaliteit en compliance. Lakehouses bieden tools voor toegangsbeheer, audittrails en data lineage—essentieel om integriteit te borgen en aan regelgeving te voldoen.
Tools als AWS Lake Formation, Azure Purview en Apache Ranger bieden gecentraliseerde controle over datatoegang, permissies en audittrails, zodat je data veilig kunt beheren en ongeautoriseerde toegang voorkomt
Dankzij deze governance- en beveiligingsfuncties zijn lakehouses geschikt voor organisaties die moeten voldoen aan regelgeving rond dataprivacy, zoals GDPR of HIPAA. Door data goed te beheren en te beschermen, groeit het vertrouwen in zowel de data als de daaruit voortkomende inzichten.
In deze sectie bekijken we de mogelijke use-cases voor het data lakehouse.
Datateams gebruiken lakehouses voor realtime analytics, business intelligence en machine-learningworkflows. Door een uniform dataplatform te bieden, kunnen professionals historische en realtime data analyseren en inzichten opdoen die betere bedrijfsresultaten aanjagen.
Zo kunnen retailers realtime verkoopdata analyseren, trends signaleren en hun voorraad daarop afstemmen. Financiële instellingen kunnen lakehouses inzetten voor risicobeoordeling en fraudedetectie, door historische met realtime transactiegegevens te combineren voor een compleet beeld.
Bekijk de gratis cursus Understanding Modern Data Architecture om meer te leren over moderne dataplatforms, van ingestie en ontsluiting tot governance en orkestratie.
Data lakehouses bieden de infrastructuur om AI- en ML-modellen te bouwen en te schalen, met eenvoudige toegang tot zowel gestructureerde als ongestructureerde data. ML-modellen vereisen vaak uiteenlopende datatypes en lakehouses brengen alle relevante data samen op één plek.
Deze uniforme datatoegang vereenvoudigt het trainen, testen en uitrollen van machine-learningmodellen. Data scientists kunnen snel met datasets experimenteren, modellen itereren en ze opschalen naar productie zonder zich zorgen te maken over datasilo’s of dataverplaatsing tussen systemen.
Lakehouses voeden datagedreven applicaties die realtime inzichten en besluitvorming vereisen. Zulke apps leunen vaak op actuele informatie om gebruikers gepersonaliseerde ervaringen of automatische aanbevelingen te bieden.
Een aanbevelingssysteem van een e-commercesite kan bijvoorbeeld een lakehouse gebruiken om gedrag in realtime te analyseren en relevante producttips te geven. Ook kunnen logistieke bedrijven lakehouses inzetten om bezorgroutes te optimaliseren op basis van realtime verkeersdata en historische leveringspatronen.
Tijd om de technologieën te leren kennen die de lakehousearchitectuur mogelijk maken. In deze sectie licht ik de populairste toe.
Databricks is een pionier van de lakehousearchitectuur en biedt Delta Lake als kernonderdeel van het platform. Delta Lake voegt betrouwbaarheid en prestatieverbeteringen toe aan data lakes, met ACID-transacties en waarborging van datakwaliteit.
Databricks Lakehouse combineert de schaalbaarheid van data lakes met datamanagementfuncties van data warehouses en biedt zo een uniform platform voor analytics en machine learning. Dankzij de integratie met Apache Spark is het aantrekkelijk voor organisaties die bigdataverwerking inzetten.
Wil je meer weten over het Databricks Lakehouse-platform en hoe het dataarchitecturen kan moderniseren en dataprocessen verbeteren? Bekijk dan de gratis cursus Introduction to Databricks.
Google’s BigLake integreert lakehouseprincipes met het bestaande cloudecosysteem en biedt een uniform platform voor dataopslag en analytics. BigLake laat gebruikers gestructureerde en ongestructureerde data beheren, waardoor analytics over verschillende datatypes eenvoudiger wordt.
Dankzij integratie met Google Cloud-services biedt BigLake een complete oplossing voor datateams die cloud-native tools willen inzetten. Het ondersteunt zowel batch- als realtimeverwerking en is daarmee geschikt voor uiteenlopende use-cases.
AWS Lake Formation biedt tools om een lakehouse op te zetten met de clouddiensten van AWS, met naadloze integratie en beheer. Met AWS Lake Formation kun je data eenvoudig inladen, catalogiseren en beveiligen, en zo een uniform lakehouse creëren.
AWS Lake Formation integreert ook met andere AWS-analyticdiensten, zoals Amazon Redshift en AWS Glue, en biedt daarmee een volledige suite aan tools voor dataverwerking en analytics. Dat maakt het aantrekkelijk voor organisaties die al op AWS draaien.
Snowflake’s architectuur evolueert richting lakehousemogelijkheden, zodat gebruikers gestructureerde en semigestructureerde data efficiënt kunnen beheren. Snowflake levert analytics met hoge prestaties en biedt tegelijk flexibiliteit in opslag en beheer.
De lakehousefuncties van Snowflake stellen je in staat verschillende datatypes te combineren en geavanceerde analytics uit te voeren zonder meerdere systemen te hoeven inzetten. Het cloud-native ontwerp en de ondersteuning voor multi-cloud maken het populair bij teams die hun data-infrastructuur willen moderniseren.
Ben je geïnteresseerd in Snowflake? Bekijk dan de cursus Introduction to Snowflake.
Microsoft’s Azure Synapse Analytics combineert big data en datawarehousing tot een uniforme lakehouseoplossing.
Met Synapse kunnen teams zowel gestructureerde als ongestructureerde data analyseren met tools als SQL, Apache Spark en Data Explorer. Dankzij de diepe integratie met andere Azure-diensten, zoals Azure Data Lake Storage en Power BI, biedt het een naadloze ervaring voor end-to-end dataverwerking, analytics en visualisatie—ideaal voor organisaties binnen het Azure-ecosysteem.
Apache Hudi is een open-sourceproject dat transactionele mogelijkheden naar data lakes brengt. Het ondersteunt ACID-transacties, upserts en dataversiebeheer.
Hudi integreert goed met cloudopslagplatforms zoals Amazon S3 en Google Cloud Storage en is daarmee geschikt voor realtime analytics en ML-pijplijnen. Met ondersteuning voor bigdata-engines zoals Apache Spark en Presto biedt Hudi flexibiliteit om een eigen lakehouse op open-sourcetechnologie te bouwen.
Dremio biedt een open data-lakehouseplatform voor snelle analytics en BI-werklasten direct op cloud data lakes.
Met de SQL-gebaseerde aanpak en integratie met Apache Arrow kunnen teams high-performance analytics uitvoeren zonder dataverplaatsing. Het is vooral nuttig voor organisaties die SQL-gebaseerde queries op hun data lakes willen ondersteunen, en is populair bij teams die snelheid en efficiëntie prioriteren.
Zoals je je kunt voorstellen, zijn niet alle technologieën die de lakehousearchitectuur ondersteunen hetzelfde. De onderstaande tabel vergelijkt ze op meerdere categorieën:
|
Platform |
Primair opslagt type |
Ondersteunt gestructureerde & ongestructureerde data |
Compute-engine |
ACID-transacties |
Realtime verwerking |
Integratie met ML/AI |
Ideale use-case |
|
Databricks Lakehouse |
Delta Lake (Apache Parquet) |
Ja |
Apache Spark |
Ja |
Ja |
Sterk (MLflow, Spark ML) |
Big data-analytics, AI/ML |
|
Google BigLake |
Google Cloud Storage |
Ja |
Google BigQuery |
Ja |
Ja |
Geïntegreerd met Google Cloud AI |
Cloud-native analytics |
|
AWS Lake Formation |
Amazon S3 |
Ja |
Amazon Redshift / AWS Glue |
Ja |
Beperkt |
Integratie met Amazon SageMaker |
AWS-centraal lakehouse |
|
Snowflake |
Propriëtair (cloudgebaseerd) |
Voornamelijk gestructureerd |
Snowflake Compute |
Ja |
Beperkt |
Beperkt |
Multi-cloud, analytics met hoge prestaties |
|
Azure Synapse Analytics |
Azure Data Lake Storage |
Ja |
SQL, Apache Spark, Data Explorer |
Ja |
Ja |
Sterk (Azure ML, Power BI) |
Analytics binnen Microsoft-ecosysteem |
|
Apache Hudi |
Cloud object storage (bijv. S3, GCS) |
Ja |
Apache Spark, Presto |
Ja |
Ja |
Externe ML-ondersteuning |
Open-source realtime data lakes |
|
Dremio |
Cloud data lakes |
Ja |
Dremio (Apache Arrow) |
Nee |
Ja |
Geen native integratie |
High-performance SQL op cloud lakes |
Sommige dingen lijken te mooi om waar te zijn, en het lakehouse vormt daarop geen uitzondering. Het lijkt alles te bieden, maar er zijn ook nadelen. Laten we die hier bekijken.
De integratie van een lakehouse met legacy-systemen kan complex zijn en vergt zorgvuldige planning. Teams moeten mogelijk data migreren uit bestaande data lakes of warehouses, wat tijd en middelen kost.
Ook kunnen compatibiliteitsproblemen ontstaan met oudere systemen die niet voor moderne dataarchitecturen zijn ontworpen. Voor een succesvolle implementatie moet je je huidige infrastructuur evalueren, migratie plannen en zorgen dat alle systemen goed samenwerken.
Schaalbaarheid balanceren met governance en beveiliging kan uitdagend zijn, zeker in gereguleerde sectoren. Lakehouses moeten robuuste governancetools bieden om toegang, herkomst en compliance te beheren, en tegelijk de schaalbaarheid behouden voor grote datasets.
Een andere cruciale factor is het goed beveiligen van gevoelige data. Je moet toegangscontroles, encryptie en auditing implementeren om data te beschermen en aan regelgeving te voldoen. Dit is extra uitdagend in hybride en multi-cloudomgevingen, waar data over locaties verspreid is.
Bij de implementatie van een lakehouse is het vinden van de juiste balans tussen kosten en prestaties niet eenvoudig. Hoewel lakehouses kostenefficiënte opslag bieden, kan analytics met hoge prestaties extra investeringen in compute vereisen.
Evalueer zorgvuldig de workloadvereisten en bepaal de meest kosteneffectieve manier om aan je prestatiebehoeften te voldoen. Dit kan betekenen: resourceallocatie optimaliseren, de juiste clouddiensten kiezen of de configuratie van het lakehouse aanpassen om zowel kosten- als prestatiedoelen te halen.
Data lakehouses vormen een belangrijke evolutie in dataarchitectuur: ze combineren de sterke punten van data lakes en data warehouses in één uniform platform!
Met schemahandhaving, ondersteuning voor ACID-transacties, schaalbaarheid en realtime verwerking bieden lakehouses een krachtige oplossing voor moderne databehoeften.
Voor datateams die hun datalandschap willen vereenvoudigen en hun analytische slagkracht willen vergroten, zijn lakehouses een overtuigende optie.
Verken de gratis cursus Understanding Data Engineering om meer te leren over data lakehouses en andere opkomende data-engineeringtechnologieën.
Data lakehouses combineren schaalbaarheid met robuuste analytics en zijn daardoor kosteneffectief voor bedrijven die flexibiliteit, hoge prestaties en realtime inzichten zoeken.
Lakehouses moeten prestaties balanceren voor gestructureerde en ongestructureerde data, wat complex kan zijn. Ook governance en beveiliging over verschillende datatypes heen én integratie met legacy-systemen vormen uitdagingen.
Lakehouses gebruiken metadatalagen (zoals de metadata-afhandeling van Delta Lake) om te organiseren, schema’s te handhaven en queries te optimaliseren, wat dataontdekking, governance en prestaties verbetert.
Lakehouses kunnen vaak data lakes en warehouses vervangen, maar voor sommige specialistische use-cases zijn aparte systemen nog steeds nodig. Voor de meeste behoeften bieden lakehouses een uniforme, flexibele oplossing.
Technologieën zoals Delta Lake en Apache Hudi ondersteunen dataversiebeheer, waardoor gebruikers wijzigingen kunnen volgen, rollbacks kunnen doen en consistentie in de tijd kunnen waarborgen.
Lakehouses bevorderen datademocratisering door één platform te bieden waar alle data toegankelijk en onder governance is, zodat bredere teams data veilig kunnen benutten.
Leer meer over data engineering met deze cursussen!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Google
blog

Adel Nehme
15 min