Program
Pembelajaran Mendalam dalam Python
18 jam
Bayangkan Anda berjalan menuruni bukit, tetapi permukaan tanah berubah-ubah—sebagian curam, sebagian datar. Jika Anda melangkah dengan ukuran yang sama setiap saat, Anda bisa kesulitan atau butuh waktu lama untuk mencapai dasar. Dalam machine learning, tantangan serupa terjadi pada gradient descent, saat menggunakan laju pembelajaran yang sama untuk semua parameter dapat memperlambat proses pembelajaran.
Di sinilah Adagrad berperan. Ia menyesuaikan ukuran langkah untuk setiap parameter berdasarkan seberapa banyak parameter tersebut berubah selama pelatihan, membantu model belajar lebih cepat dan efektif, terutama ketika fitur-fitur memiliki skala yang berbeda. Dalam artikel ini, kita akan menjelajahi cara kerja Adagrad dan menguraikan matematika di baliknya. Kami juga akan menunjukkan cara mengimplementasikannya menggunakan PyTorch dan membandingkannya dengan optimizer lain agar Anda dapat memilih yang terbaik untuk proyek Anda.
Adagrad (Adaptive Gradient) adalah algoritma optimisasi yang digunakan dalam machine learning, khususnya untuk melatih deep neural networks. Algoritma ini dirancang untuk menyesuaikan laju pembelajaran bagi setiap parameter berdasarkan riwayat gradiennya. Pendekatan ini memungkinkan Adagrad meningkatkan efisiensi model machine learning, terutama dalam skenario dengan data jarang (sparse) atau ketika parameter yang berbeda memiliki laju konvergensi yang bervariasi.
Adagrad memberikan laju pembelajaran yang lebih tinggi untuk fitur yang jarang muncul dan lebih rendah untuk yang sering muncul, sehingga sangat cocok untuk bekerja dengan data sparse. Selain itu, ia mengurangi kebutuhan untuk menyesuaikan laju pembelajaran secara manual!
Mari kita uraikan algoritma Adagrad:
Pertama, mulai dengan:
Untuk setiap parameter 0t pada langkah waktu t, Anda menghitung gradien fungsi loss terhadap parameter tersebut. Gradien ini memberi tahu kita seberapa besar dan ke arah mana kita harus memperbarui parameter untuk mengurangi loss. Mari kita sebut gradien ini gt, di mana t adalah langkah waktu saat ini.
Alih-alih langsung memperbarui parameter, Adagrad melacak jumlah kuadrat gradien untuk setiap parameter. Untuk setiap parameter i, Anda menghitung dan mengakumulasi kuadrat gradien pada setiap langkah waktu. Gradien terakumulasi ini dilambangkan sebagai Gt.
Gt =Gt-1 + gt2
Berikut ini:
Gradien terakumulasi ini membantu Adagrad menyesuaikan laju pembelajaran secara berbeda untuk setiap parameter berdasarkan seberapa banyak parameter tersebut telah diperbarui.
Sekarang setelah Anda memiliki kuadrat gradien terakumulasi Gt, kita dapat memperbarui setiap parameter 0t. Aturan pembaruan untuk Adagrad adalah sebagai berikut:
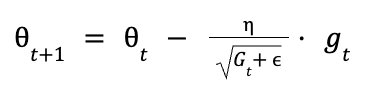
Berikut yang terjadi:
Suku:

secara efektif mengurangi laju pembelajaran untuk parameter dengan gradien terakumulasi besar. Sebaliknya, parameter dengan gradien terakumulasi kecil akan memiliki laju pembelajaran yang lebih besar.
Rumus Adagrad secara otomatis menyesuaikan laju pembelajaran, begini caranya:
PyTorch menyediakan implementasi Adagrad bawaan, yang dapat diakses melalui modul torch.optim. Pertama, instal PyTorch menggunakan pip:
pip install torch torchvisionPelajari cara membangun jaringan saraf pertama Anda dengan kursus gratis kami, Introduction to Deep Learning with PyTorch.
Berikut panduan langkah demi langkah untuk mengimplementasikan optimizer Adagrad di PyTorch:
Langkah 1: Impor Pustaka yang Diperlukan
import torchimport torch.nn as nnimport torch.optim as optimLangkah 2: Definisikan Jaringan Saraf Sederhana
class SimpleNN(nn.Module): def __init__(self): super(SimpleNN, self).__init__() self.fc1 = nn.Linear(10, 5) self.fc2 = nn.Linear(5, 2) def forward(self, x): x = torch.relu(self.fc1(x)) x = self.fc2(x) return xLangkah 3: Inisialisasi Model dan Optimizer
model = SimpleNN()criterion = nn.CrossEntropyLoss()optimizer = optim.Adagrad(model.parameters(), lr=0.01)Langkah 4: Training Loop
for epoch in range(10): # loop over the dataset multiple times inputs = torch.randn(1, 10) # random input tensor labels = torch.tensor([1]) # target labels # Zero the parameter gradients optimizer.zero_grad() # Forward pass outputs = model(inputs) loss = criterion(outputs, labels) # Backward pass and optimize loss.backward() optimizer.step() print(f'Epoch {epoch+1}, Loss: {loss.item()}')Dalam kode ini, model linear sederhana dilatih menggunakan optimizer AdaGrad. Laju pembelajaran ditetapkan ke 0,01, tetapi AdaGrad akan menyesuaikannya untuk setiap parameter berdasarkan kuadrat gradien yang terakumulasi.
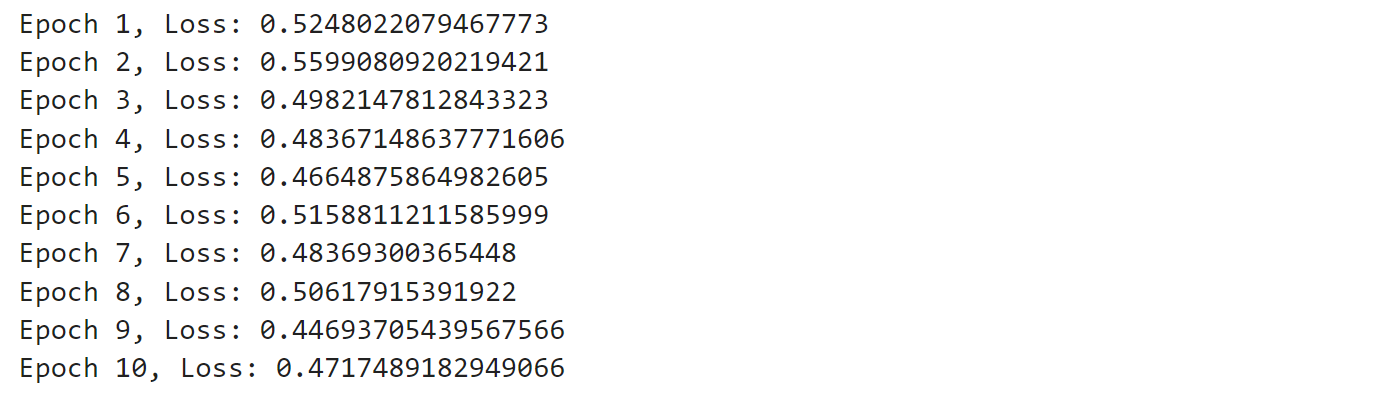
Jalankan kodenya dan Anda akan melihat keluaran yang serupa dengan ini:
Keluaran menunjukkan loss setelah setiap epoch, yang mengindikasikan seberapa baik model belajar. Awalnya, loss lebih tinggi, tetapi seiring pelatihan berlangsung, loss umumnya menurun, artinya model membaik. Beberapa fluktuasi adalah hal yang normal, terutama dengan input acak, tetapi secara keseluruhan, model secara bertahap belajar membuat prediksi yang lebih baik.
Jika Anda ingin mendalami deep learning dan mengeksplorasi bagaimana cabang machine learning ini mengubah dunia, lihat kursus kami tentang Deep Learning in Python.
Mari bandingkan Adagrad dengan optimizer lain seperti Adam, SGD, dan RMSProp.
Baik Adagrad maupun Adam menyesuaikan laju pembelajaran untuk setiap parameter, namun dengan cara yang berbeda. Adagrad menskalakan laju pembelajaran berdasarkan jumlah kuadrat gradien, yang dapat menyebabkan laju pembelajaran makin mengecil seiring waktu. Di sisi lain, Adam menggunakan momen pertama dan kedua dari gradien, memungkinkannya mempertahankan laju pembelajaran yang lebih stabil sepanjang pelatihan.
Adagrad sangat cocok untuk menangani data sparse karena kemampuannya memberikan laju pembelajaran lebih besar pada fitur yang jarang. Ini menjadikannya pilihan yang baik untuk aplikasi seperti natural language processing, di mana gradien yang sparse umum terjadi. Adam, meskipun juga mampu menangani data sparse, umumnya lebih disukai karena keandalannya secara keseluruhan dan efisiensinya di berbagai aplikasi.
Adam sering dipilih karena konvergensinya yang lebih cepat dan kinerjanya yang unggul dalam praktik, terutama pada model deep learning dengan dataset besar. Penggunaan momentum dan koreksi bias membantunya menghindari jebakan minimum lokal dan saddle point, yang bisa menjadi keterbatasan bagi Adagrad.
Pelajari arsitektur deep learning mendasar seperti CNN, RNN, LSTM, dan GRU untuk memodelkan data citra dan berurutan. Lihat kursus kami Intermediate Deep Learning with PyTorch.
Mari bandingkan Adagrad dengan SGD dan RMSProp
Stochastic Gradient Descent adalah algoritma optimisasi dasar yang memperbarui parameter model menggunakan gradien fungsi loss terhadap parameter. Algoritma ini dikenal karena kesederhanaan dan kemudahan implementasinya. Namun, SGD memiliki laju pembelajaran konstan, yang bisa menjadi keterbatasan saat berhadapan dengan data sparse atau skala fitur yang bervariasi.
RMSProp adalah pengembangan dari AdaGrad yang mengatasi masalah menurunnya laju pembelajaran dengan memperkenalkan faktor peluruhan. Faktor ini memungkinkan RMSProp mempertahankan laju pembelajaran yang lebih stabil sepanjang proses pelatihan.
Mari kita rangkum kelebihan dan kekurangan Adagrad, SGD, dan RMSProp:
Optimizer | Kelebihan | Kekurangan |
Adagrad | 1. Secara otomatis menyesuaikan laju pembelajaran untuk setiap parameter. 2. Efektif untuk data sparse. 3. Menghilangkan kebutuhan penyesuaian laju pembelajaran manual. | 1. Laju pembelajaran menurun seiring waktu, berpotensi menyebabkan konvergensi terlalu dini. 2. Dapat menjadi terlalu lambat pada tahap akhir pelatihan. |
SGD | 1. Sederhana dan mudah diimplementasikan. 2. Efektif keluar dari minimum lokal karena sifat stokastiknya. | 1. Variansi pembaruan tinggi dapat menyebabkan ketidakstabilan. 2. Memerlukan penalaan cermat terhadap laju pembelajaran dan momentum. |
RMSProp | 1. Menyesuaikan laju pembelajaran berdasarkan rata-rata bergerak kuadrat gradien. 2. Cocok untuk lingkungan non-stasioner. | 1. Memerlukan penalaan hyperparameter yang cermat. 2. Tidak secara inheren mengikutsertakan momentum. |
Mari jelajahi kasus penggunaan dan keterbatasan AdaGrad dalam berbagai konteks.
Kemampuan unik Adagrad untuk menyesuaikan laju pembelajaran bagi setiap parameter membuatnya ideal untuk beberapa skenario:
Meskipun Adagrad kuat dalam situasi tertentu, ia memiliki beberapa keterbatasan:
Ada beberapa strategi yang dapat Anda gunakan untuk mengatasi keterbatasan Adagrad:
Mari bangun jaringan saraf sederhana, latih menggunakan optimizer Adagrad, dan bandingkan kinerjanya dengan optimizer populer lainnya.
Jika Anda ingin mempelajari lebih lanjut tentang PyTorch, lihat panduan kami PyTorch Tutorial: Building a Simple Neural Network From Scratch.
Mari mulai dengan membuat model jaringan saraf dasar di PyTorch. Kita akan merancang jaringan yang cocok untuk klasifikasi biner pada data sparse, di mana Adagrad unggul.
import torchimport torch.nn as nnclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return xJaringan saraf ini memiliki lapisan input, satu lapisan tersembunyi dengan 50 neuron, dan satu lapisan output dengan satu neuron. Kita menggunakan aktivasi ReLU untuk lapisan tersembunyi dan Sigmoid untuk lapisan output, menjadikannya cocok untuk klasifikasi biner.
Sekarang, mari atur proses pelatihan menggunakan optimizer Adagrad. Kita akan membuat fungsi untuk menangani pelatihan:
import torch.optim as optimfrom torch.utils.data import DataLoader, TensorDataset# Function to train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): # loop for each training epoch for inputs, targets in train_loader: # Clear gradients before each batch to avoid accumulation optimizer.zero_grad() # Reset gradients to zero # Forward pass - get model predictions outputs = model(inputs) # Calculate loss based on predictions and targets loss = criterion(outputs, targets) # Backward pass - calculate gradients for parameter updates based on the loss loss.backward() # Update model parameters based on calculated gradients optimizer.step() # Track loss for monitoring training progress losses.append(loss.item()) return losses# Setup for trainingX, y = generate_sparse_data() # This function generates our sparse datasetinput_size = X.shape[1]train_size = int(0.8 * len(X))X_train, X_test = X[:train_size], X[train_size:]y_train, y_test = y[:train_size], y[train_size:]train_dataset = TensorDataset(X_train, y_train)train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)model = SparseNN(input_size)criterion = nn.BCELoss() # Assuming binary classification with BCE lossoptimizer = optim.Adagrad(model.parameters(), lr=0.01)# Train the modellosses = train_model(model, optimizer, criterion, train_loader)Dalam pengaturan ini, kita:
Sekarang, untuk menilai kinerja model, kita akan membuat fungsi evaluasi:
def evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Evaluate the modeltest_dataset = TensorDataset(X_test, y_test)test_loader = DataLoader(test_dataset, batch_size=32)accuracy = evaluate_model(model, test_loader)print(f"Adagrad Accuracy: {accuracy:.4f}")Fungsi ini menghitung akurasi model pada himpunan uji.
Selanjutnya, mari bandingkan dengan optimizer populer lainnya: SGD, Adam, dan RMSprop. Kita akan membuat fungsi untuk menjalankan eksperimen bagi setiap optimizer:
def run_experiment(optimizer_class, lr=0.01): model = SparseNN(input_size) criterion = nn.BCELoss() if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) losses = train_model(model, optimizer, criterion, train_loader) accuracy = evaluate_model(model, test_loader) return losses, accuracy# Compare optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Setelah menjalankan kode ini, kita mendapatkan hasil berikut:
Final accuracies:Adagrad: 0.9350SGD: 0.8950Adam: 0.9300RMSprop: 0.8600Hasil ini menunjukkan bahwa Adagrad berkinerja terbaik pada masalah data sparse kita, mencapai akurasi tertinggi 95,00%. Ini menunjukkan bahwa Adagrad sangat cocok untuk skenario data sparse. Adam berada di posisi kedua yang dekat, sementara SGD dan RMSprop berkinerja kurang baik pada kasus khusus ini.
Untuk memvisualisasikan proses pelatihan, kita dapat memplot kurva loss:
import matplotlib.pyplot as pltplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()Mari gabungkan semua potongan kode dan berikut kode lengkapnya.
import torchimport torch.nn as nnimport torch.optim as optimfrom torch.utils.data import DataLoader, TensorDatasetimport matplotlib.pyplot as plt# Step 1: Generate sparse synthetic datadef generate_sparse_data(n_samples=1000, n_features=100, sparsity=0.95): X = torch.randn(n_samples, n_features) mask = torch.rand(n_samples, n_features) < sparsity X[mask] = 0 weights = torch.randn(n_features) y = (torch.matmul(X, weights) > 0).float().view(-1, 1) return X, y# Step 2: Define the neural networkclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return x# Step 3: Train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): for inputs, targets in train_loader: optimizer.zero_grad() outputs = model(inputs) loss = criterion(outputs, targets) loss.backward() optimizer.step() losses.append(loss.item()) return losses# Step 4: Evaluate the modeldef evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Step 5: Main function to run the experimentdef run_experiment(optimizer_class, lr=0.01): # Generate sparse data X, y = generate_sparse_data() input_size = X.shape[1] train_size = int(0.8 * len(X)) X_train, X_test = X[:train_size], X[train_size:] y_train, y_test = y[:train_size], y[train_size:] # Create data loaders train_dataset = TensorDataset(X_train, y_train) test_dataset = TensorDataset(X_test, y_test) train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True) test_loader = DataLoader(test_dataset, batch_size=32) # Initialize model and training components model = SparseNN(input_size) criterion = nn.BCELoss() # Use default hyperparameters for each optimizer if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) # Train the model losses = train_model(model, optimizer, criterion, train_loader) # Evaluate the model accuracy = evaluate_model(model, test_loader) return losses, accuracy# Step 6: Compare Adagrad with other optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}# Step 7: Plot resultsplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Berikut hasilnya:
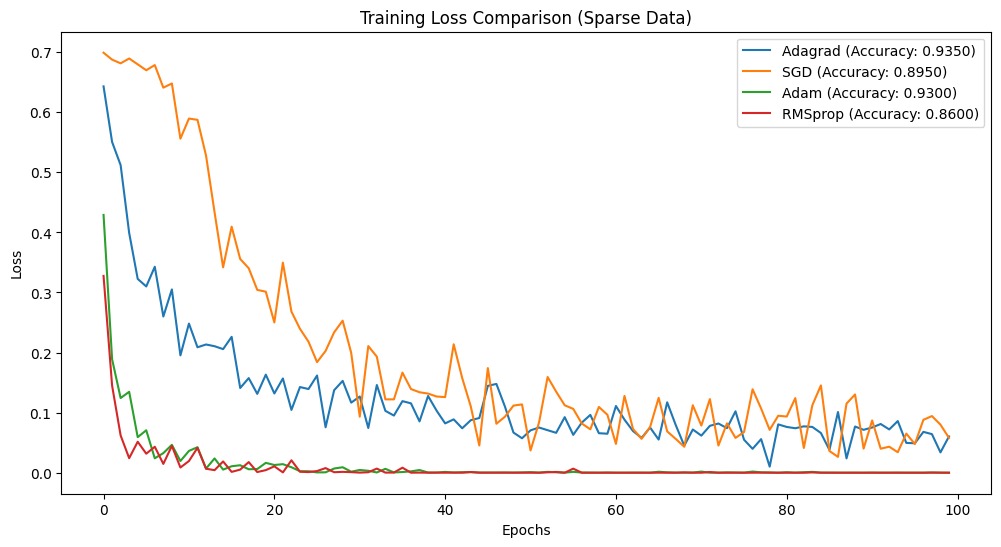
Adagrad berguna saat bekerja dengan data sparse berkat laju pembelajarannya yang adaptif. Kita membangun jaringan saraf dasar dan melatihnya menggunakan Adagrad, lalu membandingkan kinerjanya dengan algoritma optimisasi lain yang dikenal. Hasilnya sangat mengunggulkan Adagrad, menunjukkan bahwa ia menangani data sparse dengan lebih baik.
Saya juga telah memilih beberapa sumber terbaik tentang PyTorch, deep learning, dan algoritma optimisasi lainnya. Pastikan untuk memeriksanya guna belajar lebih mendalam:
Kursus Terbaik di DataCamp
Program
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




