Cursus
Apprentissage profond en Python
18 h
Imaginez que vous descendiez une colline dont la pente change en cours de route : certains passages sont raides, d’autres presque plats. Si vous gardez toujours le même pas, vous risquez d’avancer trop lentement ou de peiner à atteindre le bas. En machine learning, un défi similaire survient avec la descente de gradient, où l’utilisation d’un taux d’apprentissage identique pour tous les paramètres peut ralentir l’entraînement.
C’est là qu’intervient Adagrad. Il ajuste la taille du pas pour chaque paramètre en fonction de son historique de variations pendant l’entraînement, ce qui aide le modèle à apprendre plus vite et plus efficacement, surtout lorsque les caractéristiques ont des échelles différentes. Dans cet article, nous verrons comment fonctionne Adagrad et nous démystifierons les équations qui le sous-tendent. Nous vous montrerons également comment l’implémenter avec PyTorch et le comparerons à d’autres optimiseurs afin que vous puissiez choisir la meilleure option pour vos projets.
Adagrad (Adaptive Gradient) est un algorithme d’optimisation utilisé en machine learning, notamment pour entraîner des réseaux de neurones profonds. Il adapte le taux d’apprentissage de chaque paramètre à partir de ses gradients passés. Cette approche permet d’améliorer l’efficacité des modèles de machine learning, en particulier lorsque les données sont clairsemées (sparse) ou quand les paramètres convergent à des vitesses différentes.
Adagrad attribue des taux d’apprentissage plus élevés aux caractéristiques peu fréquentes et plus faibles aux plus fréquentes, ce qui le rend particulièrement adapté aux données clairsemées. Il réduit également la nécessité d’ajuster manuellement le taux d’apprentissage.
Décomposons l’algorithme Adagrad :
Commencez par :
Pour chaque paramètre 0t au pas de temps t, on calcule le gradient de la fonction de perte par rapport à ce paramètre. Ce gradient indique combien et dans quelle direction mettre à jour le paramètre pour réduire la perte. Appelons ce gradient gt, où t est le pas de temps courant.
Au lieu de mettre à jour directement les paramètres, Adagrad mémorise, pour chacun, la somme des gradients au carré. Pour chaque paramètre i, on calcule et on accumule à chaque pas de temps le gradient au carré. Ce cumul est noté Gt.
Gt =Gt-1 + gt2
Ici :
Ce cumul permet à Adagrad d’ajuster différemment le taux d’apprentissage de chaque paramètre selon son historique de mises à jour.
Maintenant que vous disposez du gradient cumulé au carré Gt, on peut mettre à jour chaque paramètre 0t. La règle de mise à jour d’Adagrad est la suivante :
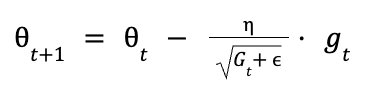
Voici ce qui se passe :
Le terme :

réduit effectivement le taux d’apprentissage pour les paramètres dont le gradient accumulé est élevé. À l’inverse, les paramètres ayant un cumul plus faible conservent un taux d’apprentissage plus important.
La formule d’Adagrad adapte automatiquement le taux d’apprentissage, de cette manière :
PyTorch propose une implémentation native d’Adagrad accessible via le module torch.optim. Commencez par installer PyTorch avec pip :
pip install torch torchvisionApprenez à construire votre premier réseau de neurones avec notre cours gratuit Introduction to Deep Learning with PyTorch.
Voici un guide pas à pas pour implémenter l’optimiseur Adagrad dans PyTorch :
Étape 1 : importer les bibliothèques nécessaires
import torchimport torch.nn as nnimport torch.optim as optimÉtape 2 : définir un réseau de neurones simple
class SimpleNN(nn.Module): def __init__(self): super(SimpleNN, self).__init__() self.fc1 = nn.Linear(10, 5) self.fc2 = nn.Linear(5, 2) def forward(self, x): x = torch.relu(self.fc1(x)) x = self.fc2(x) return xÉtape 3 : initialiser le modèle et l’optimiseur
model = SimpleNN()criterion = nn.CrossEntropyLoss()optimizer = optim.Adagrad(model.parameters(), lr=0.01)Étape 4 : boucle d’entraînement
for epoch in range(10): # loop over the dataset multiple times inputs = torch.randn(1, 10) # random input tensor labels = torch.tensor([1]) # target labels # Zero the parameter gradients optimizer.zero_grad() # Forward pass outputs = model(inputs) loss = criterion(outputs, labels) # Backward pass and optimize loss.backward() optimizer.step() print(f'Epoch {epoch+1}, Loss: {loss.item()}')Dans cet exemple, un modèle linéaire simple est entraîné avec l’optimiseur AdaGrad. Le taux d’apprentissage est fixé à 0,01, mais Adagrad l’ajustera pour chaque paramètre selon les gradients au carré accumulés.
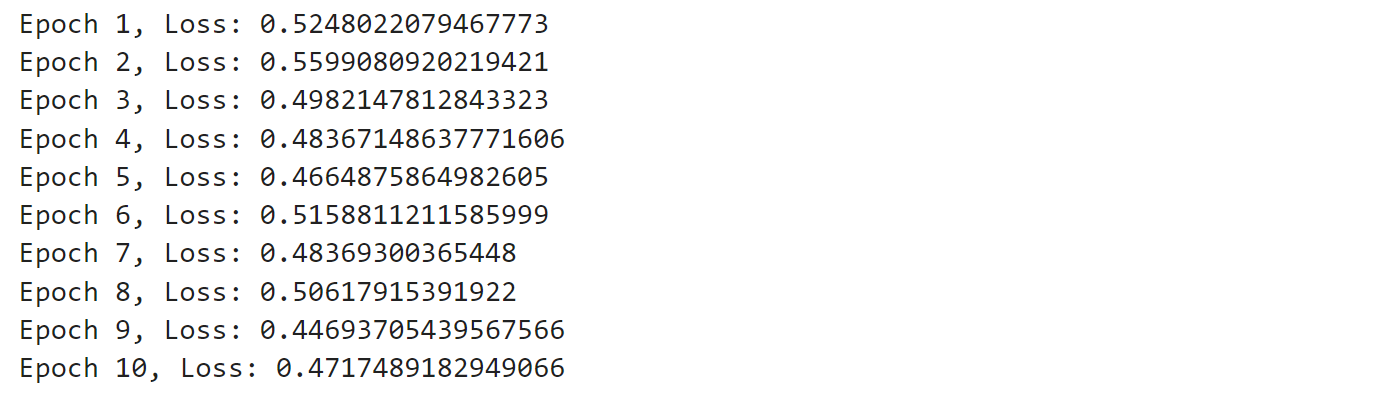
Exécutez le code et vous verrez une sortie similaire à ceci :
La sortie affiche la perte après chaque époque, ce qui reflète la progression de l’apprentissage. Au début, la perte est plus élevée, puis diminue généralement au fil des époques, signe que le modèle s’améliore. Quelques fluctuations sont normales, surtout avec des entrées aléatoires, mais la tendance globale doit être à l’amélioration des prédictions.
Si vous souhaitez découvrir le deep learning et comprendre comment cette branche du machine learning transforme le monde, consultez notre parcours Deep Learning in Python.
Comparons Adagrad à d’autres optimiseurs tels qu’Adam, SGD et RMSProp.
Adagrad et Adam adaptent tous deux le taux d’apprentissage de chaque paramètre, mais différemment. Adagrad le fait via la somme des gradients au carré, ce qui peut conduire à une diminution trop marquée au fil du temps. Adam, lui, exploite les premier et second moments des gradients, ce qui lui permet de conserver un taux plus stable tout au long de l’entraînement.
Adagrad est particulièrement adapté aux données clairsemées, car il peut attribuer des taux d’apprentissage plus élevés aux caractéristiques peu fréquentes. C’est un bon choix pour des applications comme le traitement du langage naturel, où les gradients sont souvent clairsemés. Adam sait aussi gérer ce type de données, mais il est généralement privilégié pour sa robustesse et son efficacité sur un spectre d’applications plus large.
En pratique, Adam est souvent préféré pour sa convergence plus rapide et ses performances supérieures, notamment sur des modèles de deep learning et de grands jeux de données. L’usage du momentum et de la correction de biais l’aide à éviter de se bloquer dans des minima locaux ou des points selle, ce qui peut limiter Adagrad.
Apprenez les architectures fondamentales du deep learning (CNN, RNN, LSTM, GRU) pour modéliser des images et des séquences. Découvrez notre cours Intermediate Deep Learning with PyTorch.
Comparons Adagrad avec SGD et RMSProp
Stochastic Gradient Descent est un algorithme d’optimisation de base qui met à jour les paramètres du modèle à partir du gradient de la perte par rapport à ces paramètres. Il est apprécié pour sa simplicité et sa facilité d’implémentation. Cependant, son taux d’apprentissage constant peut poser problème avec des données clairsemées ou des échelles de variables hétérogènes.
RMSProp est une extension d’Adagrad qui corrige l’effet de diminution excessive du taux d’apprentissage en introduisant un facteur de décroissance. Celui-ci permet de maintenir un taux plus stable pendant l’entraînement.
Résumons les avantages et limites d’Adagrad, de SGD et de RMSProp :
Optimiseur | Avantages | Inconvénients |
Adagrad | 1. Adapte automatiquement le taux d’apprentissage de chaque paramètre. 2. Efficace sur des données clairsemées. 3. Réduit le besoin de réglage manuel du taux d’apprentissage. | 1. Le taux d’apprentissage décroît avec le temps, risquant une convergence prématurée. 2. Peut devenir trop lent en fin d’entraînement. |
SGD | 1. Simple et facile à implémenter. 2. Sa nature stochastique aide à échapper aux minima locaux. | 1. Variance élevée des mises à jour, pouvant entraîner de l’instabilité. 2. Nécéssite un réglage fin du taux d’apprentissage et du momentum. |
RMSProp | 1. Adapte les taux d’apprentissage via la moyenne mobile des gradients au carré. 2. Adapté à des environnements non stationnaires. | 1. Demande un réglage attentif des hyperparamètres. 2. N’intègre pas intrinsèquement le momentum. |
Explorons les cas d’usage et limites d’AdaGrad selon les contextes.
La capacité d’Adagrad à adapter le taux d’apprentissage paramètre par paramètre le rend idéal dans plusieurs scénarios :
Bien qu’efficace dans certains cas, Adagrad présente des limites :
Plusieurs stratégies permettent de pallier ces limites :
Construisons un réseau de neurones simple, entraînons-le avec l’optimiseur Adagrad et comparons ses performances à celles d’autres optimiseurs populaires.
Pour en savoir plus sur PyTorch, consultez notre guide PyTorch Tutorial: Building a Simple Neural Network From Scratch.
Commençons par créer un modèle de réseau de neurones basique dans PyTorch. Nous concevrons un réseau adapté à une classification binaire sur données clairsemées, où Adagrad excelle.
import torchimport torch.nn as nnclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return xCe réseau possède une couche d’entrée, une couche cachée de 50 neurones et une couche de sortie à un neurone. On utilise ReLU pour la couche cachée et Sigmoid en sortie, ce qui convient à une classification binaire.
Configurons maintenant le processus d’entraînement avec Adagrad. Créons une fonction dédiée :
import torch.optim as optimfrom torch.utils.data import DataLoader, TensorDataset# Function to train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): # loop for each training epoch for inputs, targets in train_loader: # Clear gradients before each batch to avoid accumulation optimizer.zero_grad() # Reset gradients to zero # Forward pass - get model predictions outputs = model(inputs) # Calculate loss based on predictions and targets loss = criterion(outputs, targets) # Backward pass - calculate gradients for parameter updates based on the loss loss.backward() # Update model parameters based on calculated gradients optimizer.step() # Track loss for monitoring training progress losses.append(loss.item()) return losses# Setup for trainingX, y = generate_sparse_data() # This function generates our sparse datasetinput_size = X.shape[1]train_size = int(0.8 * len(X))X_train, X_test = X[:train_size], X[train_size:]y_train, y_test = y[:train_size], y[train_size:]train_dataset = TensorDataset(X_train, y_train)train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)model = SparseNN(input_size)criterion = nn.BCELoss() # Assuming binary classification with BCE lossoptimizer = optim.Adagrad(model.parameters(), lr=0.01)# Train the modellosses = train_model(model, optimizer, criterion, train_loader)Dans ce dispositif :
Pour évaluer les performances, créons une fonction d’évaluation :
def evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Evaluate the modeltest_dataset = TensorDataset(X_test, y_test)test_loader = DataLoader(test_dataset, batch_size=32)accuracy = evaluate_model(model, test_loader)print(f"Adagrad Accuracy: {accuracy:.4f}")Cette fonction calcule la précision du modèle sur l’ensemble de test.
Comparons-le ensuite à d’autres optimiseurs populaires : SGD, Adam et RMSprop. Créons une fonction pour exécuter l’expérience pour chacun :
def run_experiment(optimizer_class, lr=0.01): model = SparseNN(input_size) criterion = nn.BCELoss() if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) losses = train_model(model, optimizer, criterion, train_loader) accuracy = evaluate_model(model, test_loader) return losses, accuracy# Compare optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Après exécution, nous obtenons :
Final accuracies:Adagrad: 0.9350SGD: 0.8950Adam: 0.9300RMSprop: 0.8600Ces résultats montrent qu’Adagrad a obtenu la meilleure performance sur notre problème de données clairsemées, avec une précision de 95,00 %. Cela confirme qu’Adagrad est bien adapté à ce type de données. Adam arrive de près, tandis que SGD et RMSprop font moins bien dans ce cas précis.
Pour visualiser l’entraînement, traçons les courbes de perte :
import matplotlib.pyplot as pltplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()Regroupons tous les extraits, voici le code complet.
import torchimport torch.nn as nnimport torch.optim as optimfrom torch.utils.data import DataLoader, TensorDatasetimport matplotlib.pyplot as plt# Step 1: Generate sparse synthetic datadef generate_sparse_data(n_samples=1000, n_features=100, sparsity=0.95): X = torch.randn(n_samples, n_features) mask = torch.rand(n_samples, n_features) < sparsity X[mask] = 0 weights = torch.randn(n_features) y = (torch.matmul(X, weights) > 0).float().view(-1, 1) return X, y# Step 2: Define the neural networkclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return x# Step 3: Train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): for inputs, targets in train_loader: optimizer.zero_grad() outputs = model(inputs) loss = criterion(outputs, targets) loss.backward() optimizer.step() losses.append(loss.item()) return losses# Step 4: Evaluate the modeldef evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Step 5: Main function to run the experimentdef run_experiment(optimizer_class, lr=0.01): # Generate sparse data X, y = generate_sparse_data() input_size = X.shape[1] train_size = int(0.8 * len(X)) X_train, X_test = X[:train_size], X[train_size:] y_train, y_test = y[:train_size], y[train_size:] # Create data loaders train_dataset = TensorDataset(X_train, y_train) test_dataset = TensorDataset(X_test, y_test) train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True) test_loader = DataLoader(test_dataset, batch_size=32) # Initialize model and training components model = SparseNN(input_size) criterion = nn.BCELoss() # Use default hyperparameters for each optimizer if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) # Train the model losses = train_model(model, optimizer, criterion, train_loader) # Evaluate the model accuracy = evaluate_model(model, test_loader) return losses, accuracy# Step 6: Compare Adagrad with other optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}# Step 7: Plot resultsplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Voici le résultat :
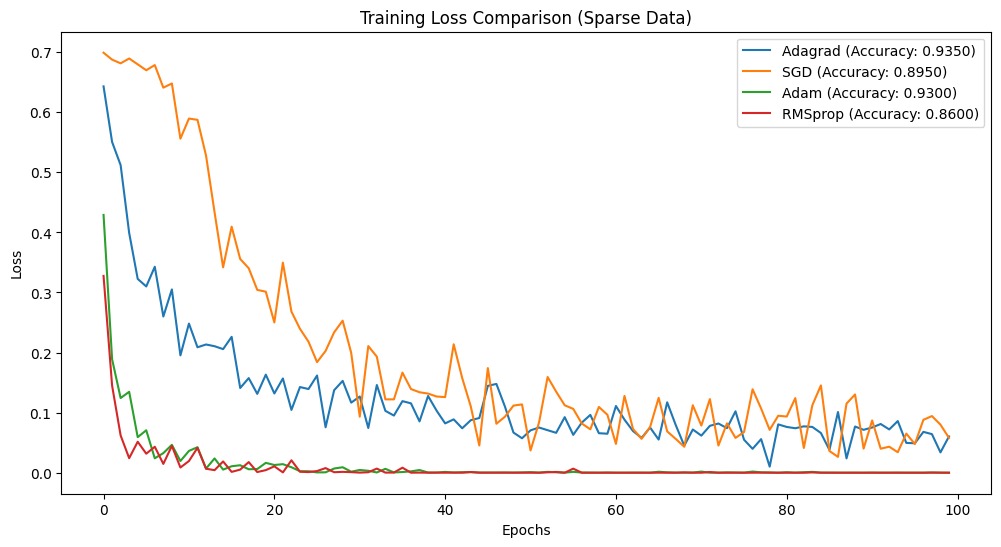
Adagrad est particulièrement utile avec des données clairsemées grâce à son taux d’apprentissage adaptatif. Nous avons construit un réseau de neurones basique et l’avons entraîné avec Adagrad, puis comparé ses performances à d’autres algorithmes d’optimisation reconnus. Les résultats ont clairement favorisé Adagrad, montrant sa capacité à mieux gérer la parcimonie.
Nous avons également sélectionné des ressources de référence sur PyTorch, le deep learning et d’autres optimiseurs. Parcourez-les pour approfondir :
Les meilleurs cours DataCamp
Cursus
Cours
Cours