Lernpfad
Deep Learning in Python
18 Std.
Stell dir vor, du läufst einen Hügel hinunter, aber der Untergrund ändert sich ständig – mal steil, mal flach. Wenn du immer gleich große Schritte machst, brauchst du entweder zu lange oder kommst ins Straucheln. In der Welt des maschinellen Lernens passiert etwas Ähnliches beim Gradient Descent: Eine einheitliche Lernrate für alle Parameter kann das Training ausbremsen.
Genau hier kommt Adagrad ins Spiel. Es passt die Schrittlänge für jeden Parameter individuell an, abhängig davon, wie stark er sich im Training verändert hat. So lernt das Modell schneller und effizienter – besonders, wenn Features unterschiedlich skaliert sind. In diesem Artikel schauen wir uns an, wie Adagrad funktioniert, und zerlegen die zugrunde liegende Mathematik. Außerdem zeigen wir dir die Implementierung in PyTorch und vergleichen Adagrad mit anderen Optimierern, damit du die beste Wahl für deine Projekte triffst.
Adagrad (Adaptive Gradient) ist ein Optimierungsalgorithmus im maschinellen Lernen, insbesondere für das Training tiefer neuronaler Netze. Er passt die Lernrate pro Parameter anhand seiner bisherigen Gradienten an. So steigert Adagrad die Effizienz von ML-Modellen – besonders bei spärlichen Daten oder wenn Parameter unterschiedlich schnell konvergieren.
Adagrad vergibt höhere Lernraten für seltene Features und niedrigere für häufige. Das macht es ideal für spärliche Daten. Zusätzlich entfällt häufig das manuelle Tuning der Lernrate.
So funktioniert Adagrad im Detail:
Starte mit:
Für jeden Parameter 0t zum Zeitpunkt t berechnest du den Gradienten der Verlustfunktion bezüglich dieses Parameters. Der Gradient gibt an, wie stark und in welche Richtung wir den Parameter anpassen sollten, um den Loss zu verringern. Nennen wir diesen Gradienten gt, wobei t der aktuelle Zeitschritt ist.
Anstatt die Parameter direkt zu aktualisieren, speichert Adagrad für jeden Parameter die aufsummierten quadrierten Gradienten. Für jeden Parameter i berechnest und akkumuliert du in jedem Zeitschritt den quadrierten Gradienten. Diese Summe bezeichnen wir als Gt.
Gt =Gt-1 + gt2
Dabei gilt:
Diese akkumulierten Gradienten ermöglichen es Adagrad, die Lernrate pro Parameter unterschiedlich zu skalieren – je nachdem, wie stark er bereits angepasst wurde.
Mit dem aufsummierten quadrierten Gradienten Gt aktualisieren wir nun jeden Parameter 0t. Die Adagrad-Update-Regel lautet:
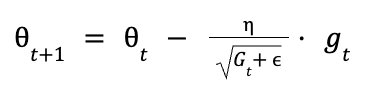
Das passiert dabei:
Der Term:

verkleinert effektiv die Lernrate für Parameter mit großem akkumulierten Gradienten. Umgekehrt erhalten Parameter mit kleinem akkumulierten Gradienten eine größere Lernrate.
So passt Adagrad die Lernrate automatisch an:
PyTorch bringt eine Adagrad-Implementierung im Modul torch.optim mit. Installiere PyTorch zunächst per pip:
pip install torch torchvisionBaue dein erstes neuronales Netz mit unserem kostenlosen Kurs Introduction to Deep Learning with PyTorch.
So implementierst du den Adagrad-Optimizer in PyTorch Schritt für Schritt:
Schritt 1: Benötigte Bibliotheken importieren
import torchimport torch.nn as nnimport torch.optim as optimSchritt 2: Ein einfaches neuronales Netz definieren
class SimpleNN(nn.Module): def __init__(self): super(SimpleNN, self).__init__() self.fc1 = nn.Linear(10, 5) self.fc2 = nn.Linear(5, 2) def forward(self, x): x = torch.relu(self.fc1(x)) x = self.fc2(x) return xSchritt 3: Modell und Optimierer initialisieren
model = SimpleNN()criterion = nn.CrossEntropyLoss()optimizer = optim.Adagrad(model.parameters(), lr=0.01)Schritt 4: Trainingsschleife
for epoch in range(10): # loop over the dataset multiple times inputs = torch.randn(1, 10) # random input tensor labels = torch.tensor([1]) # target labels # Zero the parameter gradients optimizer.zero_grad() # Forward pass outputs = model(inputs) loss = criterion(outputs, labels) # Backward pass and optimize loss.backward() optimizer.step() print(f'Epoch {epoch+1}, Loss: {loss.item()}')In diesem Beispiel trainieren wir ein einfaches lineares Modell mit dem AdaGrad-Optimizer. Die Lernrate ist auf 0,01 gesetzt, wird von Adagrad aber pro Parameter anhand der akkumulierten quadrierten Gradienten angepasst.
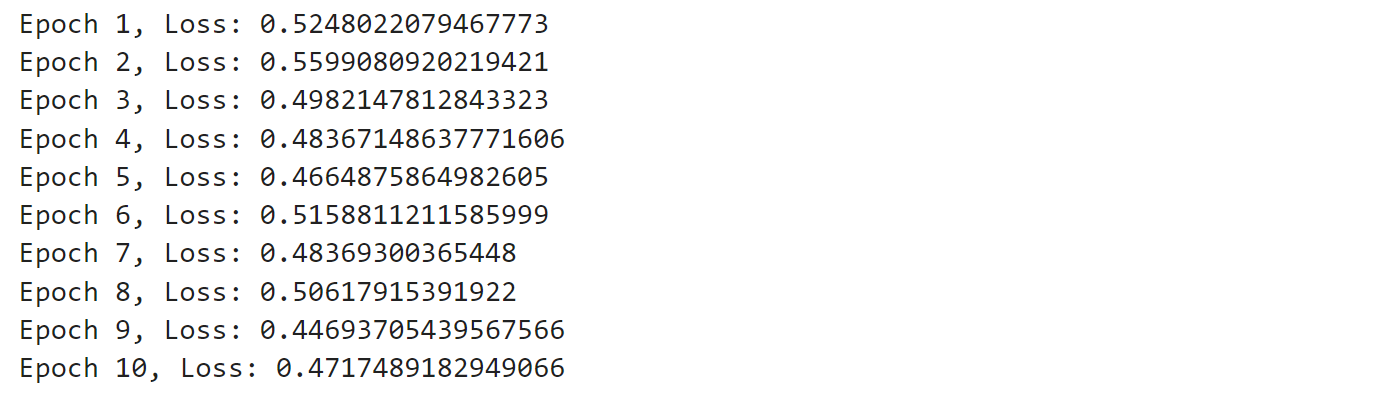
Führst du den Code aus, erhältst du eine Ausgabe ähnlich dieser:
Die Ausgabe zeigt den Loss nach jeder Epoche – ein Indikator, wie gut das Modell lernt. Zu Beginn ist der Loss höher, sinkt aber im Verlauf des Trainings in der Regel, was auf Verbesserungen hindeutet. Schwankungen sind normal, vor allem mit zufälligen Eingaben. Insgesamt sollte sich die Vorhersagequalität steigern.
Wenn du tiefer in Deep Learning einsteigen und sehen willst, wie dieses Feld die Welt verändert, schau dir unseren Track Deep Learning in Python an.
Vergleichen wir Adagrad mit anderen Optimierern wie Adam, SGD und RMSProp.
Sowohl Adagrad als auch Adam passen die Lernrate pro Parameter an, jedoch auf unterschiedliche Weise. Adagrad skaliert basierend auf der Summe quadrierter Gradienten, was die Lernrate mit der Zeit stark schrumpfen lassen kann. Adam nutzt dagegen erste und zweite Momente der Gradienten und hält so die Lernrate stabiler über das Training hinweg.
Adagrad eignet sich besonders gut für spärliche Daten, da seltene Features höhere Lernraten erhalten. Das ist z. B. in der Natural Language Processing hilfreich, wo spärliche Gradienten häufig sind. Adam kann ebenfalls mit spärlichen Daten umgehen, wird aber oft wegen seiner Robustheit und Effizienz in vielen Anwendungen bevorzugt.
Adam überzeugt in der Praxis oft mit schnellerer Konvergenz und starker Performance, besonders bei Deep-Learning-Modellen und großen Datensätzen. Durch Momentum und Bias-Korrektur bleibt Adam seltener in lokalen Minima oder Sattelpunkten hängen – ein Punkt, bei dem Adagrad schwächer sein kann.
Lerne grundlegende Deep-Learning-Architekturen wie CNNs, RNNs, LSTMs und GRUs für Bild- und Sequenzdaten. Sieh dir unseren Kurs Intermediate Deep Learning with PyTorch an.
Vergleichen wir Adagrad mit SGD und RMSProp.
Stochastic Gradient Descent ist ein grundlegender Optimierer, der Parameter mit dem Gradienten der Verlustfunktion aktualisiert. Er ist simpel und leicht umzusetzen. Allerdings nutzt SGD eine konstante Lernrate – ein Nachteil bei spärlichen Daten oder unterschiedlich skalierten Features.
RMSProp ist eine Erweiterung von Adagrad und behebt das Problem der schrumpfenden Lernrate durch einen Abklingfaktor. Dadurch bleibt die Lernrate über das Training hinweg stabiler.
Hier die Vor- und Nachteile von Adagrad, SGD und RMSProp im Überblick:
Optimizer | Pros | Cons |
Adagrad | 1. Passt Lernraten pro Parameter automatisch an. 2. Stark bei spärlichen Daten. 3. Reduziert Bedarf an manuellem Lernraten-Tuning. | 1. Lernrate nimmt über die Zeit stark ab, kann zu verfrühter Konvergenz führen. 2. Später im Training teils sehr langsam. |
SGD | 1. Einfach und leicht zu implementieren. 2. Kann durch Stochastik lokale Minima verlassen. | 1. Hohe Varianz in Updates kann instabil machen. 2. Erfordert sorgfältiges Tuning von Lernrate und Momentum. |
RMSProp | 1. Passt Lernraten anhand gleitender Mittelwerte quadrierter Gradienten an. 2. Geeignet für nicht-stationäre Umgebungen. | 1. Erfordert sorgfältiges Hyperparameter-Tuning. 2. Enthält nicht automatisch Momentum. |
Schauen wir auf typische Einsatzszenarien und Grenzen von Adagrad.
Die Fähigkeit von Adagrad, Lernraten pro Parameter zu adaptieren, macht es ideal für mehrere Szenarien:
Trotz Stärken hat Adagrad auch Schwächen:
Diese Ansätze helfen gegen die Schwächen von Adagrad:
Wir bauen ein kleines neuronales Netz, trainieren es mit Adagrad und vergleichen die Performance mit anderen Optimierern.
Wenn du mehr über PyTorch lernen willst, lies unsere Anleitung PyTorch Tutorial: Building a Simple Neural Network From Scratch.
Starten wir mit einem Basisnetz in PyTorch. Wir entwerfen ein Modell für binäre Klassifikation auf spärlichen Daten – ein Fall, in dem Adagrad glänzt.
import torchimport torch.nn as nnclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return xDas Netz hat eine Eingabeschicht, eine versteckte Schicht mit 50 Neuronen und eine Ausgabeschicht mit einem Neuron. ReLU dient als Aktivierung in der Hidden-Schicht, Sigmoid am Ausgang – ideal für binäre Klassifikation.
Jetzt richten wir den Trainingsprozess mit Adagrad ein und kapseln ihn in einer Funktion:
import torch.optim as optimfrom torch.utils.data import DataLoader, TensorDataset# Function to train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): # loop for each training epoch for inputs, targets in train_loader: # Clear gradients before each batch to avoid accumulation optimizer.zero_grad() # Reset gradients to zero # Forward pass - get model predictions outputs = model(inputs) # Calculate loss based on predictions and targets loss = criterion(outputs, targets) # Backward pass - calculate gradients for parameter updates based on the loss loss.backward() # Update model parameters based on calculated gradients optimizer.step() # Track loss for monitoring training progress losses.append(loss.item()) return losses# Setup for trainingX, y = generate_sparse_data() # This function generates our sparse datasetinput_size = X.shape[1]train_size = int(0.8 * len(X))X_train, X_test = X[:train_size], X[train_size:]y_train, y_test = y[:train_size], y[train_size:]train_dataset = TensorDataset(X_train, y_train)train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)model = SparseNN(input_size)criterion = nn.BCELoss() # Assuming binary classification with BCE lossoPTIMIZER = optim.Adagrad(model.parameters(), lr=0.01)# Train the modellosses = train_model(model, oPTIMIZER, criterion, train_loader)In diesem Setup:
Zur Bewertung erstellen wir eine Evaluationsfunktion:
def evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Evaluate the modeltest_dataset = TensorDataset(X_test, y_test)test_loader = DataLoader(test_dataset, batch_size=32)accuracy = evaluate_model(model, test_loader)print(f"Adagrad Accuracy: {accuracy:.4f}")Diese Funktion berechnet die Genauigkeit des Modells auf dem Testset.
Als Nächstes vergleichen wir mit weiteren gängigen Optimierern: SGD, Adam und RMSprop. Dazu erstellen wir eine Funktion für jeden Optimierer:
def run_experiment(optimizer_class, lr=0.01): model = SparseNN(input_size) criterion = nn.BCELoss() if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) losses = train_model(model, optimizer, criterion, train_loader) accuracy = evaluate_model(model, test_loader) return losses, accuracy# Compare optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Nach der Ausführung erhalten wir zum Beispiel diese Ergebnisse:
Final accuracies:Adagrad: 0.9350SGD: 0.8950Adam: 0.9300RMSprop: 0.8600Hier schneidet Adagrad bei unserem spärlichen Datenset am besten ab – mit der höchsten Genauigkeit von 95,00 %. Das bestätigt, dass Adagrad für spärliche Daten sehr gut geeignet ist. Adam folgt knapp dahinter, während SGD und RMSprop in diesem Fall schwächer performen.
Zur Visualisierung der Trainingsdynamik können wir die Loss-Kurven plotten:
import matplotlib.pyplot as pltplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()Fassen wir alles zusammen – hier ist der vollständige Code:
import torchimport torch.nn as nnimport torch.optim as optimfrom torch.utils.data import DataLoader, TensorDatasetimport matplotlib.pyplot as plt# Step 1: Generate sparse synthetic datadef generate_sparse_data(n_samples=1000, n_features=100, sparsity=0.95): X = torch.randn(n_samples, n_features) mask = torch.rand(n_samples, n_features) < sparsity X[mask] = 0 weights = torch.randn(n_features) y = (torch.matmul(X, weights) > 0).float().view(-1, 1) return X, y# Step 2: Define the neural networkclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return x# Step 3: Train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): for inputs, targets in train_loader: optimizer.zero_grad() outputs = model(inputs) loss = criterion(outputs, targets) loss.backward() optimizer.step() losses.append(loss.item()) return losses# Step 4: Evaluate the modeldef evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Step 5: Main function to run the experimentdef run_experiment(optimizer_class, lr=0.01): # Generate sparse data X, y = generate_sparse_data() input_size = X.shape[1] train_size = int(0.8 * len(X)) X_train, X_test = X[:train_size], X[train_size:] y_train, y_test = y[:train_size], y[train_size:] # Create data loaders train_dataset = TensorDataset(X_train, y_train) test_dataset = TensorDataset(X_test, y_test) train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True) test_loader = DataLoader(test_dataset, batch_size=32) # Initialize model and training components model = SparseNN(input_size) criterion = nn.BCELoss() # Use default hyperparameters for each optimizer if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) # Train the model losses = train_model(model, optimizer, criterion, train_loader) # Evaluate the model accuracy = evaluate_model(model, test_loader) return losses, accuracy# Step 6: Compare Adagrad with other optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}# Step 7: Plot resultsplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")So sieht das Ergebnis aus:
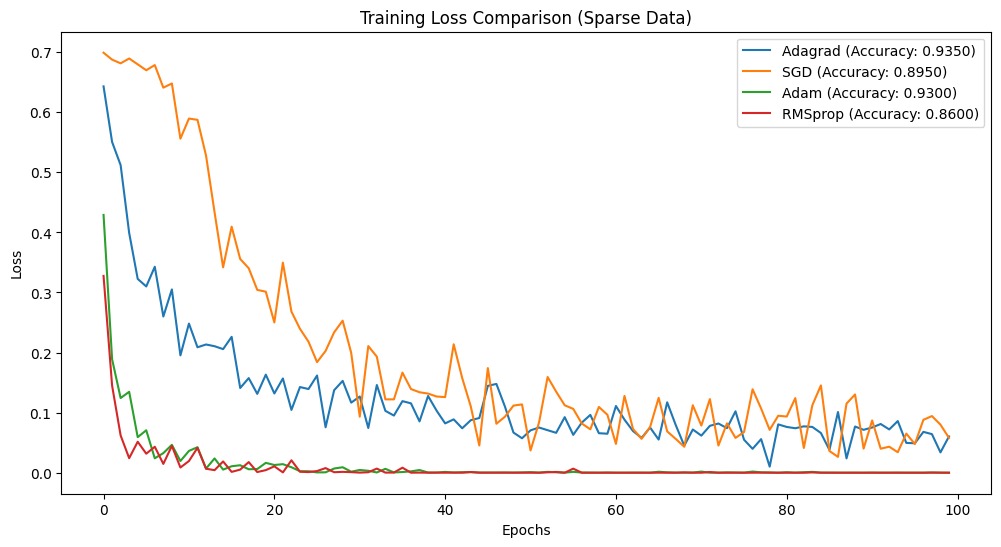
Adagrad ist bei spärlichen Daten besonders hilfreich – dank adaptiver Lernraten. Wir haben ein Basisnetz gebaut, mit Adagrad trainiert und die Performance mit anderen bekannten Optimierungsalgorithmen verglichen. Das Ergebnis spricht klar für Adagrad: Es meistert spärliche Daten in diesem Setup am besten.
Zusätzlich haben wir Top-Ressourcen zu PyTorch, Deep Learning und weiteren Optimierern für dich zusammengestellt. Schau sie dir an und vertiefe dein Wissen:
Top-DataCamp-Kurse
Lernpfad
Kurs
Kurs