लर्निंग पाथ
डीप लर्निंग में Python
18 घंटा
कल्पना कीजिए कि आप एक पहाड़ी से नीचे उतर रहे हैं, लेकिन जैसे-जैसे आप आगे बढ़ते हैं, ज़मीन बदलती रहती है—कुछ हिस्से खड़ी ढलान वाले हैं और कुछ समतल। अगर आप हर बार एक ही लंबाई का कदम लें, तो आपको नीचे तक पहुँचने में दिक्कत आ सकती है या बहुत समय लग सकता है। मशीन लर्निंग में भी ग्रेडिएंट डिसेंट में कुछ ऐसा ही होता है, जहाँ सभी पैरामीटर्स के लिए एक ही लर्निंग रेट का उपयोग करना सीखने की गति को धीमा कर सकता है।
यहीं Adagrad काम आता है। यह प्रत्येक पैरामीटर के लिए प्रशिक्षण के दौरान हुए बदलाव के आधार पर स्टेप साइज को समायोजित करता है, जिससे मॉडल तेज़ और प्रभावी ढंग से सीखता है—खासकर तब, जब अलग-अलग फीचर्स के स्केल अलग-अलग हों। इस लेख में, हम समझेंगे कि Adagrad कैसे काम करता है और इसके पीछे का गणित सरल शब्दों में जानेंगे। साथ ही, हम आपको PyTorch में इसका इम्प्लीमेंटेशन दिखाएँगे और अन्य ऑप्टिमाइज़र्स से तुलना करेंगे ताकि आप अपने प्रोजेक्ट्स के लिए सबसे अच्छा चुन सकें।
Adagrad (Adaptive Gradient) एक ऑप्टिमाइज़ेशन एल्गोरिद्म है जिसका उपयोग मशीन लर्निंग में विशेष रूप से डीप न्यूरल नेटवर्क्स को ट्रेन करने के लिए किया जाता है। यह प्रत्येक पैरामीटर के लिए उसके ऐतिहासिक ग्रेडिएंट्स के आधार पर लर्निंग रेट को अनुकूलित करने के लिए डिज़ाइन किया गया है। यह तरीका मशीन लर्निंग मॉडलों की दक्षता में सुधार करता है, खासकर तब जब डेटा स्पार्स हो या अलग-अलग पैरामीटर्स की कन्वर्जेंस रेट अलग हो।
Adagrad कम बार आने वाली विशेषताओं के लिए उच्च लर्निंग रेट और अधिक बार आने वाली विशेषताओं के लिए कम रेट प्रदान करता है, जो इसे स्पार्स डेटा के साथ काम करने के लिए उपयुक्त बनाता है। इसके अलावा, यह मैन्युअल रूप से लर्निंग रेट ट्यून करने की आवश्यकता को भी कम करता है!
आइए Adagrad एल्गोरिद्म को चरणों में समझते हैं:
सबसे पहले, शुरू करें:
प्रत्येक पैरामीटर 0t समय चरण t पर, लॉस फ़ंक्शन का उस पैरामीटर के सापेक्ष ग्रेडिएंट निकालते हैं। यह ग्रेडिएंट बताता है कि लॉस कम करने के लिए पैरामीटर को कितना और किस दिशा में अपडेट करना चाहिए। इसे हम कहते हैं gt, जहाँ t वर्तमान समय चरण है।
पैरामीटर्स को सीधे अपडेट करने के बजाय, Adagrad प्रत्येक पैरामीटर के लिए ग्रेडिएंट्स के स्क्वेयर्ड सम का ट्रैक रखता है। प्रत्येक पैरामीटर i के लिए, हर समय चरण पर स्क्वेयर्ड ग्रेडिएंट की गणना कर उसे जमा करते हैं। इस संचित ग्रेडिएंट को Gt के रूप में दर्शाते हैं।
Gt =Gt-1 + gt2
यहाँ:
यह संचित ग्रेडिएंट Adagrad को प्रत्येक पैरामीटर के लिए, उसके अपडेट होने की मात्रा के आधार पर, अलग-अलग तरीके से लर्निंग रेट समायोजित करने में मदद करता है।
अब जब आपके पास संचित स्क्वेयर्ड ग्रेडिएंट Gt है, तो हम प्रत्येक पैरामीटर 0t को अपडेट कर सकते हैं। Adagrad के लिए अपडेट नियम इस प्रकार है:
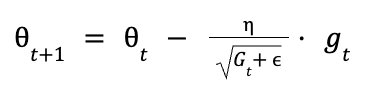
यहाँ क्या हो रहा है:
यह पद:

उन पैरामीटर्स के लिए लर्निंग रेट को प्रभावी रूप से कम कर देता है जिनका संचित ग्रेडिएंट बड़ा होता है। इसके विपरीत, जिन पैरामीटर्स के संचित ग्रेडिएंट छोटे होते हैं, उनके लिए लर्निंग रेट बड़ा रहता है।
Adagrad का सूत्र स्वतः लर्निंग रेट को अनुकूलित करता है, इस प्रकार:
PyTorch में Adagrad का बिल्ट-इन इम्प्लीमेंटेशन उपलब्ध है, जिसे torch.optim मॉड्यूल के माध्यम से एक्सेस किया जा सकता है। पहले, pip का उपयोग करके PyTorch इंस्टॉल करें:
pip install torch torchvisionअपना पहला न्यूरल नेटवर्क बनाना सीखें हमारे निःशुल्क कोर्स Introduction to Deep Learning with PyTorch के साथ।
यहाँ PyTorch में Adagrad ऑप्टिमाइज़र को इम्प्लीमेंट करने की चरणबद्ध गाइड है:
चरण 1: आवश्यक लाइब्रेरीज़ इम्पोर्ट करें
import torchimport torch.nn as nnimport torch.optim as optimचरण 2: एक साधारण न्यूरल नेटवर्क परिभाषित करें
class SimpleNN(nn.Module): def __init__(self): super(SimpleNN, self).__init__() self.fc1 = nn.Linear(10, 5) self.fc2 = nn.Linear(5, 2) def forward(self, x): x = torch.relu(self.fc1(x)) x = self.fc2(x) return xचरण 3: मॉडल और ऑप्टिमाइज़र इनिशियलाइज़ करें
model = SimpleNN()criterion = nn.CrossEntropyLoss()optimizer = optim.Adagrad(model.parameters(), lr=0.01)चरण 4: ट्रेनिंग लूप
for epoch in range(10): # loop over the dataset multiple times inputs = torch.randn(1, 10) # random input tensor labels = torch.tensor([1]) # target labels # Zero the parameter gradients optimizer.zero_grad() # Forward pass outputs = model(inputs) loss = criterion(outputs, labels) # Backward pass and optimize loss.backward() optimizer.step() print(f'Epoch {epoch+1}, Loss: {loss.item()}')इस कोड में, एक साधारण लीनियर मॉडल को AdaGrad ऑप्टिमाइज़र का उपयोग करके ट्रेन किया गया है। लर्निंग रेट 0.01 सेट है, लेकिन AdaGrad संचित स्क्वेयर्ड ग्रेडिएंट्स के आधार पर प्रत्येक पैरामीटर के लिए इसे समायोजित करेगा।
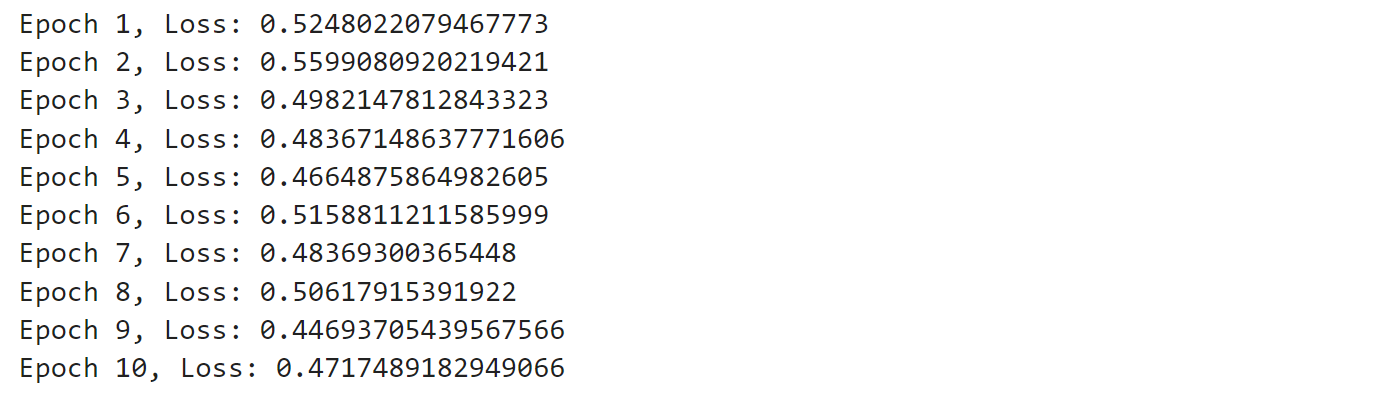
कोड चलाएँ, और आपको कुछ ऐसा आउटपुट दिखाई देगा:
आउटपुट प्रत्येक epoch के बाद का लॉस दिखाता है, जो बताता है कि मॉडल कितना अच्छा सीख रहा है। शुरुआत में लॉस अधिक होता है, लेकिन ट्रेनिंग बढ़ने के साथ, लॉस आमतौर पर घटता है, यानी मॉडल में सुधार हो रहा है। कुछ उतार-चढ़ाव सामान्य हैं, खासकर रैंडम इनपुट्स के साथ, लेकिन समग्र रूप से, मॉडल धीरे-धीरे बेहतर भविष्यवाणियाँ करना सीखता है।
यदि आप डीप लर्निंग को समझना चाहते हैं और जानना चाहते हैं कि मशीन लर्निंग की यह शाखा दुनिया को कैसे बदल रही है, तो हमारा कोर्स देखें Deep Learning in Python।
आइए Adagrad की तुलना अन्य ऑप्टिमाइज़र्स जैसे Adam, SGD और RMSProp से करते हैं।
Adagrad और Adam दोनों ही प्रत्येक पैरामीटर के लिए लर्निंग रेट को अनुकूलित करते हैं, लेकिन अलग-अलग तरीकों से। Adagrad लर्निंग रेट को स्क्वेयर्ड ग्रेडिएंट्स के सम के आधार पर स्केल करता है, जिससे समय के साथ लर्निंग रेट बहुत कम हो सकता है। दूसरी ओर, Adam ग्रेडिएंट्स के प्रथम और द्वितीय मोमेंट्स का उपयोग करता है, जिससे ट्रेनिंग के दौरान लर्निंग रेट अधिक स्थिर बना रहता है।
Adagrad स्पार्स डेटा को संभालने के लिए विशेष रूप से उपयुक्त है क्योंकि यह कम-आवृत्ति वाली विशेषताओं को बड़ा लर्निंग रेट देता है। यह नेचुरल लैंग्वेज प्रोसेसिंग जैसे अनुप्रयोगों के लिए एक अच्छा विकल्प है, जहाँ स्पार्स ग्रेडिएंट्स आम हैं। Adam भी स्पार्स डेटा को संभाल सकता है, लेकिन आमतौर पर इसकी समग्र मजबूती और व्यापक अनुप्रयोगों में दक्षता के कारण इसे प्राथमिकता दी जाती है।
व्यवहार में तेज़ कन्वर्जेंस और बेहतर प्रदर्शन के लिए अक्सर Adam को प्राथमिकता दी जाती है, खासकर डीप लर्निंग मॉडलों और बड़े डेटासेट्स में। मोमेंटम और बायस करेक्शन का उपयोग इसे लोकल मिनिमा और सैडल पॉइंट्स में फँसने से बचाता है, जो Adagrad की एक सीमा हो सकती है।
इमेज और सीक्वेंस डेटा के मॉडलिंग के लिए CNNs, RNNs, LSTMs और GRUs जैसी मूलभूत डीप लर्निंग आर्किटेक्चर्स के बारे में जानें। हमारा कोर्स देखें Intermediate Deep Learning with PyTorch।
आइए Adagrad की तुलना SGD और RMSProp से करें
Stochastic Gradient Descent एक बुनियादी ऑप्टिमाइज़ेशन एल्गोरिद्म है जो पैरामीटर्स के सापेक्ष लॉस फ़ंक्शन के ग्रेडिएंट का उपयोग करके मॉडल पैरामीटर्स को अपडेट करता है। यह अपनी सादगी और आसान इम्प्लीमेंटेशन के लिए जाना जाता है। हालाँकि, SGD का लर्निंग रेट स्थिर रहता है, जो स्पार्स डेटा या अलग-अलग फीचर स्केल के साथ काम करते समय एक सीमा हो सकती है।
RMSProp, AdaGrad का एक विस्तार है जो डिके फ़ैक्टर पेश करके इसके घटते लर्निंग रेट की समस्या को संबोधित करता है। यह डिके फ़ैक्टर ट्रेनिंग प्रक्रिया के दौरान अधिक स्थिर लर्निंग रेट बनाए रखने में मदद करता है।
आइए Adagrad, SGD और RMSProp के फायदे और नुकसान को संक्षेप में देखें:
ऑप्टिमाइज़र | फायदे | नुकसान |
Adagrad | 1. प्रत्येक पैरामीटर के लिए लर्निंग रेट स्वतः अनुकूलित करता है। 2. स्पार्स डेटा के लिए प्रभावी। 3. लर्निंग रेट को मैन्युअल रूप से ट्यून करने की आवश्यकता समाप्त करता है। | 1. लर्निंग रेट समय के साथ घटता है, जिससे समय से पहले कन्वर्जेंस हो सकता है। 2. ट्रेनिंग के बाद के चरणों में बहुत धीमा हो सकता है। |
SGD | 1. सरल और इम्प्लीमेंट करना आसान। 2. स्टोकेस्टिक प्रकृति के कारण लोकल मिनिमा से बाहर निकलने में सक्षम। | 1. अपडेट्स में उच्च वैरिएंस अस्थिरता ला सकता है। 2. लर्निंग रेट और मोमेंटम का सावधानीपूर्वक ट्यूनिंग आवश्यक। |
RMSProp | 1. स्क्वेयर्ड ग्रेडिएंट्स के मूविंग एवरेज के आधार पर लर्निंग रेट को अनुकूलित करता है। 2. नॉन-स्टेशनरी एन्वॉयरनमेंट्स के लिए उपयुक्त। | 1. हाइपरपैरामीटर्स का सावधानीपूर्वक ट्यूनिंग आवश्यक। 2. स्वाभाविक रूप से मोमेंटम को शामिल नहीं करता। |
आइए विभिन्न संदर्भों में AdaGrad के उपयोग मामलों और सीमाओं का पता लगाएँ।
प्रत्येक पैरामीटर के लिए लर्निंग रेट को अनुकूलित करने की Adagrad की अनोखी क्षमता इसे कई परिदृश्यों के लिए आदर्श बनाती है:
हालाँकि Adagrad कुछ स्थितियों में शक्तिशाली है, इसके साथ कुछ सीमाएँ भी आती हैं:
Adagrad की सीमाओं का समाधान करने के लिए आप कई रणनीतियाँ अपना सकते हैं:
आइए एक साधारण न्यूरल नेटवर्क बनाएँ, उसे Adagrad ऑप्टिमाइज़र का उपयोग करके ट्रेन करें, और इसके प्रदर्शन की तुलना अन्य लोकप्रिय ऑप्टिमाइज़र्स से करें।
यदि आप PyTorch के बारे में अधिक सीखना चाहते हैं, तो हमारा गाइड देखें PyTorch Tutorial: Building a Simple Neural Network From Scratch.
आइए PyTorch में एक बेसिक न्यूरल नेटवर्क मॉडल बनाकर शुरू करें। हम ऐसा नेटवर्क डिज़ाइन करेंगे जो स्पार्स डेटा पर बाइनरी क्लासिफिकेशन के लिए उपयुक्त हो, जहाँ Adagrad बेहतरीन काम करता है।
import torchimport torch.nn as nnclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return xइस न्यूरल नेटवर्क में एक इनपुट लेयर, 50 न्यूरॉन्स वाली एक हिडन लेयर, और एक सिंगल न्यूरॉन वाली आउटपुट लेयर है। हिडन लेयर के लिए ReLU और आउटपुट लेयर के लिए Sigmoid एक्टिवेशन का उपयोग करते हैं, जो इसे बाइनरी क्लासिफिकेशन के लिए उपयुक्त बनाता है।
अब, Adagrad ऑप्टिमाइज़र का उपयोग करके अपनी ट्रेनिंग प्रक्रिया सेट करें। हम ट्रेनिंग को हैंडल करने के लिए एक फ़ंक्शन बनाएँगे:
import torch.optim as optimfrom torch.utils.data import DataLoader, TensorDataset# Function to train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): # loop for each training epoch for inputs, targets in train_loader: # Clear gradients before each batch to avoid accumulation optimizer.zero_grad() # Reset gradients to zero # Forward pass - get model predictions outputs = model(inputs) # Calculate loss based on predictions and targets loss = criterion(outputs, targets) # Backward pass - calculate gradients for parameter updates based on the loss loss.backward() # Update model parameters based on calculated gradients optimizer.step() # Track loss for monitoring training progress losses.append(loss.item()) return losses# Setup for trainingX, y = generate_sparse_data() # This function generates our sparse datasetinput_size = X.shape[1]train_size = int(0.8 * len(X))X_train, X_test = X[:train_size], X[train_size:]y_train, y_test = y[:train_size], y[train_size:]train_dataset = TensorDataset(X_train, y_train)train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)model = SparseNN(input_size)criterion = nn.BCELoss() # Assuming binary classification with BCE lossoptimizer = optim.Adagrad(model.parameters(), lr=0.01)# Train the modellosses = train_model(model, optimizer, criterion, train_loader)इस सेटअप में, हम:
अब, अपने मॉडल के प्रदर्शन का आकलन करने के लिए, हम एक इवैल्युएशन फ़ंक्शन बनाएँगे:
def evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Evaluate the modeltest_dataset = TensorDataset(X_test, y_test)test_loader = DataLoader(test_dataset, batch_size=32)accuracy = evaluate_model(model, test_loader)print(f"Adagrad Accuracy: {accuracy:.4f}")यह फ़ंक्शन टेस्ट सेट पर हमारे मॉडल की एक्यूरेसी की गणना करता है।
अब, इसकी तुलना अन्य लोकप्रिय ऑप्टिमाइज़र्स—SGD, Adam, और RMSprop—से करें। हम प्रत्येक ऑप्टिमाइज़र के लिए प्रयोग चलाने वाला फ़ंक्शन बनाएँगे:
def run_experiment(optimizer_class, lr=0.01): model = SparseNN(input_size) criterion = nn.BCELoss() if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) losses = train_model(model, optimizer, criterion, train_loader) accuracy = evaluate_model(model, test_loader) return losses, accuracy# Compare optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")यह कोड चलाने के बाद, हमें निम्न परिणाम मिलते हैं:
Final accuracies:Adagrad: 0.9350SGD: 0.8950Adam: 0.9300RMSprop: 0.8600ये परिणाम दिखाते हैं कि हमारे स्पार्स डेटा समस्या पर Adagrad ने सबसे अच्छा प्रदर्शन किया, 95.00% की सर्वाधिक एक्यूरेसी प्राप्त की। यह दर्शाता है कि Adagrad स्पार्स डेटा परिदृश्यों के लिए उपयुक्त है। Adam क़रीब-क़रीब दूसरे स्थान पर रहा, जबकि इस विशेष मामले में SGD और RMSprop का प्रदर्शन कमज़ोर रहा।
ट्रेनिंग प्रक्रिया को विज़ुअलाइज़ करने के लिए, हम लॉस कर्व्स प्लॉट कर सकते हैं:
import matplotlib.pyplot as pltplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()आइए सभी कोड स्निपेट्स को जोड़ें, और यह रहा पूरा कोड।
import torchimport torch.nn as nnimport torch.optim as optimfrom torch.utils.data import DataLoader, TensorDatasetimport matplotlib.pyplot as plt# Step 1: Generate sparse synthetic datadef generate_sparse_data(n_samples=1000, n_features=100, sparsity=0.95): X = torch.randn(n_samples, n_features) mask = torch.rand(n_samples, n_features) < sparsity X[mask] = 0 weights = torch.randn(n_features) y = (torch.matmul(X, weights) > 0).float().view(-1, 1) return X, y# Step 2: Define the neural networkclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return x# Step 3: Train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): for inputs, targets in train_loader: optimizer.zero_grad() outputs = model(inputs) loss = criterion(outputs, targets) loss.backward() optimizer.step() losses.append(loss.item()) return losses# Step 4: Evaluate the modeldef evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Step 5: Main function to run the experimentdef run_experiment(optimizer_class, lr=0.01): # Generate sparse data X, y = generate_sparse_data() input_size = X.shape[1] train_size = int(0.8 * len(X)) X_train, X_test = X[:train_size], X[train_size:] y_train, y_test = y[:train_size], y[train_size:] # Create data loaders train_dataset = TensorDataset(X_train, y_train) test_dataset = TensorDataset(X_test, y_test) train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True) test_loader = DataLoader(test_dataset, batch_size=32) # Initialize model and training components model = SparseNN(input_size) criterion = nn.BCELoss() # Use default hyperparameters for each optimizer if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) # Train the model losses = train_model(model, optimizer, criterion, train_loader) # Evaluate the model accuracy = evaluate_model(model, test_loader) return losses, accuracy# Step 6: Compare Adagrad with other optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}# Step 7: Plot resultsplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")यह रहा परिणाम:
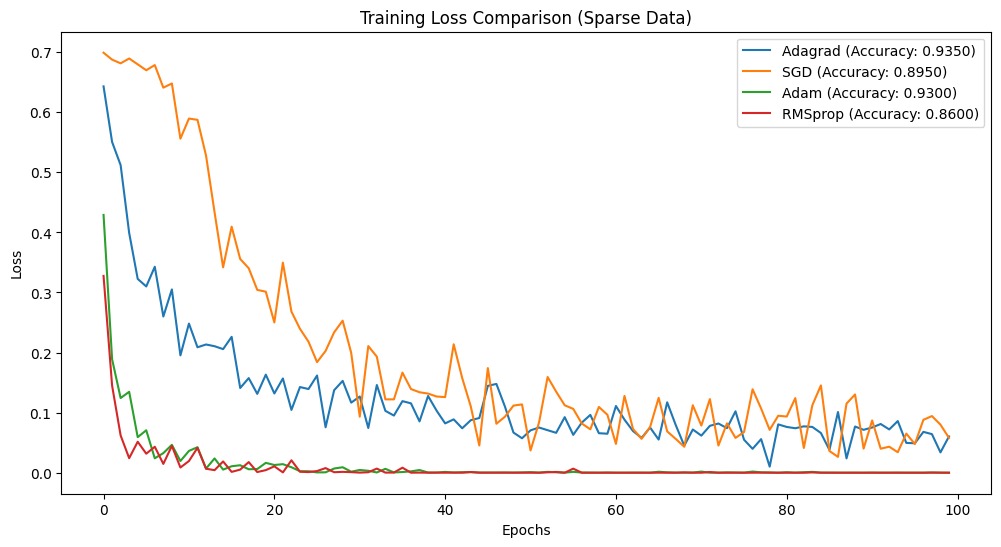
Adagrad स्पार्स डेटा के साथ काम करते समय उपयोगी है क्योंकि इसका लर्निंग रेट अनुकूलनशील होता है। हमने एक बेसिक न्यूरल नेटवर्क बनाया और उसे Adagrad से ट्रेन किया, फिर इसके प्रदर्शन की तुलना अन्य प्रसिद्ध ऑप्टिमाइज़ेशन एल्गोरिद्म से की। परिणामों ने स्पष्ट रूप से Adagrad के पक्ष में संकेत दिया, यह दिखाते हुए कि यह स्पार्स डेटा को बेहतर संभालता है।
मैंने PyTorch, डीप लर्निंग, और अन्य ऑप्टिमाइज़ेशन एल्गोरिद्म पर कुछ बेहतरीन संसाधन भी चुने हैं। अधिक गहराई से सीखने के लिए इन्हें अवश्य देखें:
टॉप DataCamp कोर्स
लर्निंग पाथ
कोर्स
कोर्स