Programma
Apprendimento profondo in Python
18 ore
Immagina di scendere da una collina, ma il terreno cambia lungo il percorso: alcuni tratti sono ripidi, altri pianeggianti. Se fai sempre passi della stessa misura, potresti faticare o metterci troppo ad arrivare in fondo. Nel machine learning succede qualcosa di simile con il gradient descent, dove usare lo stesso learning rate per tutti i parametri può rallentare l’apprendimento.
Qui entra in gioco Adagrad. Regola l’ampiezza del passo per ogni parametro in base a quanto è cambiato durante l’addestramento, aiutando il modello a imparare più rapidamente ed efficacemente, soprattutto quando le caratteristiche hanno scale diverse. In questo articolo vedremo come funziona Adagrad e ne spiegheremo la matematica. Inoltre, ti mostreremo come implementarlo con PyTorch e lo confronteremo con altri ottimizzatori, così potrai scegliere il migliore per i tuoi progetti.
Adagrad (Adaptive Gradient) è un algoritmo di ottimizzazione usato nel machine learning, in particolare per addestrare reti neurali profonde. È progettato per adattare il learning rate di ciascun parametro in base ai gradienti storici. Questo approccio consente ad Adagrad di migliorare l’efficienza dei modelli di machine learning, soprattutto in scenari con dati sparsi o quando i diversi parametri hanno velocità di convergenza differenti.
Adagrad assegna learning rate più alti alle feature meno frequenti e più bassi a quelle più frequenti, il che lo rende adatto a lavorare con dati sparsi. Inoltre, riduce la necessità di regolare manualmente il learning rate!
Vediamo nel dettaglio l’algoritmo Adagrad:
Per prima cosa, parti da:
Per ogni parametro 0t al passo temporale t, calcoli il gradiente della funzione di perdita rispetto a quel parametro. Questo gradiente ci indica quanto e in che direzione aggiornare il parametro per ridurre la perdita. Chiamiamo questo gradiente gt, dove t è il passo temporale corrente.
Invece di aggiornare direttamente i parametri, Adagrad tiene traccia della somma dei gradienti al quadrato per ciascun parametro. Per ogni parametro i, a ogni passo temporale calcoli e accumuli il gradiente al quadrato. Questo gradiente accumulato è indicato come Gt.
Gt =Gt-1 + gt2
Ecco cosa significa:
Questo gradiente accumulato aiuta Adagrad ad adattare in modo diverso il learning rate per ciascun parametro in base a quanto è stato aggiornato.
Ora che hai il gradiente al quadrato accumulato Gt, possiamo aggiornare ogni parametro 0t. La regola di aggiornamento di Adagrad è la seguente:
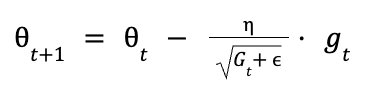
Ecco cosa succede:
Il termine:

riduce di fatto il learning rate per i parametri che hanno un gradiente accumulato grande. Al contrario, i parametri con gradienti accumulati più piccoli avranno un learning rate maggiore.
La formula di Adagrad adatta automaticamente il learning rate, ecco come:
PyTorch fornisce un’implementazione integrata di Adagrad, accessibile tramite il modulo torch.optim. Per prima cosa, installa PyTorch con pip:
pip install torch torchvisionImpara a costruire la tua prima rete neurale con il nostro corso gratuito, Introduction to Deep Learning with PyTorch.
Ecco una guida passo passo per implementare l’ottimizzatore Adagrad in PyTorch:
Passo 1: Importa le librerie necessarie
import torchimport torch.nn as nnimport torch.optim as optimPasso 2: Definisci una semplice rete neurale
class SimpleNN(nn.Module): def __init__(self): super(SimpleNN, self).__init__() self.fc1 = nn.Linear(10, 5) self.fc2 = nn.Linear(5, 2) def forward(self, x): x = torch.relu(self.fc1(x)) x = self.fc2(x) return xPasso 3: Inizializza il modello e l’ottimizzatore
model = SimpleNN()criterion = nn.CrossEntropyLoss()optimizer = optim.Adagrad(model.parameters(), lr=0.01)Passo 4: Ciclo di training
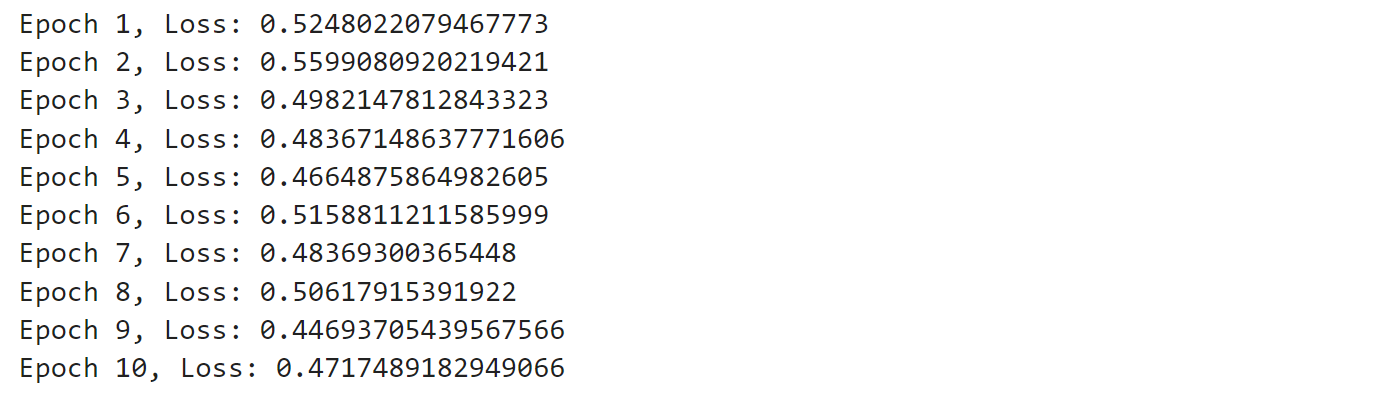
for epoch in range(10): # loop over the dataset multiple times inputs = torch.randn(1, 10) # random input tensor labels = torch.tensor([1]) # target labels # Zero the parameter gradients optimizer.zero_grad() # Forward pass outputs = model(inputs) loss = criterion(outputs, labels) # Backward pass and optimize loss.backward() optimizer.step() print(f'Epoch {epoch+1}, Loss: {loss.item()}')In questo codice, un semplice modello lineare viene addestrato usando l’ottimizzatore AdaGrad. Il learning rate è impostato a 0,01, ma AdaGrad lo regolerà per ogni parametro in base ai gradienti al quadrato accumulati.
Esegui il codice e vedrai un output simile a questo:
L’output mostra la loss dopo ogni epoca, indicando quanto bene il modello sta imparando. All’inizio la loss è più alta, ma man mano che l’addestramento procede in genere diminuisce, segno che il modello migliora. Alcune fluttuazioni sono normali, soprattutto con input casuali, ma nel complesso il modello impara gradualmente a fare previsioni migliori.
Se vuoi scoprire il deep learning ed esplorare come questo ambito del machine learning sta cambiando il mondo, dai un’occhiata al nostro corso Deep Learning in Python.
Confrontiamo Adagrad con altri ottimizzatori come Adam, SGD e RMSProp.
Sia Adagrad che Adam adattano il learning rate per ciascun parametro, ma in modi diversi. Adagrad scala il learning rate in base alla somma dei gradienti al quadrato, il che può portare a learning rate che diminuiscono nel tempo. Adam invece usa sia il primo sia il secondo momento dei gradienti, permettendo di mantenere un learning rate più stabile durante l’addestramento.
Adagrad è particolarmente adatto a gestire dati sparsi grazie alla sua capacità di assegnare learning rate maggiori alle feature meno frequenti. Questo lo rende una buona scelta per applicazioni come il natural language processing, dove i gradienti sparsi sono comuni. Adam, pur essendo in grado di gestire dati sparsi, è generalmente preferito per la sua robustezza ed efficienza complessive in un ampio ventaglio di applicazioni.
Adam è spesso preferito per la convergenza più rapida e le prestazioni superiori nella pratica, soprattutto nei modelli di deep learning con grandi dataset. L’uso del momentum e la correzione della bias lo aiutano a evitare di incagliarsi in minimi locali e punti di sella, che possono rappresentare un limite per Adagrad.
Scopri le architetture fondamentali del deep learning come CNN, RNN, LSTM e GRU per modellare dati di immagine e sequenziali. Dai un’occhiata al nostro corso Intermediate Deep Learning with PyTorch.
Confrontiamo Adagrad con SGD e RMSProp
Stochastic Gradient Descent è un algoritmo di ottimizzazione di base che aggiorna i parametri del modello usando il gradiente della funzione di perdita rispetto ai parametri. È noto per la sua semplicità e facilità di implementazione. Tuttavia, SGD ha un learning rate costante, che può essere un limite quando si lavora con dati sparsi o con scale delle feature variabili.
RMSProp è un’estensione di AdaGrad che affronta il problema del learning rate decrescente introducendo un fattore di decadimento. Questo consente a RMSProp di mantenere un learning rate più stabile durante l’addestramento.
Riepiloghiamo pro e contro di Adagrad, SGD e RMSProp:
Ottimizzatore | Pro | Contro |
Adagrad | 1. Adatta automaticamente i learning rate per ciascun parametro. 2. Efficace con dati sparsi. 3. Elimina la necessità di tarare manualmente il learning rate. | 1. Il learning rate decresce nel tempo, portando potenzialmente a convergenza prematura. 2. Può diventare troppo lento nelle fasi avanzate di training. |
SGD | 1. Semplice e facile da implementare. 2. Efficace nell’uscire dai minimi locali grazie alla natura stocastica. | 1. Alta varianza negli aggiornamenti può portare a instabilità. 2. Richiede un’attenta regolazione di learning rate e momentum. |
RMSProp | 1. Adatta i learning rate in base alla media mobile dei gradienti al quadrato. 2. Adatto ad ambienti non stazionari. | 1. Richiede un’attenta taratura degli iperparametri. 2. Non incorpora intrinsecamente il momentum. |
Esploriamo i casi d’uso e le limitazioni di AdaGrad in vari contesti.
La capacità unica di Adagrad di adattare i learning rate per ciascun parametro lo rende ideale in diversi scenari:
Sebbene Adagrad sia potente in alcune situazioni, presenta alcune limitazioni:
Esistono diverse strategie per affrontare le limitazioni di Adagrad:
Creiamo una semplice rete neurale, addestriamola usando l’ottimizzatore Adagrad e confrontiamo le sue prestazioni con altri ottimizzatori popolari.
Se vuoi saperne di più su PyTorch, consulta la nostra guida PyTorch Tutorial: Building a Simple Neural Network From Scratch.
Iniziamo creando un modello di rete neurale di base in PyTorch. Progetteremo una rete adatta alla classificazione binaria su dati sparsi, dove Adagrad dà il meglio.
import torchimport torch.nn as nnclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return xQuesta rete neurale ha uno strato di input, uno strato nascosto con 50 neuroni e uno strato di output con un singolo neurone. Usiamo ReLU come attivazione per lo strato nascosto e Sigmoid per l’output, rendendola adatta alla classificazione binaria.
Ora configuriamo il processo di training usando l’ottimizzatore Adagrad. Creeremo una funzione per gestire l’addestramento:
import torch.optim as optimfrom torch.utils.data import DataLoader, TensorDataset# Function to train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): # loop for each training epoch for inputs, targets in train_loader: # Clear gradients before each batch to avoid accumulation optimizer.zero_grad() # Reset gradients to zero # Forward pass - get model predictions outputs = model(inputs) # Calculate loss based on predictions and targets loss = criterion(outputs, targets) # Backward pass - calculate gradients for parameter updates based on the loss loss.backward() # Update model parameters based on calculated gradients optimizer.step() # Track loss for monitoring training progress losses.append(loss.item()) return losses# Setup for trainingX, y = generate_sparse_data() # This function generates our sparse datasetinput_size = X.shape[1]train_size = int(0.8 * len(X))X_train, X_test = X[:train_size], X[train_size:]y_train, y_test = y[:train_size], y[train_size:]train_dataset = TensorDataset(X_train, y_train)train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)model = SparseNN(input_size)criterion = nn.BCELoss() # Assuming binary classification with BCE losssoptimizer = optim.Adagrad(model.parameters(), lr=0.01)# Train the modellosses = train_model(model, optimizer, criterion, train_loader)In questa configurazione:
Ora, per valutare le prestazioni del modello, creiamo una funzione di valutazione:
def evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Evaluate the modeltest_dataset = TensorDataset(X_test, y_test)test_loader = DataLoader(test_dataset, batch_size=32)accuracy = evaluate_model(model, test_loader)print(f"Adagrad Accuracy: {accuracy:.4f}")Questa funzione calcola l’accuratezza del modello sul set di test.
Successivamente, confrontiamolo con altri ottimizzatori popolari: SGD, Adam e RMSprop. Creeremo una funzione per eseguire l’esperimento per ciascun ottimizzatore:
def run_experiment(optimizer_class, lr=0.01): model = SparseNN(input_size) criterion = nn.BCELoss() if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) losses = train_model(model, optimizer, criterion, train_loader) accuracy = evaluate_model(model, test_loader) return losses, accuracy# Compare optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Dopo aver eseguito questo codice, otteniamo i seguenti risultati:
Final accuracies:Adagrad: 0.9350SGD: 0.8950Adam: 0.9300RMSprop: 0.8600Questi risultati mostrano che Adagrad ha ottenuto le prestazioni migliori nel nostro problema con dati sparsi, raggiungendo l’accuratezza più alta del 95,00%. Ciò dimostra che Adagrad è ben adatto a scenari con dati sparsi. Adam è arrivato poco dietro, mentre SGD e RMSprop hanno performato peggio in questo caso specifico.
Per visualizzare il processo di training, possiamo tracciare le curve della loss:
import matplotlib.pyplot as pltplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()Uniamo tutti gli snippet ed ecco il codice completo.
import torchimport torch.nn as nnimport torch.optim as optimfrom torch.utils.data import DataLoader, TensorDatasetimport matplotlib.pyplot as plt# Step 1: Generate sparse synthetic datadef generate_sparse_data(n_samples=1000, n_features=100, sparsity=0.95): X = torch.randn(n_samples, n_features) mask = torch.rand(n_samples, n_features) < sparsity X[mask] = 0 weights = torch.randn(n_features) y = (torch.matmul(X, weights) > 0).float().view(-1, 1) return X, y# Step 2: Define the neural networkclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return x# Step 3: Train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): for inputs, targets in train_loader: optimizer.zero_grad() outputs = model(inputs) loss = criterion(outputs, targets) loss.backward() optimizer.step() losses.append(loss.item()) return losses# Step 4: Evaluate the modeldef evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Step 5: Main function to run the experimentdef run_experiment(optimizer_class, lr=0.01): # Generate sparse data X, y = generate_sparse_data() input_size = X.shape[1] train_size = int(0.8 * len(X)) X_train, X_test = X[:train_size], X[train_size:] y_train, y_test = y[:train_size], y[train_size:] # Create data loaders train_dataset = TensorDataset(X_train, y_train) test_dataset = TensorDataset(X_test, y_test) train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True) test_loader = DataLoader(test_dataset, batch_size=32) # Initialize model and training components model = SparseNN(input_size) criterion = nn.BCELoss() # Use default hyperparameters for each optimizer if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) # Train the model losses = train_model(model, optimizer, criterion, train_loader) # Evaluate the model accuracy = evaluate_model(model, test_loader) return losses, accuracy# Step 6: Compare Adagrad with other optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}# Step 7: Plot resultsplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Ecco il risultato:
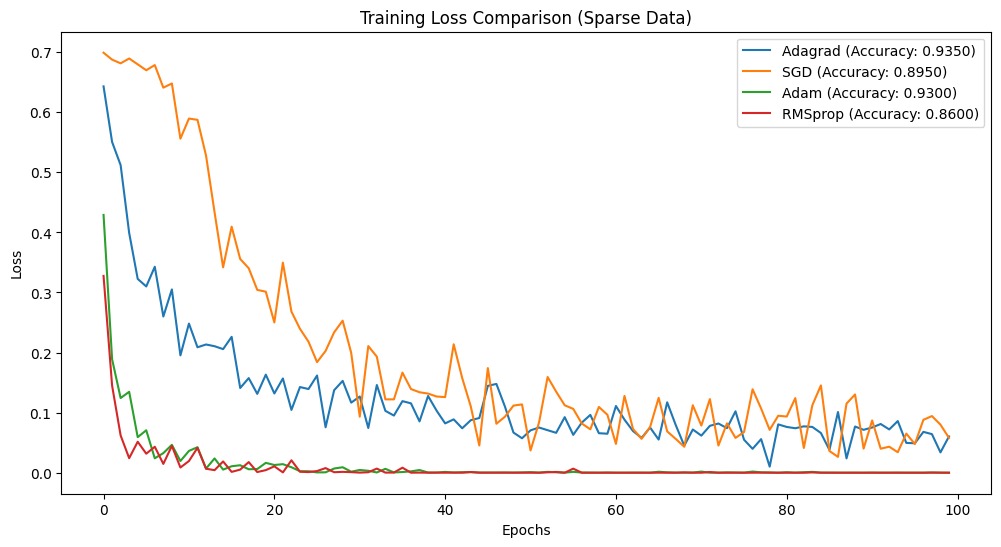
Adagrad è utile quando si lavora con dati sparsi grazie al suo learning rate adattivo. Abbiamo costruito una rete neurale di base e l’abbiamo addestrata con Adagrad, confrontandone poi le prestazioni con altri noti algoritmi di ottimizzazione. I risultati hanno favorito nettamente Adagrad, mostrando che gestisce meglio i dati sparsi.
Ho anche selezionato alcune delle migliori risorse su PyTorch, deep learning e altri algoritmi di ottimizzazione. Assicurati di darci un’occhiata per approfondire:
I migliori corsi DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



