50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Stel je voor dat je een heuvel afloopt, maar de ondergrond verandert onderweg—op sommige stukken is het steil, op andere vlak. Als je steeds even grote stappen zet, kun je moeite krijgen of te lang doen over de afdaling. In machine learning speelt iets vergelijkbaars bij gradient descent, waar één leersnelheid voor alle parameters het leerproces kan vertragen.
Hier komt Adagrad om de hoek kijken. Het past de stapgrootte voor elke parameter aan op basis van hoeveel die tijdens het trainen is veranderd. Zo leert het model sneller en effectiever, vooral wanneer verschillende features op andere schalen liggen. In dit artikel leggen we uit hoe Adagrad werkt en ontrafelen we de wiskunde erachter. Ook laten we zien hoe je het implementeert met PyTorch en vergelijken we het met andere optimizers, zodat je de beste keuze voor je projecten kunt maken.
Adagrad (Adaptive Gradient) is een optimalisatie-algoritme dat wordt gebruikt in machine learning, specifiek voor het trainen van diepe neurale netwerken. Het is ontworpen om de leersnelheid per parameter aan te passen op basis van historische gradiënten. Deze aanpak maakt Adagrad efficiënter voor machinelearningmodellen, vooral wanneer sprake is van sparse data of wanneer verschillende parameters met uiteenlopende snelheden convergeren.
Adagrad geeft hogere leersnelheden aan minder frequente features en lagere aan frequentere, wat het zeer geschikt maakt voor sparse data. Bovendien hoef je de leersnelheid minder handmatig af te stemmen!
Laten we het Adagrad-algoritme stap voor stap doornemen:
Begin met:
Voor elke parameter 0t op tijdstip t bereken je de gradiënt van de verliesfunctie ten opzichte van die parameter. Deze gradiënt vertelt hoeveel en in welke richting we de parameter moeten updaten om het verlies te verkleinen. Noem deze gradiënt gt, waarbij t de huidige tijdstap is.
In plaats van de parameters direct te updaten, houdt Adagrad voor elke parameter de som van de kwadratische gradiënten bij. Voor elke parameter i bereken en accumuleer je bij elke tijdstap de kwadratische gradiënt. Deze geaccumuleerde gradiënt wordt aangeduid als Gt.
Gt =Gt-1 + gt2
Waarbij:
Deze geaccumuleerde gradiënt helpt Adagrad om de leersnelheid per parameter aan te passen op basis van hoe vaak en hoeveel die is geüpdatet.
Nu je de geaccumuleerde kwadratische gradiënt Gt hebt, kunnen we elke parameter 0t updaten. De update-regel voor Adagrad is als volgt:
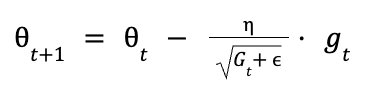
Dit gebeurt er:
De term:

verkleint effectief de leersnelheid voor parameters met een grote geaccumuleerde gradiënt. Parameters met kleinere geaccumuleerde gradiënten krijgen juist een grotere leersnelheid.
De formule van Adagrad past de leersnelheid automatisch aan. Zo werkt het:
PyTorch biedt een ingebouwde implementatie van Adagrad, beschikbaar via de module torch.optim. Installeer eerst PyTorch met pip:
pip install torch torchvisionLeer je eerste neuraal netwerk bouwen met onze gratis cursus Introduction to Deep Learning with PyTorch.
Hier is een stapsgewijze handleiding om de Adagrad-optimizer in PyTorch te implementeren:
Stap 1: Benodigde libraries importeren
import torchimport torch.nn as nnimport torch.optim as optimStap 2: Een eenvoudig neuraal netwerk definiëren
class SimpleNN(nn.Module): def __init__(self): super(SimpleNN, self).__init__() self.fc1 = nn.Linear(10, 5) self.fc2 = nn.Linear(5, 2) def forward(self, x): x = torch.relu(self.fc1(x)) x = self.fc2(x) return xStap 3: Het model en de optimizer initialiseren
model = SimpleNN()criterion = nn.CrossEntropyLoss()optimizer = optim.Adagrad(model.parameters(), lr=0.01)Stap 4: Trainingslus
for epoch in range(10): # loop over the dataset multiple times inputs = torch.randn(1, 10) # random input tensor labels = torch.tensor([1]) # target labels # Zero the parameter gradients optimizer.zero_grad() # Forward pass outputs = model(inputs) loss = criterion(outputs, labels) # Backward pass and optimize loss.backward() optimizer.step() print(f'Epoch {epoch+1}, Loss: {loss.item()}')In deze code wordt een eenvoudig lineair model getraind met de AdaGrad-optimizer. De leersnelheid is ingesteld op 0,01, maar AdaGrad past die per parameter aan op basis van de geaccumuleerde kwadratische gradiënten.
Voer de code uit en je ziet output zoals dit:
De output toont het verlies na elke epoch, wat aangeeft hoe goed het model leert. In het begin is het verlies hoger, maar naarmate de training vordert, daalt het verlies doorgaans, wat betekent dat het model verbetert. Enige fluctuatie is normaal, zeker met willekeurige inputs, maar over het algemeen leert het model geleidelijk betere voorspellingen te doen.
Wil je de wereld van deep learning ontdekken en zien hoe deze tak van machine learning alles verandert? Bekijk dan onze track Deep Learning in Python.
Laten we Adagrad vergelijken met andere optimizers zoals Adam, SGD en RMSProp.
Zowel Adagrad als Adam passen de leersnelheid per parameter aan, maar doen dit op verschillende manieren. Adagrad schaalt de leersnelheid op basis van de som van kwadratische gradiënten, wat kan leiden tot afnemende leersnelheden in de loop van de tijd. Adam gebruikt daarentegen zowel de eerste als tweede momenta van de gradiënten, waardoor de leersnelheid tijdens de training stabieler blijft.
Adagrad is bijzonder geschikt voor sparse data omdat het grotere leersnelheden toekent aan minder frequente features. Dit maakt het een goede keuze voor toepassingen zoals natural language processing, waar gradiënten vaak sparse zijn. Adam kan ook met sparse data overweg, maar is over het algemeen favoriet vanwege zijn robuustheid en efficiëntie in een breder scala aan toepassingen.
Adam wordt vaak verkozen vanwege snellere convergentie en betere prestaties in de praktijk, vooral in deep-learningmodellen met grote datasets. Dankzij momentum en bias-correctie voorkomt Adam dat het vastloopt in lokale minima en zadelpunten, wat bij Adagrad een beperking kan zijn.
Leer over fundamentele deep-learningarchitecturen zoals CNN's, RNN's, LSTM's en GRU's voor het modelleren van beeld- en sequentiedata. Bekijk onze cursus Intermediate Deep Learning with PyTorch.
Laten we Adagrad vergelijken met SGD en RMSProp
Stochastic Gradient Descent is een basisoptimalisatie-algoritme dat de modelparameters updatet met de gradiënt van de verliesfunctie ten opzichte van de parameters. Het staat bekend om zijn eenvoud en makkelijke implementatie. Maar SGD heeft een constante leersnelheid, wat een beperking kan zijn bij sparse data of verschillende featureschalen.
RMSProp is een uitbreiding op AdaGrad die het probleem van afnemende leersnelheid aanpakt met een vervalfactor. Daardoor kan RMSProp tijdens het trainen een stabielere leersnelheid behouden.
Laten we de voor- en nadelen van Adagrad, SGD en RMSProp samenvatten:
Optimizer | Voordelen | Nadelen |
Adagrad | 1. Past leersnelheden automatisch per parameter aan. 2. Effectief voor sparse data. 3. Maakt handmatige afstemming van de leersnelheid overbodig. | 1. Leersnelheid neemt in de tijd af, wat tot vroege convergentie kan leiden. 2. Kan in latere trainingsfasen te traag worden. |
SGD | 1. Simpel en makkelijk te implementeren. 2. Door het stochastische karakter effectief in het ontsnappen aan lokale minima. | 1. Hoge variantie in updates kan tot instabiliteit leiden. 2. Vereist zorgvuldige afstemming van leersnelheid en momentum. |
RMSProp | 1. Past leersnelheden aan op basis van het voortschrijdend gemiddelde van kwadratische gradiënten. 2. Geschikt voor niet-stationaire omgevingen. | 1. Vereist zorgvuldige afstemming van hyperparameters. 2. Integreert niet van nature momentum. |
Laten we de use-cases en beperkingen van AdaGrad in verschillende contexten verkennen.
Het unieke vermogen van Adagrad om leersnelheden per parameter aan te passen, maakt het ideaal voor meerdere scenario's:
Hoewel Adagrad in bepaalde situaties krachtig is, kent het ook enkele beperkingen:
Er zijn verschillende strategieën die je kunt gebruiken om de beperkingen van Adagrad aan te pakken:
Laten we een eenvoudig neuraal netwerk bouwen, het trainen met de Adagrad-optimizer en de prestaties vergelijken met andere populaire optimizers.
Wil je meer leren over PyTorch? Bekijk dan onze gids PyTorch Tutorial: Building a Simple Neural Network From Scratch.
We beginnen met een basisneuraal netwerk in PyTorch. We ontwerpen een netwerk voor binaire classificatie op sparse data, waar Adagrad uitblinkt.
import torchimport torch.nn as nnclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return xDit neuraal netwerk heeft een inputlaag, één verborgen laag met 50 neuronen en een outputlaag met één neuron. We gebruiken ReLU-activatie voor de verborgen laag en Sigmoid voor de outputlaag, wat geschikt is voor binaire classificatie.
Nu richten we het trainingsproces in met de Adagrad-optimizer. We maken een functie voor de training:
import torch.optim as optimfrom torch.utils.data import DataLoader, TensorDataset# Function to train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): # loop for each training epoch for inputs, targets in train_loader: # Clear gradients before each batch to avoid accumulation optimizer.zero_grad() # Reset gradients to zero # Forward pass - get model predictions outputs = model(inputs) # Calculate loss based on predictions and targets loss = criterion(outputs, targets) # Backward pass - calculate gradients for parameter updates based on the loss loss.backward() # Update model parameters based on calculated gradients optimizer.step() # Track loss for monitoring training progress losses.append(loss.item()) return losses# Setup for trainingX, y = generate_sparse_data() # This function generates our sparse datasetinput_size = X.shape[1]train_size = int(0.8 * len(X))X_train, X_test = X[:train_size], X[train_size:]y_train, y_test = y[:train_size], y[train_size:]train_dataset = TensorDataset(X_train, y_train)train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)model = SparseNN(input_size)criterion = nn.BCELoss() # Assuming binary classification with BCE lossoptimizer = optim.Adagrad(model.parameters(), lr=0.01)# Train the modellosses = train_model(model, optimizer, criterion, train_loader)In deze setup:
Om de prestaties van het model te beoordelen, maken we een evaluatiefunctie:
def evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Evaluate the modeltest_dataset = TensorDataset(X_test, y_test)test_loader = DataLoader(test_dataset, batch_size=32)accuracy = evaluate_model(model, test_loader)print(f"Adagrad Accuracy: {accuracy:.4f}")Deze functie berekent de nauwkeurigheid van ons model op de testset.
Vervolgens vergelijken we met andere populaire optimizers: SGD, Adam en RMSprop. We maken een functie om het experiment per optimizer uit te voeren:
def run_experiment(optimizer_class, lr=0.01): model = SparseNN(input_size) criterion = nn.BCELoss() if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) losses = train_model(model, optimizer, criterion, train_loader) accuracy = evaluate_model(model, test_loader) return losses, accuracy# Compare optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Na het uitvoeren van deze code krijgen we de volgende resultaten:
Final accuracies:Adagrad: 0.9350SGD: 0.8950Adam: 0.9300RMSprop: 0.8600Deze resultaten laten zien dat Adagrad het best presteerde op ons sparse-dataprobleem, met de hoogste nauwkeurigheid van 95,00%. Dit toont aan dat Adagrad goed geschikt is voor scenario's met sparse data. Adam volgt op korte afstand, terwijl SGD en RMSprop in dit specifieke geval minder goed presteerden.
Om het trainingsproces te visualiseren kunnen we de verliescurves plotten:
import matplotlib.pyplot as pltplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()Laten we alle codefragmenten samenvoegen; hier is de complete code.
import torchimport torch.nn as nnimport torch.optim as optimfrom torch.utils.data import DataLoader, TensorDatasetimport matplotlib.pyplot as plt# Step 1: Generate sparse synthetic datadef generate_sparse_data(n_samples=1000, n_features=100, sparsity=0.95): X = torch.randn(n_samples, n_features) mask = torch.rand(n_samples, n_features) < sparsity X[mask] = 0 weights = torch.randn(n_features) y = (torch.matmul(X, weights) > 0).float().view(-1, 1) return X, y# Step 2: Define the neural networkclass SparseNN(nn.Module): def __init__(self, input_size): super(SparseNN, self).__init__() self.fc1 = nn.Linear(input_size, 50) self.fc2 = nn.Linear(50, 1) self.activation = nn.ReLU() self.output_activation = nn.Sigmoid() def forward(self, x): x = self.activation(self.fc1(x)) x = self.output_activation(self.fc2(x)) return x# Step 3: Train the modeldef train_model(model, optimizer, criterion, train_loader, num_epochs=100): losses = [] for epoch in range(num_epochs): for inputs, targets in train_loader: optimizer.zero_grad() outputs = model(inputs) loss = criterion(outputs, targets) loss.backward() optimizer.step() losses.append(loss.item()) return losses# Step 4: Evaluate the modeldef evaluate_model(model, test_loader): model.eval() correct = 0 total = 0 with torch.no_grad(): for inputs, targets in test_loader: outputs = model(inputs) predicted = (outputs > 0.5).float() total += targets.size(0) correct += (predicted == targets).sum().item() accuracy = correct / total return accuracy# Step 5: Main function to run the experimentdef run_experiment(optimizer_class, lr=0.01): # Generate sparse data X, y = generate_sparse_data() input_size = X.shape[1] train_size = int(0.8 * len(X)) X_train, X_test = X[:train_size], X[train_size:] y_train, y_test = y[:train_size], y[train_size:] # Create data loaders train_dataset = TensorDataset(X_train, Y_train) test_dataset = TensorDataset(X_test, y_test) train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True) test_loader = DataLoader(test_dataset, batch_size=32) # Initialize model and training components model = SparseNN(input_size) criterion = nn.BCELoss() # Use default hyperparameters for each optimizer if optimizer_class == optim.SGD: optimizer = optimizer_class(model.parameters(), lr=lr, momentum=0.9) elif optimizer_class == optim.RMSprop: optimizer = optimizer_class(model.parameters(), lr=lr, alpha=0.99) else: optimizer = optimizer_class(model.parameters(), lr=lr) # Train the model losses = train_model(model, optimizer, criterion, train_loader) # Evaluate the model accuracy = evaluate_model(model, test_loader) return losses, accuracy# Step 6: Compare Adagrad with other optimizersoptimizers = { 'Adagrad': optim.Adagrad, 'SGD': optim.SGD, 'Adam': optim.Adam, 'RMSprop': optim.RMSprop}results = {}for name, opt_class in optimizers.items(): losses, accuracy = run_experiment(opt_class) results[name] = {'losses': losses, 'accuracy': accuracy}# Step 7: Plot resultsplt.figure(figsize=(12, 6))for name, data in results.items(): plt.plot(data['losses'], label=f"{name} (Accuracy: {data['accuracy']:.4f})")plt.xlabel('Epochs')plt.ylabel('Loss')plt.title('Training Loss Comparison (Sparse Data)')plt.legend()plt.show()print("Final accuracies:")for name, data in results.items(): print(f"{name}: {data['accuracy']:.4f}")Hier is het resultaat:
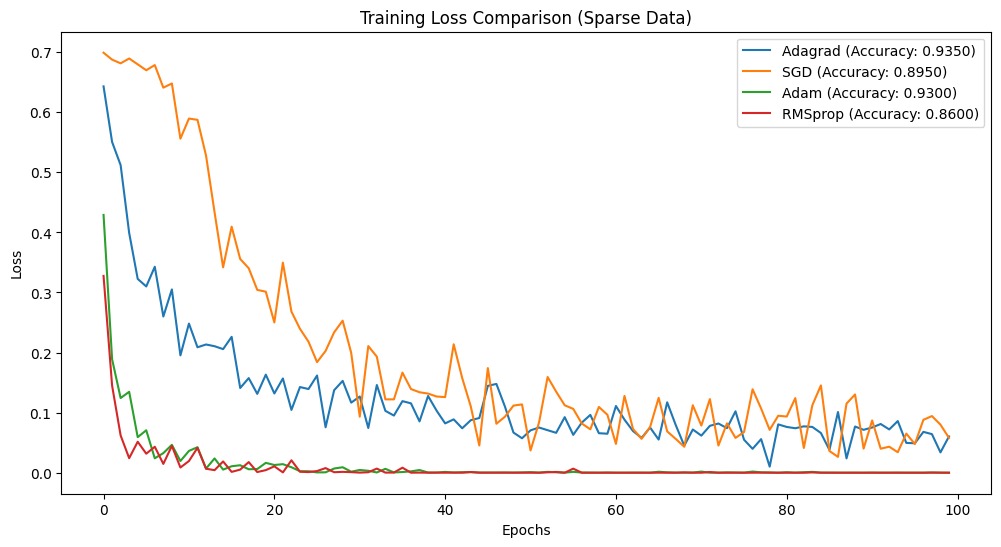
Adagrad is nuttig bij het werken met sparse data dankzij de adaptieve leersnelheid. We hebben een basisneuraal netwerk gebouwd en getraind met Adagrad, en de prestaties vergeleken met andere bekende optimalisatie-algoritmen. De resultaten waren sterk in het voordeel van Adagrad en laten zien dat het sparse data beter aankan.
Ik heb ook een aantal van de beste bronnen over PyTorch, deep learning en andere optimalisatie-algoritmen voor je geselecteerd. Bekijk ze om dieper de materie in te gaan:
Topcursussen bij DataCamp
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min