

Serialisasi Data dengan Apache Arrow
Serialisasi adalah proses mengonversi objek atau struktur data kompleks menjadi aliran byte untuk menyimpan atau mengirim data antar sistem. Namun Apache Arrow mengambil pendekatan yang berbeda.
Karena Arrow menggunakan format memori kolumnar yang dirancang untuk kecepatan, Arrow menghindari serialisasi tradisional. Sebagai gantinya, Arrow mengandalkan model memori bersama, di mana banyak proses dapat mengakses data yang sama secara langsung tanpa menyalin atau mengonversinya.
Berikut yang dilakukan Arrow:
- Mengurangi overhead dari penyalinan data
- Mengurangi penggunaan memori dengan berbagi data secara in-place
- Menyederhanakan pertukaran data antar sistem dan bahasa
Menyimpan dan memuat data Arrow
Mari lihat cara menyimpan data Arrow menggunakan format file Feather dan memuatnya kembali ke Table menggunakan Python.
Simpan Arrow Table ke File Feather
import pandas as pd
import pyarrow as pa
import pyarrow.feather as feather
# Create a sample pandas DataFrame
df = pd.DataFrame({
'id': [1, 2, 3],
'name': ['Alice', 'Bob', 'Charlie'],
'score': [95.5, 82.0, 77.5]
})
# Convert DataFrame to Arrow Table
table = pa.Table.from_pandas(df)
# Save Arrow Table to a Feather file
feather.write_feather(table, 'example.feather')
print("Arrow table saved to 'example.feather'")
Mengonversi DataFrame ke Arrow Table. Gambar oleh penulis.
Muat Arrow Table dari File Feather
Lalu, kita dapat melakukan kebalikannya dan memuat Arrow Table dari file Feather yang dibuat sebelumnya.
import pyarrow.feather as feather
# Load the Feather file into an Arrow Table
loaded_table = feather.read_table('example.feather')
# (Optional) Convert back to pandas DataFrame
df_loaded = loaded_table.to_pandas()
# Print the loaded data
print(df_loaded)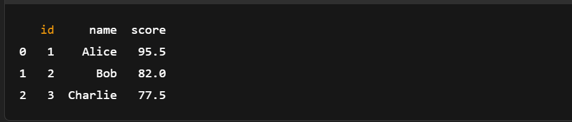
Memuat Arrow Table dari file Feather. Gambar oleh penulis.
Seperti yang Anda lihat, tidak perlu serialisasi manual. Menyimpan dan memuat data Arrow hanya membutuhkan beberapa baris kode.
Jika Anda baru di pandas atau butuh penyegaran, cheet sheet pandas ini merupakan pendamping yang bagus untuk Arrow dalam manipulasi data cepat.
Menggunakan Apache Arrow dengan Dataset yang Lebih Besar
Mari lihat contoh nyata betapa cepat dan efektifnya Arrow saat memuat, memfilter, dan menganalisis dataset besar.
Memuat dataset besar ke dalam Arrow
Kita akan mulai dengan membuat pandas DataFrame dengan satu juta baris.
Langkah 1: Hasilkan DataFrame besar
import pandas as pd
import pyarrow as pa
import pyarrow.compute as pc
import time
df = pd.DataFrame({
'id': range(1, 1_000_001), #assuming a dataset with a million rows
'value': pd.np.random.randint(1, 1000, size=1_000_000),
'category': pd.np.random.choice(['A', 'B', 'C'], size=1_000_000)
})Langkah 2: Konversi ke Arrow Table
start = time.time()
arrow_table = pa.Table.from_pandas(df)
end = time.time()
print(f"Conversion to Arrow Table took {end - start:.4f} seconds")Langkah 3: Filter dengan Compute API Arrow
# Example: Filter rows where 'value' > 990
start = time.time()
filtered_table = pc.filter(arrow_table, pc.greater(arrow_table['value'], pa.scalar(990)))
end = time.time()
# Result summary
print(f"Filtering took {end - start:.4f} seconds")
print(f"Filtered row count: {filtered_table.num_rows}")Langkah 4: Konversi kembali ke pandas (zero-copy)
start = time.time()
filtered_df = filtered_table.to_pandas()
end = time.time()
print(f"Conversion to pandas DataFrame took {end - start:.4f} seconds")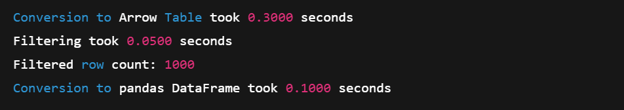
Memuat dataset besar ke Array. Gambar oleh penulis.
Format kolumnar Arrow dan fungsi komputasi bertenaga SIMD menjadikannya pilihan unggul untuk operasi dalam memori skala besar. Dan berkat konversi zero-copy, kembali ke pandas menjadi cepat dan efisien.
Untuk alur kerja di mana Anda memuat data sebelum konversi ke Arrow, kursus tentang streamlined data ingestion dengan pandas dapat mengoptimalkan pipeline Anda.
Melakukan analitik dasar
Anda juga dapat menggunakan compute API Arrow untuk menjalankan analitik dasar. Berikut demo singkat dengan dataset contoh yang lebih kecil.
import pyarrow as pa
import pyarrow.compute as pc
# Sample data
data = {
'id': pa.array([1, 2, 3, 4, 5]),
'score': pa.array([85, 92, 76, 88, 95]),
'category': pa.array(['A', 'B', 'A', 'B', 'A'])
}
# Create Arrow Table
table = pa.table(data)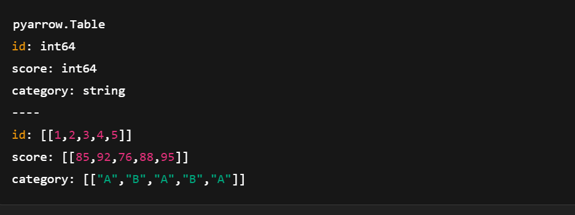
Membuat Arrow Table menggunakan pyarrow.compute. Gambar oleh penulis.
Contoh 1: Filter baris dengan skor > 90
# Filter rows where score > 90
filter_mask = pc.greater(table['score'], pa.scalar(90))
filtered_table = pc.filter(table, filter_mask)
print(filtered_table.to_pandas())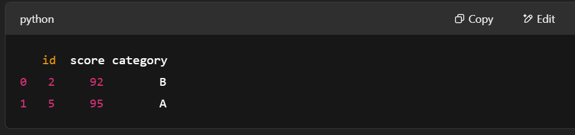
Memfilter baris menggunakan pyarrow.compute. Gambar oleh penulis.
Contoh 2: Hitung nilai rata-rata
# Compute mean of the "score" column
mean_result = pc.mean(table['score'])
print("Mean score:", mean_result.as_py())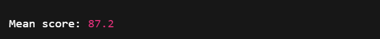
Menghitung nilai rata-rata menggunakan pyarrow.compute. Gambar oleh penulis.
Contoh 3: Group by kategori dan hitung rata-rata skor
import pandas as pd
# Convert to pandas for more complex grouping
df = table.to_pandas()
grouped = df.groupby('category')['score'].mean()
print(grouped)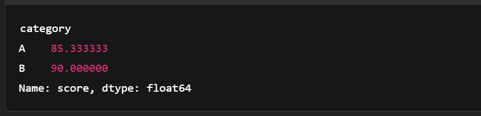
Mengelompokkan Arrow Table. Gambar oleh penulis.
Perbandingan dengan performa pandas
Berikut perbandingan singkat Apache Arrow dan pandas. Ini menunjukkan di mana Arrow unggul untuk beban kerja analitik berskala besar.
|
Fitur |
Apache Arrow |
Pandas |
|
Format Memori |
Kolumnar, zero-copy, terkemas rapat |
Berbasis baris (secara internal menggunakan array NumPy) |
|
Kecepatan (Filtering, I/O) |
Lebih cepat berkat SIMD & vektorisasi |
Lebih lambat pada data besar (penyalinan, loop Python) |
|
Penggunaan Memori |
Lebih ringkas, efisien |
Lebih tinggi karena overhead Python |
|
Interoperabilitas |
Sangat baik (dibagi lintas bahasa/alat) |
Mayoritas berpusat pada Python |
|
Kecocokan kasus penggunaan |
Dioptimalkan untuk beban kerja analitik besar |
Sangat baik untuk data kecil/sedang & prototyping |
|
Serialisasi |
Feather/Parquet dengan dukungan zero-copy |
CSV/Excel, sering lebih lambat dan lebih besar |
Seperti yang telah kita lihat, Arrow Table terintegrasi baik dengan pandas, terutama saat melakukan join. Jelajahi lebih lanjut dalam kursus tentang joining data dengan pandas.
Mengintegrasikan Apache Arrow dengan Alat Data Lain
Arrow dapat bekerja baik dengan alat data lain, sehingga memudahkan memindahkan data antar lingkungan tanpa kehilangan kecepatan atau struktur.
Menggunakan Arrow dengan pandas
Dalam Apache Arrow, Table mirip dengan DataFrame pandas, keduanya menggunakan kolom bernama dengan panjang sama. Namun Arrow Table melangkah lebih jauh. Table mendukung kolom bertingkat sehingga Anda dapat merepresentasikan struktur data yang lebih kompleks dibandingkan di pandas.
Meski begitu, tidak semua konversi berlangsung mulus. Namun, mengonversi antara Arrow dan pandas tetap sederhana. Begini caranya:
Arrow Table → pandas DataFrame
table.to_pandas()pandas DataFrame → Arrow Table
pa.Table.from_pandas(df)Dan itu saja! Hanya satu baris kode yang dibutuhkan.
Anda juga dapat bekerja dengan struktur pandas lain seperti Series menggunakan Arrow. Lihat dokumentasi untuk mempelajari lebih lanjut. Selain itu, baik Arrow maupun pandas diuntungkan dari desain berorientasi performa—pelajari lebih lanjut dalam kursus tentang menulis kode efisien dengan pandas.
Bekerja dengan Apache Spark
Apache Arrow terintegrasi ke dalam Spark untuk mempercepat pertukaran data antara JVM (Java Virtual Machine) dan Python. Ini sangat membantu bagi pengguna pandas dan NumPy. Fitur ini tidak aktif secara default, jadi Anda mungkin perlu mengubah beberapa pengaturan untuk menyalakannya. Namun setelah berjalan, Arrow meningkatkan performa dalam beberapa cara:
- Format kolumnar: Menggunakan memori lebih efisien dan mendukung operasi tervektorisasi.
- Pertukaran data zero-copy: Seluruh kolom dibagi langsung antara Spark dan pandas; tanpa duplikasi data.
- Overhead serialisasi lebih rendah: Tanpa Arrow, mengonversi Spark DataFrame ke pandas melibatkan serialisasi JVM-ke-Python yang lambat. Arrow melewati langkah ini.
- Pemrosesan paralel: Arrow mendukung pemrosesan data per chunk, yang sangat cocok dengan sistem terdistribusi Spark.
Untuk memulai, ikuti panduan resmi PySpark dengan Arrow.
Interoperabilitas dengan pustaka machine learning
Arrow juga bekerja baik dengan pustaka machine learning seperti TensorFlow.
Format kolumnarnya memungkinkan pemuatan data dan prapemrosesan yang lebih cepat, langkah kunci dalam pelatihan model machine learning. Dan dengan menangani dataset besar secara efisien, Arrow membantu membangun pipeline ML yang dapat diskalakan, berlatih lebih cepat, dan bekerja lebih baik lintas alat berbeda.
Kesimpulan
Selesai! Kita telah membahas ide-ide inti di balik Apache Arrow, melihat bagaimana Arrow berbeda dari format data yang lebih tradisional, cara menyiapkannya, dan cara menggunakannya di Python.
Kita juga mengeksplorasi contoh langsung untuk membangun Arrow Array dan Table, serta melihat bagaimana Arrow membantu melewati serialisasi yang lambat agar pemrosesan data tetap cepat dan efisien.
Jika Anda ingin terus belajar dan membangun dari yang telah kita bahas, berikut beberapa sumber yang bagus untuk langkah berikutnya:
- Kursus Introduction to Apache Kafka – Pelajari cara membangun pipeline data real-time.
- Kursus Introduction to Databricks – Latihan langsung dengan analitik data berskala besar.
Ke mana pun langkah Anda berikutnya, kami harap Arrow membantu Anda membangun alur kerja yang lebih bersih dan lebih mudah diskalakan!
FAQs
Apa perbedaan antara Arrow dan Parquet?
Parquet adalah format penyimpanan yang dirancang untuk efisiensi ruang maksimum, sedangkan Arrow adalah format dalam memori yang ditujukan untuk operasi oleh kernel komputasi tervektorisasi.
Bagaimana hubungan Arrow dengan Protobuf?
Pustaka protocol buffers Google (Protobuf) bukanlah “format dalam memori saat runtime.” Mirip dengan Parquet, representasi Protobuf tidak cocok untuk pemrosesan. Data harus dideserialisasi ke representasi dalam memori seperti Arrow untuk diproses.
Bagaimana hubungan Arrow dengan Flatbuffers?
Format file Arrow memang menggunakan Flatbuffers di balik layar untuk menserialisasi skema dan metadata lain yang diperlukan guna mengimplementasikan protokol IPC biner Arrow, tetapi format data Arrow menggunakan representasinya sendiri untuk akses dan komputasi yang optimal.
Apakah Apache Arrow gratis digunakan?
Ya, Anda dapat menggunakannya secara gratis.
Dapatkah Apache Arrow digunakan dalam pipeline data real-time?
Ya, Apache Arrow sangat cocok untuk aplikasi real-time. Fitur zero-copy dan model memori bersama mengurangi latensi, terutama saat digabungkan dengan alat seperti Apache Kafka atau Spark.
Bagaimana Apache Arrow berinteraksi dengan format file Parquet dan Feather?
Arrow berada di memori, sementara Parquet dan Feather adalah format di disk. Namun, Feather dan Parquet kompatibel dengan Arrow, sehingga mudah untuk menserialisasi data dari memori ke disk dengan overhead minimal.
Apakah Apache Arrow lebih baik daripada pandas untuk semua operasi data?
Tidak selalu. Arrow unggul dalam pemrosesan kolumnar cepat dalam memori dan interoperabilitas, tetapi pandas lebih kaya fitur untuk perapian data yang kompleks. Gunakan Arrow saat performa dan berbagi lintas bahasa menjadi penting.
Apa perbedaan Arrow Array dan array NumPy?
Arrow Array mendukung metadata tambahan seperti penanganan null, bersifat immutable, dan dirancang untuk interoperabilitas lintas bahasa, sementara array NumPy bersifat mutable dan berpusat pada Python.
Apakah Apache Arrow mendukung tipe data bertingkat atau kompleks?
Ya. Arrow mendukung tipe bertingkat seperti list, struct, dan union, sehingga memungkinkan struktur data hierarkis kompleks yang umum digunakan dalam analitik dan pipeline ML.

Saya seorang ahli strategi konten yang senang menyederhanakan topik kompleks. Saya telah membantu perusahaan seperti Splunk, Hackernoon, dan Tiiny Host membuat konten yang menarik dan informatif untuk audiens mereka.




Apache Arrow membantu berbagai alat dan sistem berbagi data dengan cepat dan mudah. Arrow menyimpan data dalam format kolom khusus yang berada di memori, sehingga sangat cepat untuk dikerjakan.
Dalam tutorial ini, saya akan memandu Anda memahami dasar-dasar Apache Arrow. Anda akan mendapatkan contoh langsung untuk memahami cara kerjanya dan cara menggunakannya dalam proyek Anda.
Apa itu Apache Arrow?
Apache Arrow ialah platform sumber terbuka lintas bahasa untuk pemrosesan data dalam memori berperforma tinggi. Arrow mendefinisikan format memori kolumnar standar yang dioptimalkan untuk CPU modern guna memungkinkan analitik efisien dan komputasi tervektorisasi.
Arrow juga menghilangkan kebutuhan serialisasi antar sistem dan bahasa, sehingga memungkinkan pembacaan zero-copy dan mengurangi overhead pemrosesan.
Karena bekerja baik dengan alat seperti pandas, Apache Spark, dan Dask, Anda dapat memindahkan data dengan upaya minimal. Ini menjadikannya pilihan yang sangat baik bagi siapa pun yang membangun sistem cepat dan fleksibel yang perlu menangani banyak data.
Sekarang, mari jelajahi Arrow dengan beberapa contoh praktis!
Menginstal Apache Arrow
Apache Arrow mendukung banyak bahasa, termasuk C, C++, C#, Python, Rust, Java, JavaScript, Julia, Go, Ruby, dan R.
Arrow bekerja di Windows, macOS, dan distro Linux populer seperti Debian, Ubuntu, CentOS, dan Red Hat Enterprise Linux.
Dalam panduan ini, kita akan menggunakannya dengan Python.
Panduan instalasi langkah demi langkah
Mari lihat cara menginstal Apache Arrow untuk Python menggunakan binary wheel resmi yang dipublikasikan di PyPI. Langkah-langkah ini sama di Windows, macOS, dan Linux.
Langkah 1: Periksa apakah Python sudah terpasang
Buka terminal Anda dan jalankan:
Jika perintah ini menampilkan nomor versi, Anda siap lanjut. Jika tidak, pasang Python dari situs resmi.
Langkah 2: Instal
pyarrowmenggunakan pipUntuk menginstal Apache Arrow untuk Python, jalankan:
Tanda
*memastikan Anda mendapatkan rilis patch terbaru di seri 19.0.Saya juga menyarankan menggunakan
pyarrow==19.0.*di filerequirements.txtuntuk menjaga konsistensi lintas lingkungan. Ini akan memasangpyarrowbeserta pustaka biner C++ Apache Arrow dan Parquet yang dibundel dalam wheel.Untuk memasang Arrow pada bahasa lain, lihat dokumentasi lengkapnya.
Menguji instalasi
Anda dapat menjalankan potongan kode Python singkat ini untuk memeriksa apakah semuanya berfungsi:
Jika
pyarrowterpasang dengan benar, Anda akan melihat array dicetak di terminal. Jika tidak, kode akan memunculkan error.Dasar-dasar Apache Arrow
Sebelum masuk lebih dalam ke kode, mari pahami bagaimana Apache Arrow dibangun.
Memahami format memori kolumnar
Format kolumnar dalam memori adalah salah satu fitur paling penting dari Apache Arrow. Arrow mendefinisikan struktur data dalam memori yang independen bahasa. Selain itu, Arrow menyertakan serialisasi metadata, protokol untuk transport data, dan cara standar untuk merepresentasikan data lintas sistem.
Dalam format kolumnar, data disimpan per kolom alih-alih per baris, berbeda dari penyimpanan berbasis baris tradisional. Tata letak kolumnar populer untuk beban kerja analitik karena jauh lebih cepat untuk dipindai dan diproses.
Gambar di bawah menjelaskan formatnya:
Format kolumnar. Sumber: Dokumentasi Apache Arrow
Format Arrow meningkatkan efisiensi dengan meletakkan kolom dalam blok memori bersebelahan. Ini mendukung operasi tervektorisasi modern (SIMD) yang mempercepat pemrosesan data.
Dengan tata letak kolumnar standar, Arrow menghilangkan kebutuhan setiap sistem untuk mendefinisikan format data internalnya. Hal ini mengurangi overhead serialisasi dan duplikasi upaya.
Sistem dapat berbagi data lebih mudah, dan pengembang dapat menggunakan kembali algoritme di berbagai bahasa.
Tanpa format bersama seperti Arrow, setiap basis data atau alat perlu melakukan serialisasi dan deserialisasi data sebelum meneruskannya. Itu menambah biaya dan kompleksitas. Dan algoritme umum harus ditulis ulang untuk struktur data internal tiap sistem.
Arrow mengubah ini dengan menstandarkan cara data direpresentasikan dalam memori.
Meski format kolumnar sangat baik untuk performa analitik dan lokalitas memori, format ini tidak dirancang untuk pembaruan yang sering.
Itu karena penyimpanan kolumnar dioptimalkan untuk pembacaan cepat, bukan modifikasi. Mengubah data sering kali berarti menyalin atau mengalokasikan ulang memori, yang bisa lambat dan berat sumber daya.
Arrow berfokus pada representasi dan serialisasi dalam memori yang efisien. Jika kasus penggunaan Anda memerlukan mutasi data yang sering, Anda perlu menanganinya di tingkat implementasi.
Untuk menggali lebih dalam format yang kompatibel dengan Arrow, lihat panduan ke Apache Parquet, ideal untuk penyimpanan data kolomnar.
Struktur data Arrow
Apache Arrow menyediakan dua struktur data utama:
ArraydanTable:Arraymerepresentasikan satu kolom data. Array menyimpan nilai dalam blok memori bersebelahan, memungkinkan akses cepat, pemindaian efisien, dan dukungan untuk optimasi tingkat prosesor seperti SIMD. Setiap array juga dapat membawa metadata seperti indikator null (bitmap) dan informasi tipe data.Arrow Tablemerepresentasikan dataset 2D. Setiap kolom adalah chunked array, dan semua kolom mengikuti skema bersama yang mendefinisikan nama dan tipe field. Meskipun chunk dapat berbeda antar kolom, jumlah elemen total harus tetap selaras agar baris konsisten.Anda dapat menganggapnya seperti DataFrame di pandas atau R. Tabel ini tabular, efisien, dan mendukung operasi lintas banyak kolom secara simultan.
Contoh struktur data dasar
Mari lihat beberapa contoh membuat
ArraydanTableArrow di Python.Pastikan Anda telah memasang
pyarrowsebelum menjalankan kode di bawah, mengikuti instruksi sebelumnya.Membuat Arrow Array
Mencetak Arrow Array. Gambar oleh penulis.
Membuat Arrow Table
Mencetak Arrow Table. Gambar oleh penulis.
Bekerja dengan Arrow Array Apache Arrow
Mari lihat cara bekerja dengan Arrow Array dan melakukan operasi umum, seperti slicing, filtering, dan memeriksa metadata.
Membuat Arrow Array
Arrow Array mendukung berbagai tipe data, termasuk string, bilangan floating-point, dan integer. Berikut cara membuatnya:
Mencetak Arrow Array dengan tipe data berbeda. Gambar oleh penulis.
Operasi dasar pada Arrow Array
Mari lihat beberapa operasi umum yang dapat Anda lakukan dengan Arrow Array.
Slicing
Slicing memungkinkan Anda mengambil bagian dari sebuah array. Misalnya, Anda dapat mengekstrak elemen pada rentang indeks tertentu:
Mencetak Arrow Array yang di-slice. Gambar oleh Penulis.
Filtering dan metadata
Filtering menggunakan mask Boolean untuk menyisakan hanya nilai yang memenuhi kondisi. Anda juga dapat mengakses metadata seperti tipe, panjang, dan jumlah null.
Mencetak Arrow Array yang difilter. Gambar oleh Penulis.
Mencetak Metadata dari Arrow Array. Gambar oleh Penulis.
Menggunakan Apache Arrow Table
Anda dapat membuat Arrow Table dari Arrow Array atau langsung dari struktur data Python native seperti dictionary. Mari lihat caranya.
Membuat dan menampilkan tabel
Ada dua cara umum untuk membuat Arrow Table:
pa.table()Mari jelajahi keduanya satu per satu.
1. Menggunakan Arrow Array
Pada kode di atas:
pa.table()Membuat Arrow Table menggunakan beberapa Arrow Array. Gambar oleh penulis.
2. Menggunakan dictionary Python
Sekarang, mari lihat cara membuat Table dari dictionary Python.
Metode ini lebih singkat dan ringkas. Kita tidak perlu mendefinisikan array secara manual; Arrow menanganinya untuk kita.
Membuat Arrow Table langsung dari dictionary Python. Gambar oleh penulis.
Mengonversi antara Arrow Table dan pandas DataFrame
Salah satu kekuatan terbesar Arrow adalah interoperabilitasnya. Anda dapat dengan mudah berpindah antara Arrow Table dan pandas DataFrame. Mari lihat caranya:
Mengonversi Arrow Table ke Pandas DataFrame
Mengonversi Arrow Table ke Pandas DataFrame. Gambar oleh penulis.
Mengonversi Pandas DataFrame ke Arrow Table
Sekarang, mari lihat cara melakukan sebaliknya:
Mengonversi pandas DataFrame ke Array Table. Gambar oleh penulis.