

Data-serialisatie met Apache Arrow
Serialisatie is het proces waarbij complexe objecten of datastructuren worden omgezet naar een bytestroom om data op te slaan of tussen systemen te versturen. Maar Apache Arrow pakt dit anders aan.
Omdat Arrow een kolomgeoriënteerd geheugenformaat gebruikt dat is ontworpen voor snelheid, vermijdt het traditionele serialisatie. In plaats daarvan vertrouwt het op een gedeeld geheugermodel, waarbij meerdere processen dezelfde data direct kunnen benaderen zonder te kopiëren of te converteren.
Dit is wat het doet:
- Vermindert overhead door datakopieën
- Reduceert geheugengebruik door data ter plekke te delen
- Vereenvoudigt data-uitwisseling tussen systemen en talen
Arrow-data opslaan en laden
Laten we zien hoe je Arrow-data kunt opslaan met het Feather-bestandsformaat en terug kunt laden in een Table met Python.
Arrow Table opslaan naar een Feather-bestand
import pandas as pd
import pyarrow as pa
import pyarrow.feather as feather
# Create a sample pandas DataFrame
df = pd.DataFrame({
'id': [1, 2, 3],
'name': ['Alice', 'Bob', 'Charlie'],
'score': [95.5, 82.0, 77.5]
})
# Convert DataFrame to Arrow Table
table = pa.Table.from_pandas(df)
# Save Arrow Table to a Feather file
feather.write_feather(table, 'example.feather')
print("Arrow table saved to 'example.feather'")
DataFrame converteren naar Arrow Table. Afbeelding door de auteur.
Arrow Table laden uit een Feather-bestand
Vervolgens kunnen we het omgekeerde doen en een Arrow Table laden uit het eerder gemaakte Feather-bestand.
import pyarrow.feather as feather
# Load the Feather file into an Arrow Table
loaded_table = feather.read_table('example.feather')
# (Optional) Convert back to pandas DataFrame
df_loaded = loaded_table.to_pandas()
# Print the loaded data
print(df_loaded)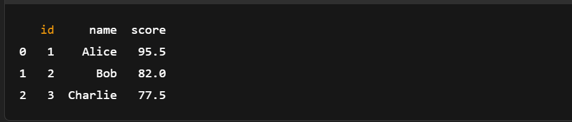
Een Arrow Table laden uit een Feather-bestand. Afbeelding door de auteur.
Zoals je ziet is er geen handmatige serialisatie nodig. Arrow-data opslaan en laden kost slechts een paar regels code.
Als je nieuw bent met pandas of een opfrisser nodig hebt, is deze pandas-cheatsheet een fijne aanvulling op Arrow voor snelle datamanipulaties.
Apache Arrow gebruiken met grotere datasets
Laten we een realistisch voorbeeld bekijken van hoe snel en effectief Arrow kan zijn bij het laden, filteren en analyseren van een grote dataset.
Een grote dataset in Arrow laden
We beginnen met het maken van een pandas DataFrame met één miljoen rijen.
Stap 1: Een groot DataFrame genereren
import pandas as pd
import pyarrow as pa
import pyarrow.compute as pc
import time
df = pd.DataFrame({
'id': range(1, 1_000_001), #assuming a dataset with a million rows
'value': pd.np.random.randint(1, 1000, size=1_000_000),
'category': pd.np.random.choice(['A', 'B', 'C'], size=1_000_000)
})Stap 2: Converteren naar Arrow Table
start = time.time()
arrow_table = pa.Table.from_pandas(df)
end = time.time()
print(f"Conversion to Arrow Table took {end - start:.4f} seconds")Stap 3: Filteren met Arrow’s Compute API
# Example: Filter rows where 'value' > 990
start = time.time()
filtered_table = pc.filter(arrow_table, pc.greater(arrow_table['value'], pa.scalar(990)))
end = time.time()
# Result summary
print(f"Filtering took {end - start:.4f} seconds")
print(f"Filtered row count: {filtered_table.num_rows}")Stap 4: Terug converteren naar pandas (zero-copy)
start = time.time()
filtered_df = filtered_table.to_pandas()
end = time.time()
print(f"Conversion to pandas DataFrame took {end - start:.4f} seconds")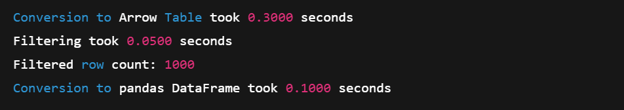
Een grote dataset in een Array laden. Afbeelding door de auteur.
Het kolomformaat van Arrow en SIMD-aangedreven compute-functies maken het een uitstekende keuze voor grootschalige in-memory bewerkingen. En dankzij zero-copy conversie is teruggaan naar pandas snel en efficiënt.
Voor workflows waarbij je data laadt vóór Arrow-conversie, kan deze coursus over gestroomlijnde data-ingestie met pandas je pijplijn optimaliseren.
Basisanalyses uitvoeren
Je kunt ook de compute-API van Arrow gebruiken om basisanalyses uit te voeren. Hier is een snelle demo met een kleinere voorbeeldset.
import pyarrow as pa
import pyarrow.compute as pc
# Sample data
data = {
'id': pa.array([1, 2, 3, 4, 5]),
'score': pa.array([85, 92, 76, 88, 95]),
'category': pa.array(['A', 'B', 'A', 'B', 'A'])
}
# Create Arrow Table
table = pa.table(data)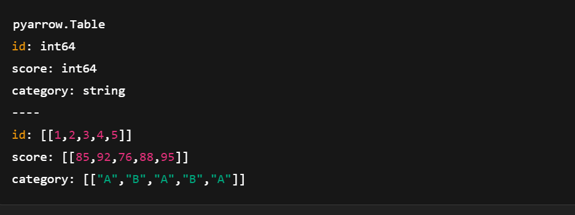
Een Arrow Table maken met pyarrow.compute. Afbeelding door de auteur.
Voorbeeld 1: Rijen filteren waar score > 90
# Filter rows where score > 90
filter_mask = pc.greater(table['score'], pa.scalar(90))
filtered_table = pc.filter(table, filter_mask)
print(filtered_table.to_pandas())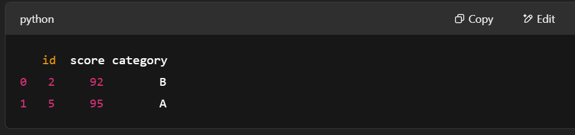
Rijen filteren met pyarrow.compute. Afbeelding door de auteur.
Voorbeeld 2: De gemiddelde score berekenen
# Compute mean of the "score" column
mean_result = pc.mean(table['score'])
print("Mean score:", mean_result.as_py())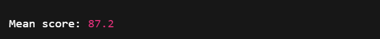
Gemiddelde score berekenen met pyarrow.compute. Afbeelding door de auteur.
Voorbeeld 3: Groeperen op categorie en gemiddelde score berekenen
import pandas as pd
# Convert to pandas for more complex grouping
df = table.to_pandas()
grouped = df.groupby('category')['score'].mean()
print(grouped)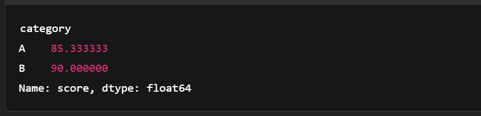
De Arrow Table groeperen. Afbeelding door de auteur.
Vergelijking met pandas-prestaties
Hier is een snelle vergelijking van Apache Arrow en pandas. Het laat zien waar Arrow uitblinkt voor grootschalige, analytische workloads.
|
Functie |
Apache Arrow |
Pandas |
|
Geheugenformaat |
Kolom-gebaseerd, zero-copy, strak verpakt |
Rij-gebaseerd (gebruikt intern NumPy-arrays) |
|
Snelheid (filteren, I/O) |
Sneller dankzij SIMD & vectorisatie |
Langzamer op grote data (kopieën, Python-lussen) |
|
Geheugengebruik |
Compacter, efficiënter |
Hoger geheugengebruik door Python-overhead |
|
Interoperabiliteit |
Uitstekend (gedeeld over talen/tools) |
Vooral Python-centraal |
|
Geschiktheid usecase |
Geoptimaliseerd voor grote, analytische workloads |
Geweldig voor kleine/middelgrote data & prototyping |
|
Serialisatie |
Feather/Parquet met zero-copy-ondersteuning |
CSV/Excel, vaak trager en volumineuzer |
Zoals we hebben gezien, integreren Arrow Tables goed met pandas, vooral bij het uitvoeren van joins. Verken meer in deze coursus over data joinen met pandas.
Apache Arrow integreren met andere datatools
Arrow kan goed samenwerken met andere datatools, waardoor je data eenvoudig tussen omgevingen verplaatst zonder snelheid of structuur te verliezen.
Arrow gebruiken met pandas
In Apache Arrow lijkt de Table op een pandas-DataFrame; beide gebruiken benoemde kolommen van gelijke lengte. Maar Arrow Tables gaan verder. Ze ondersteunen geneste kolommen, zodat je complexere datastructuren kunt weergeven dan in pandas.
Dat gezegd hebbende, zijn niet alle conversies naadloos. Toch is converteren tussen Arrow en pandas eenvoudig. Zo doe je dat:
Arrow Table → pandas DataFrame
table.to_pandas()pandas DataFrame → Arrow Table
pa.Table.from_pandas(df)En dat is het! Eén regel code is alles wat je nodig hebt.
Je kunt ook met andere pandas-structuren zoals Series werken via Arrow. Bekijk de docs voor meer info. Ook profiteren zowel Arrow als pandas van een prestatiegerichte aanpak—leer meer in deze cursus over efficiënte code schrijven met pandas.
Werken met Apache Spark
Apache Arrow is ingebouwd in Spark om data-uitwisseling tussen de JVM (Java Virtual Machine) en Python te versnellen. Dit is erg handig voor pandas- en NumPy-gebruikers. Het staat niet standaard aan, dus je moet mogelijk enkele instellingen aanpassen om het te activeren. Maar zodra het draait, verbetert Arrow de prestaties op verschillende manieren:
- Kolomformaat: Gebruikt geheugen efficiënter en ondersteunt gevectoriseerde operaties.
- Zero-copy data-uitwisseling: Hele kolommen worden direct gedeeld tussen Spark en pandas; geen dataduplicatie.
- Lagere serialisatie-overhead: Zonder Arrow is het converteren van Spark DataFrames naar pandas langzame JVM-naar-Python-serialisatie. Arrow slaat deze stap over.
- Parallelle verwerking: Arrow ondersteunt het verwerken van data in chunks, wat perfect past bij het gedistribueerde systeem van Spark.
Om te beginnen, volg de officiële PySpark met Arrow-gids.
Interoperabiliteit met machinelearning-bibliotheken
Arrow werkt ook goed met machinelearning-bibliotheken zoals TensorFlow.
Het kolomformaat maakt snellere datalading en -voorbewerking mogelijk, cruciale stappen bij het trainen van ML-modellen. En door grote datasets efficiënt te verwerken helpt Arrow bij het bouwen van schaalbare ML-pijplijnen die sneller trainen en beter werken over verschillende tools heen.
Conclusie
En dat was het! We zijn door de kernideeën achter Apache Arrow gelopen, hebben gekeken hoe het verschilt van meer traditionele dataformaten, hoe je het instelt en hoe je ermee werkt in Python.
We hebben ook hands-on voorbeelden bekeken voor het bouwen van Arrow Arrays en Tables en gezien hoe Arrow trage serialisatie helpt overslaan om dataverwerking snel en efficiënt te houden.
Als je zin hebt om verder te leren en voort te bouwen op wat we hebben behandeld, zijn dit mooie vervolgstappen:
- Introduction to Apache Kafka-cursus – Leer realtime datapijplijnen bouwen.
- Introduction to Databricks-cursus – Ga hands-on met grootschalige data-analyse.
Waar je ook naartoe gaat, we hopen dat Arrow je helpt om schonere en schaalbaardere workflows te bouwen!
FAQs
Wat is het verschil tussen Arrow en Parquet?
Parquet is een opslagformaat dat is ontworpen voor maximale ruimte-efficiëntie, terwijl Arrow een in-memory formaat is bedoeld voor bewerking door gevectoriseerde rekenkernen.
Hoe verhoudt Arrow zich tot Protobuf?
Google’s protocol buffers-bibliotheek (Protobuf) is geen “runtime in-memory formaat.” Net als Parquet is de representatie van Protobuf niet geschikt voor verwerking. Data moet voor verwerking worden gedeserialiseerd naar een in-memory representatie zoals Arrow.
Hoe verhoudt Arrow zich tot Flatbuffers?
Het Arrow-bestandsformaat gebruikt onder de motorkap Flatbuffers om schema's en andere metadata te serialiseren die nodig zijn om het Arrow binaire IPC-protocol te implementeren, maar het Arrow-dataformaat gebruikt zijn eigen representatie voor optimale toegang en berekening.
Is Apache Arrow gratis te gebruiken?
Ja, je kunt het gratis gebruiken.
Kan Apache Arrow worden gebruikt in realtime datapijplijnen?
Ja, Apache Arrow is zeer geschikt voor real-time toepassingen. De zero-copy features en het gedeelde geheugemodel verlagen de latentie, vooral in combinatie met tools zoals Apache Kafka of Spark.
Hoe werkt Apache Arrow samen met de bestandsformaten Parquet en Feather?
Arrow is in-memory, terwijl Parquet en Feather on-disk formaten zijn. Beide zijn echter Arrow-compatibel, waardoor je data met minimale overhead van geheugen naar schijf kunt serialiseren.
Is Apache Arrow beter dan pandas voor alle databewerkingen?
Niet altijd. Arrow blinkt uit in snelle, kolomgeoriënteerde, in-memory verwerking en interoperabiliteit, maar pandas is rijker aan features voor complexe dataverwerking. Gebruik Arrow wanneer performance en delen over talen belangrijk zijn.
Wat is het verschil tussen Arrow Arrays en NumPy-arrays?
Arrow Arrays ondersteunen extra metadata zoals null-afhandeling, zijn immuut en ontworpen voor taalonafhankelijke interoperabiliteit, terwijl NumPy-arrays mutabel en Python-centraal zijn.
Ondersteunt Apache Arrow geneste of complexe datatypes?
Ja. Arrow ondersteunt geneste types zoals lijsten, structs en unions, waardoor complexe hiërarchische datastructuren mogelijk zijn die vaak worden gebruikt in analytics- en ML-pijplijnen.

Ik ben een contentstrateeg die graag complexe onderwerpen eenvoudig maakt. Ik heb bedrijven als Splunk, Hackernoon en Tiiny Host geholpen om boeiende en informatieve content te maken voor hun doelgroep.


Apache Arrow helpt verschillende tools en systemen om snel en eenvoudig data uit te wisselen. Het slaat data op in een speciaal kolomgebaseerd formaat dat in het geheugen blijft, waardoor ermee werken erg snel is.
In deze tutorial neem ik je mee door de basis van Apache Arrow. Je krijgt hands-on voorbeelden om te begrijpen hoe het werkt en hoe je het in je projecten gebruikt.
Wat is Apache Arrow?
Apache Arrow is een open-source, taalonafhankelijk platform voor high-performance in-memory dataverwerking. Het definieert een gestandaardiseerd, kolomgeoriënteerd geheugenformaat geoptimaliseerd voor moderne CPU's om efficiënte analytics en gevectoriseerde berekeningen mogelijk te maken.
Arrow neemt ook de noodzaak voor serialisatie weg tussen systemen en talen, wat zero-copy reads mogelijk maakt en de verwerkingslast vermindert.
Omdat het goed samenwerkt met tools zoals pandas, Apache Spark en Dask, kun je data met minimale moeite verplaatsen. Dat maakt het een uitstekende keuze voor iedereen die snelle, flexibele systemen bouwt die veel data moeten verwerken.
Laten we Arrow nu verkennen met wat praktische voorbeelden!
Apache Arrow installeren
Apache Arrow ondersteunt meerdere talen, waaronder C, C++, C#, Python, Rust, Java, JavaScript, Julia, Go, Ruby en R.
Het werkt op Windows, macOS en populaire Linux-distributies zoals Debian, Ubuntu, CentOS en Red Hat Enterprise Linux.
In deze gids gebruiken we het met Python.
Stapsgewijze installatiewijzer
Laten we kijken hoe je Apache Arrow voor Python installeert met de officiële binary wheels die op PyPI zijn gepubliceerd. Deze stappen werken hetzelfde op Windows, macOS en Linux.
Stap 1: Controleer of Python is geïnstalleerd
Open je terminal en voer uit:
Als dit een versienummer teruggeeft, kun je aan de slag. Zo niet, installeer Python vanaf de officiële site.
Stap 2: Installeer
pyarrowmet pipOm Apache Arrow voor Python te installeren, voer je uit:
De
*zorgt ervoor dat je de nieuwste patchrelease in de 19.0-serie krijgt.Ik raad ook aan om
pyarrow==19.0.*in jerequirements.txtte gebruiken om alles consistent te houden tussen omgevingen. Dit installeertpyarrowsamen met de vereiste Apache Arrow- en Parquet C++-binary libraries die met het wheel worden meegeleverd.Wil je Arrow voor een andere taal installeren, bekijk dan de volledige documentatie.
Installatie testen
Je kunt deze korte Python-snippet draaien om te controleren of alles werkt:
Als
pyarrowcorrect is geïnstalleerd, zie je de array in je terminal geprint. Zo niet, dan geeft de code een foutmelding.Apache Arrow-kerntheorie
Voordat we dieper de code induiken, kijken we hoe Apache Arrow is opgebouwd.
Het kolomgeheugenformaat begrijpen
Het in-memory kolomformaat is een van de belangrijkste features van Apache Arrow. Het definieert een taalonafhankelijke, in-memory datastructuur. Daarnaast bevat het metadata-serialisatie, een protocol voor datatransport en een standaard manier om data over systemen te representeren.
In een kolomformaat wordt data in kolommen opgeslagen in plaats van rijen, wat verschilt van traditionele rijgebaseerde opslag. Kolomindelingen zijn populair voor analytische workloads omdat ze veel sneller te scannen en te verwerken zijn.
De afbeelding hieronder legt het formaat uit:
Kolomformaat. Bron: Apache Arrow docs
Het formaat van Apache Arrow verhoogt de efficiëntie door kolommen in aaneengesloten geheugengebieden te leggen. Dit ondersteunt moderne gevectoriseerde (SIMD) operaties, die de dataverwerking versnellen.
Door een standaard kolomindeling te gebruiken, neemt Arrow de noodzaak weg voor elk systeem om zijn eigen interne dataformaat te definiëren. Dat vermindert zowel serialisatie-overhead als dubbel werk.
Systemen kunnen data gemakkelijker delen en ontwikkelaars kunnen algoritmes hergebruiken in verschillende talen.
Zonder een gedeeld formaat zoals Arrow moeten databases of tools data serialiseren en deserialiseren voordat ze het doorgeven. Dat voegt kosten en complexiteit toe. En veelgebruikte algoritmes moeten voor de interne datastructuur van elk systeem worden herschreven.
Arrow verandert dat door te standaardiseren hoe data in het geheugen wordt weergegeven.
Hoewel kolomformaten geweldig zijn voor analytische prestaties en geheugenlokaliteit, zijn ze niet ontworpen voor frequente updates.
Dat komt omdat kolomopslag is geoptimaliseerd voor snel lezen, niet voor wijzigen. Aanpassingen aan data betekenen vaak kopiëren of geheugen opnieuw toewijzen, wat traag en resource-intensief kan zijn.
Arrow richt zich op efficiënte in-memory representatie en serialisatie. Als je usecase frequente datamutaties vereist, moet je dat op implementatieniveau afhandelen.
Wil je dieper duiken in Arrow-compatibele formaten, bekijk dan deze guide naar Apache Parquet, ideaal voor kolomgebaseerde dataopslag.
Arrow-datastructuren
Apache Arrow biedt twee kern-datastructuren:
ArrayenTable:Arraystaat voor één kolom data. Het slaat waarden op in een aaneengesloten geheugengebied, wat snelle toegang, efficiënte scans en ondersteuning voor processoroptimalisaties zoals SIMD mogelijk maakt. Elke array kan ook metadata bevatten, zoals null-indicatoren (bitmaps) en informatie over het datatype.Arrow Tablevertegenwoordigt dus een 2D-dataset. Elke kolom is een gechunkte array en alle kolommen volgen een gedeeld schema dat veldnamen en types definieert. Hoewel de chunks per kolom kunnen verschillen, moet het totale aantal elementen uitgelijnd blijven om de rijen consistent te houden.Je kunt het zien als een DataFrame in pandas of R. Het is tabelvormig, efficiënt en ondersteunt bewerkingen over meerdere kolommen tegelijk.
Voorbeeld van basisdatastructuren
Laten we een paar voorbeelden bekijken van het maken van een Arrow-
ArrayenTablein Python.Zorg dat je
pyarrowhebt geïnstalleerd voordat je de onderstaande code draait, volgens de eerdere instructies.Een Arrow Array maken
Een Arrow Array printen. Afbeelding door de auteur.
Een Arrow Table maken
Een Arrow Table printen. Afbeelding door de auteur.
Werken met Apache Arrow Arrays
Laten we zien hoe je met Arrow Arrays werkt en veelvoorkomende bewerkingen uitvoert, zoals slicen, filteren en metadata controleren.
Arrow Arrays maken
Arrow Arrays werken met verschillende datatypes, waaronder strings, drijvende-kommagetallen en gehele getallen. Zo maak je ze:
Arrow Arrays met verschillende datatypes printen. Afbeelding door de auteur.
Basisbewerkingen op Arrow Arrays
Laten we een paar veelvoorkomende bewerkingen bekijken die je met Arrow Arrays kunt uitvoeren.
Slicen
Met slicen pak je een subsectie van een array. Je kunt bijvoorbeeld elementen uit specifieke indexbereiken halen:
Een geslicete Arrow Array printen. Afbeelding door de auteur.
Filteren en metadata
Filteren gebruikt een booleaanse mask om alleen waarden te behouden die aan een voorwaarde voldoen. Je kunt ook metadata zoals type, lengte en aantal nulls opvragen.
Een gefilterde Arrow Array printen. Afbeelding door de auteur.
Metadata van een Arrow Array printen. Afbeelding door de auteur.
Apache Arrow Tables gebruiken
Je kunt Arrow Tables maken vanuit Arrow Arrays of direct vanuit native Python-datastructuren zoals dictionaries. Laten we kijken hoe.
Tabellen maken en bekijken
Er zijn twee gebruikelijke manieren om een Arrow Table te maken:
pa.table()Laten we beide manieren één voor één bekijken.
1. Met Arrow Arrays
In de bovenstaande code:
pa.table()Een Arrow Table maken met meerdere Arrow Arrays. Afbeelding door de auteur.
2. Met een Python-dictionary
Laten we nu zien hoe je een Table maakt vanuit een Python-dictionary.
Deze methode is korter en compacter. We hoeven niet handmatig arrays te definiëren; Arrow regelt dat voor ons.
Een Arrow Table direct vanuit Python-dictionaries maken. Afbeelding door de auteur.
Converteren tussen Arrow Tables en pandas DataFrames
Een van de grootste krachten van Arrow is de interoperabiliteit. Je kunt eenvoudig heen en weer tussen een Arrow Table en een pandas DataFrame. Zo doe je dat:
Een Arrow Table omzetten naar een pandas DataFrame
Een Arrow Table omzetten naar een Pandas DataFrame. Afbeelding door de auteur.
Een pandas DataFrame omzetten naar een Arrow Table
Laten we nu het omgekeerde doen:
Een pandas DataFrame converteren naar een Array Table. Afbeelding door de auteur.