

Serializzazione dei dati con Apache Arrow
La serializzazione è il processo di conversione di oggetti o strutture dati complesse in un flusso di byte per archiviare o inviare dati tra sistemi. Ma Apache Arrow adotta un approccio diverso.
Poiché Arrow usa un formato di memoria colonnare progettato per la velocità, evita la serializzazione tradizionale. Al suo posto si basa su un modello di memoria condivisa, in cui più processi possono accedere direttamente agli stessi dati senza copiarli o convertirli.
Ecco cosa consente di fare:
- Riduce l’overhead dovuto alla copia dei dati
- Riduce l’uso di memoria condividendo i dati in place
- Semplifica lo scambio di dati tra sistemi e linguaggi
Salvataggio e caricamento di dati Arrow
Vediamo come puoi salvare i dati Arrow usando il formato file Feather e ricaricarli in una Tabella usando Python.
Salvare un Arrow Table in un file Feather
import pandas as pd
import pyarrow as pa
import pyarrow.feather as feather
# Create a sample pandas DataFrame
df = pd.DataFrame({
'id': [1, 2, 3],
'name': ['Alice', 'Bob', 'Charlie'],
'score': [95.5, 82.0, 77.5]
})
# Convert DataFrame to Arrow Table
table = pa.Table.from_pandas(df)
# Save Arrow Table to a Feather file
feather.write_feather(table, 'example.feather')
print("Arrow table saved to 'example.feather'")
Conversione del DataFrame in Arrow Table. Immagine dell’autore.
Caricare un Arrow Table da un file Feather
Poi possiamo fare l’inverso e caricare un Arrow Table dal file Feather creato in precedenza.
import pyarrow.feather as feather
# Load the Feather file into an Arrow Table
loaded_table = feather.read_table('example.feather')
# (Optional) Convert back to pandas DataFrame
df_loaded = loaded_table.to_pandas()
# Print the loaded data
print(df_loaded)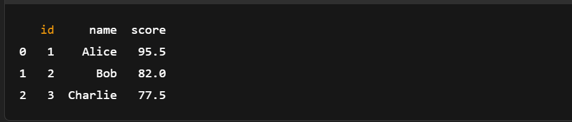
Caricamento di un Arrow Table da un file Feather. Immagine dell’autore.
Come vedi, non c’è bisogno di serializzazione manuale. Salvare e caricare dati Arrow richiede solo poche righe di codice.
Se sei alle prime armi con pandas o vuoi un ripasso, questa cheat sheet di pandas è un’ottima compagna per Arrow nelle manipolazioni veloci dei dati.
Usare Apache Arrow con dataset più grandi
Vediamo un esempio reale di quanto Arrow possa essere rapido ed efficace durante il caricamento, il filtraggio e l’analisi di un dataset di grandi dimensioni.
Caricare un dataset grande in Arrow
Inizieremo creando un DataFrame di pandas con un milione di righe.
Passaggio 1: genera un DataFrame grande
import pandas as pd
import pyarrow as pa
import pyarrow.compute as pc
import time
df = pd.DataFrame({
'id': range(1, 1_000_001), #assuming a dataset with a million rows
'value': pd.np.random.randint(1, 1000, size=1_000_000),
'category': pd.np.random.choice(['A', 'B', 'C'], size=1_000_000)
})Passaggio 2: converti in Arrow Table
start = time.time()
arrow_table = pa.Table.from_pandas(df)
end = time.time()
print(f"Conversion to Arrow Table took {end - start:.4f} seconds")Passaggio 3: filtra con la Compute API di Arrow
# Example: Filter rows where 'value' > 990
start = time.time()
filtered_table = pc.filter(arrow_table, pc.greater(arrow_table['value'], pa.scalar(990)))
end = time.time()
# Result summary
print(f"Filtering took {end - start:.4f} seconds")
print(f"Filtered row count: {filtered_table.num_rows}")Passaggio 4: riconverti in pandas (zero-copy)
start = time.time()
filtered_df = filtered_table.to_pandas()
end = time.time()
print(f"Conversion to pandas DataFrame took {end - start:.4f} seconds")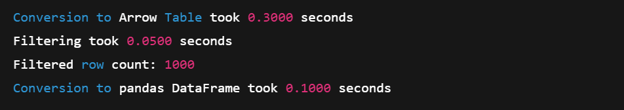
Caricamento di un dataset grande in un Array. Immagine dell’autore.
Il formato colonnare di Arrow e le funzioni di calcolo alimentate da SIMD lo rendono una scelta eccellente per operazioni in memoria su larga scala. E grazie alla conversione zero-copy, tornare a pandas è veloce ed efficiente.
Per i workflow in cui carichi i dati prima della conversione in Arrow, questo corso su ingestione dei dati semplificata con pandas può ottimizzare la tua pipeline.
Eseguire analisi di base
Puoi anche usare la compute API di Arrow per eseguire analisi di base. Ecco una demo veloce con un dataset campione più piccolo.
import pyarrow as pa
import pyarrow.compute as pc
# Sample data
data = {
'id': pa.array([1, 2, 3, 4, 5]),
'score': pa.array([85, 92, 76, 88, 95]),
'category': pa.array(['A', 'B', 'A', 'B', 'A'])
}
# Create Arrow Table
table = pa.table(data)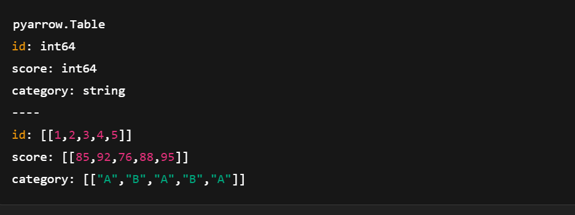
Creazione di un Arrow Table usando pyarrow.compute. Immagine dell’autore.
Esempio 1: filtra le righe con score > 90
# Filter rows where score > 90
filter_mask = pc.greater(table['score'], pa.scalar(90))
filtered_table = pc.filter(table, filter_mask)
print(filtered_table.to_pandas())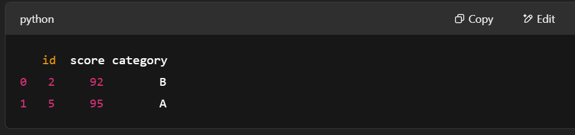
Filtrare righe usando pyarrow.compute. Immagine dell’autore.
Esempio 2: calcolare la media degli score
# Compute mean of the "score" column
mean_result = pc.mean(table['score'])
print("Mean score:", mean_result.as_py())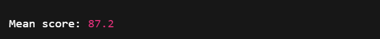
Calcolo della media degli score usando pyarrow.compute. Immagine dell’autore.
Esempio 3: raggruppa per categoria e calcola la media degli score
import pandas as pd
# Convert to pandas for more complex grouping
df = table.to_pandas()
grouped = df.groupby('category')['score'].mean()
print(grouped)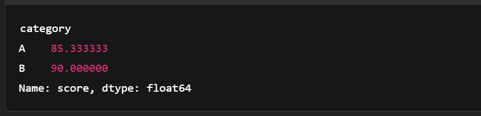
Raggruppamento dell’Arrow Table. Immagine dell’autore.
Confronto con le prestazioni di pandas
Ecco un rapido confronto tra Apache Arrow e pandas. Mostra dove Arrow eccelle per carichi analitici su larga scala.
|
Funzionalità |
Apache Arrow |
Pandas |
|
Formato di memoria |
Colonnare, zero-copy, compatto |
Basato su righe (usa internamente array NumPy) |
|
Velocità (filtraggio, I/O) |
Più veloce grazie a SIMD e vettorizzazione |
Più lento su grandi dati (copie, loop Python) |
|
Uso di memoria |
Più compatto, efficiente |
Maggiore utilizzo di memoria per l’overhead di Python |
|
Interoperabilità |
Eccellente (condiviso tra linguaggi/strumenti) |
Perlopiù centrato su Python |
|
Casi d’uso ideali |
Ottimizzato per carichi analitici su larga scala |
Ottimo per dati piccoli/medi e prototipazione |
|
Serializzazione |
Feather/Parquet con supporto zero-copy |
CSV/Excel, spesso più lenti e ingombranti |
Come abbiamo visto, gli Arrow Table si integrano bene con pandas, soprattutto durante le join. Approfondisci in questo corso su unire i dati con pandas.
Integrazione di Apache Arrow con altri strumenti dati
Arrow può lavorare bene con altri strumenti di data, facilitando lo spostamento dei dati tra ambienti senza perdere velocità o struttura.
Usare Arrow con pandas
In Apache Arrow, la Table è simile a un DataFrame di pandas: entrambe usano colonne nominate di uguale lunghezza. Ma gli Arrow Table vanno oltre. Supportano colonne annidate, così puoi rappresentare strutture dati più complesse rispetto a pandas.
Detto questo, non tutte le conversioni sono perfette. Tuttavia, convertire tra Arrow e pandas è semplice. Ecco come:
Arrow Table → pandas DataFrame
table.to_pandas()pandas DataFrame → Arrow Table
pa.Table.from_pandas(df)E questo è tutto! Basta una riga di codice.
Puoi anche lavorare con altre strutture di pandas come le Series usando Arrow. Controlla la documentazione per saperne di più. Inoltre, sia Arrow che pandas beneficiano di un design attento alle prestazioni—scopri di più in questo corso su scrivere codice efficiente con pandas.
Lavorare con Apache Spark
Apache Arrow è integrato in Spark per velocizzare lo scambio di dati tra la JVM (Java Virtual Machine) e Python. Questo è molto utile per chi usa pandas e NumPy. Non è attivo di default, quindi potresti dover modificare alcune impostazioni per abilitarlo. Una volta attivato, Arrow migliora le prestazioni in vari modi:
- Formato colonnare: usa la memoria in modo più efficiente e supporta operazioni vettorializzate.
- Scambio dati zero-copy: intere colonne sono condivise direttamente tra Spark e pandas; niente duplicazione dei dati.
- Minore overhead di serializzazione: senza Arrow, convertire Spark DataFrame in pandas comporta una lenta serializzazione dalla JVM a Python. Arrow salta questo passaggio.
- Elaborazione parallela: Arrow supporta l’elaborazione dei dati a chunk, perfettamente in linea con il sistema distribuito di Spark.
Per iniziare, segui la guida ufficiale a PySpark con Arrow.
Interoperabilità con le librerie di machine learning
Arrow funziona bene anche con librerie di machine learning come TensorFlow.
Il suo formato colonnare consente caricamenti e pre-processing più rapidi, passaggi chiave nell’addestramento di modelli di machine learning. E gestendo in modo efficiente dataset di grandi dimensioni, Arrow aiuta a costruire pipeline ML scalabili che si addestrano più velocemente e funzionano meglio tra strumenti diversi.
Conclusione
E con questo è tutto! Abbiamo visto le idee fondamentali dietro Apache Arrow, come differisce dai formati dati più tradizionali, come configurarlo e come usarlo in Python.
Abbiamo anche esplorato esempi pratici per costruire Arrow Array e Table e visto come Arrow evita la serializzazione lenta per mantenere l’elaborazione dei dati rapida ed efficiente.
Se vuoi continuare a imparare e approfondire quanto visto, ecco alcune ottime risorse per proseguire:
- Introduction to Apache Kafka – Impara a costruire pipeline dati in tempo reale.
- Introduction to Databricks – Metti le mani in pasta con l’analisi dati su larga scala.
Qualunque sia la tua prossima tappa, speriamo che Arrow ti aiuti a costruire workflow più puliti e scalabili!
FAQ
Qual è la differenza tra Arrow e Parquet?
Parquet è un formato di archiviazione progettato per la massima efficienza di spazio, mentre Arrow è un formato in memoria pensato per l’uso da parte di kernel computazionali vettorializzati.
In che modo Arrow è correlato a Protobuf?
La libreria Protocol Buffers di Google (Protobuf) non è un “formato in memoria a runtime”. Come Parquet, la rappresentazione di Protobuf non è adatta all’elaborazione. I dati devono essere deserializzati in una rappresentazione in memoria come Arrow per poter essere elaborati.
In che modo Arrow è correlato a Flatbuffers?
Il formato file Arrow utilizza Flatbuffers sotto il cofano per serializzare schemi e altri metadati necessari a implementare il protocollo IPC binario di Arrow, ma il formato dati di Arrow usa una propria rappresentazione per un accesso e un calcolo ottimali.
Apache Arrow è gratuito da usare?
Sì, puoi usarlo gratuitamente.
Si può usare Apache Arrow in pipeline dati in tempo reale?
Sì, Apache Arrow è adatto alle applicazioni in tempo reale. Le sue funzionalità zero-copy e il modello di memoria condivisa riducono la latenza, soprattutto in combinazione con strumenti come Apache Kafka o Spark.
Come interagisce Apache Arrow con i formati di file Parquet e Feather?
Arrow è in memoria, mentre Parquet e Feather sono formati su disco. Tuttavia, sia Feather sia Parquet sono compatibili con Arrow, rendendo semplice serializzare i dati dalla memoria al disco con overhead minimo.
Apache Arrow è migliore di pandas per tutte le operazioni sui dati?
Non sempre. Arrow eccelle nell’elaborazione in memoria, colonnare e veloce, e nell’interoperabilità, ma pandas è più ricco di funzionalità per trasformazioni complesse. Usa Arrow quando contano prestazioni e condivisione tra linguaggi.
Qual è la differenza tra Arrow Array e array NumPy?
Gli Arrow Array supportano metadati aggiuntivi come la gestione dei null, sono immutabili e progettati per l’interoperabilità tra linguaggi, mentre gli array NumPy sono mutabili e incentrati su Python.
Apache Arrow supporta tipi di dati annidati o complessi?
Sì. Arrow supporta tipi annidati come liste, struct e union, abilitando strutture dati gerarchiche complesse comunemente usate in analytics e pipeline ML.

Sono una content strategist: mi piace semplificare argomenti complessi. Ho aiutato aziende come Splunk, Hackernoon e Tiiny Host a creare contenuti coinvolgenti e informativi per il loro pubblico.





Apache Arrow aiuta strumenti e sistemi diversi a condividere i dati in modo rapido e semplice. Memorizza i dati in un formato speciale basato su colonne che rimane in memoria, rendendo il lavoro molto veloce.
In questo tutorial ti guiderò attraverso le basi di Apache Arrow. Vedrai esempi pratici per capire come funziona e come usarlo nei tuoi progetti.
Che cos’è Apache Arrow?
Apache Arrow is un progetto open-source, multipiattaforma e multilanguage per l’elaborazione ad alte prestazioni di dati in memoria. Definisce un formato di memoria colonnare standardizzato e ottimizzato per le CPU moderne per abilitare analisi efficienti e computazione vettoriale.
Arrow inoltre elimina la necessità di serializzazione tra sistemi e linguaggi, consentendo letture zero-copy e riducendo l’overhead di elaborazione.
Poiché si integra bene con strumenti come pandas, Apache Spark e Dask, puoi spostare i dati con il minimo sforzo. Questo lo rende un’ottima scelta per chi costruisce sistemi veloci e flessibili che devono gestire grandi volumi di dati.
Ora esploriamo Arrow con alcuni esempi pratici!
Installare Apache Arrow
Apache Arrow supporta diversi linguaggi, tra cui C, C++, C#, Python, Rust, Java, JavaScript, Julia, Go, Ruby e R.
Funziona su Windows, macOS e sulle principali distribuzioni Linux, come Debian, Ubuntu, CentOS e Red Hat Enterprise Linux.
In questa guida lo useremo con Python.
Guida all’installazione passo passo
Vediamo come installare Apache Arrow per Python usando i wheel binari ufficiali pubblicati su PyPI. Questi passaggi funzionano allo stesso modo su Windows, macOS e Linux.
Passaggio 1: verifica se Python è installato
Apri il terminale ed esegui:
Se restituisce un numero di versione, sei a posto. In caso contrario, installa Python dal sito ufficiale.
Passaggio 2: installa
pyarrowcon pipPer installare Apache Arrow per Python, esegui:
Il
*garantisce che tu ottenga l’ultima patch release della serie 19.0.Consiglio anche di usare
pyarrow==19.0.*nel tuorequirements.txtper mantenere la coerenza tra gli ambienti. Questo installeràpyarrowinsieme alle librerie binarie C++ richieste di Apache Arrow e Parquet incluse nel wheel.Per installare Arrow per un altro linguaggio, dai un’occhiata alla documentazione completa.
Testare l’installazione
Puoi eseguire questo breve snippet Python per verificare che tutto funzioni:
Se
pyarrowè installato correttamente, vedrai l’array stampato nel terminale. In caso contrario, il codice genererà un errore.Fondamenti di Apache Arrow
Prima di entrare più a fondo nel codice, capiamo come è costruito Apache Arrow.
Capire il formato di memoria colonnare
Il formato colonnare in memoria è una delle caratteristiche più importanti di Apache Arrow. Definisce una struttura dati in memoria indipendente dal linguaggio. Inoltre, include la serializzazione dei metadati, un protocollo per il trasporto dei dati e un modo standard per rappresentare i dati tra i sistemi.
In un formato colonnare, i dati sono memorizzati per colonne anziché per righe, diversamente dall’archiviazione tradizionale basata su righe. I layout colonnari sono popolari per i carichi analitici perché sono molto più veloci da scandire ed elaborare.
L’immagine seguente spiega il formato:
Formato colonnare. Fonte: documentazione di Apache Arrow
Il formato di Apache Arrow aumenta l’efficienza disponendo le colonne in blocchi di memoria contigui. Questo supporta le operazioni vettorializzate (SIMD) moderne, che accelerano l’elaborazione dei dati.
Usando un layout colonnare standard, Arrow elimina la necessità per ogni sistema di definire il proprio formato dati interno. Questo riduce sia l’overhead di serializzazione sia la duplicazione degli sforzi.
I sistemi possono condividere i dati più facilmente e gli sviluppatori possono riutilizzare algoritmi tra linguaggi diversi.
Senza un formato condiviso come Arrow, ogni database o strumento deve serializzare e deserializzare i dati prima di passarli oltre. Questo aggiunge costi e complessità. E gli algoritmi comuni devono essere riscritti per la struttura dati interna di ogni sistema.
Arrow cambia le cose standardizzando la rappresentazione dei dati in memoria.
Sebbene i formati colonnari siano eccellenti per le prestazioni analitiche e la località della memoria, non sono progettati per aggiornamenti frequenti.
Questo perché l’archiviazione colonnare è ottimizzata per la lettura veloce, non per le modifiche. Apportare cambiamenti ai dati spesso significa copiare o riallocare memoria, operazioni lente e dispendiose in risorse.
Arrow si concentra su una rappresentazione in memoria efficiente e sulla serializzazione. Se il tuo caso d’uso richiede modifiche frequenti ai dati, dovrai gestirle a livello di implementazione.
Per approfondire i formati compatibili con Arrow, consulta questa guida a Apache Parquet, ideale per l’archiviazione di dati colonnari.
Strutture dati di Arrow
Apache Arrow fornisce due strutture dati principali:
ArrayeTable:Arrayrappresenta una singola colonna di dati. Memorizza i valori in un blocco di memoria contiguo, consentendo accesso veloce, scansioni efficienti e supporto per ottimizzazioni a livello di processore come la SIMD. Ogni array può includere anche metadati come indicatori di null (bitmap) e informazioni sul tipo di dato.Arrow Tablerappresenta un dataset 2D. Ogni colonna è un array a chunk, e tutte le colonne seguono uno schema condiviso che definisce nomi dei campi e tipi. Anche se i chunk possono differire tra colonne, il numero totale di elementi deve rimanere allineato per mantenere coerenti le righe.Puoi pensarla come un DataFrame in pandas o R. È tabellare, efficiente e supporta operazioni su più colonne contemporaneamente.
Esempio di strutture dati di base
Vediamo alcuni esempi per creare un
Arraye unaTabledi Arrow in Python.Assicurati di aver installato
pyarrowprima di eseguire il codice qui sotto, seguendo le istruzioni precedenti.Creare un Arrow Array
Stampa di un Arrow Array. Immagine dell’autore.
Creare un Arrow Table
Stampa di un Arrow Table. Immagine dell’autore.
Lavorare con gli Arrow Array
Vediamo come lavorare con gli Arrow Array ed eseguire operazioni comuni, come slicing, filtro e verifica dei metadati.
Creare Arrow Array
Gli Arrow Array funzionano con diversi tipi di dati, inclusi stringhe, numeri in virgola mobile e interi. Ecco come crearli:
Stampa di Arrow Array con tipi di dati diversi. Immagine dell’autore.
Operazioni di base sugli Arrow Array
Vediamo alcune operazioni comuni che puoi eseguire con gli Arrow Array.
Slicing
Lo slicing ti permette di prendere una sottosezione di un array. Per esempio, puoi estrarre elementi in specifici intervalli di indici:
Stampa di un Arrow Array affettato (sliced). Immagine dell’autore.
Filtraggio e metadati
Il filtraggio usa una maschera booleana per mantenere solo i valori che soddisfano una condizione. Puoi anche accedere a metadati come tipo, lunghezza e conteggio dei null.
Stampa di un Arrow Array filtrato. Immagine dell’autore.
Stampa dei metadati di un Arrow Array. Immagine dell’autore.
Usare gli Arrow Table
Puoi creare Arrow Table a partire da Arrow Array o direttamente da strutture dati native di Python come i dizionari. Vediamo come.
Creare e visualizzare tabelle
Ci sono due modi comuni per creare un Arrow Table:
pa.table()Esploriamo entrambi i modi uno per uno.
1. Usando Arrow Array
Nel codice sopra:
pa.table()Creazione di un Arrow Table usando più Arrow Array. Immagine dell’autore.
2. Usando un dizionario Python
Ora vediamo come creare una Tabella da un dizionario Python.
Questo metodo è più breve e compatto. Non dobbiamo definire manualmente gli array; Arrow se ne occupa per noi.
Creazione di un Arrow Table direttamente da dizionari Python. Immagine dell’autore.
Conversione tra Arrow Table e DataFrame di pandas
Uno dei maggiori punti di forza di Arrow è l’interoperabilità. Puoi passare facilmente da un Arrow Table a un DataFrame di pandas. Vediamo come fare:
Convertire un Arrow Table in un DataFrame pandas
Conversione di un Arrow Table in un DataFrame pandas. Immagine dell’autore.
Convertire un DataFrame pandas in un Arrow Table
Ora vediamo come fare l’operazione inversa:
Conversione di un DataFrame pandas in un Arrow Table. Immagine dell’autore.