

Tuần tự hóa dữ liệu với Apache Arrow
Tuần tự hóa là quá trình chuyển các đối tượng hoặc cấu trúc dữ liệu phức tạp thành luồng byte để lưu trữ hoặc gửi giữa các hệ thống. Nhưng Apache Arrow tiếp cận theo cách khác.
Vì Arrow sử dụng định dạng bộ nhớ dạng cột được thiết kế cho tốc độ, nó tránh tuần tự hóa truyền thống. Thay vào đó, nó dựa trên mô hình bộ nhớ dùng chung, nơi nhiều tiến trình có thể truy cập cùng dữ liệu trực tiếp mà không cần sao chép hay chuyển đổi.
Cụ thể, nó làm được:
- Cắt giảm chi phí do sao chép dữ liệu
- Giảm sử dụng bộ nhớ bằng cách chia sẻ dữ liệu tại chỗ
- Đơn giản hóa trao đổi dữ liệu giữa các hệ thống và ngôn ngữ
Lưu và tải dữ liệu Arrow
Hãy xem cách bạn có thể lưu dữ liệu Arrow bằng định dạng tệp Feather và tải lại thành Table bằng Python.
Lưu Arrow Table thành tệp Feather
import pandas as pd
import pyarrow as pa
import pyarrow.feather as feather
# Create a sample pandas DataFrame
df = pd.DataFrame({
'id': [1, 2, 3],
'name': ['Alice', 'Bob', 'Charlie'],
'score': [95.5, 82.0, 77.5]
})
# Convert DataFrame to Arrow Table
table = pa.Table.from_pandas(df)
# Save Arrow Table to a Feather file
feather.write_feather(table, 'example.feather')
print("Arrow table saved to 'example.feather'")
Chuyển DataFrame sang Arrow Table. Ảnh: tác giả.
Tải Arrow Table từ tệp Feather
Sau đó, chúng ta có thể làm ngược lại và tải một Arrow Table từ tệp Feather vừa tạo.
import pyarrow.feather as feather
# Load the Feather file into an Arrow Table
loaded_table = feather.read_table('example.feather')
# (Optional) Convert back to pandas DataFrame
df_loaded = loaded_table.to_pandas()
# Print the loaded data
print(df_loaded)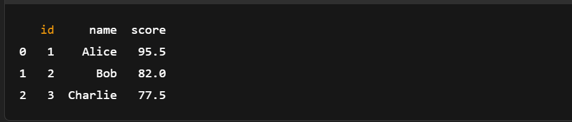
Tải Arrow Table từ tệp Feather. Ảnh: tác giả.
Như bạn thấy, không cần tuần tự hóa thủ công. Lưu và tải dữ liệu Arrow chỉ mất vài dòng mã.
Nếu bạn mới dùng pandas hoặc cần ôn lại, tờ cheat sheet pandas này là tài liệu bổ trợ tuyệt vời cho Arrow để thao tác dữ liệu nhanh.
Sử dụng Apache Arrow với bộ dữ liệu lớn
Hãy xem ví dụ thực tế về việc Arrow nhanh và hiệu quả thế nào khi tải, lọc và phân tích một bộ dữ liệu lớn.
Tải bộ dữ liệu lớn vào Arrow
Chúng ta sẽ bắt đầu bằng cách tạo một pandas DataFrame với một triệu hàng.
Bước 1: Tạo DataFrame lớn
import pandas as pd
import pyarrow as pa
import pyarrow.compute as pc
import time
df = pd.DataFrame({
'id': range(1, 1_000_001), #assuming a dataset with a million rows
'value': pd.np.random.randint(1, 1000, size=1_000_000),
'category': pd.np.random.choice(['A', 'B', 'C'], size=1_000_000)
})Bước 2: Chuyển sang Arrow Table
start = time.time()
arrow_table = pa.Table.from_pandas(df)
end = time.time()
print(f"Conversion to Arrow Table took {end - start:.4f} seconds")Bước 3: Lọc với Compute API của Arrow
# Example: Filter rows where 'value' > 990
start = time.time()
filtered_table = pc.filter(arrow_table, pc.greater(arrow_table['value'], pa.scalar(990)))
end = time.time()
# Result summary
print(f"Filtering took {end - start:.4f} seconds")
print(f"Filtered row count: {filtered_table.num_rows}")Bước 4: Chuyển đổi lại sang pandas (zero-copy)
start = time.time()
filtered_df = filtered_table.to_pandas()
end = time.time()
print(f"Conversion to pandas DataFrame took {end - start:.4f} seconds")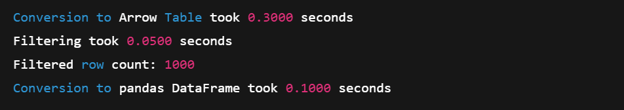
Tải một bộ dữ liệu lớn vào Array. Ảnh: tác giả.
Định dạng dạng cột và các hàm tính toán tận dụng SIMD của Arrow khiến nó trở thành lựa chọn tuyệt vời cho các thao tác trong bộ nhớ quy mô lớn. Và nhờ chuyển đổi zero-copy, quay lại pandas nhanh và hiệu quả.
Với quy trình làm việc nơi bạn tải dữ liệu trước khi chuyển sang Arrow, khóa học về nạp dữ liệu tinh gọn với pandas có thể tối ưu hóa pipeline của bạn.
Thực hiện phân tích cơ bản
Bạn cũng có thể dùng compute API của Arrow để chạy các phân tích cơ bản. Đây là bản demo nhanh với tập mẫu nhỏ hơn.
import pyarrow as pa
import pyarrow.compute as pc
# Sample data
data = {
'id': pa.array([1, 2, 3, 4, 5]),
'score': pa.array([85, 92, 76, 88, 95]),
'category': pa.array(['A', 'B', 'A', 'B', 'A'])
}
# Create Arrow Table
table = pa.table(data)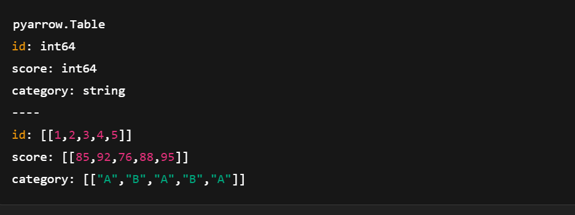
Tạo một Arrow Table bằng pyarrow.compute. Ảnh: tác giả.
Ví dụ 1: Lọc các hàng có score > 90
# Filter rows where score > 90
filter_mask = pc.greater(table['score'], pa.scalar(90))
filtered_table = pc.filter(table, filter_mask)
print(filtered_table.to_pandas())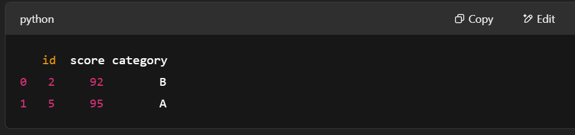
Lọc hàng bằng pyarrow.compute. Ảnh: tác giả.
Ví dụ 2: Tính điểm trung bình
# Compute mean of the "score" column
mean_result = pc.mean(table['score'])
print("Mean score:", mean_result.as_py())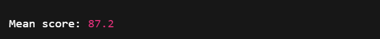
Tính điểm trung bình bằng pyarrow.compute. Ảnh: tác giả.
Ví dụ 3: Group by theo category và tính điểm trung bình
import pandas as pd
# Convert to pandas for more complex grouping
df = table.to_pandas()
grouped = df.groupby('category')['score'].mean()
print(grouped)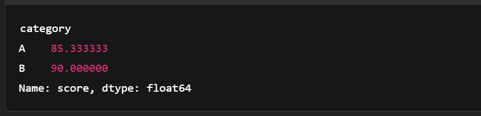
Gom nhóm Arrow Table. Ảnh: tác giả.
So sánh hiệu năng với pandas
Dưới đây là so sánh nhanh giữa Apache Arrow và pandas. Nó cho thấy vị trí nổi bật của Arrow trong các khối lượng công việc phân tích quy mô lớn.
|
Tính năng |
Apache Arrow |
Pandas |
|
Định dạng bộ nhớ |
Dạng cột, zero-copy, đóng gói chặt chẽ |
Dựa trên hàng (bên trong dùng mảng NumPy) |
|
Tốc độ (Lọc, I/O) |
Nhanh hơn nhờ SIMD & vector hóa |
Chậm hơn với dữ liệu lớn (sao chép, vòng lặp Python) |
|
Sử dụng bộ nhớ |
Gọn nhẹ, hiệu quả hơn |
Dùng nhiều bộ nhớ hơn do overhead của Python |
|
Khả năng tương tác |
Xuất sắc (chia sẻ giữa ngôn ngữ/công cụ) |
Chủ yếu tập trung vào Python |
|
Phù hợp trường hợp sử dụng |
Tối ưu cho khối lượng công việc phân tích lớn |
Tốt cho dữ liệu nhỏ/vừa & tạo mẫu nhanh |
|
Tuần tự hóa |
Feather/Parquet với hỗ trợ zero-copy |
CSV/Excel, thường chậm và cồng kềnh hơn |
Như chúng ta đã thấy, Arrow Table tích hợp tốt với pandas, đặc biệt khi thực hiện join. Khám phá thêm trong khóa học về kết hợp dữ liệu với pandas.
Tích hợp Apache Arrow với các công cụ dữ liệu khác
Arrow có thể hoạt động tốt với các công cụ dữ liệu khác, giúp việc di chuyển dữ liệu giữa môi trường trở nên dễ dàng mà không mất tốc độ hay cấu trúc.
Sử dụng Arrow với pandas
Trong Apache Arrow, Table tương tự pandas DataFrame, cả hai đều dùng các cột có tên và cùng độ dài. Nhưng Arrow Table còn tiến xa hơn. Chúng hỗ trợ cột lồng nhau, vì vậy bạn có thể biểu diễn cấu trúc dữ liệu phức tạp hơn so với pandas.
Dù vậy, không phải mọi chuyển đổi đều liền mạch. Tuy nhiên, chuyển đổi giữa Arrow và pandas rất đơn giản. Cách làm như sau:
Arrow Table → pandas DataFrame
table.to_pandas()pandas DataFrame → Arrow Table
pa.Table.from_pandas(df)Vậy là xong! Chỉ một dòng mã là đủ.
Bạn cũng có thể làm việc với các cấu trúc pandas khác như Series bằng Arrow. Xem tài liệu để tìm hiểu thêm. Ngoài ra, cả Arrow và pandas đều hưởng lợi từ thiết kế hướng hiệu năng—tìm hiểu thêm trong khóa học về viết mã hiệu quả với pandas.
Làm việc với Apache Spark
Apache Arrow được tích hợp sẵn trong Spark để tăng tốc trao đổi dữ liệu giữa JVM (Java Virtual Machine) và Python. Điều này rất hữu ích cho người dùng pandas và NumPy. Nó không được bật theo mặc định, vì vậy bạn có thể cần thay đổi một số thiết lập để kích hoạt. Nhưng khi đã chạy, Arrow cải thiện hiệu năng theo nhiều cách:
- Định dạng dạng cột: Sử dụng bộ nhớ hiệu quả hơn và hỗ trợ thao tác vector hóa.
- Trao đổi dữ liệu zero-copy: Toàn bộ cột được chia sẻ trực tiếp giữa Spark và pandas; không nhân đôi dữ liệu.
- Giảm chi phí tuần tự hóa: Không dùng Arrow, việc chuyển Spark DataFrame sang pandas liên quan đến tuần tự hóa chậm giữa JVM và Python. Arrow bỏ qua bước này.
- Xử lý song song: Arrow hỗ trợ xử lý dữ liệu theo khối, rất phù hợp với hệ thống phân tán của Spark.
Để bắt đầu, hãy làm theo hướng dẫn chính thức về PySpark với Arrow.
Khả năng tương tác với các thư viện máy học
Arrow cũng hoạt động tốt với các thư viện máy học như TensorFlow.
Định dạng dạng cột cho phép tải và tiền xử lý dữ liệu nhanh hơn, các bước then chốt khi huấn luyện mô hình máy học. Và bằng cách xử lý hiệu quả các bộ dữ liệu lớn, Arrow giúp xây dựng pipeline ML có thể mở rộng, huấn luyện nhanh hơn và hoạt động tốt hơn giữa các công cụ khác nhau.
Kết luận
Vậy là xong! Chúng ta đã đi qua các ý tưởng cốt lõi đằng sau Apache Arrow, xem nó khác gì so với các định dạng dữ liệu truyền thống hơn, cách thiết lập và cách làm việc với nó trong Python.
Chúng ta cũng đã xem các ví dụ thực hành để xây dựng Arrow Array và Table, và thấy cách Arrow giúp bỏ qua tuần tự hóa chậm để giữ cho xử lý dữ liệu nhanh và hiệu quả.
Nếu bạn muốn tiếp tục học và phát triển dựa trên những gì đã đề cập, dưới đây là một số tài nguyên tuyệt vời để đi tiếp:
- Khóa học Introduction to Apache Kafka – Học cách xây dựng pipeline dữ liệu thời gian thực.
- Khóa học Introduction to Databricks – Trải nghiệm thực hành với phân tích dữ liệu quy mô lớn.
Dù bạn chọn hướng nào, hy vọng Arrow sẽ giúp bạn xây dựng quy trình làm việc gọn gàng và có khả năng mở rộng hơn!
Câu hỏi thường gặp
Sự khác biệt giữa Arrow và Parquet là gì?
Parquet là định dạng lưu trữ được thiết kế để tối ưu không gian, trong khi Arrow là định dạng trong bộ nhớ dành cho các kernel tính toán dạng vector.
Arrow liên quan thế nào đến Protobuf?
Thư viện protocol buffers của Google (Protobuf) không phải là “định dạng trong bộ nhớ khi chạy”. Tương tự Parquet, biểu diễn của Protobuf không phù hợp cho xử lý. Dữ liệu phải được giải tuần tự vào một biểu diễn trong bộ nhớ như Arrow để xử lý.
Arrow liên quan thế nào đến Flatbuffers?
Định dạng tệp Arrow có dùng Flatbuffers ở tầng dưới để tuần tự hóa lược đồ và các siêu dữ liệu khác cần cho giao thức Arrow binary IPC, nhưng định dạng dữ liệu của Arrow dùng biểu diễn riêng để tối ưu truy cập và tính toán.
Apache Arrow có miễn phí không?
Có, bạn có thể dùng miễn phí.
Apache Arrow có thể dùng trong pipeline dữ liệu thời gian thực không?
Có, Apache Arrow rất phù hợp cho ứng dụng thời gian thực. Tính năng zero-copy và mô hình bộ nhớ dùng chung giúp giảm độ trễ, đặc biệt khi kết hợp với các công cụ như Apache Kafka hoặc Spark.
Apache Arrow tương tác với định dạng tệp Parquet và Feather như thế nào?
Arrow là trong bộ nhớ, trong khi Parquet và Feather là các định dạng trên đĩa. Tuy nhiên, cả Feather và Parquet đều tương thích với Arrow, giúp tuần tự hóa dữ liệu từ bộ nhớ ra đĩa với chi phí tối thiểu.
Apache Arrow có tốt hơn pandas cho mọi thao tác dữ liệu không?
Không phải lúc nào cũng vậy. Arrow vượt trội trong xử lý nhanh, dạng cột, trong bộ nhớ và khả năng tương tác, nhưng pandas giàu tính năng hơn cho xử lý dữ liệu phức tạp. Hãy dùng Arrow khi hiệu năng và chia sẻ đa ngôn ngữ là quan trọng.
Sự khác nhau giữa Arrow Array và mảng NumPy là gì?
Arrow Array hỗ trợ siêu dữ liệu bổ sung như xử lý giá trị null, là bất biến, và được thiết kế cho khả năng tương tác đa ngôn ngữ, trong khi mảng NumPy là khả biến và tập trung vào Python.
Apache Arrow có hỗ trợ kiểu dữ liệu lồng nhau hoặc phức tạp không?
Có. Arrow hỗ trợ các kiểu lồng nhau như list, struct và union, cho phép cấu trúc dữ liệu phân cấp phức tạp thường dùng trong phân tích và pipeline ML.

Tôi là một chiến lược gia nội dung, yêu thích việc đơn giản hóa các chủ đề phức tạp. Tôi đã giúp các công ty như Splunk, Hackernoon và Tiiny Host tạo nội dung hấp dẫn và giàu thông tin cho khán giả của họ.


Apache Arrow giúp các công cụ và hệ thống khác nhau chia sẻ dữ liệu nhanh chóng và dễ dàng. Nó lưu trữ dữ liệu theo định dạng dạng cột đặc biệt nằm trong bộ nhớ, nhờ đó việc thao tác trở nên cực kỳ nhanh.
Trong hướng dẫn này, tôi sẽ giới thiệu cho bạn những kiến thức cơ bản về Apache Arrow. Bạn sẽ có các ví dụ thực hành để hiểu cách nó hoạt động và cách sử dụng trong dự án của bạn.
Apache Arrow là gì?
Apache Arrow là một nền tảng mã nguồn mở, đa ngôn ngữ cho xử lý dữ liệu trong bộ nhớ hiệu năng cao. Nó định nghĩa một định dạng bộ nhớ dạng cột tiêu chuẩn hóa tối ưu hoá cho CPU hiện đại để cho phép phân tích hiệu quả và tính toán vector hóa.
Arrow còn loại bỏ nhu cầu tuần tự hóa giữa các hệ thống và ngôn ngữ, cho phép đọc zero-copy và giảm chi phí xử lý.
Vì hoạt động tốt với các công cụ như pandas, Apache Spark và Dask, bạn có thể di chuyển dữ liệu với ít nỗ lực. Điều đó khiến nó trở thành lựa chọn tuyệt vời cho bất kỳ ai xây dựng hệ thống nhanh, linh hoạt và cần xử lý nhiều dữ liệu.
Giờ hãy khám phá Arrow qua một số ví dụ thực tế!
Cài đặt Apache Arrow
Apache Arrow hỗ trợ nhiều ngôn ngữ, bao gồm C, C++, C#, Python, Rust, Java, JavaScript, Julia, Go, Ruby và R.
Nó hoạt động trên Windows, macOS và các bản phân phối Linux phổ biến như Debian, Ubuntu, CentOS và Red Hat Enterprise Linux.
Trong hướng dẫn này, chúng ta sẽ dùng với Python.
Hướng dẫn cài đặt từng bước
Hãy xem cách cài đặt Apache Arrow cho Python bằng các gói nhị phân chính thức được phát hành trên PyPI. Các bước này giống nhau trên Windows, macOS và Linux.
Bước 1: Kiểm tra Python đã được cài chưa
Mở terminal và chạy:
Nếu lệnh trả về số phiên bản, bạn có thể tiếp tục. Nếu không, hãy cài Python từ trang chính thức.
Bước 2: Cài
pyarrowbằng pipĐể cài Apache Arrow cho Python, chạy:
Dấu
*đảm bảo bạn nhận được bản vá mới nhất trong dòng 19.0.Tôi cũng khuyên dùng
pyarrow==19.0.*trongrequirements.txtđể giữ nhất quán giữa các môi trường. Lệnh này sẽ càipyarrowcùng các thư viện nhị phân C++ Apache Arrow và Parquet cần thiết được đóng gói trong wheel.Để cài Arrow cho ngôn ngữ khác, hãy xem tài liệu đầy đủ.
Kiểm tra cài đặt
Bạn có thể chạy đoạn mã Python nhanh này để kiểm tra mọi thứ hoạt động ổn:
Nếu
pyarrowđược cài đúng, bạn sẽ thấy mảng được in ra trong terminal. Nếu không, mã sẽ ném lỗi.Những điều cơ bản về Apache Arrow
Trước khi đi sâu vào mã, hãy hiểu cách Apache Arrow được xây dựng.
Tìm hiểu định dạng bộ nhớ dạng cột
Định dạng dạng cột trong bộ nhớ là một trong những tính năng quan trọng nhất của Apache Arrow. Nó định nghĩa cấu trúc dữ liệu trong bộ nhớ, độc lập ngôn ngữ. Ngoài ra, còn bao gồm tuần tự hóa siêu dữ liệu, một giao thức cho truyền dữ liệu và cách chuẩn để biểu diễn dữ liệu giữa các hệ thống.
Trong định dạng dạng cột, dữ liệu được lưu theo cột thay vì theo hàng, khác với lưu trữ dựa trên hàng truyền thống. Bố cục dạng cột phổ biến cho khối lượng công việc phân tích vì quét và xử lý nhanh hơn nhiều.
Hình dưới giải thích định dạng:
Định dạng dạng cột. Nguồn: Tài liệu Apache Arrow
Định dạng của Apache Arrow tăng hiệu quả bằng cách sắp xếp các cột trong các khối bộ nhớ liên tiếp. Điều này hỗ trợ các phép toán vector hóa (SIMD) hiện đại, giúp tăng tốc xử lý dữ liệu.
Với bố cục dạng cột tiêu chuẩn, Arrow loại bỏ nhu cầu mỗi hệ thống phải tự định nghĩa định dạng dữ liệu nội bộ. Điều đó giảm cả chi phí tuần tự hóa lẫn trùng lặp công sức.
Các hệ thống có thể chia sẻ dữ liệu dễ dàng hơn, và nhà phát triển có thể tái sử dụng thuật toán trên nhiều ngôn ngữ.
Nếu không có định dạng chung như Arrow, mỗi cơ sở dữ liệu hay công cụ cần tuần tự hóa và giải tuần tự dữ liệu trước khi truyền đi. Điều đó làm tăng chi phí và độ phức tạp. Và các thuật toán phổ biến phải được viết lại cho cấu trúc dữ liệu nội bộ của từng hệ thống.
Arrow thay đổi điều đó bằng cách chuẩn hóa cách dữ liệu được biểu diễn trong bộ nhớ.
Mặc dù định dạng dạng cột rất tốt cho hiệu năng phân tích và tính cục bộ của bộ nhớ, nhưng không được thiết kế cho cập nhật thường xuyên.
Đó là vì lưu trữ dạng cột tối ưu cho việc đọc nhanh, không phải sửa đổi. Việc thay đổi dữ liệu thường đồng nghĩa với sao chép hoặc cấp phát lại bộ nhớ, có thể chậm và tốn tài nguyên.
Arrow tập trung vào biểu diễn dữ liệu trong bộ nhớ và tuần tự hóa hiệu quả. Nếu trường hợp sử dụng của bạn cần thay đổi dữ liệu thường xuyên, bạn sẽ cần xử lý ở tầng triển khai.
Để tìm hiểu sâu hơn về các định dạng tương thích Arrow, hãy xem hướng dẫn về Apache Parquet, lý tưởng cho lưu trữ dữ liệu dạng cột.
Cấu trúc dữ liệu của Arrow
Apache Arrow cung cấp hai cấu trúc dữ liệu chính:
ArrayvàTable:Arrayđại diện cho một cột dữ liệu. Nó lưu các giá trị trong một khối bộ nhớ liên tiếp, cho phép truy cập nhanh, quét hiệu quả và hỗ trợ tối ưu hóa ở cấp xử lý như SIMD. Mỗi mảng cũng có thể mang siêu dữ liệu như chỉ báo null (bitmap) và thông tin kiểu dữ liệu.Arrow Tableđại diện cho tập dữ liệu 2D. Mỗi cột là một mảng chia khúc, và tất cả các cột tuân theo cùng một lược đồ xác định tên trường và kiểu. Dù các khúc có thể khác nhau giữa các cột, tổng số phần tử phải được căn chỉnh để giữ hàng nhất quán.Bạn có thể hình dung nó giống như DataFrame trong pandas hoặc R. Dạng bảng, hiệu quả và hỗ trợ thao tác trên nhiều cột đồng thời.
Ví dụ về các cấu trúc dữ liệu cơ bản
Hãy xem một vài ví dụ tạo
ArrayvàTablecủa Arrow trong Python.Hãy đảm bảo bạn đã cài
pyarrowtrước khi chạy mã dưới đây, theo hướng dẫn trước đó.Tạo Arrow Array
In một Arrow Array. Ảnh: tác giả.
Tạo Arrow Table
In một Arrow Table. Ảnh: tác giả.
Làm việc với Arrow Array
Hãy xem cách làm việc với Arrow Array và thực hiện các thao tác thường gặp như cắt lát, lọc và kiểm tra siêu dữ liệu.
Tạo Arrow Array
Arrow Array làm việc với nhiều kiểu dữ liệu, bao gồm chuỗi, số thực dấu phẩy động và số nguyên. Cách tạo như sau:
In Arrow Array với các kiểu dữ liệu khác nhau. Ảnh: tác giả.
Các thao tác cơ bản trên Arrow Array
Hãy xem một vài thao tác thường gặp bạn có thể thực hiện với Arrow Array.
Cắt lát (Slicing)
Cắt lát cho phép bạn lấy một phần con của mảng. Ví dụ, bạn có thể trích xuất các phần tử ở dải chỉ mục cụ thể:
In một Arrow Array sau khi cắt lát. Ảnh: tác giả.
Lọc và siêu dữ liệu
Lọc sử dụng một mặt nạ Boolean để giữ lại các giá trị thỏa điều kiện. Bạn cũng có thể truy cập siêu dữ liệu như kiểu, độ dài và số lượng null.
In một Arrow Array sau khi lọc. Ảnh: tác giả.
In siêu dữ liệu của một Arrow Array. Ảnh: tác giả.
Sử dụng Apache Arrow Table
Bạn có thể tạo Arrow Table từ Arrow Array hoặc trực tiếp từ cấu trúc dữ liệu gốc của Python như từ điển. Hãy xem cách làm.
Tạo và xem bảng
Có hai cách phổ biến để tạo Arrow Table:
pa.table()Hãy lần lượt khám phá cả hai cách.
1. Sử dụng Arrow Array
Trong đoạn mã trên:
pa.table()Tạo một Arrow Table bằng nhiều Arrow Array. Ảnh: tác giả.
2. Sử dụng từ điển Python
Giờ hãy xem cách tạo Table từ một từ điển Python.
Cách này ngắn gọn và súc tích hơn. Chúng ta không cần tự định nghĩa mảng; Arrow xử lý giúp.
Tạo một Arrow Table trực tiếp từ từ điển Python. Ảnh: tác giả.
Chuyển đổi giữa Arrow Table và pandas DataFrame
Một trong những thế mạnh lớn của Arrow là khả năng tương tác. Bạn có thể dễ dàng chuyển qua lại giữa Arrow Table và pandas DataFrame. Hãy xem cách làm:
Chuyển Arrow Table thành Pandas DataFrame
Chuyển Arrow Table sang Pandas DataFrame. Ảnh: tác giả.
Chuyển Pandas DataFrame thành Arrow Table
Giờ hãy xem cách làm ngược lại:
Chuyển đổi pandas DataFrame sang Array Table. Ảnh: tác giả.