

कोर्स
pandas के साथ Data Manipulation
4 घंटा
567.5K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंApache Arrow अलग-अलग टूल्स और सिस्टम्स को डेटा साझा करने में तेज़ी और आसानी से मदद करता है। यह डेटा को एक विशेष कॉलम-आधारित फ़ॉर्मेट में मेमोरी में ही संग्रहीत करता है, जिससे उस पर काम करना बहुत तेज़ हो जाता है।
इस ट्यूटोरियल में, मैं आपको Apache Arrow की मूल बातें समझाऊँगा। आप हाथों-हाथ उदाहरणों के माध्यम से जानेंगे कि यह कैसे काम करता है और अपने प्रोजेक्ट्स में इसका उपयोग कैसे करें।
Apache Arrow iस एक ओपन-सोर्स, क्रॉस-लैंग्वेज प्लेटफ़ॉर्म है जो हाई-परफ़ॉर्मेंस इन-मेमोरी डेटा प्रोसेसिंग के लिए बना है। यह एक स्टैंडर्ड, कॉलमनर मेमोरी फ़ॉर्मेट परिभाषित करता है जो मॉडर्न CPU के लिए ऑप्टिमाइज़्ड है ताकि एनालिटिक्स और वेक्टराइज़्ड कम्प्यूटेशन कुशलता से हो सके।
Arrow सीरियलाइज़ेशन की ज़रूरत को भी हटाता है सिस्टम्स और भाषाओं के बीच, जिससे ज़ीरो-कॉपी रीड संभव होती है और प्रोसेसिंग ओवरहेड कम होता है।
क्योंकि यह pandas, Apache Spark, और Dask जैसे टूल्स के साथ अच्छी तरह काम करता है, आप बहुत कम प्रयास में डेटा इधर-उधर कर सकते हैं। यह उन सभी के लिए बेहतरीन विकल्प है जो तेज़, लचीले सिस्टम बनाते हैं जिन्हें बड़े पैमाने पर डेटा संभालना होता है।
अब, कुछ व्यवहारिक उदाहरणों के साथ Arrow को एक्सप्लोर करते हैं!
Apache Arrow कई भाषाओं को सपोर्ट करता है, जिनमें C, C++, C#, Python, Rust, Java, JavaScript, Julia, Go, Ruby, और R शामिल हैं।
यह Windows, macOS, और लोकप्रिय Linux डिस्ट्रीब्यूशन्स—जैसे Debian, Ubuntu, CentOS, और Red Hat Enterprise Linux—पर काम करता है।
इस गाइड में, हम इसे Python के साथ उपयोग करेंगे।
आइए PyPI पर प्रकाशित आधिकारिक बाइनरी व्हील्स का उपयोग करके Python के लिए Apache Arrow इंस्टॉल करना देखें। ये स्टेप्स Windows, macOS, और Linux पर समान हैं।
अपना टर्मिनल खोलें और चलाएँ:
python --versionअगर यह कोई वर्ज़न नंबर लौटाता है, तो सब ठीक है। अगर नहीं, तो Python को आधिकारिक साइट से इंस्टॉल करें।
pyarrow इंस्टॉल करेंPython के लिए Apache Arrow इंस्टॉल करने के लिए चलाएँ:
pip install 'pyarrow==19.0.* ' यहाँ * सुनिश्चित करता है कि आपको 19.0 सीरीज़ का नवीनतम पैच रिलीज़ मिले।
मैं यह भी सुझाव देता हूँ कि अपने requirements.txt फ़ाइल में pyarrow==19.0.* का उपयोग करें ताकि अलग-अलग वातावरणों में सामंजस्य बना रहे। इससे pyarrow के साथ आवश्यक Apache Arrow और Parquet C++ बाइनरी लाइब्रेरीज़, जो व्हील में बंडल होती हैं, इंस्टॉल हो जाएँगी।
किसी दूसरी भाषा के लिए Arrow इंस्टॉल करने हेतु, पूरी डॉक्यूमेंटेशन देखें।
सब कुछ सही काम कर रहा है या नहीं, यह जाँचने के लिए आप यह छोटा Python स्निपेट चला सकते हैं:
import pyarrow as pa
# Create a simple Arrow array
data = pa.array([1, 2, 3, 4, 5])
print("Apache Arrow is installed and working!")
print("Arrow Array:", data)
यदि pyarrow सही से इंस्टॉल है, तो आपको टर्मिनल में ऐरे प्रिंट होकर दिखेगा। नहीं तो कोड एक एरर देगा।
कोड में गहराई से जाने से पहले, समझते हैं कि Apache Arrow कैसे बना है।
इन-मेमोरी कॉलमनर फ़ॉर्मेट, Apache Arrow की सबसे अहम विशेषताओं में से एक है। यह एक भाषा-स्वतंत्र, इन-मेमोरी डेटा स्ट्रक्चर परिभाषित करता है। इसके अलावा, इसमें मेटाडेटा सीरियलाइज़ेशन, डेटा ट्रांसपोर्ट के लिए एक प्रोटोकॉल, और सिस्टम्स में डेटा को दर्शाने का एक मानक तरीका शामिल है।
कॉलमनर फ़ॉर्मेट में, डेटा पंक्तियों के बजाय कॉलम्स में संग्रहीत होता है, जो पारंपरिक रो-बेस्ड स्टोरेज से अलग है। कॉलमनर लेआउट्स विश्लेषणात्मक वर्कलोड्स के लिए लोकप्रिय हैं क्योंकि वे स्कैन और प्रोसेस करने में बहुत तेज़ होते हैं।
नीचे दी गई इमेज इस फ़ॉर्मेट को समझाती है:
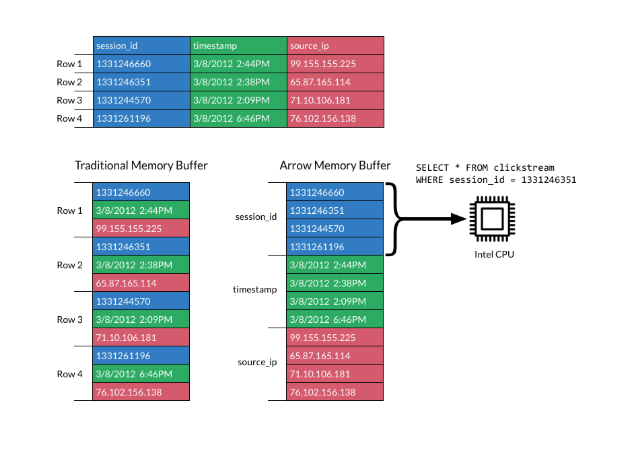
कॉलमनर फ़ॉर्मेट। स्रोत: Apache Arrow डॉक्स
Apache Arrow का फ़ॉर्मेट सन्निहित (contiguous) मेमोरी ब्लॉक्स में कॉलम्स को रखकर दक्षता बढ़ाता है। यह आधुनिक वेक्टराइज़्ड (SIMD) ऑपरेशन्स को सपोर्ट करता है, जो डेटा प्रोसेसिंग को तेज़ करते हैं।
एक मानक कॉलमनर लेआउट का उपयोग करके, Arrow हर सिस्टम को अपना आंतरिक डेटा फ़ॉर्मेट परिभाषित करने की ज़रूरत से मुक्त करता है। इससे सीरियलाइज़ेशन ओवरहेड और दोहराए जाने वाले प्रयास दोनों कम होते हैं।
सिस्टम्स के बीच डेटा साझा करना आसान हो जाता है, और डेवलपर्स अलग-अलग भाषाओं में एल्गोरिद्म्स को पुन: उपयोग कर सकते हैं।
Arrow जैसे साझा फ़ॉर्मेट के बिना, हर डेटाबेस या टूल को डेटा पास करने से पहले उसे सीरियलाइज़ और डी-सीरियलाइज़ करना पड़ता है। इससे लागत और जटिलता बढ़ती है। और आम एल्गोरिद्म्स को हर सिस्टम के आंतरिक डेटा स्ट्रक्चर के अनुसार दोबारा लिखना पड़ता है।
Arrow इसे बदलता है, यह मानकीकृत करता है कि मेमोरी में डेटा को कैसे प्रस्तुत किया जाए।
हालाँकि कॉलमनर फ़ॉर्मेट्स विश्लेषणात्मक परफ़ॉर्मेंस और मेमोरी लोकैलिटी के लिए बढ़िया हैं, वे बार-बार अपडेट्स के लिए डिज़ाइन नहीं किए गए होते।
क्योंकि कॉलमनर स्टोरेज तेज़ रीडिंग के लिए ऑप्टिमाइज़ होता है, न कि संशोधित करने के लिए। डेटा में बदलाव करना अक्सर मेमोरी की कॉपी या रिअलोकेशन की मांग करता है, जो धीमा और संसाधन-गहन हो सकता है।
Arrow कुशल इन-मेमोरी प्रतिवेदन और सीरियलाइज़ेशन पर ध्यान देता है। यदि आपके उपयोग-केस में बार-बार डेटा परिवर्तन की आवश्यकता है, तो आपको उसे इम्प्लीमेंटेशन स्तर पर संभालना होगा।
Arrow-कम्पैटिबल फ़ॉर्मेट्स में गहराई से जाने के लिए, इस गुide to Apache Parquet देखें, जो कॉलुमनर डेटा स्टोरेज के लिए उपयुक्त है।
Apache Arrow दो मुख्य डेटा स्ट्रक्चर प्रदान करता है: Array और Table:
Array एक सिंगल कॉलम का प्रतिनिधित्व करता है। यह मानों को सन्निहित मेमोरी ब्लॉक में स्टोर करता है, जिससे तेज़ एक्सेस, कुशल स्कैनिंग और SIMD जैसी प्रोसेसर-स्तरीय ऑप्टिमाइज़ेशन संभव होती हैं। प्रत्येक ऐरे में नल इंडिकेटर्स (बिटमैप्स) और डेटा टाइप जानकारी जैसी मेटाडेटा भी हो सकती है।Arrow Table 2D डेटासेट का प्रतिनिधित्व करता है। प्रत्येक कॉलम एक चंक्ड ऐरे होता है, और सभी कॉलम एक साझा स्कीमा का पालन करते हैं जो फ़ील्ड नाम और टाइप्स परिभाषित करता है। भले ही चंक्स कॉलम्स में अलग-अलग हो सकते हैं, लेकिन कुल एलिमेंट्स की संख्या पंक्तियों को सुसंगत रखने के लिए संरेखित रहनी चाहिए।आप इसे pandas या R के DataFrame जैसा समझ सकते हैं। यह टेब्युलर, कुशल है, और एक साथ कई कॉलम्स पर ऑपरेशन्स को सपोर्ट करता है।
Python में Arrow Array और Table बनाने के कुछ उदाहरण देखते हैं।
नीचे दिया गया कोड चलाने से पहले, सुनिश्चित करें कि pyarrow इंस्टॉल है—पिछले निर्देश देखें।
import pyarrow as pa

# Create an Arrow Array (single column)
data = pa.array([1, 2, 3, 4, 5])
print("Arrow Array:")
print(data)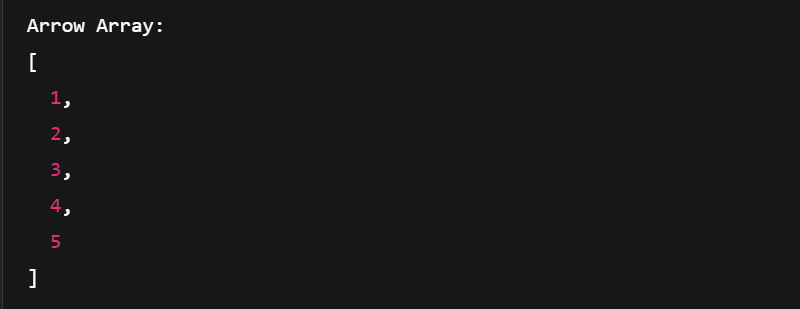
Arrow Array प्रिंट करें। चित्र: लेखक।
import pyarrow as pa

# Create an Arrow Table (multiple columns)
table = pa.table({
    'column1': pa.array([1, 2, 3]),
    'column2': pa.array(['a', 'b', 'c'])
})

print("\nArrow Table:")
print(table)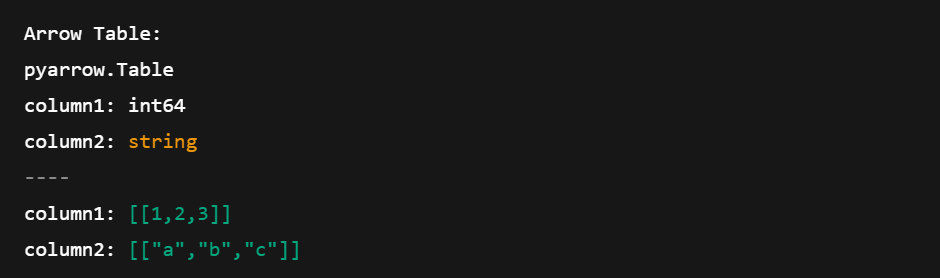
Arrow Table प्रिंट करें। चित्र: लेखक।
आइए देखें कि Arrow Arrays के साथ कैसे काम करें और स्लाइसिंग, फ़िल्टरिंग, और मेटाडेटा जाँच जैसी सामान्य क्रियाएँ करें।
Arrow Arrays अलग-अलग डेटा टाइप्स के साथ काम करते हैं, जिनमें स्ट्रिंग, फ़्लोटिंग-पॉइंट नंबर और इंटिजर्स शामिल हैं। इन्हें ऐसे बनाएँ:
import pyarrow as pa

# Integer Array
int_array = pa.array([10, 20, 30], type=pa.int32())
print("Integer Array:")
print(int_array)

# String Array
string_array = pa.array(["apple", "banana", "cherry"], type=pa.string())
print("\nString Array:")
print(string_array)

# Floating-point Array
float_array = pa.array([1.1, 2.2, 3.3], type=pa.float64())
print("\nFloating-point Array:")
print(float_array)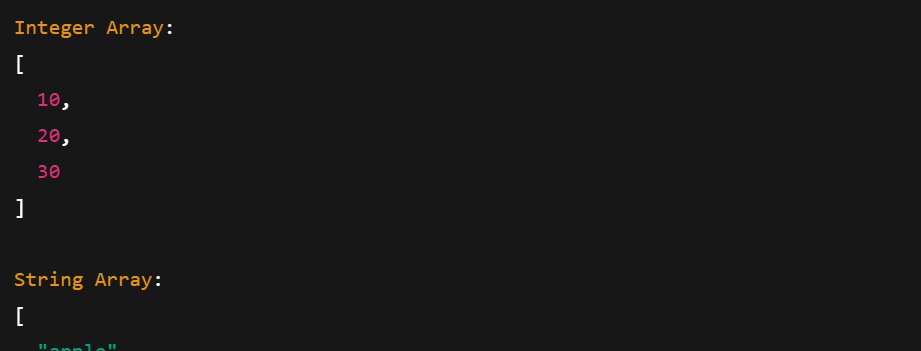
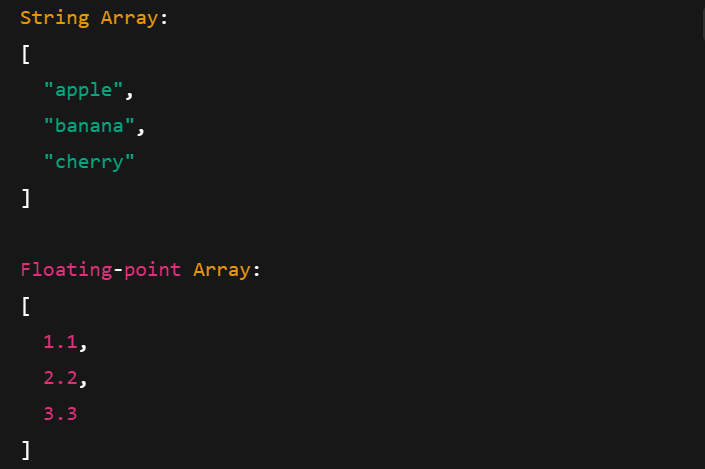
अलग-अलग डेटा टाइप्स के Arrow Arrays प्रिंट करना। चित्र: लेखक।
आइए कुछ आम ऑपरेशन्स देखें जो आप Arrow Arrays पर कर सकते हैं।
स्लाइसिंग से आप किसी ऐरे का उप-भाग ले सकते हैं। उदाहरण के लिए, आप खास इंडेक्स रेंज के एलिमेंट्स निकाल सकते हैं:
import pyarrow as pa
arr = pa.array([10, 20, 30, 40, 50])
# Slice from index 1 to 4 (3 elements: 20, 30, 40)
sliced = arr.slice(1, 3)
print("Original Array:", arr)
print("Sliced Array (1:4):", sliced)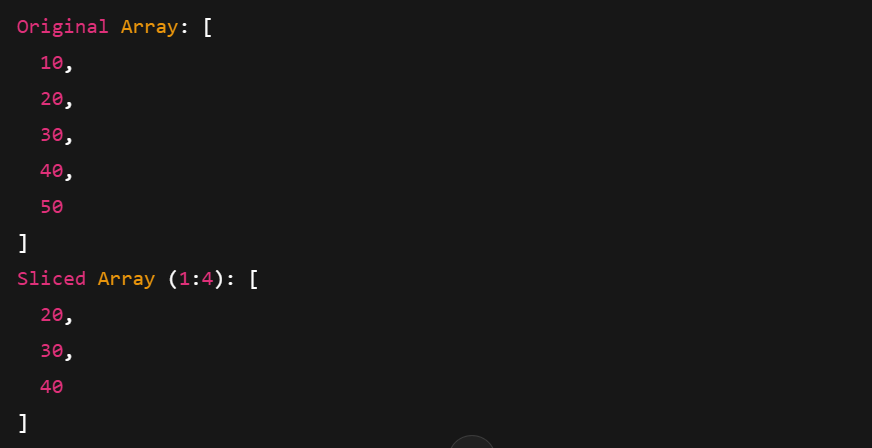
स्लाइस किया हुआ Arrow Array प्रिंट करना। चित्र: लेखक।
फ़िल्टरिंग किसी शर्त से मेल खाने वाले मानों को रखने के लिए बूलियन मास्क का उपयोग करती है। आप टाइप, लंबाई, और नल काउंट जैसे मेटाडेटा भी एक्सेस कर सकते हैं।
import pyarrow.compute as pc

arr = pa.array([10, 20, 30, 40, 50])

# Create a boolean mask: Keep elements > 25
mask = pc.greater(arr, pa.scalar(25))

# Apply the filter
filtered = pc.filter(arr, mask)

print("Filtered Array (values > 25):", filtered)

print("Array Type:", arr.type)
print("Array Length:", len(arr))
print("Null Count:", arr.null_count)
print("Is Null Bitmap Buffers:", arr.buffers())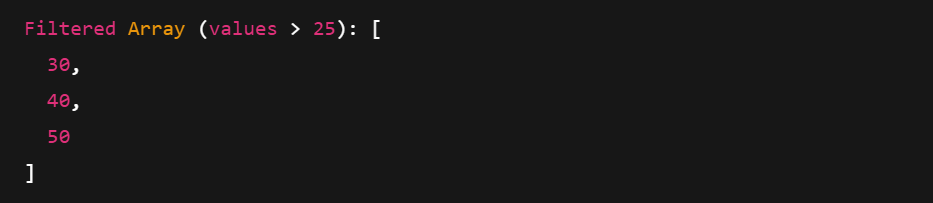
फ़िल्टर किया हुआ Arrow Array प्रिंट करना। चित्र: लेखक।
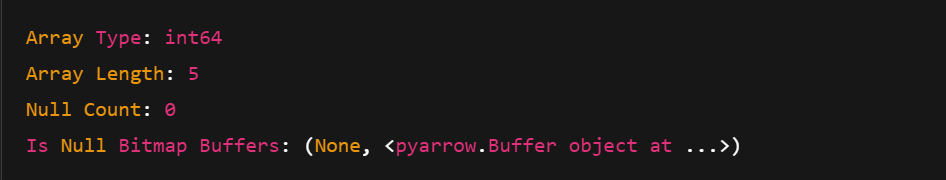
Arrow Array का मेटाडेटा प्रिंट करना। चित्र: लेखक।
आप Arrow Tables को Arrow Arrays से या सीधे Python डेटा स्ट्रक्चर्स जैसे डिक्शनरीज़ से बना सकते हैं। आइए देखें कैसे।
Arrow Table बनाने के दो आम तरीके हैं:
pa.table() के साथ Python डिक्शनरी का उपयोग करनाआइए दोनों तरीकों को एक-एक करके देखें।
import pyarrow as pa

# Create individual Arrow Arrays
ids = pa.array([1, 2, 3])
names = pa.array(['Alice', 'Bob', 'Charlie'])
scores = pa.array([85.0, 92.5, 78.3])

# Combine them into a Table
table = pa.table({
    'id': ids,
    'name': names,
    'score': scores
})

print("Arrow Table from Arrays:")
print(table)
ऊपर दिए गए कोड में:
pa.table() के साथ उन्हें एक टेबल में जोड़ा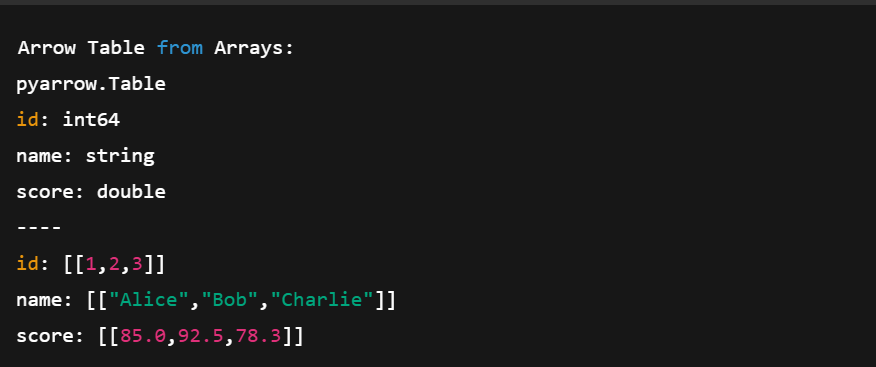
कई Arrow Arrays का उपयोग करके Arrow Table बनाना। चित्र: लेखक।
अब देखें कि Python डिक्शनरी से टेबल कैसे बनाते हैं।
# Create a table directly from Python data
data = {
    'id': [4, 5, 6],
    'name': ['Diana', 'Eve', 'Frank'],
    'score': [88.0, 79.5, 91.2]
}

table2 = pa.table(data)

print("\nArrow Table from Dictionary:")
print(table2)
यह तरीका छोटा और अधिक कॉम्पैक्ट है। हमें ऐरेज़ को मैन्युअली परिभाषित नहीं करना पड़ता; Arrow यह काम कर देता है।
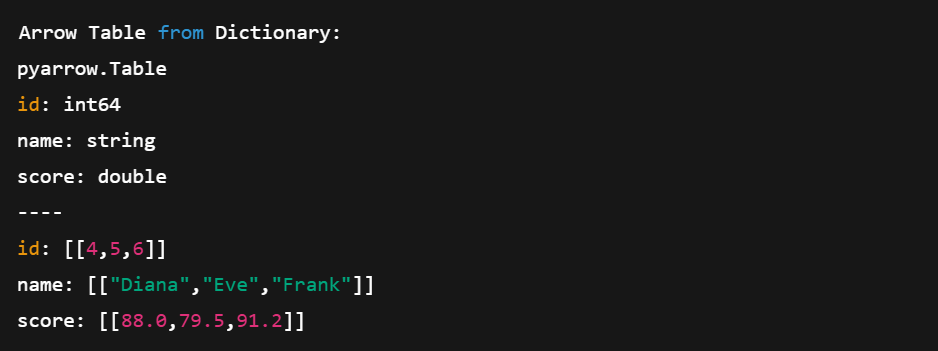
Python डिक्शनरीज़ से सीधे Arrow Table बनाना। चित्र: लेखक।
Arrow की सबसे बड़ी ताकतों में से एक है इंटरऑपरेबिलिटी। आप आसानी से Arrow Table और pandas DataFrame के बीच जा सकते हैं। आइए देखें कैसे:
import pyarrow as pa
import pandas as pd

# Create an Arrow Table
data = {
    'numbers': [1, 2, 3],
    'fruits': ['apple', 'banana', 'cherry'],
    'prices': [1.1, 2.2, 3.3]
}
arrow_table = pa.table(data)

# Convert Arrow Table to pandas DataFrame
df = arrow_table.to_pandas()

# Show the DataFrame
print(df)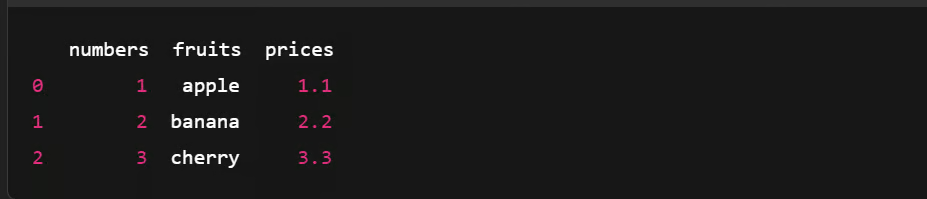
Arrow Table को Pandas DataFrame में बदलना। चित्र: लेखक।
अब, इसका उलटा देखते हैं:
import pyarrow as pa
import pandas as pd

# Create a pandas DataFrame
df = pd.DataFrame({
    'numbers': [1, 2, 3],
    'fruits': ['apple', 'banana', 'cherry'],
    'prices': [1.1, 2.2, 3.3]
})

# Convert pandas DataFrame to Arrow Table
arrow_table = pa.Table.from_pandas(df)

# Show the Arrow Table
print(arrow_table)
pandas DataFrame को Array Table में बदलना। चित्र: लेखक।
सीरियलाइज़ेशन जटिल ऑब्जेक्ट्स या डेटा स्ट्रक्चर्स को बाइट्स की स्ट्रीम में बदलने की प्रक्रिया है ताकि सिस्टम्स के बीच डेटा स्टोर या भेजा जा सके। लेकिन Apache Arrow अलग तरीका अपनाता है।
क्योंकि Arrow स्पीड के लिए डिज़ाइन किए गए कॉलमनर मेमोरी फ़ॉर्मेट का उपयोग करता है, यह पारंपरिक सीरियलाइज़ेशन से बचता है। इसके बजाय, यह एक शेयर्ड मेमोरी मॉडल पर निर्भर करता है, जहाँ कई प्रोसेसेज़ बिना कॉपी या कन्वर्ट किए एक ही डेटा को सीधे एक्सेस कर सकते हैं।
यह क्या करता है:
आइए देखें कि Feather फ़ाइल फ़ॉर्मेट का उपयोग करके Arrow डेटा कैसे सेव करें और Python में उसे वापस एक टेबल के रूप में लोड करें।
import pandas as pd
import pyarrow as pa
import pyarrow.feather as feather

# Create a sample pandas DataFrame
df = pd.DataFrame({
    'id': [1, 2, 3],
    'name': ['Alice', 'Bob', 'Charlie'],
    'score': [95.5, 82.0, 77.5]
})

# Convert DataFrame to Arrow Table
table = pa.Table.from_pandas(df)
# Save Arrow Table to a Feather file
feather.write_feather(table, 'example.feather')
print("Arrow table saved to 'example.feather'")
DataFrame को Arrow Table में बदलना। चित्र: लेखक।
फिर, हम इसके उलट कर सकते हैं और पहले बनाई गई Feather फ़ाइल से Arrow Table लोड कर सकते हैं।
import pyarrow.feather as feather

# Load the Feather file into an Arrow Table
loaded_table = feather.read_table('example.feather')

# (Optional) Convert back to pandas DataFrame
df_loaded = loaded_table.to_pandas()

# Print the loaded data
print(df_loaded)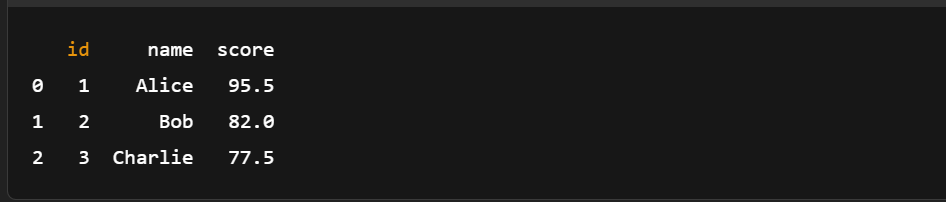
Feather फ़ाइल से Arrow Table लोड करना। चित्र: लेखक।
जैसा कि आप देख सकते हैं, मैन्युअल सीरियलाइज़ेशन की ज़रूरत नहीं है। Arrow डेटा को सेव और लोड करना कुछ ही लाइन के कोड में हो जाता है।
अगर आप pandas में नए हैं या दोहराव चाहते हैं, this pandas चीट शीट क्विक डेटा मैनीपुलेशंस के लिए Arrow का बेहतरीन साथी है।
आइए एक वास्तविक उदाहरण देखें कि बड़े डेटासेट को लोड, फ़िल्टर और विश्लेषण करते समय Arrow कितना तेज़ और प्रभावी हो सकता है।
हम एक मिलियन पंक्तियों वाला pandas DataFrame बनाकर शुरू करेंगे।
import pandas as pd
import pyarrow as pa
import pyarrow.compute as pc
import time
df = pd.DataFrame({
    'id': range(1, 1_000_001),  #assuming a dataset with a million rows
    'value': pd.np.random.randint(1, 1000, size=1_000_000),
    'category': pd.np.random.choice(['A', 'B', 'C'], size=1_000_000)
})start = time.time()
arrow_table = pa.Table.from_pandas(df)
end = time.time()
print(f"Conversion to Arrow Table took {end - start:.4f} seconds")# Example: Filter rows where 'value' > 990
start = time.time()
filtered_table = pc.filter(arrow_table, pc.greater(arrow_table['value'], pa.scalar(990)))
end = time.time()
# Result summary
print(f"Filtering took {end - start:.4f} seconds")
print(f"Filtered row count: {filtered_table.num_rows}")start = time.time()
filtered_df = filtered_table.to_pandas()
end = time.time()
print(f"Conversion to pandas DataFrame took {end - start:.4f} seconds")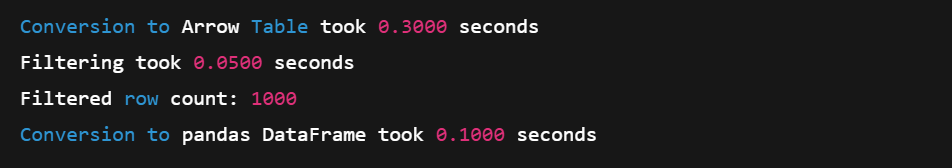
बड़े डेटासेट को Array में लोड करना। चित्र: लेखक।
Arrow का कॉलमनर फ़ॉर्मेट और SIMD-संचालित कम्प्यूट फ़ंक्शन्स इसे बड़े पैमाने पर इन-मेमोरी ऑपरेशन्स के लिए बेहतरीन विकल्प बनाते हैं। और ज़ीरो-कॉपी कन्वर्ज़न की बदौलत, वापस pandas में जाना तेज़ और कुशल है।
उन वर्कफ़्लोज़ के लिए जहाँ आप Arrow कन्वर्ज़न से पहले डेटा लोड करते हैं, यह कोर्se on streamlined data ingestion with pandas आपकी पाइपलाईन को अनुकूलित कर सकता है।
आप Arrow की compute API का उपयोग करके बेसिक एनालिटिक्स भी चला सकते हैं। यहाँ एक छोटे सैंपल डेटासेट के साथ त्वरित डेमो है।
import pyarrow as pa
import pyarrow.compute as pc
# Sample data
data = {
    'id': pa.array([1, 2, 3, 4, 5]),
    'score': pa.array([85, 92, 76, 88, 95]),
    'category': pa.array(['A', 'B', 'A', 'B', 'A'])
}
# Create Arrow Table
table = pa.table(data)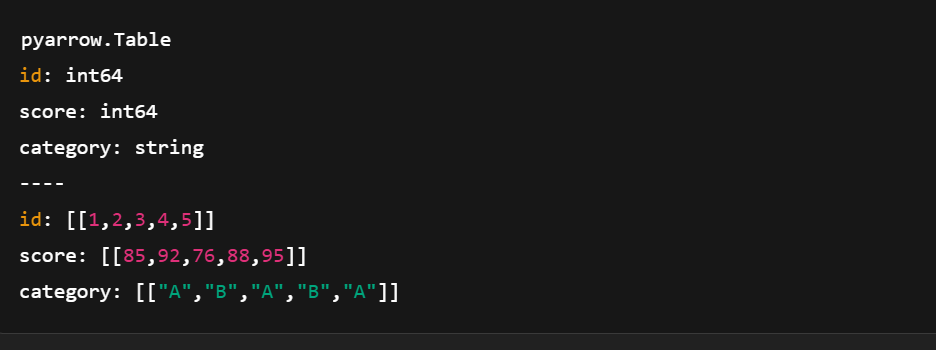
pyarrow.compute का उपयोग करके Arrow Table बनाना। चित्र: लेखक।
# Filter rows where score > 90
filter_mask = pc.greater(table['score'], pa.scalar(90))
filtered_table = pc.filter(table, filter_mask)

print(filtered_table.to_pandas())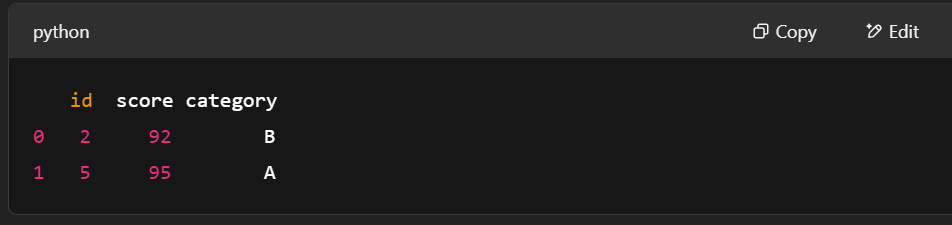
pyarrow.compute का उपयोग करके पंक्तियाँ फ़िल्टर करना। चित्र: लेखक।
# Compute mean of the "score" column
mean_result = pc.mean(table['score'])
print("Mean score:", mean_result.as_py())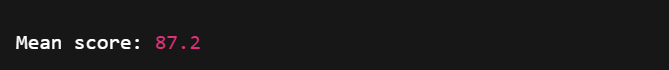
pyarrow.compute से औसत स्कोर निकालना। चित्र: लेखक।
import pandas as pd

# Convert to pandas for more complex grouping
df = table.to_pandas()
grouped = df.groupby('category')['score'].mean()
print(grouped)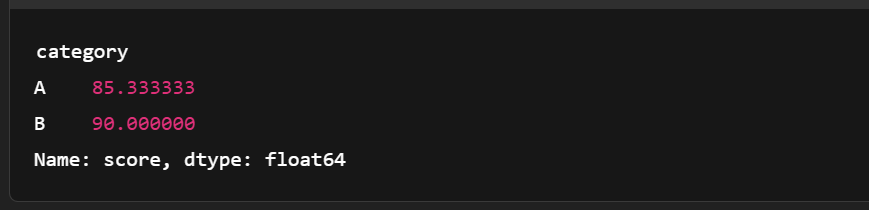
Arrow Table को समूहित करना। चित्र: लेखक।
यहाँ Apache Arrow और pandas की त्वरित तुलना है। यह दिखाती है कि बड़े पैमाने, विश्लेषणात्मक वर्कलोड्स के लिए Arrow कहाँ उभरकर आता है।
|
विशेषता |
Apache Arrow |
Pandas |
|
मेमोरी फ़ॉर्मेट |
कॉलमनर, ज़ीरो-कॉपी, टाइटली पैक्ड |
रो-आधारित (आंतरिक रूप से NumPy ऐरेज़ का उपयोग) |
|
स्पीड (फ़िल्टरिंग, I/O) |
SIMD और वेक्टराइज़ेशन के कारण तेज़ |
बड़े डेटा पर धीमा (कॉपीज़, Python लूप्स) |
|
मेमोरी उपयोग |
अधिक कॉम्पैक्ट, कुशल |
Python ओवरहेड के कारण अधिक मेमोरी उपयोग |
|
इंटरऑपरेबिलिटी |
उत्कृष्ट (भाषाओं/टूल्स में साझा) |
मुख्यतः Python-केंद्रित |
|
उपयोग-केस फ़िट |
बड़े, विश्लेषणात्मक वर्कलोड्स के लिए अनुकूलित |
छोटे/मध्यम डेटा और प्रोटोटाइपिंग के लिए बढ़िया |
|
सीरियलाइज़ेशन |
Feather/Parquet के साथ ज़ीरो-कॉपी सपोर्ट |
CSV/Excel, अक्सर धीमे और भारी |
जैसा कि हमने देखा, Arrow Tables pandas के साथ अच्छी तरह इंटीग्रेट होते हैं, खासकर जब जोइन्स करते हैं। इस course में pandas के साथ डेटा जॉइनिंग के बारे में और जानें।
Arrow अन्य डेटा टूल्स के साथ अच्छी तरह काम कर सकता है, जिससे अलग-अलग एनवायरनमेंट्स के बीच डेटा को उसकी स्पीड या स्ट्रक्चर खोए बिना ले जाना आसान हो जाता है।
Apache Arrow में Table pandas के DataFrame के समान है—दोनों में समान लंबाई के नामित कॉलम्स होते हैं। लेकिन Arrow Tables आगे बढ़ती हैं। वे nested कॉलम्स को सपोर्ट करती हैं ताकि आप pandas की तुलना में अधिक जटिल डेटा स्ट्रक्चर्स प्रस्तुत कर सकें।
यह कहा जाए तो, सभी कन्वर्ज़न निर्बाध नहीं होते। फिर भी, Arrow और pandas के बीच कन्वर्ज़न सरल है। ऐसे करें:
Arrow Table → pandas DataFrame
table.to_pandas()pandas DataFrame → Arrow Table
pa.Table.from_pandas(df)और बस! एक लाइन कोड ही काफी है।
आप pandas की अन्य संरचनाओं जैसे Series के साथ भी Arrow का उपयोग कर सकते हैं। अधिक जानने के लिए डॉक्स देखें। साथ ही, Arrow और pandas दोनों परफ़ॉर्मेंस-उन्मुख डिज़ाइन से लाभान्वित होते हैं—pandas के साथ कुशल कोड लिखने पर इस कोर्स में और जानें।
Apache Arrow, JVM (Java Virtual Machine) और Python के बीच डेटा एक्सचेंज को तेज़ करने के लिए Spark में बिल्ट-इन है। यह pandas और NumPy उपयोगकर्ताओं के लिए काफ़ी मददगार है। यह डिफ़ॉल्ट रूप से सक्षम नहीं होता, इसलिए इसे चालू करने के लिए कुछ सेटिंग्स बदलनी पड़ सकती हैं। लेकिन एक बार चलने पर, Arrow कई तरीकों से परफ़ॉर्मेंस सुधारता है:
शुरू करने के लिए, आधिकारिक PySpark with Arrow गाइड का पालन करें।
Arrow, TensorFlow जैसी मशीन लर्निंग लाइब्रेरीज़ के साथ भी अच्छी तरह काम करता है।
इसका कॉलमनर फ़ॉर्मेट तेज़ डेटा लोडिंग और प्री-प्रोसेसिंग सक्षम करता है—जो मशीन लर्निंग मॉडल ट्रेनिंग के लिए प्रमुख चरण हैं। और बड़े डेटासेट्स को कुशलता से संभालकर, Arrow स्केलेबल ML पाइपलाइन्स बनाने में मदद करता है जो तेज़ ट्रेन होती हैं और अलग-अलग टूल्स में बेहतर काम करती हैं।
बस इतना ही! हमने Apache Arrow के मुख्य विचारों को देखा, यह पारंपरिक डेटा फ़ॉर्मेट्स से कैसे अलग है, इसे कैसे सेटअप करें, और Python में इसके साथ कैसे काम करें।
हमने Arrow Arrays और Tables बनाने के हाथों-हाथ उदाहरण भी देखे और जाना कि Arrow धीमे सीरियलाइज़ेशन को स्किप करके डेटा प्रोसेसिंग को तेज़ और कुशल बनाए रखने में कैसे मदद करता है।
यदि आप और सीखने और जो कवर किया है उस पर आगे बनाने के इच्छुक हैं, तो आगे जाने के लिए कुछ बेहतरीन संसाधन यहाँ हैं:
आप आगे जहाँ भी जाएँ, हमें उम्मीद है Arrow आपको और साफ़-सुथरे और अधिक स्केलेबल वर्कफ़्लोज़ बनाने में मदद करेगा!
इन कोर्सेज़ के साथ डेटा इंजीनियरिंग के बारे में और जानें!
कोर्स
लर्निंग पाथ
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें