

Apache Arrow ile Veri Serileştirme
Serileştirme, karmaşık nesneleri veya veri yapılarını saklamak ya da sistemler arasında göndermek için bayt akışına dönüştürme işlemidir. Ancak Apache Arrow farklı bir yaklaşım benimser.
Arrow hız için tasarlanmış sütunlu bir bellek formatı kullandığından geleneksel serileştirmeden kaçınır. Bunun yerine, bir paylaşımlı bellek modeline dayanır; burada birden çok süreç, veriye kopyalama veya dönüştürme olmadan doğrudan erişebilir.
Şunları sağlar:
- Veri kopyalamadan kaynaklı ek yükü azaltır
- Veriyi yerinde paylaşarak bellek kullanımını düşürür
- Sistemler ve diller arasında veri alışverişini basitleştirir
Arrow verisini kaydetme ve yükleme
Feather dosya formatını kullanarak Arrow verisini nasıl kaydedip Python ile tekrar bir Tabloya yükleyebileceğinize bakalım.
Arrow Tablosunu bir Feather Dosyasına Kaydetme
import pandas as pd
import pyarrow as pa
import pyarrow.feather as feather
# Create a sample pandas DataFrame
df = pd.DataFrame({
'id': [1, 2, 3],
'name': ['Alice', 'Bob', 'Charlie'],
'score': [95.5, 82.0, 77.5]
})
# Convert DataFrame to Arrow Table
table = pa.Table.from_pandas(df)
# Save Arrow Table to a Feather file
feather.write_feather(table, 'example.feather')
print("Arrow table saved to 'example.feather'")
DataFrame’den Arrow Tablosuna dönüştürme. Görsel: yazar.
Bir Feather Dosyasından Arrow Tablosu Yükleme
Ardından, daha önce oluşturduğumuz Feather dosyasından bir Arrow Tablosu yükleyebiliriz.
import pyarrow.feather as feather
# Load the Feather file into an Arrow Table
loaded_table = feather.read_table('example.feather')
# (Optional) Convert back to pandas DataFrame
df_loaded = loaded_table.to_pandas()
# Print the loaded data
print(df_loaded)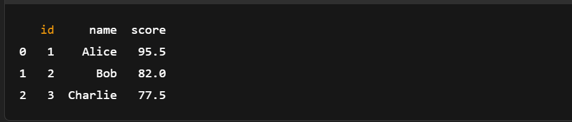
Bir Feather dosyasından Arrow Tablosu yükleme. Görsel: yazar.
Gördüğünüz gibi, elle serileştirmeye gerek yok. Arrow verisini kaydetmek ve yüklemek sadece birkaç satır kod gerektirir.
pandas’a yeniyseniz veya kısa bir hatırlatmaya ihtiyacınız varsa, bu pandas cheat sheet, hızlı veri işlemleri için Arrow’a harika bir eşlikçidir.
Apache Arrow’u Daha Büyük Veri Kümeleriyle Kullanma
Büyük bir veri kümesini yüklerken, filtrelerken ve analiz ederken Arrow’un ne kadar hızlı ve etkili olabileceğine dair gerçek bir örneğe bakalım.
Büyük bir veri kümesini Arrow’a yükleme
Bir milyon satırlı bir pandas DataFrame oluşturarak başlayacağız.
Adım 1: Büyük bir DataFrame oluşturma
import pandas as pd
import pyarrow as pa
import pyarrow.compute as pc
import time
df = pd.DataFrame({
'id': range(1, 1_000_001), #assuming a dataset with a million rows
'value': pd.np.random.randint(1, 1000, size=1_000_000),
'category': pd.np.random.choice(['A', 'B', 'C'], size=1_000_000)
})Adım 2: Arrow Tablosuna dönüştürme
start = time.time()
arrow_table = pa.Table.from_pandas(df)
end = time.time()
print(f"Conversion to Arrow Table took {end - start:.4f} seconds")Adım 3: Arrow’un Compute API’ı ile filtreleme
# Example: Filter rows where 'value' > 990
start = time.time()
filtered_table = pc.filter(arrow_table, pc.greater(arrow_table['value'], pa.scalar(990)))
end = time.time()
# Result summary
print(f"Filtering took {end - start:.4f} seconds")
print(f"Filtered row count: {filtered_table.num_rows}")Adım 4: pandas’a geri dönüştürme (sıfır kopya)
start = time.time()
filtered_df = filtered_table.to_pandas()
end = time.time()
print(f"Conversion to pandas DataFrame took {end - start:.4f} seconds")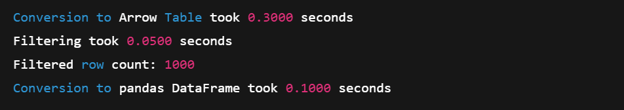
Büyük bir veri kümesini bir Array’e yükleme. Görsel: yazar.
Arrow’un sütunlu formatı ve SIMD destekli hesaplama işlevleri, onu büyük ölçekli bellek içi işlemler için mükemmel bir seçim yapar. Ve sıfır kopya dönüşüm sayesinde pandas’a geri dönmek hızlı ve verimlidir.
Arrow dönüşümünden önce veri yüklediğiniz iş akışları için, pandas ile veri alımını sadeleştirme kursu, pipeline’ınızı optimize edebilir.
Temel analitik işlemler
Arrow’un compute API’ını kullanarak temel analitik işlemler de yapabilirsiniz. İşte daha küçük bir örnek veri kümesiyle hızlı bir demo.
import pyarrow as pa
import pyarrow.compute as pc
# Sample data
data = {
'id': pa.array([1, 2, 3, 4, 5]),
'score': pa.array([85, 92, 76, 88, 95]),
'category': pa.array(['A', 'B', 'A', 'B', 'A'])
}
# Create Arrow Table
table = pa.table(data)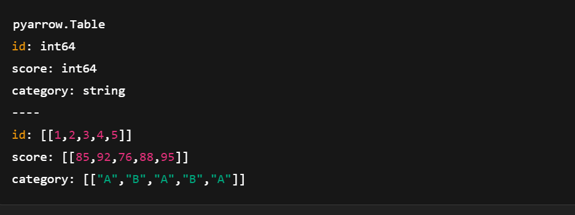
pyarrow.compute kullanarak bir Arrow Tablosu oluşturma. Görsel: yazar.
Örnek 1: score > 90 olan satırları filtreleme
# Filter rows where score > 90
filter_mask = pc.greater(table['score'], pa.scalar(90))
filtered_table = pc.filter(table, filter_mask)
print(filtered_table.to_pandas())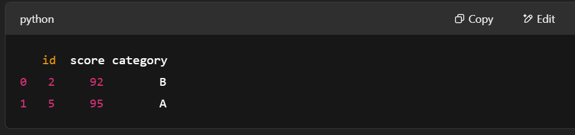
pyarrow.compute kullanarak satırları filtreleme. Görsel: yazar.
Örnek 2: Ortalama score hesaplama
# Compute mean of the "score" column
mean_result = pc.mean(table['score'])
print("Mean score:", mean_result.as_py())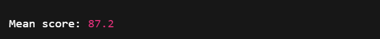
pyarrow.compute kullanarak Ortalama score hesaplama. Görsel: yazar.
Örnek 3: Kategoriye göre gruplayıp ortalama score hesaplama
import pandas as pd
# Convert to pandas for more complex grouping
df = table.to_pandas()
grouped = df.groupby('category')['score'].mean()
print(grouped)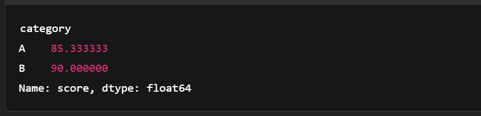
Arrow Tablosunu gruplama. Görsel: yazar.
pandas performansıyla karşılaştırma
İşte Apache Arrow ile pandas’ın hızlı bir karşılaştırması. Bu, büyük ölçekli analitik iş yüklerinde Arrow’un nerede öne çıktığını gösterir.
|
Özellik |
Apache Arrow |
Pandas |
|
Bellek Formatı |
Sütunlu, sıfır kopya, sıkı paketlenmiş |
Satır tabanlı (içsel olarak NumPy dizileri kullanır) |
|
Hız (Filtreleme, G/Ç) |
SIMD ve vektörleştirme sayesinde daha hızlı |
Büyük veride daha yavaş (kopyalar, Python döngüleri) |
|
Bellek Kullanımı |
Daha derli, verimli |
Python ek yükü nedeniyle daha yüksek bellek kullanımı |
|
Birlikte Çalışabilirlik |
Mükemmel (diller/araçlar arasında paylaşımlı) |
Çoğunlukla Python merkezli |
|
Kullanım Durumu Uygunluğu |
Büyük, analitik iş yükleri için optimize edilmiş |
Küçük/orta veri ve prototipleme için harika |
|
Serileştirme |
Sıfır kopya desteğiyle Feather/Parquet |
CSV/Excel, genellikle daha yavaş ve hacimli |
Gördüğümüz üzere, Arrow Tabloları pandas ile iyi bütünleşir; özellikle join işlemleri yaparken. Bu konuda pandas ile verileri birleştirme kursunu inceleyin.
Apache Arrow’u Diğer Veri Araçlarıyla Entegre Etme
Arrow, diğer veri araçlarıyla iyi çalışabilir; bu da veriyi hızdan veya yapıdan ödün vermeden ortamlar arasında taşımayı kolaylaştırır.
Arrow’u pandas ile kullanma
Apache Arrow’da Table, pandas DataFrame’ine benzer; ikisi de eşit uzunlukta adlandırılmış sütunlar kullanır. Ancak Arrow Tabloları daha da ileri gider. İç içe sütunları destekler; böylece pandas’tan daha karmaşık veri yapılarını temsil edebilirsiniz.
Bununla birlikte, tüm dönüşümler sorunsuz değildir. Yine de Arrow ile pandas arasında dönüştürmek basittir. İşte nasıl:
Arrow Table → pandas DataFrame
table.to_pandas()pandas DataFrame → Arrow Table
pa.Table.from_pandas(df)Ve bu kadar! Sadece bir satır kod yeterli.
Ayrıca Arrow ile pandas’ın Series gibi diğer yapılarıyla da çalışabilirsiniz. Daha fazlası için dokümanlara göz atın. Her iki araç da performans odaklı tasarımdan faydalanır—pandas ile verimli kod yazma kursunda daha fazlasını öğrenin.
Apache Spark ile çalışma
Apache Arrow, JVM (Java Virtual Machine) ile Python arasındaki veri alışverişini hızlandırmak için Spark’a yerleşik olarak gelir. Bu, pandas ve NumPy kullanıcıları için oldukça faydalıdır. Varsayılan olarak etkin değildir; dolayısıyla açmak için bazı ayarları değiştirmeniz gerekebilir. Ancak çalışır hâle geldiğinde Arrow performansı çeşitli şekillerde artırır:
- Sütunlu format: Belleği daha verimli kullanır ve vektörleştirilmiş işlemleri destekler.
- Sıfır kopya veri alışverişi: Tüm sütunlar Spark ile pandas arasında doğrudan paylaşılır; veri çoğaltması yoktur.
- Daha düşük serileştirme yükü: Arrow olmadan, Spark DataFrame’lerini pandas’a dönüştürmek yavaş JVM-Python serileştirmesi içerir. Arrow bu adımı atlar.
- Paralel işleme: Arrow, verileri parçalar hâlinde işlemeyi destekler; bu da Spark’ın dağıtık sistemiyle mükemmel uyum sağlar.
Başlamak için resmi PySpark ve Arrow kılavuzunu izleyin.
Makine öğrenmesi kütüphaneleriyle birlikte çalışabilirlik
Arrow, TensorFlow gibi makine öğrenmesi kütüphaneleriyle de iyi çalışır.
Sütunlu formatı, makine öğrenmesi modellerini eğitmenin kilit adımları olan veri yükleme ve ön işlemeyi hızlandırır. Büyük veri kümelerini verimli şekilde ele alarak Arrow, farklı araçlarda daha hızlı eğitilen ve daha iyi çalışan ölçeklenebilir ML boru hatları kurmaya yardımcı olur.
Sonuç
Ve tamam! Apache Arrow’un temel fikirlerini ele aldık; onu daha geleneksel veri formatlarından ayıran noktaları, nasıl kurulacağını ve Python’da nasıl kullanılacağını gördük.
Ayrıca Arrow Array ve Tablo oluşturmak için uygulamalı örnekler inceledik ve Arrow’un yavaş serileştirmeyi atlatarak veri işlemeyi nasıl hızlı ve verimli tuttuğunu gördük.
Öğrenmeye devam etmek ve öğrendiklerimizin üzerine koymak istiyorsanız, sıradaki adımlar için harika kaynaklar:
- Introduction to Apache Kafka kursu – Gerçek zamanlı veri boru hatları kurmayı öğrenin.
- Introduction to Databricks kursu – Büyük ölçekli veri analitiğini uygulamalı olarak öğrenin.
Sırada nereye giderseniz gidin, Arrow’un daha temiz ve daha ölçeklenebilir iş akışları kurmanıza yardımcı olmasını umuyoruz!
SSS
Arrow ile Parquet arasındaki fark nedir?
Parquet, maksimum alan verimliliği için tasarlanmış bir depolama formatıdır; Arrow ise vektörleştirilmiş hesaplama çekirdekleri tarafından işlemeye yönelik bellek içi bir formattır.
Arrow, Protobuf ile nasıl ilişkilidir?
Google’ın protocol buffers kütüphanesi (Protobuf) bir “çalışma zamanı bellek içi formatı” değildir. Parquet gibi Protobuf’un temsili de işlemeye uygun değildir. İşlemek için verinin Arrow gibi bellek içi bir temsile serisi çözülmelidir.
Arrow, Flatbuffers ile nasıl ilişkilidir?
Arrow dosya formatı, Arrow ikili IPC protokolünü uygulamak için gereken şemaları ve diğer üstverileri serileştirmek üzere kaputun altında Flatbuffers kullanır; ancak Arrow veri formatı, en iyi erişim ve hesaplama için kendi temsilini kullanır.
Apache Arrow ücretsiz mi?
Evet, ücretsiz kullanabilirsiniz.
Apache Arrow gerçek zamanlı veri boru hatlarında kullanılabilir mi?
Evet, Apache Arrow gerçek zamanlı uygulamalar için oldukça uygundur. Sıfır kopya özellikleri ve paylaşımlı bellek modeli gecikmeyi azaltır; özellikle Apache Kafka veya Spark gibi araçlarla birlikte kullanıldığında.
Apache Arrow, Parquet ve Feather dosya formatlarıyla nasıl etkileşir?
Arrow bellek içidir; Parquet ve Feather ise disk üzerinde depolama formatlarıdır. Ancak Feather ve Parquet, Arrow ile uyumludur; bu da veriyi bellekten diske minimum ek yükle serileştirmeyi kolaylaştırır.
Apache Arrow, tüm veri işlemleri için pandas’tan daha mı iyi?
Her zaman değil. Arrow, hızlı, sütunlu, bellek içi işlem ve birlikte çalışabilirlikte öne çıkar; ancak pandas, karmaşık veri düzenleme için daha zengin özelliklere sahiptir. Performans ve diller arası paylaşım kritikse Arrow’u tercih edin.
Arrow Array’lerle NumPy dizileri arasındaki fark nedir?
Arrow Array’ler; null işleme gibi ek üstverileri destekler, değiştirilemezdir ve diller arası birlikte çalışabilirlik için tasarlanmıştır. NumPy dizileri ise değiştirilebilirdir ve Python merkezlidir.
Apache Arrow iç içe veya karmaşık veri türlerini destekler mi?
Evet. Arrow; listeler, yapılar (struct) ve birlikler (union) gibi iç içe türleri destekler; bu da analitik ve ML boru hatlarında yaygın olan karmaşık hiyerarşik veri yapılarını mümkün kılar.

Karmaşık konuları basitleştirmeyi seven bir içerik stratejistiyim. Splunk, Hackernoon ve Tiiny Host gibi şirketlerin hedef kitleleri için ilgi çekici ve bilgilendirici içerikler üretmelerine yardımcı oldum.





Apache Arrow, farklı araçların ve sistemlerin verileri hızlı ve kolay bir şekilde paylaşmasına yardımcı olur. Verileri bellek içinde kalan özel bir sütun tabanlı formatta saklar; bu da onunla çalışmayı gerçekten çok hızlı hale getirir.
Bu eğitimde, Apache Arrow’un temellerini adım adım anlatacağım. Nasıl çalıştığını ve projelerinizde nasıl kullanabileceğinizi anlamanız için uygulamalı örnekler göreceksiniz.
Apache Arrow nedir?
Apache Arrow işin yüksek performanslı bellek içi veri işleme için açık kaynaklı, çok dilli bir platform olduğu söylenebilir. Modern CPU’lar için optimize edilmiş standartlaştırılmış bir sütunlu bellek formatı tanımlar ve verimli analitik ile vektörleştirilmiş hesaplamayı mümkün kılar.
Arrow ayrıca sistemler ve diller arasında serileştirme ihtiyacını ortadan kaldırır; bu da sıfır kopya okumalara imkân verir ve işleme yükünü azaltır.
pandas, Apache Spark ve Dask gibi araçlarla iyi çalıştığı için verileri minimum çabayla taşıyabilirsiniz. Bu da çok fazla veriyi işlemesi gereken hızlı ve esnek sistemler kuran herkes için onu mükemmel bir seçenek yapar.
Şimdi, birkaç pratik örnekle Arrow’u keşfedelim!
Apache Arrow’u yükleme
Apache Arrow; C, C++, C#, Python, Rust, Java, JavaScript, Julia, Go, Ruby ve R dahil olmak üzere birden fazla dili destekler.
Windows, macOS ve Debian, Ubuntu, CentOS ile Red Hat Enterprise Linux gibi popüler Linux dağıtımlarında çalışır.
Bu rehberde onu Python ile kullanacağız.
Adım adım kurulum rehberi
PyPI’de yayımlanan resmi ikili paketleri kullanarak Python için Apache Arrow nasıl kurulur, bakalım. Bu adımlar Windows, macOS ve Linux’ta aynıdır.
Adım 1: Python kurulu mu, kontrol edin
Terminalinizi açın ve şunu çalıştırın:
Bu komut bir sürüm numarası döndürürse hazırsınız demektir. Aksi halde Python’u resmi siteden yükleyin.
Adım 2: pip ile
pyarrowyükleyinPython için Apache Arrow’u yüklemek üzere şunu çalıştırın:
*, 19.0 serisinin en güncel yama sürümünü almanızı sağlar.requirements.txtdosyanızda dapyarrow==19.0.*kullanmanızı öneririm; böylece ortamlar arasında tutarlılık sağlanır. Bu işlem, tekerlek dosyasına dâhil edilen gerekli Apache Arrow ve Parquet C++ ikili kitaplıklarıyla birliktepyarrow’u yükler.Arrow’u başka bir dil için kurmak isterseniz tam dokümantasyona göz atın.
Kurulumu test etme
Her şeyin çalıştığını kontrol etmek için bu kısa Python parçacığını çalıştırabilirsiniz:
pyarrowdoğru şekilde kurulmuşsa, dizinin terminalinizde yazdırıldığını görürsünüz. Aksi durumda kod bir hata fırlatır.Apache Arrow Temelleri
Koda daha derine inmeden önce Apache Arrow’un nasıl yapılandığını anlayalım.
Sütunlu bellek formatını anlama
Bellek içi sütunlu format, Apache Arrow’un en önemli özelliklerinden biridir. Dilden bağımsız, bellek içi bir veri yapısı tanımlar. Ek olarak, üstveri serileştirmeyi, veri taşımaya yönelik bir protokolü ve sistemler arasında veriyi temsil etmenin standart bir yolunu içerir.
Sütunlu formatta veriler, geleneksel satır tabanlı depolamadan farklı olarak satırlar yerine sütunlarda saklanır. Sütunlu yerleşimler, çok daha hızlı tarandıkları ve işlendiği için analitik iş yüklerinde popülerdir.
Aşağıdaki görsel formatı açıklar:
Sütunlu format. Kaynak: Apache Arrow dokümanları
Apache Arrow’un formatı, sütunları bitişik bellek bloklarına yerleştirerek verimliliği artırır. Bu, veriyi hızlandıran modern vektörleştirilmiş (SIMD) işlemleri destekler.
Standart bir sütunlu yerleşim kullanarak Arrow, her sistemin kendi iç veri formatını tanımlama ihtiyacını ortadan kaldırır. Bu da serileştirme yükünü ve yinelenen çabayı azaltır.
Sistemler veriyi daha kolay paylaşabilir ve geliştiriciler farklı dillerde algoritmaları yeniden kullanabilir.
Arrow gibi paylaşılan bir format olmadan, her veritabanı veya araç veriyi aktarmadan önce serileştirmek ve serisini çözmek zorundadır. Bu da maliyet ve karmaşıklık katar. Ayrıca ortak algoritmalar, her sistemin iç veri yapısına göre yeniden yazılmak zorundadır.
Arrow bunu, verinin bellek içinde nasıl temsil edildiğini standartlaştırarak değiştirir.
Sütunlu formatlar analitik performans ve bellek yakınsaması için harika olsa da sık güncellemeler için tasarlanmamıştır.
Bunun nedeni, sütunlu depolamanın değiştirmekten ziyade hızlı okumaya optimize edilmiş olmasıdır. Veride değişiklik yapmak genellikle bellek kopyalama veya yeniden ayırma gerektirir; bu da yavaş ve kaynak yoğun olabilir.
Arrow, verinin bellek içi temsiline ve serileştirmeye odaklanır. Kullanım senaryonuz sık veri mutasyonu gerektiriyorsa, bunu uygulama seviyesinde ele almanız gerekir.
Arrow ile uyumlu formatlara daha derinlemesine dalmak için, sütun tabanlı veri depolama için ideal olan Apache Parquet rehberine göz atın.
Arrow veri yapıları
Apache Arrow iki temel veri yapısı sunar:
ArrayveTable:Array, tek bir veri sütununu temsil eder. Değerlere bitişik bir bellek bloğunda yer verir; bu da hızlı erişim, verimli tarama ve SIMD gibi işlemci düzeyi optimizasyonlara destek sağlar. Her dizi ayrıca null göstergeleri (bitmapler) ve veri tipi bilgisi gibi üstveriler taşıyabilir.Arrow Tableiki boyutlu bir veri kümesini temsil eder. Her sütun parçalara ayrılmış bir dizidir ve tüm sütunlar alan adlarını ve türlerini tanımlayan ortak bir şemayı izler. Parçalar sütunlar arasında farklı olabilir; ancak satırların tutarlı kalması için toplam eleman sayısı hizalı olmalıdır.Bunu pandas veya R’deki bir DataFrame gibi düşünebilirsiniz. Tablo yapısındadır, verimlidir ve birden çok sütunda eşzamanlı işlemleri destekler.
Temel veri yapıları örneği
Python’da bir Arrow
ArrayveTableoluşturmanın birkaç örneğine bakalım.Aşağıdaki kodu çalıştırmadan önce önceki talimatları izleyerek
pyarrowyüklü olduğundan emin olun.Bir Arrow Array oluşturma
Bir Arrow Array yazdırma. Görsel: yazar.
Bir Arrow Table oluşturma
Bir Arrow Tablosu yazdırma. Görsel: yazar.
Apache Arrow Array’lerle çalışma
Arrow Array’lerle nasıl çalışılacağını ve dilimleme, filtreleme, üstveri kontrolü gibi yaygın işlemleri nasıl yapacağınızı görelim.
Arrow Array oluşturma
Arrow Array’ler; string, kayan noktalı sayılar ve tamsayılar dâhil farklı veri türleriyle çalışır. İşte nasıl oluşturacağınız:
Farklı veri türlerinde Arrow Array’leri yazdırma. Görsel: yazar.
Arrow Array’lerde temel işlemler
Arrow Array’lerle yapabileceğiniz birkaç yaygın işlemi inceleyelim.
Dilimleme
Dilimleme, bir dizinin bir alt bölümünü almanızı sağlar. Örneğin belirli indeks aralıklarındaki öğeleri çıkarabilirsiniz:
Dilimlenmiş bir Arrow Array yazdırma. Görsel: yazar.
Filtreleme ve üstveri
Filtreleme, bir koşulu karşılayan değerleri tutmak için Boole maskesi kullanır. Ayrıca tür, uzunluk ve null sayısı gibi üstverilere de erişebilirsiniz.
Filtrelenmiş bir Arrow Array yazdırma. Görsel: yazar.
Bir Arrow Array’in Üstverisini yazdırma. Görsel: yazar.
Apache Arrow Tablolarını kullanma
Arrow Tablolarını Arrow Array’lerden veya doğrudan sözlükler gibi yerel Python veri yapılarından oluşturabilirsiniz. Nasıl olduğuna bakalım.
Tablo oluşturma ve görüntüleme
Bir Arrow Tablosu oluşturmanın iki yaygın yolu vardır:
pa.table()ile bir Python sözlüğü kullanmakHer iki yöntemi de sırayla inceleyelim.
1. Arrow Array kullanma
Yukarıdaki kodda:
pa.table()ile bir Tabloya birleştiriyoruzBirden fazla Arrow Array kullanarak bir Arrow Tablosu oluşturma. Görsel: yazar.
2. Bir Python sözlüğü kullanma
Şimdi, bir Python sözlüğünden nasıl Tablo oluşturulacağını görelim.
Bu yöntem daha kısa ve derlidir. Dizileri elle tanımlamak zorunda değiliz; Arrow bunu bizim için halleder.
Doğrudan Python sözlüklerinden bir Arrow Tablosu oluşturma. Görsel: yazar.
Arrow Tabloları ile pandas DataFrame’ler arasında dönüştürme
Arrow’un en büyük güçlü yönlerinden biri birlikte çalışabilirliğidir. Bir Arrow Tablosu ile bir pandas DataFrame arasında kolayca geçiş yapabilirsiniz. Nasıl yapıldığına bakalım:
Bir Arrow Tablosunu Pandas DataFrame’e dönüştürme
Bir Arrow Tablosunu Pandas DataFrame’e dönüştürme. Görsel: yazar.
Bir Pandas DataFrame’i Arrow Tablosuna dönüştürme
Şimdi de tersini nasıl yapacağımıza bakalım:
pandas DataFrame’den Arrow Tablosuna dönüştürme. Görsel: yazar.