

课程
使用 pandas 进行数据处理
4 小时
567.5K
实践并学习路径你的进步。
使用 Google 继续Apache Arrow 可帮助不同的工具和系统快速、轻松地共享数据。它将数据存储在一种特殊的基于列的内存格式中,使处理速度非常快。
在本教程中,我将带您了解 Apache Arrow 的基础知识。您将通过动手示例了解它的工作原理,以及如何在项目中使用它。
Apache Arrow 是一个开源、跨语言的高性能内存数据处理平台。它定义了一种标准化的列式内存格式,针对现代 CPU 进行了优化,从而实现高效分析与向量化计算。
Arrow 还消除了系统与语言间的序列化需求,从而实现零拷贝读取,降低处理开销。
由于它与 pandas、Apache Spark 和 Dask 等工具配合良好,您可以以最小的代价在它们之间移动数据。这使其成为构建快速、灵活且需要处理海量数据的系统的理想选择。
现在,让我们通过一些实用示例来探索 Arrow!
Apache Arrow 支持多种语言,包括 C、C++、C#、Python、Rust、Java、JavaScript、Julia、Go、Ruby 和 R。
它可在 Windows、macOS 和主流 Linux 发行版(如 Debian、Ubuntu、CentOS 和 Red Hat Enterprise Linux)上运行。
本指南将结合 Python 进行演示。
我们来看如何使用 PyPI 上发布的官方二进制轮包为 Python 安装 Apache Arrow。这些步骤在 Windows、macOS 和 Linux 上都相同。
打开终端并运行:
python --version如果返回版本号,说明就绪。否则,请从 官方网站 安装 Python。
pyarrow要为 Python 安装 Apache Arrow,运行:
pip install 'pyarrow==19.0.* ' 其中 * 确保您获得 19.0 系列中的最新补丁版本。
我还建议在 requirements.txt 文件中使用 pyarrow==19.0.*,以在不同环境中保持一致性。此操作将安装 pyarrow,并同时通过 wheel 打包安装所需的 Apache Arrow 和 Parquet C++ 二进制库。
要为其他语言安装 Arrow,请查阅完整文档。
您可以运行以下简短的 Python 代码片段检查一切是否正常:
import pyarrow as pa
# Create a simple Arrow array
data = pa.array([1, 2, 3, 4, 5])
print("Apache Arrow is installed and working!")
print("Arrow Array:", data)
如果 pyarrow 安装正确,您将在终端中看到打印的数组;否则,代码会抛出错误。
在深入代码之前,我们先了解 Apache Arrow 的构建方式。
内存中的列式格式是 Apache Arrow 最重要的特性之一。它定义了一种与语言无关的内存数据结构;此外,还包含元数据序列化、数据传输协议,以及跨系统的标准数据表示方法。
在列式格式中,数据按列而非按行存储,这不同于传统的行式存储。列式布局在分析型工作负载中很受欢迎,因为扫描与处理速度更快。
下图解释了这种格式:
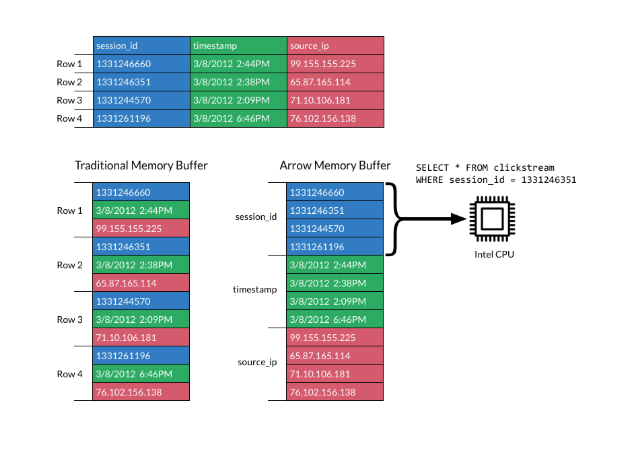
列式格式。来源:Apache Arrow 文档
Apache Arrow 的格式通过将列布局在连续内存块中来提升效率。这支持现代的向量化(SIMD)操作,从而加速数据处理。
使用标准列式布局,Arrow 免去了每个系统自行定义内部数据格式的需要,既降低了序列化开销,也减少了重复劳动。
系统之间更容易共享数据,开发者也能在不同语言间复用算法。
没有像 Arrow 这样的共享格式时,每个数据库或工具在传递数据前都需要进行序列化与反序列化。这会增加成本与复杂度,而且通用算法还得针对每个系统的内部数据结构重写。
Arrow 通过标准化内存中的数据表示方式,改变了这一点。
尽管列式格式在分析性能与内存局部性方面表现出色,但并不适合频繁更新。
原因在于列式存储主要为快速读取优化,而非修改。进行变更往往需要复制或重新分配内存,这既慢又耗费资源。
Arrow 专注于高效的内存表示与序列化。如果您的用例需要频繁的数据变更,则需要在实现层面进行处理。
若要更深入了解与 Arrow 兼容的格式,请参阅这篇关于Apache Parquet 的指南,适用于列式数据存储。
Apache Arrow 提供两个关键数据结构:Array 和 Table:
Array 表示单个数据列。它将值存储在连续的内存块中,支持快速访问、高效扫描以及诸如 SIMD 的处理器级优化。每个数组还可携带诸如空值标记(位图)和数据类型信息等元数据。Arrow Table 即表示一个二维数据集。每一列是一个分块数组,且所有列遵循共享的模式(schema),定义字段名称与类型。尽管各列的分块可以不同,但元素总数必须对齐以保证行一致性。您可以将其类比为 pandas 或 R 中的 DataFrame。它是表格化的、高效的,并支持跨多列同时进行操作。
下面我们看看在 Python 中创建 Arrow Array 和 Table 的几个示例。
在运行以下代码前,请确保已按之前的说明安装 pyarrow。
import pyarrow as pa

# Create an Arrow Array (single column)
data = pa.array([1, 2, 3, 4, 5])
print("Arrow Array:")
print(data)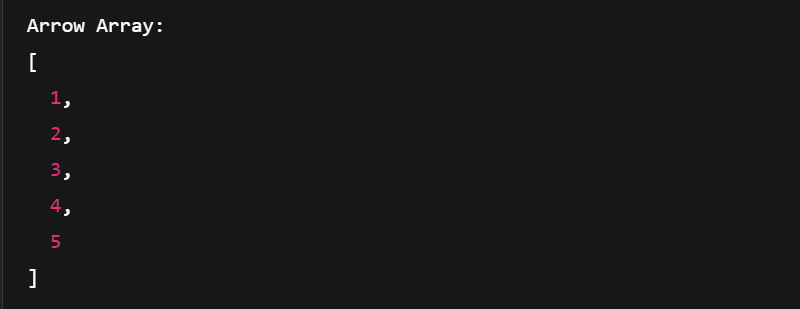
打印 Arrow Array。图源作者。
import pyarrow as pa

# Create an Arrow Table (multiple columns)
table = pa.table({
    'column1': pa.array([1, 2, 3]),
    'column2': pa.array(['a', 'b', 'c'])
})

print("\nArrow Table:")
print(table)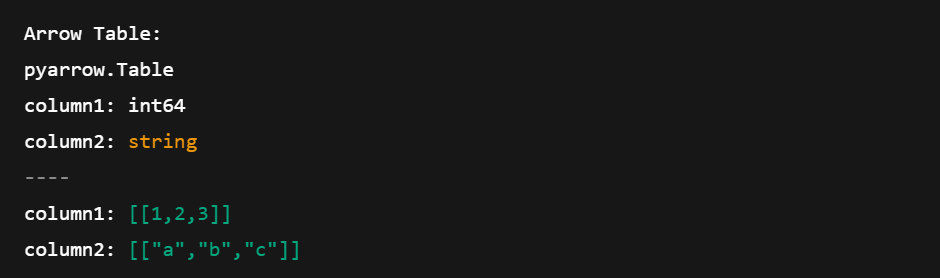
打印 Arrow Table。图源作者。
我们来看看如何使用 Arrow Array 并执行常见操作,如切片、过滤以及查看元数据。
Arrow Array 支持多种数据类型,包括字符串、浮点数和整数。以下是创建方法:
import pyarrow as pa

# Integer Array
int_array = pa.array([10, 20, 30], type=pa.int32())
print("Integer Array:")
print(int_array)

# String Array
string_array = pa.array(["apple", "banana", "cherry"], type=pa.string())
print("\nString Array:")
print(string_array)

# Floating-point Array
float_array = pa.array([1.1, 2.2, 3.3], type=pa.float64())
print("\nFloating-point Array:")
print(float_array)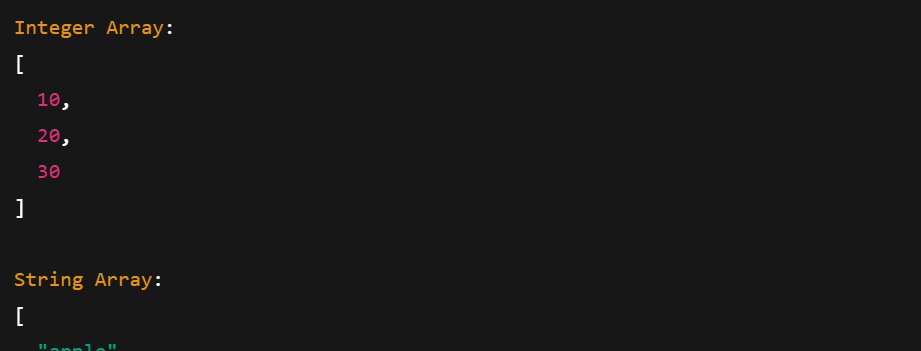
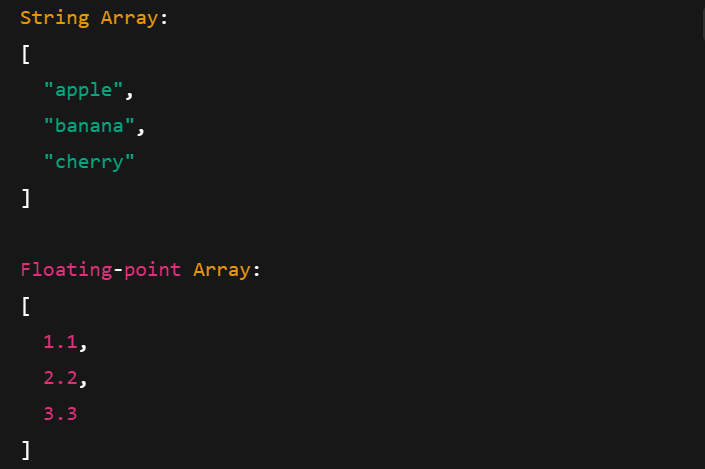
打印不同数据类型的 Arrow Array。图源作者。
我们来看看可在 Arrow Array 上执行的一些常见操作。
切片可获取数组的一个子区间。例如,您可以提取特定索引范围内的元素:
import pyarrow as pa
arr = pa.array([10, 20, 30, 40, 50])
# Slice from index 1 to 4 (3 elements: 20, 30, 40)
sliced = arr.slice(1, 3)
print("Original Array:", arr)
print("Sliced Array (1:4):", sliced)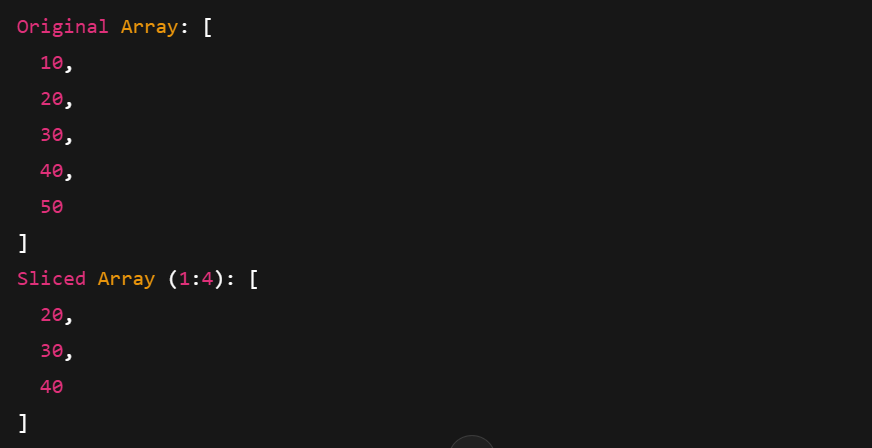
打印切片后的 Arrow Array。图源作者。
过滤使用布尔掩码,仅保留符合条件的值。您还可以访问类型、长度、空值计数等元数据。
import pyarrow.compute as pc

arr = pa.array([10, 20, 30, 40, 50])

# Create a boolean mask: Keep elements > 25
mask = pc.greater(arr, pa.scalar(25))

# Apply the filter
filtered = pc.filter(arr, mask)

print("Filtered Array (values > 25):", filtered)

print("Array Type:", arr.type)
print("Array Length:", len(arr))
print("Null Count:", arr.null_count)
print("Is Null Bitmap Buffers:", arr.buffers())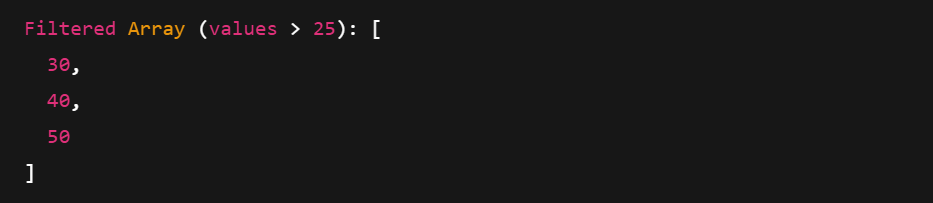
打印过滤后的 Arrow Array。图源作者。
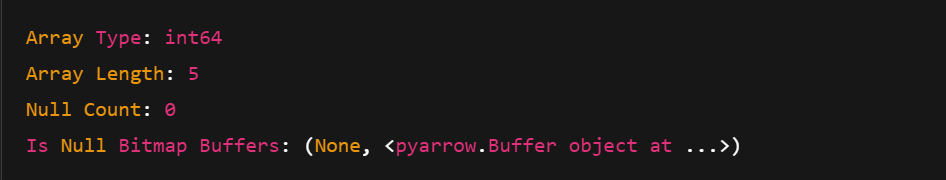
打印 Arrow Array 的元数据。图源作者。
您可以从 Arrow Array 或直接从原生 Python 数据结构(如字典)创建 Arrow Table。我们来看看如何实现。
创建 Arrow Table 的两种常见方式:
pa.table()我们逐一进行演示。
import pyarrow as pa

# Create individual Arrow Arrays
ids = pa.array([1, 2, 3])
names = pa.array(['Alice', 'Bob', 'Charlie'])
scores = pa.array([85.0, 92.5, 78.3])

# Combine them into a Table
table = pa.table({
    'id': ids,
    'name': names,
    'score': scores
})

print("Arrow Table from Arrays:")
print(table)
在上述代码中:
pa.table() 将它们组合成一个 Table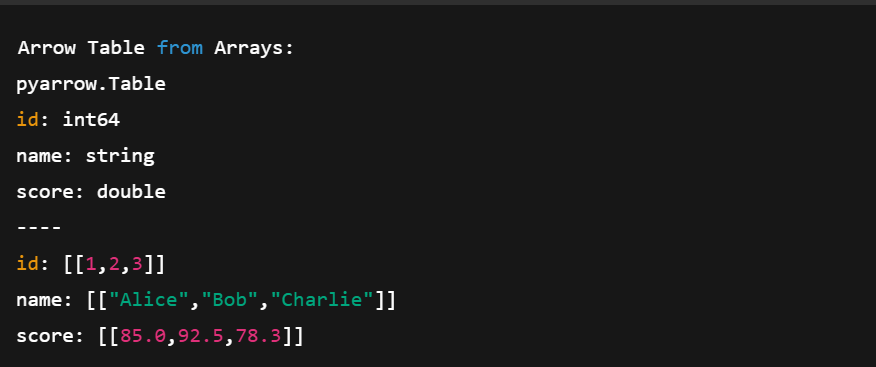
使用多个 Arrow Array 创建 Arrow Table。图源作者。
现在,我们来看如何从 Python 字典创建一个 Table。
# Create a table directly from Python data
data = {
    'id': [4, 5, 6],
    'name': ['Diana', 'Eve', 'Frank'],
    'score': [88.0, 79.5, 91.2]
}

table2 = pa.table(data)

print("\nArrow Table from Dictionary:")
print(table2)
这种方法更简洁。我们无需手动定义数组;Arrow 会替我们处理。
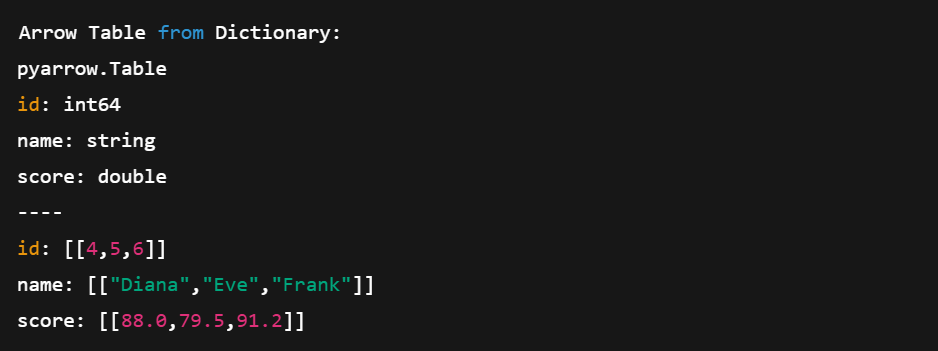
直接从 Python 字典创建 Arrow Table。图源作者。
Arrow 的一大优势在于互操作性。您可以轻松在 Arrow Table 与 pandas DataFrame 之间转换。如下所示:
import pyarrow as pa
import pandas as pd

# Create an Arrow Table
data = {
    'numbers': [1, 2, 3],
    'fruits': ['apple', 'banana', 'cherry'],
    'prices': [1.1, 2.2, 3.3]
}
arrow_table = pa.table(data)

# Convert Arrow Table to pandas DataFrame
df = arrow_table.to_pandas()

# Show the DataFrame
print(df)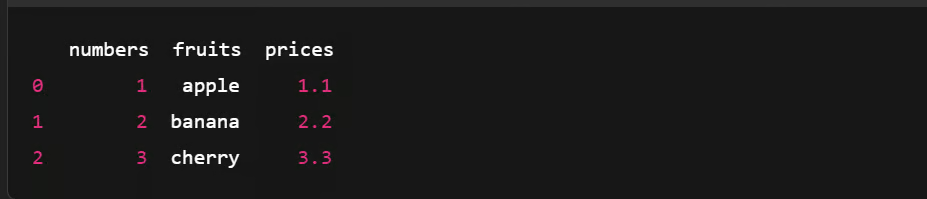
将 Arrow Table 转为 Pandas DataFrame。图源作者。
现在,我们来看反向操作:
import pyarrow as pa
import pandas as pd

# Create a pandas DataFrame
df = pd.DataFrame({
    'numbers': [1, 2, 3],
    'fruits': ['apple', 'banana', 'cherry'],
    'prices': [1.1, 2.2, 3.3]
})

# Convert pandas DataFrame to Arrow Table
arrow_table = pa.Table.from_pandas(df)

# Show the Arrow Table
print(arrow_table)
将 pandas DataFrame 转为 Arrow Table。图源作者。
序列化是将复杂对象或数据结构转换为字节流以在系统之间存储或传输数据的过程。但 Apache Arrow 采用了不同的方法。
由于 Arrow 使用面向速度设计的列式内存格式,它避免了传统序列化。相反,它依赖于共享内存模型,多个进程可以直接访问相同数据而无需拷贝或转换。
其作用如下:
我们来看如何使用 Feather 文件格式保存 Arrow 数据,并在 Python 中将其加载回 Table。
import pandas as pd
import pyarrow as pa
import pyarrow.feather as feather

# Create a sample pandas DataFrame
df = pd.DataFrame({
    'id': [1, 2, 3],
    'name': ['Alice', 'Bob', 'Charlie'],
    'score': [95.5, 82.0, 77.5]
})

# Convert DataFrame to Arrow Table
table = pa.Table.from_pandas(df)
# Save Arrow Table to a Feather file
feather.write_feather(table, 'example.feather')
print("Arrow table saved to 'example.feather'")
将 DataFrame 转为 Arrow Table。图源作者。
接着,我们进行相反操作,从先前创建的 Feather 文件中加载 Arrow Table。
import pyarrow.feather as feather

# Load the Feather file into an Arrow Table
loaded_table = feather.read_table('example.feather')

# (Optional) Convert back to pandas DataFrame
df_loaded = loaded_table.to_pandas()

# Print the loaded data
print(df_loaded)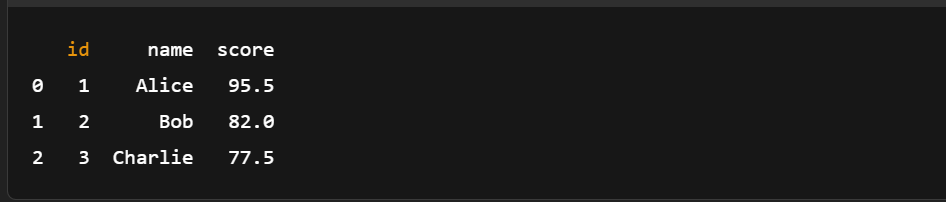
从 Feather 文件加载 Arrow Table。图源作者。
如您所见,无需手动序列化。保存与加载 Arrow 数据只需几行代码。
如果您刚接触 pandas 或需要复习,这份pandas 速查表是与 Arrow 搭配进行快速数据处理的绝佳参考。
我们来看一个真实示例,展示在加载、过滤与分析大型数据集时 Arrow 的速度与效率。
我们先创建一个包含一百万行的 pandas DataFrame。
import pandas as pd
import pyarrow as pa
import pyarrow.compute as pc
import time
df = pd.DataFrame({
    'id': range(1, 1_000_001),  #assuming a dataset with a million rows
    'value': pd.np.random.randint(1, 1000, size=1_000_000),
    'category': pd.np.random.choice(['A', 'B', 'C'], size=1_000_000)
})start = time.time()
arrow_table = pa.Table.from_pandas(df)
end = time.time()
print(f"Conversion to Arrow Table took {end - start:.4f} seconds")# Example: Filter rows where 'value' > 990
start = time.time()
filtered_table = pc.filter(arrow_table, pc.greater(arrow_table['value'], pa.scalar(990)))
end = time.time()
# Result summary
print(f"Filtering took {end - start:.4f} seconds")
print(f"Filtered row count: {filtered_table.num_rows}")start = time.time()
filtered_df = filtered_table.to_pandas()
end = time.time()
print(f"Conversion to pandas DataFrame took {end - start:.4f} seconds")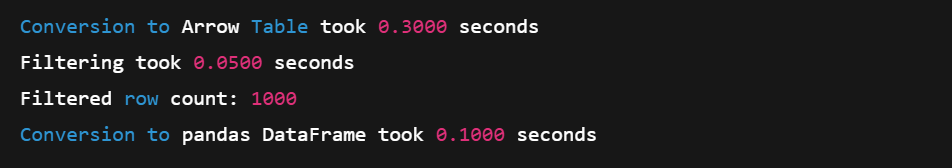
将大型数据集加载到 Array 中。图源作者。
Arrow 的列式格式与基于 SIMD 的计算函数让其在大规模内存操作中表现出色。得益于零拷贝转换,回到 pandas 的过程同样快速高效。
对于在转换为 Arrow 之前需要先加载数据的工作流,这门关于使用 pandas 精简数据摄取的课程可优化您的管道。
您还可以使用 Arrow 的计算 API 进行基础分析。下面用一个较小的示例数据集进行快速演示。
import pyarrow as pa
import pyarrow.compute as pc
# Sample data
data = {
    'id': pa.array([1, 2, 3, 4, 5]),
     'score': pa.array([85, 92, 76, 88, 95]),
    'category': pa.array(['A', 'B', 'A', 'B', 'A'])
}
# Create Arrow Table
table = pa.table(data)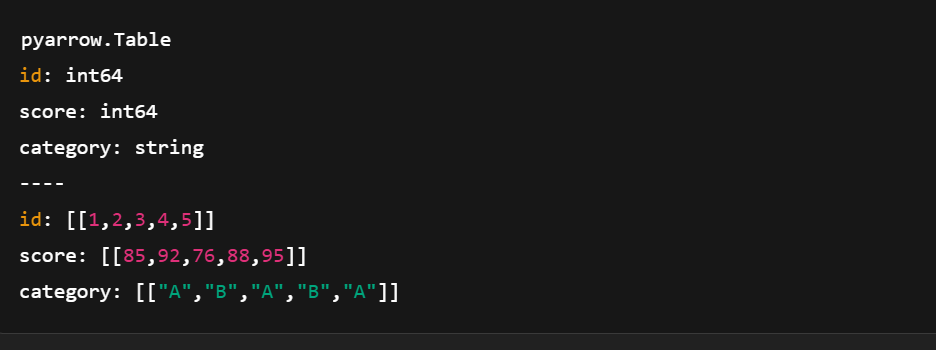
使用 pyarrow.compute 创建 Arrow Table。图源作者。
# Filter rows where score > 90
filter_mask = pc.greater(table['score'], pa.scalar(90))
filtered_table = pc.filter(table, filter_mask)

print(filtered_table.to_pandas())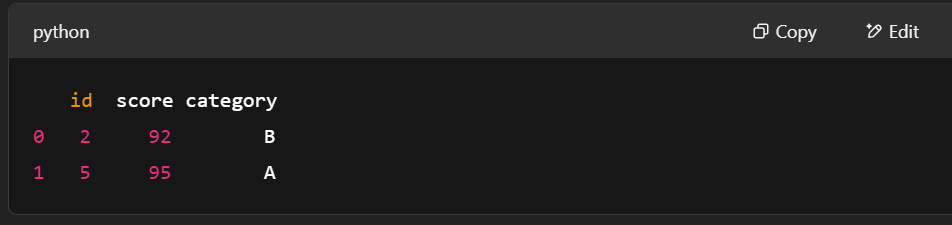
使用 pyarrow.compute 进行行过滤。图源作者。
# Compute mean of the "score" column
mean_result = pc.mean(table['score'])
print("Mean score:", mean_result.as_py())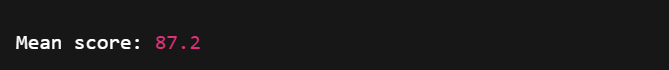
使用 pyarrow.compute 计算平均分。图源作者。
import pandas as pd

# Convert to pandas for more complex grouping
df = table.to_pandas()
grouped = df.groupby('category')['score'].mean()
print(grouped)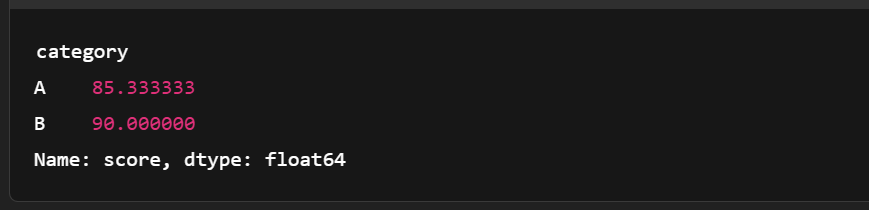
对 Arrow Table 进行分组。图源作者。
下面是 Apache Arrow 与 pandas 的简要对比,展示了在大规模分析型工作负载中Arrow 的优势所在。
|
特性 |
Apache Arrow |
Pandas |
|
内存格式 |
列式、零拷贝、紧凑 |
行式(内部使用 NumPy 数组) |
|
速度(过滤、I/O) |
借助 SIMD 与向量化更快 |
在大数据上较慢(拷贝、Python 循环) |
|
内存占用 |
更紧凑、更高效 |
由于 Python 开销更高 |
|
互操作性 |
优秀(可在多语言/工具间共享) |
主要面向 Python |
|
适用场景 |
为大型分析型工作负载优化 |
适合小/中型数据与原型开发 |
|
序列化 |
Feather/Parquet,支持零拷贝 |
CSV/Excel,通常更慢且更臃肿 |
如上所示,Arrow Table 与 pandas 集成良好,尤其是在执行连接操作时。想了解更多,请查看这门关于pandas 数据连接的课程。
Arrow 能与其他数据工具良好协作,便于在不同环境间移动数据而不损失速度或结构。
在 Apache Arrow 中,Table 与 pandas 的 DataFrame 类似,均由等长的命名列组成。但 Arrow Table 更进一步,支持嵌套列,能够表示比 pandas 更复杂的数据结构。
需要说明的是,并非所有转换都能无缝进行。不过,在 Arrow 与 pandas 之间转换非常简单。方法如下:
Arrow Table → pandas DataFrame
table.to_pandas()pandas DataFrame → Arrow Table
pa.Table.from_pandas(df)就这样!仅需一行代码即可完成。
您还可以使用 Arrow 处理 pandas 的其他结构(如 Series)。请查看文档了解更多。此外,Arrow 与 pandas 都受益于面向性能的设计——想进一步了解,请参阅这门编写高效 pandas 代码的课程。
Apache Arrow 已集成到 Spark 中,用于加速 JVM(Java 虚拟机)与 Python 之间的数据交换。这对 pandas 与 NumPy 用户非常有帮助。它默认未启用,您可能需要调整一些设置来开启。一旦启用,Arrow 将在多方面提升性能:
要开始,请参阅官方 PySpark 与 Arrow 指南。
Arrow 也能与 TensorFlow 等机器学习库良好配合。
其列式格式可实现更快的数据加载与预处理——这些是训练机器学习模型的关键步骤。借助对大型数据集的高效处理,Arrow 有助于构建可扩展的 ML 流水线,使训练更快,并能在不同工具之间更好地协作。
到这里就结束了!我们一起回顾了 Apache Arrow 的核心理念,了解了它与传统数据格式的不同、如何进行设置,以及如何在 Python 中使用它。
我们还通过动手示例构建了 Arrow Array 与 Table,并看到 Arrow 如何跳过缓慢的序列化,从而保持数据处理快速高效。
如果您希望继续学习并在此基础上深入,以下资源是不錯的下一站:
无论您的下一步是什么,我们希望 Arrow 能帮助您构建更简洁、更可扩展的工作流!
通过这些课程进一步学习数据工程!
课程
学习路径
实践并学习路径你的进步。
使用 Google 继续