Khóa học
Nhập môn Ngôn ngữ lập trình R
4 giờ
3.1M

Hãy hình dung bạn đang đi trong một mê cung. Mỗi bước đi, bạn phải đưa ra một quyết định đưa bạn gần lối ra hơn hoặc lạc sâu hơn vào mê cung. Điều này giống như thuật toán cây quyết định, một phương pháp học máy mạnh mẽ và trực quan giúp chúng ta hiểu dữ liệu phức tạp và chọn phương án tối ưu.
Thuật toán cây quyết định chia nhỏ một tập dữ liệu thành những tập con ngày càng nhỏ dựa trên các điều kiện nhất định. Giống như một cái cây có cành và lá, nó bắt đầu từ một nút gốc duy nhất rồi phân nhánh thành nhiều cành, mỗi nhánh đại diện cho một quyết định dựa trên giá trị của một đặc trưng. Các lá cuối cùng của cây là những kết quả hoặc dự đoán có thể xảy ra.
Bài viết này sẽ giới thiệu với bạn thế giới cây quyết định bằng ngôn ngữ R. Chúng ta sẽ bàn về các khái niệm cơ bản, đi sâu vào các loại thuật toán cây quyết định phổ biến, khám phá các phương pháp dựa trên cây, và hướng dẫn bạn một ví dụ từng bước. Kết thúc bài, bạn sẽ có thể khai thác sức mạnh của cây quyết định để đưa ra quyết định dựa trên dữ liệu tốt hơn.
Cây quyết định đặc biệt trong học máy nhờ tính đơn giản, dễ diễn giải và linh hoạt.
Đây là một thuật toán học máy có giám sát có thể dùng cho cả bài toán hồi quy (dự đoán giá trị liên tục) và phân loại (dự đoán giá trị phân loại). Hơn nữa, chúng là nền tảng cho các kỹ thuật nâng cao như bagging, boosting và rừng ngẫu nhiên.
Sơ đồ dưới đây minh họa các thuật ngữ phía sau cây quyết định:
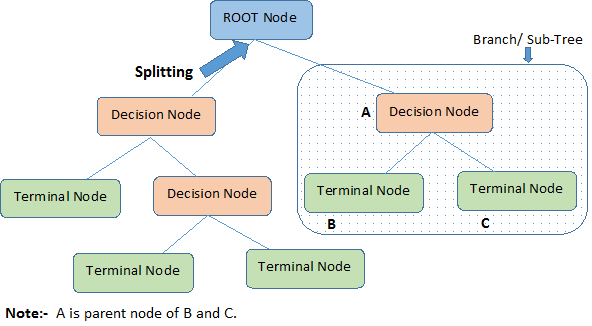
Một cây quyết định bắt đầu với nút gốc biểu thị toàn bộ quần thể hoặc mẫu, sau đó tách thành hai hoặc nhiều nhóm đồng nhất thông qua phương pháp gọi là chia tách. Khi các nút con tiếp tục được chia nhỏ, chúng được gọi là nút quyết định, trong khi những nút không chia nữa gọi là nút cuối hoặc lá. Một đoạn của cây hoàn chỉnh được gọi là nhánh.
Chúng ta đã xác định rằng cây quyết định có thể dùng cho cả hồi quy và phân loại; vậy hãy tìm hiểu thuật toán đằng sau các loại cây quyết định này.
Hãy cùng hiểu một cách trực quan cả cây hồi quy và cây phân loại, điểm giống và khác nhau, cũng như các hàm lỗi.
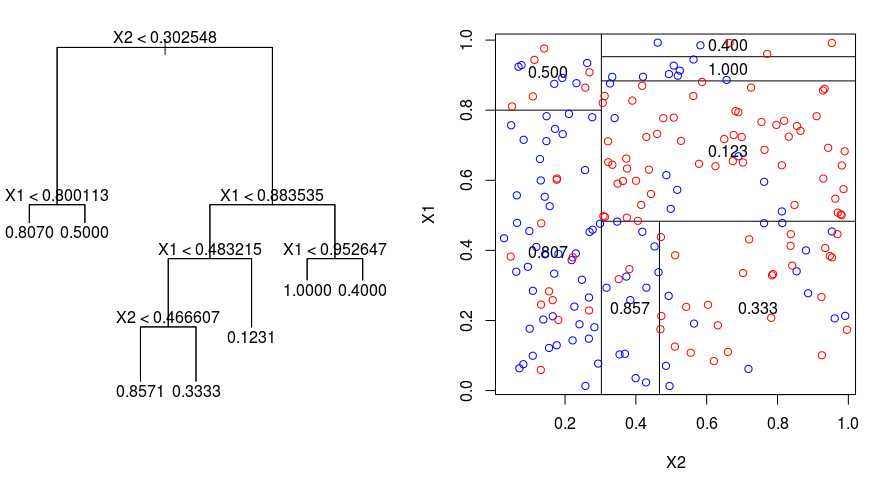
Hãy xem hình dưới giúp hình dung cách phân mảnh được thực hiện bởi một Cây Hồi quy. Hình cho thấy một cây chưa cắt tỉa và một cây hồi quy được khớp với một tập dữ liệu ngẫu nhiên. Cả hai minh họa một chuỗi các quy tắc chia tách, bắt đầu từ đỉnh của cây. Lưu ý rằng mỗi lần chia miền đều song song với một trục đặc trưng. Khái niệm chia song song trục này khái quát dễ dàng lên không gian nhiều hơn hai chiều. Với không gian đặc trưng kích thước $p$, là một tập con của $\mathbb{R}^p$, không gian được chia thành $M$ vùng, $R_{m}$, mỗi vùng là một “siêu khối” $p$ chiều.
Để xây dựng một cây hồi quy, trước tiên bạn dùng chia tách nhị phân đệ quy để tăng trưởng một cây lớn trên dữ liệu huấn luyện, chỉ dừng lại khi mỗi nút cuối có ít hơn một số lượng tối thiểu quan sát. Chia tách nhị phân đệ quy là một thuật toán tham lam, từ trên xuống, dùng để tối thiểu hóa Tổng bình phương phần dư (RSS), một thước đo lỗi cũng dùng trong bối cảnh hồi quy tuyến tính. Với không gian đặc trưng được chia thành M phần, RSS được cho bởi:
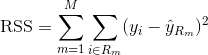
Bắt đầu từ đỉnh của cây, bạn chia thành 2 nhánh, tạo nên một phân hoạch gồm 2 vùng. Sau đó bạn thực hiện việc chia này nhiều lần ở đỉnh cây và chọn cách chia các đặc trưng sao cho tối thiểu hóa RSS (hiện tại).
Tiếp theo, bạn áp dụng cắt tỉa theo độ phức tạp chi phí cho cây lớn để thu được một dãy các cây con tốt nhất như một hàm của $\alpha$. Ý tưởng cơ bản là đưa vào một tham số tinh chỉnh bổ sung, ký hiệu $\alpha$, cân bằng giữa độ sâu của cây và mức độ phù hợp với dữ liệu huấn luyện.
Bạn có thể dùng đánh giá chéo K-fold để chọn $\alpha$. Kỹ thuật này đơn giản là chia các quan sát huấn luyện thành K phần để ước lượng tỷ lệ lỗi kiểm tra của các cây con. Mục tiêu là chọn giá trị mang lại tỷ lệ lỗi thấp nhất.
Một cây phân loại rất giống với cây hồi quy, ngoại trừ việc nó dùng để dự đoán phản hồi định tính thay vì định lượng.
Nhớ rằng với cây hồi quy, giá trị dự đoán cho một quan sát là trung bình phản hồi của các quan sát huấn luyện thuộc cùng một nút cuối. Ngược lại, với cây phân loại, bạn dự đoán mỗi quan sát thuộc về lớp xuất hiện phổ biến nhất trong vùng mà nó thuộc về.
Khi diễn giải kết quả cây phân loại, bạn thường không chỉ quan tâm đến dự đoán lớp ứng với một vùng nút cuối cụ thể, mà còn quan tâm đến tỷ lệ các lớp trong số những quan sát huấn luyện rơi vào vùng đó.
Nhiệm vụ tăng trưởng một cây phân loại khá giống với cây hồi quy. Cũng như trong bối cảnh hồi quy, bạn dùng chia tách nhị phân đệ quy để tăng trưởng cây phân loại. Tuy nhiên, trong bối cảnh phân loại, Tổng bình phương phần dư không thể dùng làm tiêu chí chia nhị phân. Thay vào đó, bạn có thể dùng một trong 3 phương pháp dưới đây:
E = 1 - argmaxc($\hat{\pi}_{mc}$)
trong đó $\hat{\pi}_{mc}$ biểu thị phần dữ liệu huấn luyện trong vùng Rm thuộc lớp c.
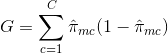
Cross-entropy sẽ nhận giá trị gần 0 nếu các $\hat{\pi}_{mc}$ đều gần 0 hoặc gần 1. Do đó, giống chỉ số Gini, cross-entropy sẽ nhỏ nếu nút thứ m thuần khiết. Thực tế, chỉ số Gini và cross-entropy khá tương đồng về mặt số trị.
Khi xây dựng cây phân loại, thường dùng chỉ số Gini hoặc cross-entropy để đánh giá chất lượng một phép chia cụ thể, vì chúng nhạy với độ thuần của nút hơn tỷ lệ lỗi phân loại. Bất kỳ trong 3 cách tiếp cận này đều có thể dùng khi cắt tỉa cây, nhưng tỷ lệ lỗi phân loại thường phù hợp hơn nếu mục tiêu là độ chính xác dự đoán của cây đã cắt tỉa cuối cùng.
Dù chúng ta muốn hiểu thuật toán và điểm mạnh của nó đến đâu, điều cốt yếu là phải hiểu cả những hạn chế. Sự thật là cây quyết định không phải lúc nào cũng phù hợp nhất cho mọi loại bài toán học máy, điều này cũng đúng với các thuật toán học máy khác.
Dưới đây là ưu và nhược điểm:
Dù có những nhược điểm trên, cây quyết định vẫn là lựa chọn phổ biến trong nhiều ứng dụng nhờ sự đơn giản, khả năng diễn giải và tính linh hoạt.
Hãy khám phá các phương pháp tổ hợp dựa trên cây tận dụng điểm mạnh của cây quyết định đồng thời khắc phục một số hạn chế của chúng: bagging, boosting và rừng ngẫu nhiên.
Các cây quyết định vừa thảo luận ở trên mắc phải phương sai cao, nghĩa là nếu bạn chia ngẫu nhiên dữ liệu huấn luyện thành 2 phần và khớp một cây quyết định cho mỗi phần, kết quả có thể khá khác nhau. Ngược lại, một thủ tục có phương sai thấp sẽ cho kết quả tương tự nếu lặp lại trên các tập dữ liệu khác nhau.
Bagging, hay bootstrap aggregation, là kỹ thuật dùng để giảm phương sai của dự đoán bằng cách kết hợp kết quả của nhiều bộ phân loại được mô hình hóa trên các mẫu con khác nhau của cùng một tập dữ liệu. Đây là phương trình cho bagging:
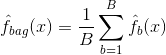
trong đó bạn tạo ra $B$ tập dữ liệu huấn luyện bootstrap khác nhau. Sau đó huấn luyện phương pháp của bạn trên tập huấn luyện bootstrap thứ $b$ để thu được $\hat{f}_{b}(x)$, và cuối cùng lấy trung bình các dự đoán.
Hình dưới minh họa 3 bước trong bagging:
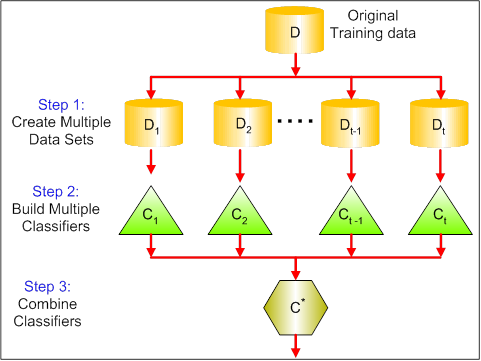
Bước 1: Thay thế dữ liệu gốc bằng dữ liệu mới. Dữ liệu mới thường có một phần cột và hàng của dữ liệu gốc, có thể dùng làm siêu tham số trong mô hình bagging.
Bước 2: Xây bộ phân loại trên mỗi tập dữ liệu. Thông thường, bạn có thể dùng cùng một bộ phân loại để tạo mô hình và dự đoán.
Bước 3: Cuối cùng, dùng giá trị trung bình để kết hợp dự đoán của tất cả bộ phân loại, tùy bài toán. Nhìn chung, các giá trị kết hợp này vững vàng hơn một mô hình đơn lẻ.
Mặc dù bagging có thể cải thiện dự đoán cho nhiều phương pháp hồi quy và phân loại, nó đặc biệt hữu ích cho cây quyết định. Để áp dụng bagging cho cây hồi quy/phân loại, bạn chỉ cần xây dựng $B$ cây hồi quy/phân loại dùng $B$ tập huấn luyện bootstrap và lấy trung bình các dự đoán. Các cây này được trồng sâu và không cắt tỉa. Do đó mỗi cây riêng lẻ có phương sai cao nhưng độ chệch thấp. Lấy trung bình $B$ cây sẽ giảm phương sai.
Tổng quát mà nói, bagging đã cho thấy cải thiện ấn tượng về độ chính xác bằng cách kết hợp hàng trăm thậm chí hàng nghìn cây vào một thủ tục duy nhất.
Rừng Ngẫu nhiên là một phương pháp học máy linh hoạt có thể thực hiện cả hồi quy và phân loại. Nó cũng thực hiện các phương pháp giảm chiều, xử lý giá trị thiếu, giá trị ngoại lệ và các bước khám phá dữ liệu thiết yếu khác, và làm khá tốt.
Rừng ngẫu nhiên cải tiến các cây bagging bằng một điều chỉnh nhỏ để khử tương quan giữa các cây. Giống như bagging, bạn xây nhiều cây quyết định trên các mẫu huấn luyện bootstrap. Nhưng khi xây cây, mỗi lần xem xét một phép chia trong cây, một mẫu ngẫu nhiên gồm m biến dự báo được chọn làm ứng viên chia từ toàn bộ tập $p$ biến dự báo. Phép chia chỉ được phép dùng một trong số $m$ biến đó. Đây là khác biệt chính giữa rừng ngẫu nhiên và bagging; vì trong bagging, lựa chọn biến dự báo là $m = p$.
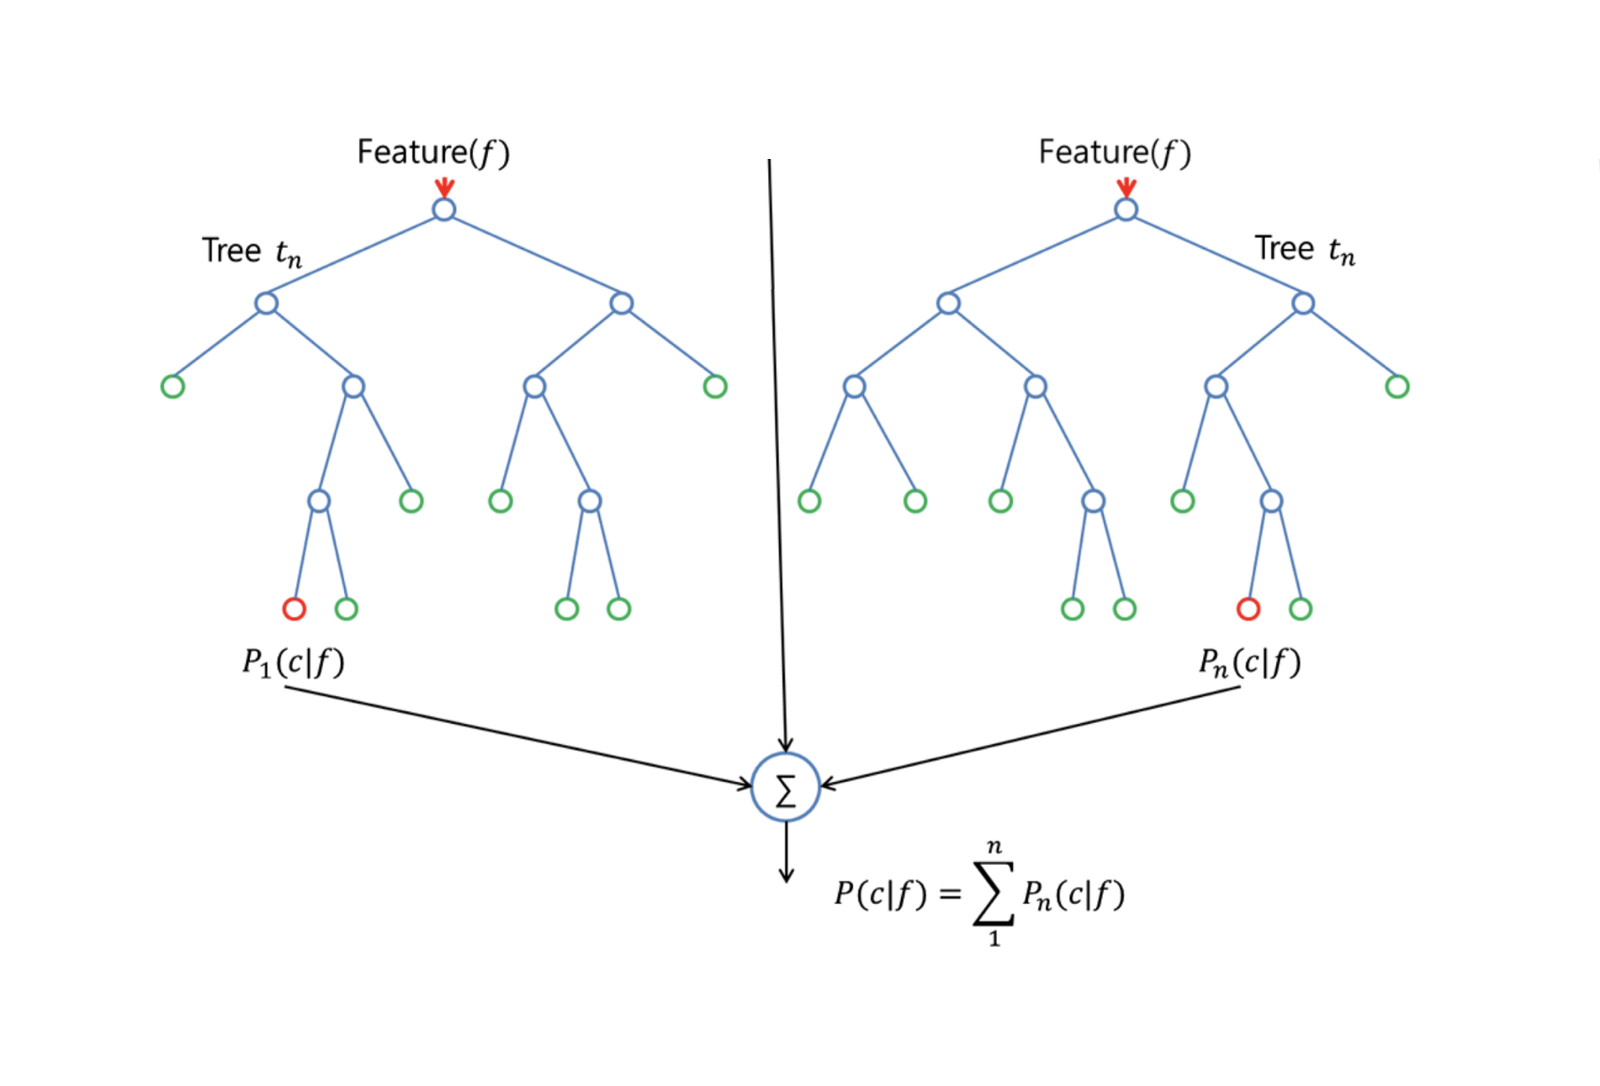
Để trồng một rừng ngẫu nhiên, bạn nên:
Trước tiên giả sử số trường hợp trong tập huấn luyện là K. Sau đó, lấy mẫu ngẫu nhiên các trường hợp này và dùng mẫu đó làm tập huấn luyện để trồng cây.
Nếu có $p$ biến đầu vào, chỉ định một số $m < p$ sao cho tại mỗi nút, bạn có thể chọn ngẫu nhiên $m$ biến trong số $p$. Phép chia tốt nhất trên $m$ biến này được dùng để chia nút.
Mỗi cây sau đó được trồng tới mức tối đa và không cần cắt tỉa.
Cuối cùng, tổng hợp các dự đoán của các cây mục tiêu để dự đoán dữ liệu mới.
Rừng ngẫu nhiên rất hiệu quả trong việc ước lượng dữ liệu thiếu và duy trì độ chính xác khi một tỷ lệ lớn dữ liệu bị thiếu. Nó cũng có thể cân bằng lỗi trong các tập dữ liệu mất cân bằng lớp. Quan trọng nhất, nó xử lý được các tập dữ liệu khổng lồ với số chiều lớn. Tuy nhiên, một nhược điểm là bạn có thể dễ quá khớp với tập dữ liệu nhiễu, đặc biệt trong bài toán hồi quy.
Boosting là một cách tiếp cận khác để cải thiện dự đoán từ cây quyết định. Giống bagging và rừng ngẫu nhiên, đây là một phương pháp tổng quát có thể áp dụng cho nhiều phương pháp học thống kê trong hồi quy hoặc phân loại. Nhớ rằng bagging tạo nhiều bản sao của tập huấn luyện gốc bằng bootstrap, khớp một cây quyết định riêng cho mỗi bản sao, rồi kết hợp tất cả các cây để tạo một mô hình dự đoán duy nhất. Đáng chú ý, mỗi cây được xây trên một tập bootstrap, độc lập với các cây khác.
Boosting hoạt động tương tự, ngoại trừ việc các cây được trồng tuần tự: mỗi cây dùng thông tin từ các cây đã trồng trước đó. Boosting không dùng mẫu bootstrap; thay vào đó, mỗi cây được khớp trên một phiên bản đã được sửa đổi của tập dữ liệu gốc.
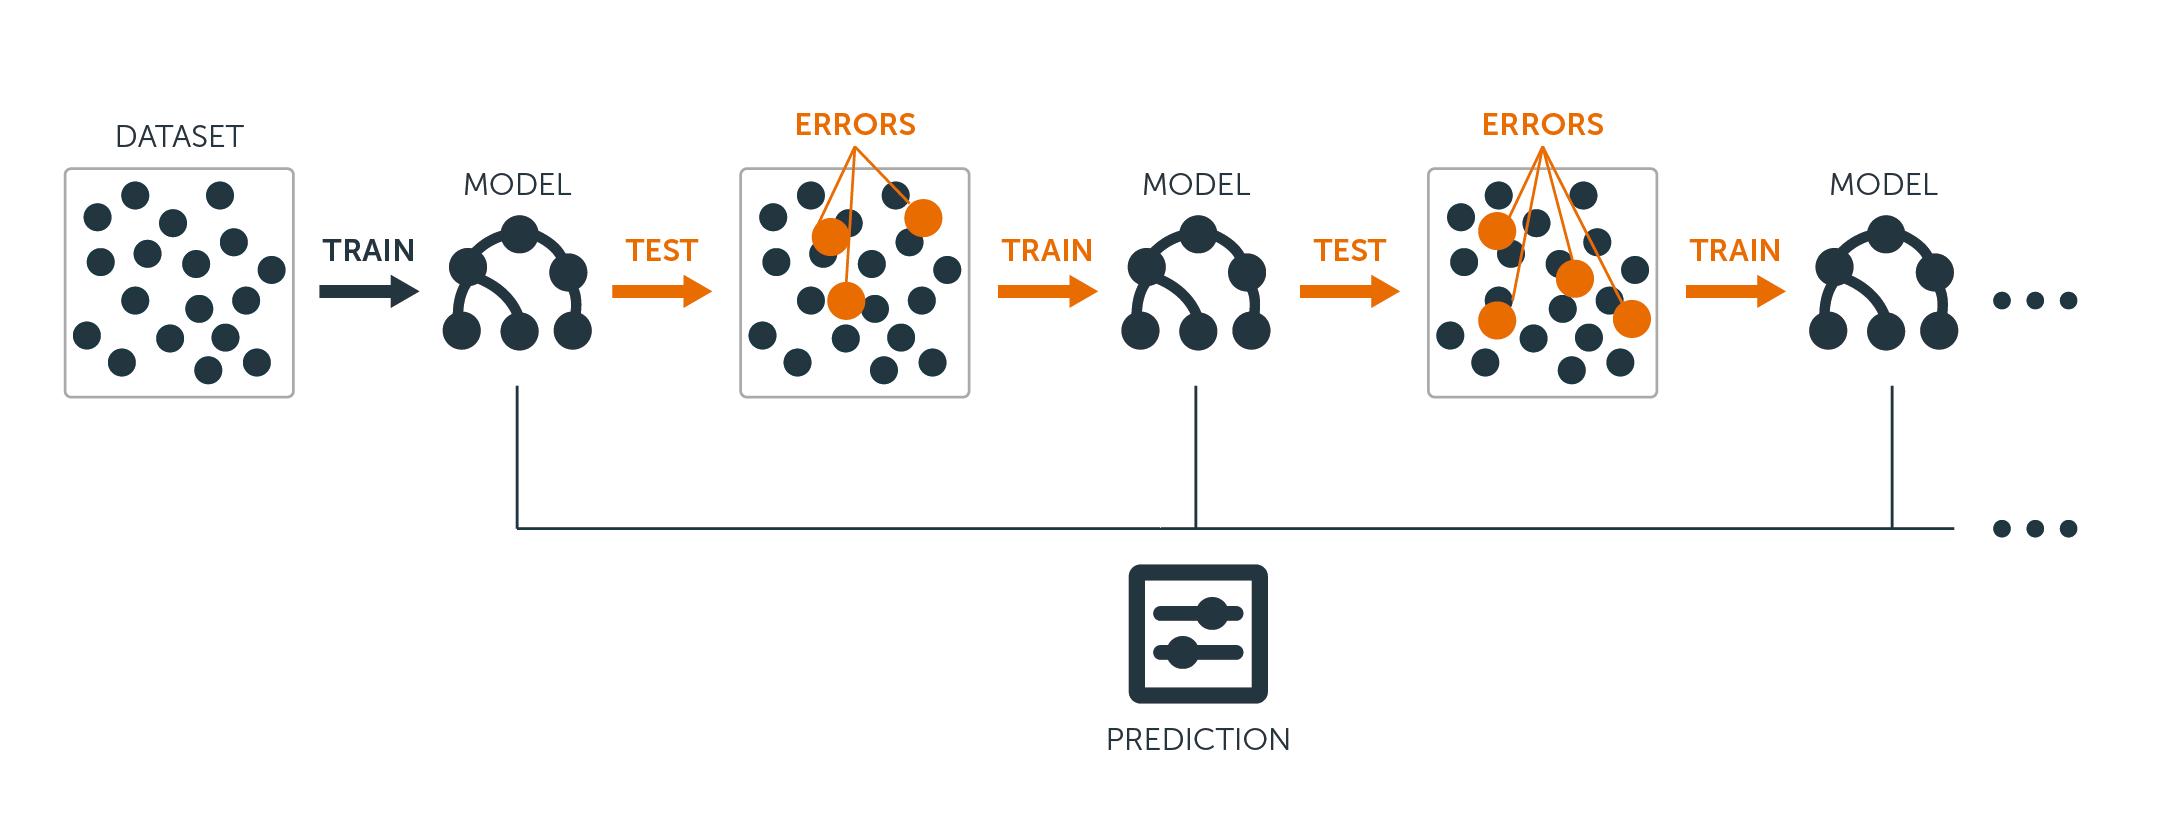
Với cả cây hồi quy và phân loại, boosting hoạt động như sau:
Thay vì khớp một cây quyết định lớn duy nhất với dữ liệu, điều có thể dẫn tới quá khớp, boosting học một cách từ tốn.
Với mô hình hiện tại, bạn khớp một cây quyết định lên phần dư từ mô hình. Tức là, bạn khớp một cây dùng phần dư hiện tại, thay vì biến kết quả $Y$, làm biến phản hồi.
Sau đó bạn thêm cây quyết định mới này vào hàm đã khớp để cập nhật phần dư. Mỗi cây trong số này có thể khá nhỏ, chỉ với vài nút cuối, được xác định bởi tham số $d$ trong thuật toán. Bằng cách khớp các cây nhỏ vào phần dư, bạn từ từ cải thiện $\hat{f}$ ở những vùng mà mô hình hoạt động chưa tốt.
Tham số co rút $\nu$ làm chậm quá trình hơn nữa, cho phép nhiều cây với hình dạng khác nhau xử lý phần dư.
Boosting rất hữu ích khi bạn có nhiều dữ liệu và kỳ vọng cây quyết định sẽ rất phức tạp. Boosting đã được dùng để giải nhiều bài toán phân loại và hồi quy khó, bao gồm phân tích rủi ro, phân tích cảm xúc, quảng cáo dự đoán, mô hình giá, ước tính doanh số và chẩn đoán bệnh nhân, v.v.
Về bản chất, các thuật toán này kết hợp dự đoán của nhiều cây quyết định để cải thiện hiệu năng và độ ổn định tổng thể. Sau khi đã hiểu các thuật toán nâng cao, trong phạm vi hướng dẫn này, chúng ta sẽ tiếp tục với các mô hình cây quyết định đơn giản.
Chúng ta đã học khá nhiều về lý thuyết và trực giác đằng sau các mô hình cây quyết định và biến thể của chúng, nhưng không gì bằng việc thực hành xây dựng mô hình và đánh giá hiệu năng một cách từng bước.
Trong các ví dụ sau, chúng ta sẽ dùng bộ dữ liệu Boston Housing nổi tiếng.
Bộ dữ liệu Boston Housing chứa thông tin về thị trường nhà ở tại Boston, Massachusetts, những năm 1970. Nó có 506 quan sát và 14 biến, gồm 13 đặc trưng và 1 biến mục tiêu.
Các đặc trưng trong bộ dữ liệu Boston Housing gồm:
Biến mục tiêu là MEDV, đại diện giá trị trung vị của nhà do chủ sở hữu ở tính theo nghìn đô la.
Mục tiêu là dự đoán giá trị trung vị của các căn nhà do chủ sở hữu ở (tính bằng hàng nghìn đô la) dựa trên các đặc trưng đã cho.
Trong R, dữ liệu được cung cấp trong gói “MASS.” Bạn sẽ cần cài đặt nhiều gói cho hướng dẫn này và nạp chúng. Vì việc này sẽ lặp lại, hãy minh họa quy trình với gói MASS một lần, và bạn lặp lại khi thấy một gói mới được dùng trong hướng dẫn.
# install the package
install.packages("MASS")

# Load the MASS package
library(MASS)

# Load the Boston Housing dataset
data(Boston)
Thường cần khám phá dữ liệu qua trực quan hóa và thực hiện các bước tiền xử lý trước khi chuyển sang mô hình hóa. Hãy xem phân phối các biến thông qua biểu đồ histogram.
Đây là mã để tạo chúng:
# Load the library
library(tidymodels)
library(tidyr)

# Prepare the dataset for ggplot2
boston_data_long <- Boston %>%
 pivot_longer(cols = everything(),
              names_to = "variable",
              values_to = "value")

# Create a histogram for all numeric variables in one plot
boston_histograms <- ggplot(boston_data_long, aes(x = value)) +
 geom_histogram(bins = 30, color = "black", fill = "lightblue") +
 facet_wrap(~variable, scales = "free", ncol = 4) +
 labs(title = "Histograms of Numeric Variables in the Boston Housing Dataset",
      x = "Value",
      y = "Frequency") +
 theme_minimal()

# Plot the histograms
print(boston_histograms)
Và đầu ra trông như sau:

Chúng ta thấy một số ngoại lệ, đặc biệt ở các cột như RAD, TAX và NOX. Mục tiêu của hướng dẫn này tập trung vào giai đoạn mô hình hóa cây quyết định; vì vậy hãy chia bộ dữ liệu thành tập huấn luyện và kiểm tra.
# Split the data into training and testing sets

set.seed(123)
data_split <- initial_split(Boston, prop = 0.75)
train_data <- training(data_split)
test_data <- testing(data_split)
Giờ hãy bắt tay vào mô hình hóa và đánh giá hiệu năng mô hình.
Dùng hàm decision_tree() từ gói Tidymodels trong R, việc tạo đặc tả mô hình cây quyết định trước rồi khớp mô hình trên dữ liệu huấn luyện là khá trực quan.
# Create a decision tree model specification
tree_spec <- decision_tree() %>%
 set_engine("rpart") %>%
 set_mode("regression")

# Fit the model to the training data
tree_fit <- tree_spec %>%
 fit(medv ~ ., data = train_data)
Chúng ta dùng chế độ “regression” ở đây, và với cây quyết định phân loại, ta sẽ dùng chế độ “classification”.
Để đánh giá hiệu năng mô hình, chúng ta sẽ dùng gói Tidymodels để tính sai số bình phương trung bình căn (RMSE) và hệ số xác định R-squared cho mô hình cây quyết định trên dữ liệu kiểm tra.
# Make predictions on the testing data
predictions <- tree_fit %>%
 predict(test_data) %>%
 pull(.pred)

# Calculate RMSE and R-squared
metrics <- metric_set(rmse, rsq)
model_performance <- test_data %>%
 mutate(predictions = predictions) %>%
 metrics(truth = medv, estimate = predictions)

print(model_performance)
Bạn sẽ nhận được đầu ra trình bày hai chỉ số hiệu năng: Sai số bình phương trung bình căn (RMSE) và R-squared (R²).
 .metric .estimator .estimate
 <chr>   <chr>          <dbl>
1 rmse    standard       5.22
2 rsq standard 0.689Vậy, kết quả mô hình của chúng ta đã đủ tốt chưa?
Chúng ta cũng có thể tối ưu siêu tham số để vắt kiệt hiệu năng hoặc chuyển sang các mô hình phức tạp hơn như Random Forests và XGBoost với cái giá là giảm khả năng diễn giải mô hình.
Khi bạn hài lòng với mô hình, đã đến lúc để mô hình đưa ra dự đoán.
Cách làm tương tự như với dữ liệu kiểm tra bằng hàm predict(), nhưng chúng ta sẽ cung cấp một bộ dữ liệu mới mô phỏng thông tin về một căn nhà mới ở Boston. Đây là kịch bản có thể xảy ra khi mô hình chạy thực tế trong môi trường sản xuất.
# Make predictions on new data
new_data <- tribble(
 ~crim, ~zn, ~indus, ~chas, ~nox, ~rm, ~age, ~dis, ~rad, ~tax, ~ptratio, ~black, ~lstat,
 0.03237, 0, 2.18, 0, 0.458, 6.998, 45.8, 6.0622, 3, 222, 18.7, 394.63, 2.94
)
predictions <- predict(tree_fit, new_data)
print(predictions)
Và bạn sẽ nhận được giá trị trung vị dự đoán (tính bằng $1000) cho căn nhà cụ thể này:
# A tibble: 1 × 1
 .pred
 <dbl>
1  37.8
Như vậy, bạn đã nắm được các bước xây dựng mô hình cây quyết định — giờ hãy tập trung vào cách chúng ta có thể tự diễn giải điều gì đang diễn ra trong mô hình và giải thích cho các bên liên quan sử dụng giải pháp vừa xây.
Lợi thế lớn nhất, như đã nói, là khả năng diễn giải của mô hình cây quyết định. Hãy trực quan hóa cây quyết định để hiểu mô hình rõ hơn:
# Load the library
library(rpart.plot)

# Plot the decision tree
rpart.plot(tree_fit$fit, type = 4, extra = 101, under = TRUE, cex = 0.8, box.palette = "auto")
Bạn sẽ thấy một biểu đồ như thế này:

Biểu đồ đầu ra của hàm rpart.plot hiển thị biểu diễn cây quyết định của mô hình. Trong biểu đồ này, mỗi nút đại diện cho một phép chia trong cây dựa trên các biến dự báo. Biểu đồ bao gồm một số thông tin giúp chúng ta diễn giải cây quyết định:
Các nút được biểu diễn bằng hình tròn và được nối bằng các đường, thể hiện cấu trúc phân cấp của cây. Cây bắt đầu với một nút gốc ở trên cùng, sau đó tách thành các nút bên trong, cuối cùng dẫn tới các nút cuối hay lá ở phía dưới.
Mỗi nút bên trong hiển thị tiêu chí chia, tức biến dự báo và giá trị dùng để chia dữ liệu thành hai tập con.
Ví dụ, một nút có thể hiển thị “RM < 6.8”, cho biết các quan sát có số phòng trung bình mỗi căn (RM) nhỏ hơn 6,8 sẽ đi theo nhánh trái, trong khi các quan sát có RM lớn hơn hoặc bằng 6,8 sẽ đi theo nhánh phải.
n tại mỗi nút biểu thị số quan sát trong tập dữ liệu rơi vào nút đó. Ví dụ, nếu một nút hiển thị "n = 100", nghĩa là có 100 quan sát trong tập dữ liệu thỏa các tiêu chí của các nút cha của nút đó.
Giá trị phần trăm giúp bạn hiểu kích thước tương đối của mỗi nút so với toàn bộ tập dữ liệu, cho thấy dữ liệu đang được chia và phân bổ qua cây như thế nào. Phần trăm cao nghĩa là tỷ lệ lớn dữ liệu theo đường quyết định dẫn đến nút đó, trong khi phần trăm thấp chỉ ra tỷ lệ nhỏ dữ liệu đi tới nút.
Giá trị dự đoán tại mỗi nút được hiển thị dưới dạng một con số trong vòng tròn (nút) có màu. Trong cây hồi quy, đây là giá trị trung bình của biến mục tiêu cho tất cả quan sát rơi vào nút đó.
Ví dụ, nút lá cuối cùng hiển thị 47 nghĩa là giá trị trung bình của biến mục tiêu (trong trường hợp của chúng ta là giá trị trung vị của nhà do chủ sở hữu ở) cho tất cả quan sát trong nút đó là 47.
Khi diễn giải bất kỳ kết quả nào, bạn bắt đầu từ nút gốc và theo các nhánh dựa trên tiêu chí chia cho đến khi tới một nút cuối. Giá trị dự đoán ở nút cuối cho ra dự đoán của mô hình cho một quan sát nhất định và lý do đằng sau quyết định.
Nếu bạn vẫn muốn trích xuất các quy tắc ở dạng văn bản (thay vì lần theo biểu đồ) — bạn cũng có thể làm điều này bằng cùng thư viện đã dùng để vẽ biểu đồ.
Đây là mã để thực hiện:
rules <- rpart.rules(tree_fit$fit)
print(rules)
Và bạn sẽ thấy đầu ra với các giá trị dự đoán và các quy tắc mà mô hình tuân theo để đi đến giá trị đó như dưới đây:
medv
  11 when rm <  6.9        & lstat >= 15 & crim >= 7.5
  17 when rm <  6.9        & lstat >= 15 & crim <  7.5
  22 when rm <  6.5        & lstat <  15               & dis >= 1.6
  26 when rm is 6.9 to 7.4 & lstat >=  7
  27 when rm is 6.5 to 6.9 & lstat <  15
  34 when rm <  6.5        & lstat <  15               & dis <  1.6
  34 when rm is 6.9 to 7.4 & lstat <   7
  47 when rm >=        7.4
Giờ khi thấy các quy tắc, bạn có thể tự hỏi làm sao quyết định có thể được đưa ra với 3–4 biến khi chúng ta nạp nhiều biến hơn cho cây quyết định.
Thì ra một số biến quan trọng hơn những biến còn lại. Hãy hiểu rõ hơn khái niệm này.
Chúng ta đã xem sơ đồ cây và cách mô hình hoạt động. Một khía cạnh cuối cùng của diễn giải là hiểu các biến quan trọng từ tập dữ liệu.
Vì sao điều này quan trọng:
Trong cây quyết định, tầm quan trọng biến thường được xác định bởi các đặc trưng dùng để chia tại các nút. Những đặc trưng được dùng để chia ở vị trí cao trong cây hoặc được dùng thường xuyên có thể coi là quan trọng hơn.
Tầm quan trọng của một biến có thể được định lượng bởi mức giảm của thước đo độ tạp (ví dụ, chỉ số Gini hoặc sai số bình phương trung bình) mà nó đem lại khi được dùng để chia. Gói “VIP” trong R đã loại bỏ các phức tạp và bạn có thể thu được biểu đồ qua đoạn mã dưới:
# Load the necessary library
library(vip)

# Create a variable importance plot
var_importance <- vip::vip(tree_fit, num_features = 10)
print(var_importance)
Và bạn sẽ nhận được biểu đồ tầm quan trọng biến dưới đây:

Khi đã thấy biểu đồ, bạn có thể nghiên cứu thêm vì sao các biến này quan trọng, phối hợp với chuyên gia miền. Ví dụ, dựa trên biểu đồ trên, ta có thể suy ra 3 biến quan trọng nhất và lý do:
Vì vậy, hãy nhớ kiểm tra biểu đồ tầm quan trọng biến trước khi chốt mô hình; điều này giúp bạn tạo và chọn đặc trưng tốt hơn để tối ưu hiệu năng.
Trong hướng dẫn này, chúng ta đã khám phá các khái niệm nền tảng của cây quyết định và không chỉ xây dựng mô hình mà còn diễn giải chúng. Cây quyết định là các mô hình mạnh mẽ và dễ diễn giải cho cả nhiệm vụ phân loại và hồi quy, khiến chúng trở thành công cụ thiết yếu trong bộ đồ nghề của nhà khoa học dữ liệu.
Khi tiếp tục phát triển kỹ năng, chúng tôi khuyến khích bạn đào sâu hơn vào thế giới cây quyết định, khám phá các thuật toán thay thế và nâng cao khả năng lập trình R. Dưới đây là một số tài nguyên cho bước tiếp theo:
Không nghi ngờ gì, mở rộng kiến thức và thử nghiệm công cụ, kỹ thuật mới sẽ giúp bạn xử lý nhiều thách thức đa dạng và mang lại những hiểu biết giá trị cho các dự án của mình.
Khóa học R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
