

कल्पना कीजिए कि आप एक भूलभुलैया से गुजर रहे हैं। हर कदम पर आपको एक ऐसा निर्णय लेना पड़ता है जो या तो आपको बाहर निकलने के करीब ले जाए या भूलभुलैया में और भीतर। यही कुछ डिसीजन ट्री एल्गोरिदम करता है—एक शक्तिशाली और सहज मशीन लर्निंग विधि जो हमें जटिल डेटा को समझने और सबसे अच्छा कदम चुनने में मदद करती है।
डिसीजन ट्री एल्गोरिदम कुछ शर्तों के आधार पर किसी डेटासेट को छोटे-छोटे उपसमुच्चयों में तोड़ता है। पत्तियों और नोड्स वाली शाखायुक्त पेड़ की तरह, यह एकल रूट नोड से शुरू होता है और कई शाखाओं में फैलता है, जिनमें से हर एक किसी फीचर के मान पर आधारित निर्णय का प्रतिनिधित्व करता है। पेड़ की अंतिम पत्तियाँ संभावित परिणाम या पूर्वानुमान होती हैं।
यह लेख R प्रोग्रामिंग भाषा का उपयोग करके आपको डिसीजन ट्री की दुनिया से परिचित कराएगा। हम बुनियादी बातें समझेंगे, डिसीजन ट्री एल्गोरिदम के लोकप्रिय प्रकारों में उतरेंगे, ट्री-आधारित विधियों का अन्वेषण करेंगे, और आपको एक चरण-दर-चरण उदाहरण से गुजारेंगे। अंत तक, आप बेहतर डेटा-आधारित निर्णय लेने के लिए डिसीजन ट्री की शक्ति का उपयोग करने में सक्षम होंगे।
मशीन लर्निंग में डिसीजन ट्री क्या है?
डिसीजन ट्री अपनी सरलता, व्याख्येयता और बहुमुखी प्रतिभा के कारण मशीन लर्निंग में खास हैं।
यह एक सुपरवाइज़्ड मशीन लर्निंग एल्गोरिदम है जिसका उपयोग रिग्रेशन (सतत मानों का पूर्वानुमान) और क्लासिफिकेशन (श्रेणीबद्ध मानों का पूर्वानुमान) दोनों समस्याओं के लिए किया जा सकता है। साथ ही, ये बैगिंग, बूस्टिंग और रैंडम फॉरेस्ट जैसी उन्नत तकनीकों की आधारशिला भी हैं।
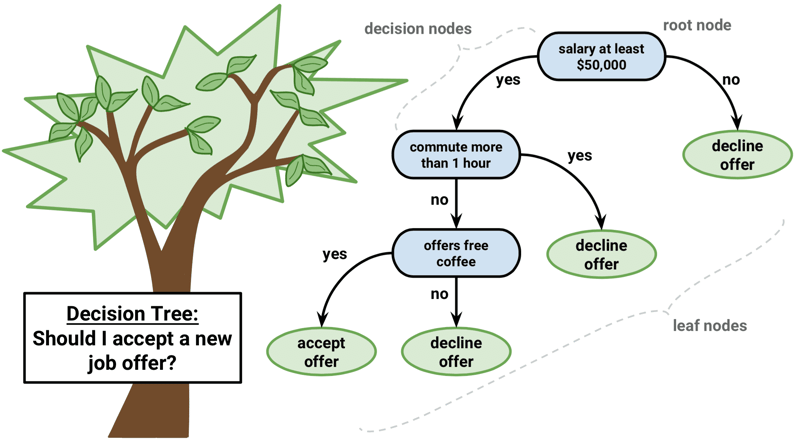
नीचे दिया गया आरेख डिसीजन ट्री से जुड़ी पारिभाषिक शब्दावली को दर्शाएगा:
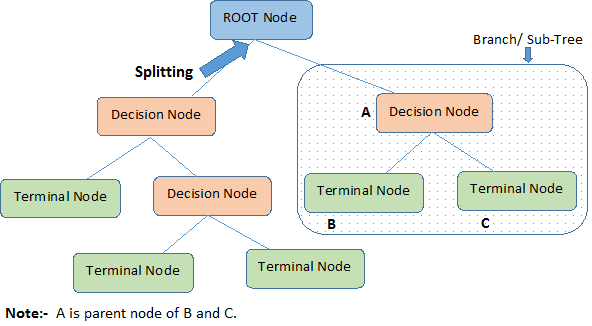
एक डिसीजन ट्री रूट नोड से शुरू होता है जो पूरी आबादी या सैंपल को दर्शाता है, जिसे बाद में स्प्लिटिंग नामक विधि से दो या अधिक एकरूप समूहों में विभाजित किया जाता है। जब सब-नोड्स का आगे विभाजन होता है, तो उन्हें डिसीजन नोड कहा जाता है, जबकि जो नोड और नहीं विभाजित होते, उन्हें टर्मिनल नोड या पत्तियाँ कहा जाता है। पूर्ण पेड़ के किसी खंड को ब्रांच कहा जाता है।
हमने स्थापित किया कि डिसीजन ट्री का उपयोग रिग्रेशन और क्लासिफिकेशन दोनों कार्यों के लिए किया जा सकता है; अतः आइए डिसीजन ट्री के प्रकारों के पीछे के एल्गोरिदम को समझें।
डिसीजन ट्री एल्गोरिदम के लोकप्रिय प्रकार
आइए सहज रूप से रिग्रेशन और क्लासिफिकेशन डिसीजन ट्री—दोनों को समझें, दोनों में क्या समान और भिन्न है, और एरर फंक्शंस क्या हैं।
Regression Trees
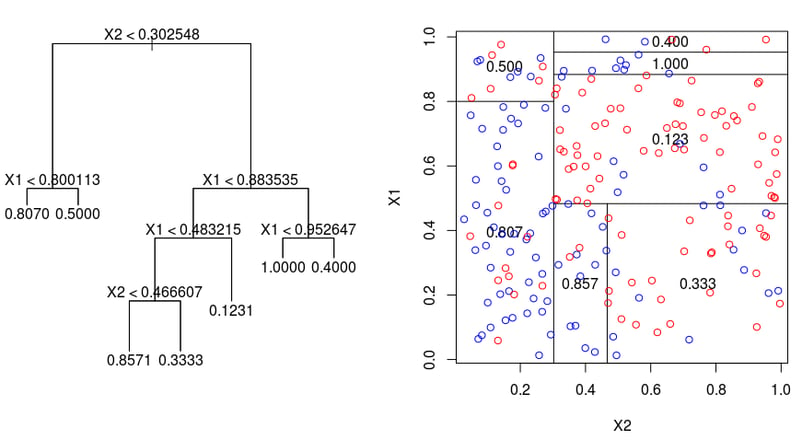
नीचे दी गई छवि पर नज़र डालिए, जो Regression Tree द्वारा किए गए विभाजन के स्वरूप को दर्शाने में मदद करती है। यह एक अन-प्रून्ड ट्री और एक रैंडम डेटासेट पर फिट किया गया रिग्रेशन ट्री दिखाती है। दोनों विज़ुअलाइज़ेशन पेड़ के शीर्ष से शुरू होने वाले विभाजन नियमों की श्रृंखला दिखाते हैं। ध्यान दें कि डोमेन का हर विभाजन किसी एक फीचर अक्ष के समानांतर है। अक्ष-समांतर विभाजन की अवधारणा दो से अधिक आयामों के लिए सीधे सामान्यीकृत हो जाती है। आकार $p$ वाले फीचर स्पेस, जो $\mathbb{R}^p$ का उपसमुच्चय है, को $M$ प्रदेशों $R_{m}$ में बांटा जाता है, जिनमें से प्रत्येक $p$-आयामी "हाइपरब्लॉक" है।
एक रिग्रेशन ट्री बनाने के लिए, आप पहले प्रशिक्षण डेटा पर recursive binary splitting का उपयोग करके एक बड़ा पेड़ उगाते हैं, और तभी रुकते हैं जब प्रत्येक टर्मिनल नोड में न्यूनतम प्रेक्षणों की संख्या से कम रह जाए। Recursive Binary Splitting एक ग्रीडी और टॉप-डाउन एल्गोरिदम है जिसका उपयोग Residual Sum of Squares (RSS) को न्यूनतम करने के लिए किया जाता है—यह वही त्रुटि माप है जिसका उपयोग linear regression में भी होता है। विभाजित फीचर स्पेस में M विभाजनों की स्थिति में RSS इस प्रकार दिया जाता है:
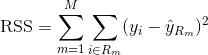
पेड़ के शीर्ष से शुरू करते हुए, आप इसे 2 शाखाओं में विभाजित करते हैं, जिससे 2 स्पेस का विभाजन बनता है। फिर आप इस शीर्ष विभाजन को कई बार आज़माते हैं और उन फीचर्स के विभाजन का चयन करते हैं जो (वर्तमान) RSS को न्यूनतम करता है।
इसके बाद, आप बड़े पेड़ पर cost complexity pruning लागू करते हैं ताकि $\alpha$ के फलन के रूप में सर्वोत्तम सबट्रीज़ का अनुक्रम प्राप्त किया जा सके। मूल विचार एक अतिरिक्त ट्यूनिंग पैरामीटर, $\alpha$, जोड़ने का है जो पेड़ की गहराई और प्रशिक्षण डेटा पर उसके फिट की गुणवत्ता के बीच संतुलन बनाता है।
आप $\alpha$ चुनने के लिए K-fold cross-validation का उपयोग कर सकते हैं। इस तकनीक में प्रशिक्षण प्रेक्षणों को K फोल्ड में बांटकर सबट्रीज़ की टेस्ट एरर दर का अनुमान लगाया जाता है। आपका लक्ष्य उस मान का चयन करना है जो न्यूनतम एरर दर देता है।
Classification Trees
Classification tree रिग्रेशन ट्री से बहुत मिलता-जुलता है, सिवाय इसके कि यह मात्रात्मक प्रतिक्रिया के बजाय गुणात्मक प्रतिक्रिया का पूर्वानुमान करता है।
याद कीजिए कि रिग्रेशन ट्री में किसी प्रेक्षण के लिए भविष्यवाणी उस टर्मिनल नोड में आने वाले प्रशिक्षण प्रेक्षणों की औसत प्रतिक्रिया से दी जाती है। इसके विपरीत, क्लासिफिकेशन ट्री में, आप यह भविष्यवाणी करते हैं कि प्रत्येक प्रेक्षण उस क्षेत्र में सबसे अधिक बार आने वाली श्रेणी से संबंधित है जिसमें वह आता है।
क्लासिफिकेशन ट्री के परिणामों की व्याख्या करते समय, आप अक्सर किसी विशेष टर्मिनल नोड क्षेत्र के अनुरूप श्रेणी की भविष्यवाणी के साथ-साथ उस क्षेत्र में आने वाले प्रशिक्षण प्रेक्षणों में श्रेणियों के अनुपात में भी रुचि रखते हैं।
क्लासिफिकेशन ट्री को उगाने का कार्य रिग्रेशन ट्री को उगाने के कार्य से काफी मिलता-जुलता है। रिग्रेशन की तरह ही, आप क्लासिफिकेशन ट्री को उगाने के लिए recursive binary splitting का उपयोग करते हैं। हालांकि, क्लासिफिकेशन में Residual Sum of Squares का उपयोग बाइनरी स्प्लिट्स के मानदंड के रूप में नहीं किया जा सकता। इसके बजाय, आप नीचे दिए गए 3 तरीकों में से किसी का उपयोग कर सकते हैं:
- Classification Error Rate: रिग्रेशन में जहां हम देखते हैं कि कोई संख्यात्मक प्रतिक्रिया औसत मान से कितनी दूर है, उसके बजाय आप "हिट रेट" को किसी विशेष क्षेत्र में सबसे अधिक आने वाली श्रेणी से संबंधित न होने वाले प्रशिक्षण प्रेक्षणों के अंश के रूप में परिभाषित कर सकते हैं। त्रुटि इस समीकरण से दी जाती है:
E = 1 - argmaxc($\hat{\pi}_{mc}$)
जहाँ $\hat{\pi}_{mc}$ क्षेत्र Rm में श्रेणी c से संबंधित प्रशिक्षण डेटा का अंश दर्शाता है।
- Gini Index: Gini Index एक वैकल्पिक त्रुटि मेट्रिक है, जिसे किसी क्षेत्र की "शुद्धता" दिखाने के लिए बनाया गया है। यहाँ "शुद्धता" का अर्थ है कि किसी क्षेत्र में प्रशिक्षण डेटा कितना एक ही श्रेणी का है। यदि क्षेत्र Rm में अधिकतर डेटा किसी एकल श्रेणी c से है, तो Gini Index का मान छोटा होगा:
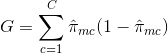
- Cross-Entropy: तीसरा विकल्प, जो Gini Index जैसा ही है, Cross-Entropy या Deviance के नाम से जाना जाता है:
यदि $\hat{\pi}_{mc}$ के मान सभी 0 या 1 के करीब हों, तो क्रॉस-एंट्रॉपी का मान शून्य के निकट होगा। इसलिए, Gini Index की तरह, यदि mवाँ नोड शुद्ध है तो क्रॉस-एंट्रॉपी का मान छोटा होगा। वस्तुतः, Gini Index और क्रॉस-एंट्रॉपी संख्यात्मक रूप से काफी समान निकलते हैं।
क्लासिफिकेशन ट्री बनाते समय, किसी विशेष स्प्लिट की गुणवत्ता का आकलन करने के लिए आमतौर पर Gini Index या क्रॉस-एंट्रॉपी का उपयोग किया जाता है, क्योंकि ये नोड की शुद्धता के प्रति क्लासिफिकेशन एरर रेट की तुलना में अधिक संवेदनशील हैं। ट्री को प्रून करते समय इन 3 में से कोई भी तरीका अपनाया जा सकता है, लेकिन यदि अंतिम प्रून्ड ट्री की भविष्यवाणी सटीकता लक्ष्य है तो क्लासिफिकेशन एरर रेट बेहतर माना जाता है।
डिसीजन ट्री के फायदे और नुकसान
जितना हम एल्गोरिदम और उसकी ताकतों को समझना चाहेंगे, उतना ही इसकी कमियों को समझना भी ज़रूरी है। सच्चाई यह है कि डिसीजन ट्री हर प्रकार के मशीन लर्निंग कार्यों के लिए सर्वश्रेष्ठ नहीं हैं—जैसा कि बाकी सभी एल्गोरिदम के साथ भी होता है।
यहाँ फायदे और नुकसान दिए गए हैं:
फायदे
- समझने और समझाने में आसान। डिसीजन ट्री अत्यधिक सहज होते हैं और इन्हें आसानी से विज़ुअलाइज़ किया जा सकता है। इनकी पदानुक्रमिक संरचना मानव निर्णय-निर्माण जैसी लगती है, जिससे ये गैर-विशेषज्ञों के लिए भी सुलभ हो जाते हैं। यह व्याख्येयता उन स्थितियों में महत्वपूर्ण है जहाँ निर्णय प्रक्रिया को समझना स्वयं भविष्यवाणी जितना ही महत्वपूर्ण है।
- सतत और श्रेणीबद्ध दोनों प्रकार के वेरिएबल्स को संभाल सकते हैं। डिसीजन ट्री बहुमुखी हैं और सतत व श्रेणीबद्ध फीचर्स के मिश्रण वाले डेटासेट्स के साथ-साथ दोनों प्रकार के लक्षित वेरिएबल्स को संभाल सकते हैं। यह लचीलापन डिसीजन ट्री को विभिन्न समस्याओं पर लागू करने योग्य बनाता है।
- न्यूनतम डेटा पूर्व-प्रसंस्करण आवश्यक। डिसीजन ट्री को फीचर स्केलिंग या नॉर्मलाइज़ेशन की आवश्यकता नहीं होती, क्योंकि ये मोनोटोनिक रूपांतरणों के प्रति अपरिवर्तित रहते हैं। ये missing values और आउट्लायर्स को भी आसानी से संभाल सकते हैं, जिससे ये कच्चे और शोरयुक्त डेटा के लिए उपयुक्त हैं।
- फीचर चयन और महत्वपूर्ण वेरिएबल्स की पहचान के लिए उपयोगी। डिसीजन ट्री स्वाभाविक रूप से डेटा को विभाजित करने के लिए सबसे सूचनात्मक फीचर्स चुनकर feature selection करते हैं। किसी फीचर का महत्व इस आधार पर आँका जा सकता है कि वह पेड़ में कितनी जल्दी दिखाई देता है और विभाजन के लिए कितनी बार उपयोग होता है।
नुकसान
- ओवरफिटिंग की प्रवृत्ति। जब डिसीजन ट्री बहुत गहरे हो जाते हैं, तो वे अत्यधिक जटिल होकर प्रशिक्षण डेटा पर ओवरफिट कर सकते हैं, जिसके परिणामस्वरूप अनदेखे डेटा पर सामान्यीकरण खराब होता है। प्रूनिंग या अधिकतम गहराई तय करने जैसी तकनीकें इस समस्या को कम कर सकती हैं।
- डेटा में छोटे बदलावों के प्रति संवेदनशील। प्रशिक्षण डेटा में छोटा-सा बदलाव पूरी तरह अलग ट्री संरचना दे सकता है, जिससे डिसीजन ट्री अस्थिर हो जाते हैं। बैगिंग, बूस्टिंग या रैंडम फॉरेस्ट जैसी एंसेंबल विधियाँ कई पेड़ बनाकर और उनके परिणामों को समेकित करके इस संवेदनशीलता को कम करती हैं।
- अक्सर अन्य मशीन लर्निंग तरीकों जितने सटीक नहीं। सरलता और निर्माण की ग्रीडी प्रकृति के कारण, डिसीजन ट्री हमेशा सबसे सटीक मॉडल नहीं देते। फिर भी, ये तुलना हेतु एक अच्छा प्रारम्भिक या बेसलाइन मॉडल हो सकते हैं।
- प्रभुत्वशाली श्रेणियों की ओर पक्षपाती। असंतुलित डेटासेट्स में डिसीजन ट्री बहुसंख्यक श्रेणी की ओर पक्षपाती हो सकते हैं, जिससे उप-इष्टतम विभाजन और अल्पसंख्यक उदाहरणों की गलत वर्गीकरण हो सकती है। ओवरसैंपलिंग, अंडरसैंपलिंग या कॉस्ट-सेंसिटिव लर्निंग जैसी तकनीकें इसका समाधान कर सकती हैं।
इन कमियों के बावजूद, डिसीजन ट्री अपनी सरलता, व्याख्येयता और बहुमुखी प्रतिभा के कारण कई अनुप्रयोगों में लोकप्रिय विकल्प बने हुए हैं।
उन्नत ट्री-आधारित मशीन लर्निंग एल्गोरिदम
आइए ट्री-आधारित एंसेंबल विधियों का अन्वेषण करें जो डिसीजन ट्री की ताकतों का लाभ उठाते हुए उनकी कुछ सीमाओं को संबोधित करती हैं: बैगिंग, बूस्टिंग और रैंडम फॉरेस्ट।
Bagging
ऊपर चर्चा किए गए डिसीजन ट्रीज़ में उच्च विचरण की समस्या होती है, यानी यदि आप प्रशिक्षण डेटा को यादृच्छिक रूप से 2 भागों में बाँट दें और दोनों आधों पर डिसीजन ट्री फिट करें, तो परिणाम काफी अलग हो सकते हैं। इसके विपरीत, निम्न विचरण वाली प्रक्रिया अलग-अलग डेटासेट पर बार-बार लागू करने पर समान परिणाम देगी।
Bagging, या bootstrap aggregation, कई क्लासिफ़ायर्स के परिणामों को संयोजित करके, जो एक ही डेटासेट के अलग-अलग उप-नमूनों पर मॉडल किए गए हों, आपकी भविष्यवाणियों के विचरण को कम करने की तकनीक है। बैगिंग का समीकरण यह है:
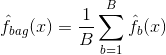
जिसमें आप $B$ अलग-अलग बूटस्ट्रैप्ड प्रशिक्षण डेटासेट बनाते हैं। फिर आप $bth$ बूटस्ट्रैप्ड प्रशिक्षण सेट पर अपना विधि-आधारित मॉडल ट्रेन करके $\hat{f}_{b}(x)$ प्राप्त करते हैं, और अंत में भविष्यवाणियों का औसत लेते हैं।
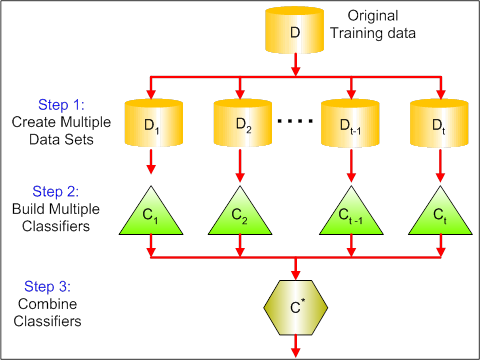
नीचे दिया गया दृश्य बैगिंग के 3 अलग-अलग चरण दिखाता है:
-
चरण 1: यहाँ आप मूल डेटा को नए डेटा से प्रतिस्थापित करते हैं। नए डेटा में आमतौर पर मूल डेटा के कॉलमों और पंक्तियों का एक अंश होता है, जिन्हें बैगिंग मॉडल में हाइपर-पैरामीटर्स के रूप में भी उपयोग किया जा सकता है।
-
चरण 2: आप प्रत्येक डेटासेट पर क्लासिफ़ायर्स बनाते हैं। सामान्यतः, आप मॉडलिंग और भविष्यवाणी के लिए एक ही क्लासिफ़ायर का उपयोग कर सकते हैं।
-
चरण 3: अंत में, समस्या के अनुसार, आप सभी क्लासिफ़ायर्स की भविष्यवाणियों को संयोजित करने के लिए औसत मान का उपयोग करते हैं। आम तौर पर, ये संयुक्त मान एकल मॉडल से अधिक सुदृढ़ होते हैं।
हालाँकि बैगिंग कई रिग्रेशन और क्लासिफिकेशन तरीकों की भविष्यवाणियों में सुधार कर सकता है, यह विशेष रूप से डिसीजन ट्रीज़ के लिए उपयोगी है। रिग्रेशन/क्लासिफिकेशन ट्रीज़ पर बैगिंग लागू करने के लिए, आप $B$ बूटस्ट्रैप्ड प्रशिक्षण सेटों का उपयोग करके $B$ रिग्रेशन/क्लासिफिकेशन ट्री बनाते हैं और परिणामस्वरूप भविष्यवाणियों का औसत लेते हैं। ये ट्री गहराई तक उगाए जाते हैं और प्रून नहीं किए जाते। इसलिए प्रत्येक व्यक्तिगत ट्री का विचरण उच्च, लेकिन बायस निम्न होता है। इन $B$ ट्रीज़ का औसत लेने से विचरण कम हो जाता है।
व्यापक रूप से, बैगिंग ने सैकड़ों या हजारों ट्रीज़ को एकल प्रक्रिया में जोड़कर सटीकता में प्रभावशाली सुधार दिखाए हैं।
Random Forests
Random Forests एक बहुमुखी मशीन लर्निंग विधि है जो रिग्रेशन और क्लासिफिकेशन दोनों कार्य कर सकती है। यह आयामीयता घटाने की विधियों को भी अपनाती है, missing values और आउट्लायर को संभालती है, तथा डेटा अन्वेषण के अन्य आवश्यक कदम उठाती है—और यह सब काफ़ी प्रभावी ढंग से करती है।
Random Forests बैग्ड ट्रीज़ में एक छोटा-सा बदलाव करके सुधार लाता है जो ट्रीज़ को डि-कोरिलेट करता है। बैगिंग की तरह, आप बूटस्ट्रैप्ड प्रशिक्षण सैंपल्स पर कई डिसीजन ट्री बनाते हैं। लेकिन इन ट्रीज़ का निर्माण करते समय, जब भी किसी स्प्लिट पर विचार किया जाता है, $p$ प्रेडिक्टर्स के पूरे सेट में से m प्रेडिक्टर्स का एक रैंडम सैंपल स्प्लिट उम्मीदवारों के रूप में चुना जाता है। स्प्लिट इन्हीं $m$ प्रेडिक्टर्स में से किसी एक का ही उपयोग कर सकता है। यही रैंडम फॉरेस्ट और बैगिंग के बीच मुख्य अंतर है; क्योंकि बैगिंग में प्रेडिक्टर्स की पसंद $m = p$ होती है।
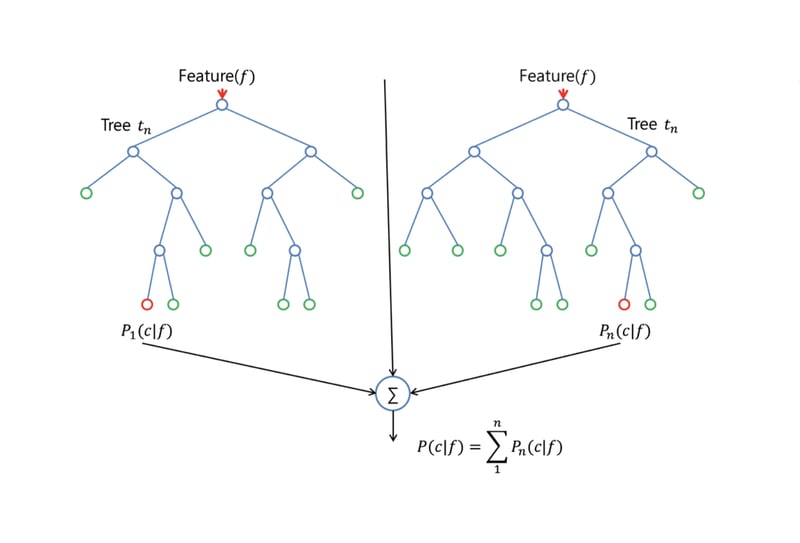
एक रैंडम फॉरेस्ट उगाने के लिए, आपको चाहिए:
-
पहले मान लीजिए प्रशिक्षण सेट में मामलों की संख्या K है। फिर इन्हीं K मामलों का एक यादृच्छिक सैंपल लें, और इस सैंपल को ट्री उगाने के लिए प्रशिक्षण सेट के रूप में उपयोग करें।
-
यदि $p$ इनपुट वेरिएबल्स हैं, तो ऐसा $m < p$ निर्दिष्ट करें कि प्रत्येक नोड पर आप $p$ में से $m$ रैंडम वेरिएबल्स चुन सकें। नोड को स्प्लिट करने के लिए इन्हीं $m$ पर सबसे अच्छा स्प्लिट उपयोग किया जाता है।
-
प्रत्येक ट्री को बाद में यथासंभव अधिकतम सीमा तक उगाया जाता है और प्रूनिंग की आवश्यकता नहीं होती।
-
अंत में, नए डेटा की भविष्यवाणी के लिए लक्ष्य ट्रीज़ की भविष्यवाणियों का समेकन करें।
Random Forests missing data का अनुमान लगाने में बहुत प्रभावी है और तब भी सटीकता बनाए रख सकती है जब डेटा का बड़ा हिस्सा गायब हो। यह असंतुलित कक्षाओं वाले डेटासेट्स में त्रुटियों को संतुलित भी कर सकती है। सबसे महत्वपूर्ण, यह बड़े आयामों वाले विशाल डेटासेट संभाल सकती है। हालाँकि, Random Forests का एक नुकसान यह है कि आप शोरयुक्त डेटासेट्स पर, विशेष रूप से रिग्रेशन के मामले में, आसानी से ओवरफिट कर सकते हैं।
Boosting
Boosting डिसीजन ट्री से प्राप्त भविष्यवाणियों में सुधार करने का एक और तरीका है। बैगिंग और रैंडम फॉरेस्ट की तरह, यह एक सामान्य दृष्टिकोण है जिसे रिग्रेशन या क्लासिफिकेशन के लिए कई सांख्यिकीय लर्निंग तरीकों पर लागू किया जा सकता है। याद कीजिए कि बैगिंग में बूटस्ट्रैप का उपयोग करके मूल प्रशिक्षण डेटासेट की कई प्रतियाँ बनाना, प्रत्येक प्रति पर अलग डिसीजन ट्री फिट करना, और फिर सभी ट्रीज़ को मिलाकर एकल भविष्यसूचक मॉडल बनाना शामिल है। खास बात यह है कि प्रत्येक ट्री को अन्य ट्रीज़ से स्वतंत्र किसी बूटस्ट्रैप्ड डेटासेट पर बनाया जाता है।
बूस्टिंग भी इसी तरह काम करता है, सिवाय इसके कि ट्रीज़ क्रमशः उगाए जाते हैं: प्रत्येक ट्री पहले से उगाए गए ट्रीज़ की जानकारी का उपयोग करके उगता है। बूस्टिंग में बूटस्ट्रैप सैंपलिंग शामिल नहीं होती; इसके बजाय, प्रत्येक ट्री को मूल डेटासेट के संशोधित संस्करण पर फिट किया जाता है।
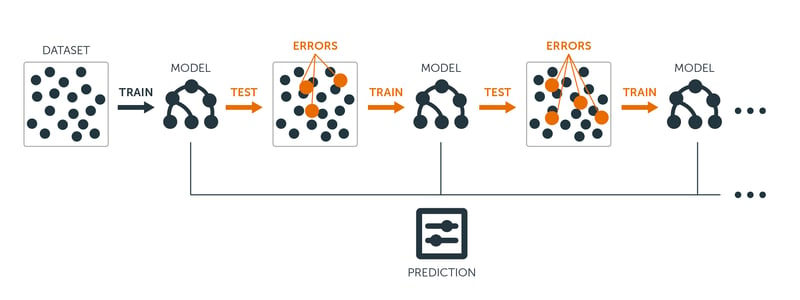
रिग्रेशन और क्लासिफिकेशन ट्री—दोनों के लिए, बूस्टिंग इस प्रकार काम करता है:
-
डेटा पर एक बड़ा डिसीजन ट्री फिट करने के विपरीत, जो डेटा को कड़ा फिट करके ओवरफिटिंग करा सकता है, बूस्टिंग दृष्टिकोण धीरे-धीरे सीखता है।
-
वर्तमान मॉडल को मानते हुए, आप मॉडल के रिज़िडुअल्स पर एक डिसीजन ट्री फिट करते हैं। यानी आप $Y$ परिणाम के बजाय वर्तमान रिज़िडुअल्स को प्रतिक्रिया मानकर ट्री फिट करते हैं।
-
फिर आप इस नए डिसीजन ट्री को फिटेड फंक्शन में जोड़कर रिज़िडुअल्स को अपडेट करते हैं। इनमें से प्रत्येक ट्री काफी छोटा हो सकता है, केवल कुछ टर्मिनल नोड्स के साथ, जिसका निर्धारण एल्गोरिदम के पैरामीटर $d$ से होता है। रिज़िडुअल्स पर छोटे ट्री फिट करके, आप उन क्षेत्रों में $\hat{f}$ में धीरे-धीरे सुधार करते हैं जहाँ यह अच्छा प्रदर्शन नहीं करता।
-
श्रिंकेज पैरामीटर $\nu$ प्रक्रिया को और धीमा कर देता है, जिससे अधिक और अलग आकार के ट्रीज़ को रिज़िडुअल्स पर काम करने का अवसर मिलता है।
जब आपके पास बहुत सारा डेटा हो और आप अपेक्षा करते हों कि डिसीजन ट्री बहुत जटिल होंगे, तब बूस्टिंग बहुत उपयोगी है। जोखिम विश्लेषण, भावना विश्लेषण, प्रेडिक्टिव विज्ञापन, मूल्य मॉडलिंग, बिक्री अनुमान और रोगी निदान सहित कई चुनौतीपूर्ण क्लासिफिकेशन और रिग्रेशन समस्याओं को सुलझाने में बूस्टिंग का उपयोग किया गया है।
मूल रूप से ये एल्गोरिदम कई डिसीजन ट्री की भविष्यवाणियों को मिलाकर समग्र प्रदर्शन और स्थिरता में सुधार करते हैं। उन्नत एल्गोरिदम समझ लेने के बाद, इस ट्यूटोरियल के दायरे में, हम सरल डिसीजन ट्री मॉडलों के साथ आगे बढ़ेंगे।
R में चरण-दर-चरण डिसीजन ट्री मॉडल बनाना
हमने डिसीजन ट्री मॉडलों और उनके रूपांतरों के पीछे काफी सिद्धांत और अंतर्ज्ञान सीखा, लेकिन हाथ से काम करना—मॉडल बनाना और चरण-दर-चरण उनके प्रदर्शन का मूल्यांकन करना—सबसे बेहतर है।
मॉडलिंग के लिए डेटा तैयार करना
आगे के उदाहरणों के लिए, हम लोकप्रिय Boston Housing Dataset का उपयोग करेंगे।
Boston Housing डेटासेट में 1970 के दशक में मैसाचुसेट्स के बोस्टन के आवास बाज़ार की जानकारी है। इसमें 506 प्रेक्षण और 14 वेरिएबल्स हैं, जिनमें 13 फीचर्स और 1 टारगेट वेरिएबल शामिल है।
Boston Housing डेटासेट के फीचर्स ये हैं:
- CRIM: प्रति व्यक्ति अपराध दर (टाउन के अनुसार)
- ZN: उन आवासीय भूमि का अनुपात जो 25,000 वर्ग फुट से बड़े प्लॉट के लिए ज़ोन की गई हैं
- INDUS: प्रति टाउन गैर-खुदरा व्यावसायिक एकड़ों का अनुपात
- CHAS: चार्ल्स नदी डमी वेरिएबल (= 1 यदि ट्रैक्ट नदी से सटा है; अन्यथा 0)
- NOX: नाइट्रिक ऑक्साइड की सांद्रता (प्रति 10 मिलियन भाग)
- RM: प्रति आवास औसत कमरों की संख्या
- AGE: 1940 से पहले बने मालिक-आबाद यूनिट्स का अनुपात
- DIS: बोस्टन के पाँच रोजगार केंद्रों तक भारित दूरी
- RAD: रेडियल हाईवे तक पहुँच का सूचकांक
- TAX: प्रति $10,000 पूर्ण-मूल्य संपत्ति कर की दर
- PTRATIO: टाउन के अनुसार छात्र-शिक्षक अनुपात
- Black: टाउन के अनुसार अश्वेत आबादी का अनुपात
- LSTAT: निम्न सामाजिक-आर्थिक स्थिति वाली आबादी का प्रतिशत
टारगेट वेरिएबल MEDV है, जो मालिक-आबाद घरों के माध्य मान को $1000s में दर्शाता है।
लक्ष्य यह है कि दिए गए फीचर्स के आधार पर मालिक-आबाद घरों के माध्य मान (हज़ार डॉलर में) का पूर्वानुमान किया जाए।
R में, यह डेटा “MASS” नामक पैकेज में उपलब्ध है। इस ट्यूटोरियल के लिए आपको कई पैकेज इंस्टॉल और लोड करने होंगे। दोहराव से बचने के लिए, चलिए MASS पैकेज के साथ यह प्रक्रिया एक बार दिखाते हैं, और जब भी इस गाइड में कोई नया पैकेज दिखे, आप इसे दोहराएँगे।
# install the package
install.packages("MASS")
# Load the MASS package
library(MASS)
# Load the Boston Housing dataset
data(Boston)मॉडलिंग पर जाने से पहले अक्सर विज़ुअलाइज़ेशन के जरिए डेटा का अन्वेषण करना और डेटा प्री-प्रोसेसिंग चरण करना आवश्यक होता है। आइए हिस्टोग्राम्स के माध्यम से वेरिएबल्स के वितरण पर एक नज़र डालें।
इन्हें बनाने का कोड यह है:
# Load the library
library(tidymodels)
library(tidyr)
# Prepare the dataset for ggplot2
boston_data_long <- Boston %>%
pivot_longer(cols = everything(),
names_to = "variable",
values_to = "value")
# Create a histogram for all numeric variables in one plot
boston_histograms <- ggplot(boston_data_long, aes(x = value)) +
geom_histogram(bins = 30, color = "black", fill = "lightblue") +
facet_wrap(~variable, scales = "free", ncol = 4) +
labs(title = "Histograms of Numeric Variables in the Boston Housing Dataset",
x = "Value",
y = "Frequency") +
theme_minimal()
# Plot the histograms
print(boston_histograms)और आउटपुट कुछ ऐसा दिखाई देगा:
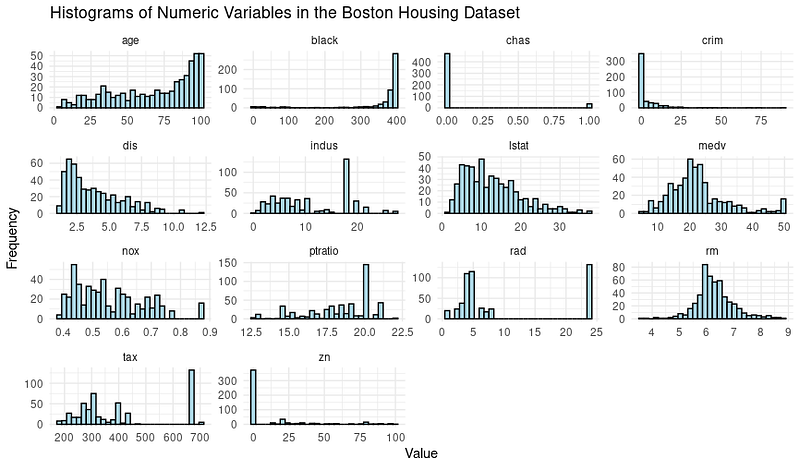
हम कुछ आउट्लायर्स देखते हैं, खासकर RAD, TAX और NOX जैसे कॉलमों में। इस ट्यूटोरियल का हमारा लक्ष्य डिसीजन ट्री मॉडलिंग चरण पर ध्यान केंद्रित करना है; अतः डेटासेट को प्रशिक्षण और परीक्षण सेटों में विभाजित करते हैं।
# Split the data into training and testing sets
set.seed(123)
data_split <- initial_split(Boston, prop = 0.75)
train_data <- training(data_split)
test_data <- testing(data_split)अब मॉडलिंग और मॉडल प्रदर्शन के मूल्यांकन में उतरते हैं।
सरल डिसीजन ट्री मॉडलिंग
R में Tidymodels पैकेज की decision_tree() फ़ंक्शन का उपयोग करके, पहले डिसीजन ट्री का मॉडल विनिर्देश बनाना और फिर प्रशिक्षण डेटा पर मॉडल फिट करना सरल है।
# Create a decision tree model specification
tree_spec <- decision_tree() %>%
set_engine("rpart") %>%
set_mode("regression")
# Fit the model to the training data
tree_fit <- tree_spec %>%
fit(medv ~ ., data = train_data)हम यहाँ “regression” मोड का उपयोग करते हैं, और यदि क्लासिफिकेशन डिसीजन ट्री चाहिए, तो “classification” मोड का उपयोग करना होगा।
डिसीजन ट्री मॉडलिंग प्रदर्शन का मूल्यांकन
मॉडल के प्रदर्शन का आकलन करने के लिए, हम Tidymodels पैकेज का उपयोग करके टेस्टिंग डेटा पर अपने डिसीजन ट्री मॉडल के लिए रूट मीन स्क्वेयर्ड एरर (RMSE) और R-squared मान की गणना करेंगे।
# Make predictions on the testing data
predictions <- tree_fit %>%
predict(test_data) %>%
pull(.pred)
# Calculate RMSE and R-squared
metrics <- metric_set(rmse, rsq)
model_performance <- test_data %>%
mutate(predictions = predictions) %>%
metrics(truth = medv, estimate = predictions)
print(model_performance)आपको आउटपुट में दो प्रदर्शन मेट्रिक्स मिलेंगे: रूट मीन स्क्वेयर्ड एरर (RMSE) और R-squared (R²)।
.metric .estimator .estimate
<chr> <chr> <dbl>
1 rmse standard 5.22
2 rsq standard 0.689मॉडल परिणामों का विश्लेषण
तो, क्या हमारे मॉडल के परिणाम पर्याप्त अच्छे हैं?
- RMSE (रूट मीन स्क्वेयर्ड एरर): यह भविष्यवाणी और वास्तविक मानों के बीच औसत अंतर को मापता है। आपके मामले में, RMSE 5.22 है, जिसका अर्थ है कि औसतन, डिसीजन ट्री मॉडल द्वारा की गई भविष्यवाणियाँ वास्तविक मानों से लगभग 5.22 यूनिट दूर हैं। सामान्यतः कम RMSE बेहतर होता है, क्योंकि यह छोटे पूर्वानुमान त्रुटियों को दर्शाता है।
- R-squared (R²): यह मापता है कि मॉडल लक्ष्य वेरिएबल में विभेद को कितनी अच्छी तरह समझाता है। यह 0 से 1 के बीच होता है, और अधिक मान बेहतर फिट को सूचित करता है। आपके मामले में, R² 0.689 है, यानी मॉडल लक्ष्य वेरिएबल (MEDV) के लगभग 68.9% विभेद को समझाता है।
हम हाइपर-पैरामीटर्स को अनुकूलित कर प्रदर्शन और निचोड़ सकते हैं, या मॉडल की व्याख्येयता की कीमत पर Random Forests और XGBoost जैसे अधिक जटिल मॉडलों पर जा सकते हैं।
डिसीजन ट्री मॉडल का उपयोग करके परिणामों की भविष्यवाणी
जब आप मॉडल से संतुष्ट हों, तो अब मॉडल से भविष्यवाणी कराने का समय है।
यह वही है जैसा हमने टेस्ट डेटा के साथ predict() फ़ंक्शन से किया था, लेकिन यहाँ हमें बोस्टन के किसी नए घर की जानकारी का अनुकरण करते हुए एक नए डेटा सेट की आपूर्ति करनी होगी। यह वह संभावित परिदृश्य है जब मॉडल प्रोडक्शन वातावरण में लाइव जाता है।
# Make predictions on new data
new_data <- tribble(
~crim, ~zn, ~indus, ~chas, ~nox, ~rm, ~age, ~dis, ~rad, ~tax, ~ptratio, ~black, ~lstat,
0.03237, 0, 2.18, 0, 0.458, 6.998, 45.8, 6.0622, 3, 222, 18.7, 394.63, 2.94
)
predictions <- predict(tree_fit, new_data)
print(predictions)और आपको इस विशेष घर का अनुमानित माध्य मान ($1000s में) मिलेगा:
# A tibble: 1 × 1
.pred
<dbl>
1 37.8इसके साथ, आप डिसीजन ट्री मॉडल बनाने के चरणों से लैस हैं—अब ध्यान दें कि हम अपने लिए और उन स्टेकहोल्डर्स के लिए, जो हमारे बनाए समाधान का उपयोग करते हैं, मॉडल के अंदर क्या हो रहा है, इसे कैसे समझ सकते हैं।
डिसीजन ट्री की व्याख्या
जैसा कि हमने पहले कहा, सबसे बड़ा लाभ डिसीजन ट्री मॉडलों की व्याख्येयता है। मॉडल को बेहतर समझने के लिए डिसीजन ट्री को विज़ुअलाइज़ करें:
# Load the library
library(rpart.plot)
# Plot the decision tree
rpart.plot(tree_fit$fit, type = 4, extra = 101, under = TRUE, cex = 0.8, box.palette = "auto")आपको ऐसा प्लॉट दिखाई देगा:
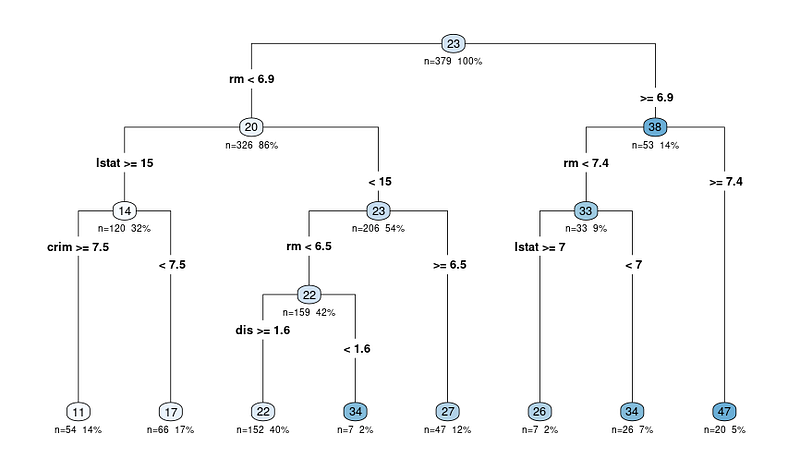
rpart.plot फ़ंक्शन का आउटपुट आरेख मॉडल के डिसीजन ट्री का निरूपण दिखाता है। इस आरेख में प्रत्येक नोड प्रेडिक्टर वेरिएबल्स के आधार पर डिसीजन ट्री में एक स्प्लिट का प्रतिनिधित्व करता है। आउटपुट आरेख में कई सूचनाएँ शामिल होती हैं जो हमें डिसीजन ट्री की व्याख्या में मदद करती हैं:
ट्री आरेख नोड से शुरू होते हैं
नोड्स वृत्तों द्वारा दर्शाए जाते हैं और रेखाओं से जुड़े होते हैं, जो डिसीजन ट्री की पदानुक्रमिक संरचना दिखाते हैं। ट्री शीर्ष पर रूट नोड से शुरू होता है, और यह आंतरिक नोड्स में शाखित होता हुआ अंत में निचले हिस्से में टर्मिनल नोड्स या पत्तियों तक पहुँचता है।
प्रत्येक आंतरिक नोड के लिए विभाजन का मानदंड
हर आंतरिक नोड पर विभाजन मानदंड दिखता है, यानी वह प्रेडिक्टर वेरिएबल और मान जिससे डेटा को दो उपसमूहों में विभाजित किया गया।
उदाहरण के लिए, किसी नोड पर “RM < 6.8” दिख सकता है, जो दर्शाता है कि जिन प्रेक्षणों में प्रति आवास औसत कमरों की संख्या (RM) 6.8 से कम है, वे बाएँ शाखा पर जाएँगे, जबकि जिनमें RM 6.8 या उससे अधिक है, वे दाएँ शाखा पर जाएँगे।
N: विभाजन के बाद प्रेक्षणों की संख्या
n मान हर नोड में उस डेटासेट के प्रेक्षणों की संख्या दर्शाता है जो उस विशेष नोड में आते हैं। उदाहरण के लिए, यदि किसी नोड पर "n = 100" दिखता है, तो इसका अर्थ है कि डेटासेट के 100 प्रेक्षण उस नोड के पैरेंट नोड्स के मानदंडों को पूरा करते हैं।
X%: कुल डेटासेट के उस हिस्से का अनुपात जो उस विशेष नोड तक पहुँचा
यह प्रतिशत आपको प्रत्येक नोड के सापेक्ष आकार को पूरे डेटासेट की तुलना में समझने में मदद करता है, दर्शाता है कि कैसे डेटा ट्री में विभाजित और वितरित हो रहा है। उच्च प्रतिशत का अर्थ है कि अधिक डेटा उस विशेष नोड तक पहुँचने वाले निर्णय पथ का अनुसरण करता है, जबकि कम प्रतिशत का अर्थ छोटा अनुपात है।
प्रत्येक नोड के लिए पूर्वानुमानित मान
हर नोड पर पूर्वानुमानित मान रंगीन वृत्त (नोड) में एक संख्या के रूप में दिखता है। रिग्रेशन ट्री में, यह उस नोड में आने वाले सभी प्रेक्षणों के लिए लक्षित वेरिएबल का औसत मान होता है।
उदाहरण के लिए, अंतिम पत्ती नोड पर 47 दिखने का अर्थ है कि उस नोड के सभी प्रेक्षणों के लिए लक्षित वेरिएबल (हमारे मामले में, मालिक-आबाद घरों का माध्य मान) 47 है।
रूट नोड से शुरू करें और शाखाओं का अनुसरण करें
अतः किसी भी परिणाम की व्याख्या करते समय, आप रूट नोड से शुरू करते हैं और विभाजन मानदंड के आधार पर शाखाओं का अनुसरण करते हुए टर्मिनल नोड तक पहुँचते हैं। टर्मिनल नोड में दिए गए पूर्वानुमानित मान से उस प्रेक्षण के लिए मॉडल की भविष्यवाणी और उसके पीछे का तर्क मिलता है।
डिसीजन ट्री से नियम निकालना
यदि आप अभी भी नियमों को टेक्स्ट रूप में निकालना पसंद करते हैं (आरेख में घूमने के बजाय)—तो यह भी संभव है, उसी लाइब्रेरी का उपयोग करके जिससे हमने आरेख प्लॉट किया था।
इसे करने का कोड यह है:
rules <- rpart.rules(tree_fit$fit)
print(rules)और आपको नीचे दिखाए अनुसार अनुमानित मानों और उन नियमों वाला आउटपुट दिखेगा, जिनका पालन करके वह मान प्राप्त हुआ:
medv
11 when rm < 6.9 & lstat >= 15 & crim >= 7.5
17 when rm < 6.9 & lstat >= 15 & crim < 7.5
22 when rm < 6.5 & lstat < 15 & dis >= 1.6
26 when rm is 6.9 to 7.4 & lstat >= 7
27 when rm is 6.5 to 6.9 & lstat < 15
34 when rm < 6.5 & lstat < 15 & dis < 1.6
34 when rm is 6.9 to 7.4 & lstat < 7
47 when rm >= 7.4अब जब आपने नियम देख लिए, तो आप सोच सकते हैं कि जब हम डिसीजन ट्री को कई वेरिएबल्स देते हैं तो केवल 3–4 वेरिएबल्स से ही निर्णय कैसे लिया जा रहा है।
असल में, कुछ वेरिएबल्स बाकी की तुलना में अधिक महत्वपूर्ण होते हैं। आइए इस अवधारणा को बेहतर समझें।
डिसीजन ट्री से महत्वपूर्ण वेरिएबल्स को समझना
हमने ट्री आरेख और मॉडल के काम करने के तरीके को देख लिया है। व्याख्या का एक अंतिम पहलू डेटासेट से महत्वपूर्ण वेरिएबल्स को समझना है।
यह क्यों महत्वपूर्ण है, इसके कारण:
- फीचर चयन। महत्वपूर्ण वेरिएबल्स की पहचान करने से आप प्रासंगिक फीचर्स पर ध्यान केंद्रित कर सकते हैं और कम महत्वपूर्ण को हटाकर अपने मॉडल को सरल बना सकते हैं और शोर को कम कर सकते हैं।
- डोमेन ज्ञान। कौन-से फीचर्स सबसे अधिक महत्वपूर्ण हैं, इस पर अंतर्दृष्टि मिलना आपके विशेष समस्या के संदर्भ में वेरिएबल्स और लक्ष्य वेरिएबल के बीच संबंधों को बेहतर समझने में मदद कर सकता है।
- मॉडल व्याख्या। मॉडल की भविष्यवाणियों को संचालित करने वाले प्रमुख फीचर्स को समझने से निर्णय-निर्माण प्रक्रिया पर मूल्यवान अंतर्दृष्टि मिलती है।
डिसीजन ट्री में, वेरिएबल महत्त्व आमतौर पर उन फीचर्स से निर्धारित होता है जिनका उपयोग नोड्स पर विभाजन के लिए किया जाता है। जो फीचर्स ट्री के ऊपर की ओर विभाजन के लिए उपयोग होते हैं या अधिक बार उपयोग होते हैं, वे अधिक महत्वपूर्ण माने जा सकते हैं।
किसी वेरिएबल का महत्व उस अशुद्धि माप (जैसे, Gini Index या mean squared error) में लाई गई कमी से मापा जा सकता है जब उसका उपयोग विभाजन के लिए किया जाता है। R में “VIP” पैकेज ने सारी जटिलताओं को सुलझा दिया है, और नीचे दिए गए कोड से प्लॉट प्राप्त किया जा सकता है:
# Load the necessary library
library(vip)
# Create a variable importance plot
var_importance <- vip::vip(tree_fit, num_features = 10)
print(var_importance)और आपको नीचे वेरिएबल इम्पॉर्टेंस प्लॉट दिखाई देगा:
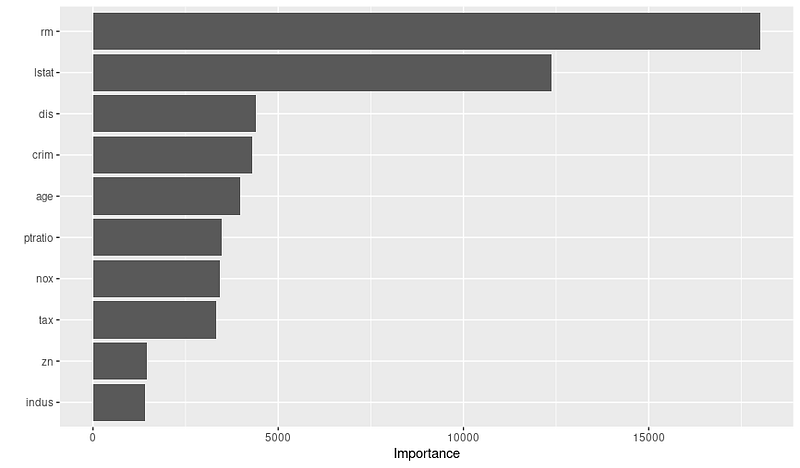
प्लॉट देखने के बाद, आप यह शोध आगे बढ़ा सकते हैं कि ये वेरिएबल्स क्यों महत्वपूर्ण हैं, और डोमेन विशेषज्ञों के साथ सहयोग कर सकते हैं। उदाहरण के लिए, ऊपर दिए गए प्लॉट के आधार पर, हम शीर्ष 3 महत्वपूर्ण वेरिएबल्स और उनके तर्क का अनुमान लगा सकते हैं:
- RM: प्रति आवास औसत कमरों की संख्या अत्यधिक महत्वपूर्ण फीचर है, यह बताता है कि अधिक कमरों वाले घरों का माध्य मान अधिक होता है।
- LSTAT: निम्न सामाजिक-आर्थिक स्थिति वाली आबादी का प्रतिशत एक और महत्वपूर्ण वेरिएबल है, जो संकेत देता है कि निम्न-स्थिति वाले पड़ोसों में माध्य घर मूल्य कम होने की संभावना है।
- DIS: रोजगार केंद्रों तक भारित दूरी एक अहम वेरिएबल है, जो दिखाता है कि प्रमुख रोजगार केंद्रों के निकट स्थित घरों के माध्य मान अधिक होने की संभावना है।
तो अपने मॉडल को अंतिम रूप देने से पहले वेरिएबल इम्पॉर्टेंस प्लॉट ज़रूर देखें; इससे आप बेहतर फीचर्स बना और चुनकर प्रदर्शन को अनुकूलित कर सकते हैं।
निष्कर्ष
इस ट्यूटोरियल में, हमने डिसीजन ट्री की मूलभूत अवधारणाओं का अन्वेषण किया और केवल मॉडल बनाना ही नहीं, बल्कि उनकी व्याख्या करना भी सीखा। डिसीजन ट्री क्लासिफिकेशन और रिग्रेशन—दोनों कार्यों के लिए शक्तिशाली और व्याख्येय मॉडल हैं, जो किसी भी डेटा साइंटिस्ट के टूलकिट में आवश्यक उपकरण बनाते हैं।
जैसे-जैसे आप अपनी क्षमताएँ विकसित करते जाएँ, हम आपको डिसीजन ट्री की दुनिया में और गहराई से उतरने, वैकल्पिक एल्गोरिदम का अन्वेषण करने, और अपनी R प्रोग्रामिंग कौशल को निखारने के लिए प्रोत्साहित करते हैं। अगले कदम के लिए कुछ संसाधन यहाँ हैं:
- Machine Learning Fundamentals in R
- Introduction to Feature Engineering in R
- Modelling with Tidymodels in R
- Machine Learning with Tree-based Models in R
निस्संदेह, अपने ज्ञान का विस्तार करना और नए टूल्स व तकनीकों के साथ प्रयोग करना आपको विविध चुनौतियों का सामना करने और अपने प्रोजेक्ट्स में मूल्यवान अंतर्दृष्टि देने में सक्षम बनाएगा।