Cursus
Introductie tot R
4 uur
3.1M

Stel je voor dat je door een doolhof navigeert. Bij elke stap neem je een beslissing die je dichter bij de uitgang of dieper het labyrint in brengt. Dat lijkt op een beslisboomalgoritme: een krachtig en intuïtief machinelearning‑methode die ons helpt complexe data te begrijpen en de beste koers te kiezen.
Een beslisboomalgoritme splitst een dataset stap voor stap in kleinere subsets op basis van bepaalde voorwaarden. Net als een vertakkende boom met bladeren en knooppunten begint het met één wortelknooppunt en vertakt het zich in meerdere takken, die elk een beslissing op basis van de waarde van een feature voorstellen. De uiteindelijke bladeren van de boom zijn de mogelijke uitkomsten of voorspellingen.
Dit artikel introduceert je in de wereld van beslisbomen met de programmeertaal R. We bespreken de basis, gaan in op populaire soorten beslisboomalgoritmen, verkennen boomgebaseerde methoden en nemen je mee door een stapsgewijs voorbeeld. Aan het eind kun je de kracht van beslisbomen benutten om betere datagedreven beslissingen te nemen.
Beslisbomen zijn bijzonder in machine learning vanwege hun eenvoud, uitlegbaarheid en veelzijdigheid.
Het is een supervised machinelearning‑algoritme dat kan worden gebruikt voor zowel regressie (voorspellen van continue waarden) als classificatie (voorspellen van categorische waarden). Bovendien vormen ze de basis voor geavanceerdere technieken zoals bagging, boosting en random forests.
Het diagram hieronder illustreert de terminologie achter beslisbomen:
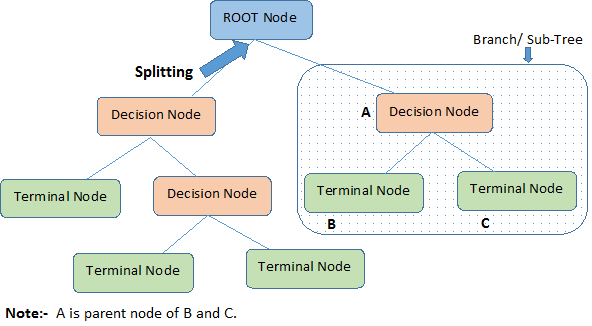
Een beslisboom begint met een wortelknooppunt dat de gehele populatie of steekproef weergeeft, en dat vervolgens wordt opgesplitst in twee of meer uniforme groepen via een methode die splitting heet. Wanneer subknooppunten verder worden opgedeeld, heten ze decision nodes, terwijl knooppunten die niet verder splitsen terminale knooppunten of bladeren worden genoemd. Een segment van een volledige boom wordt een tak genoemd.
We hebben vastgesteld dat beslisbomen kunnen worden gebruikt voor zowel regressie- als classificatietaken; laten we daarom het algoritme achter de typen beslisbomen begrijpen.
Laten we intuïtief begrijpen wat regressie- en classificatiebeslisbomen zijn, wat overeenkomt en verschilt, en welke foutfuncties worden gebruikt.
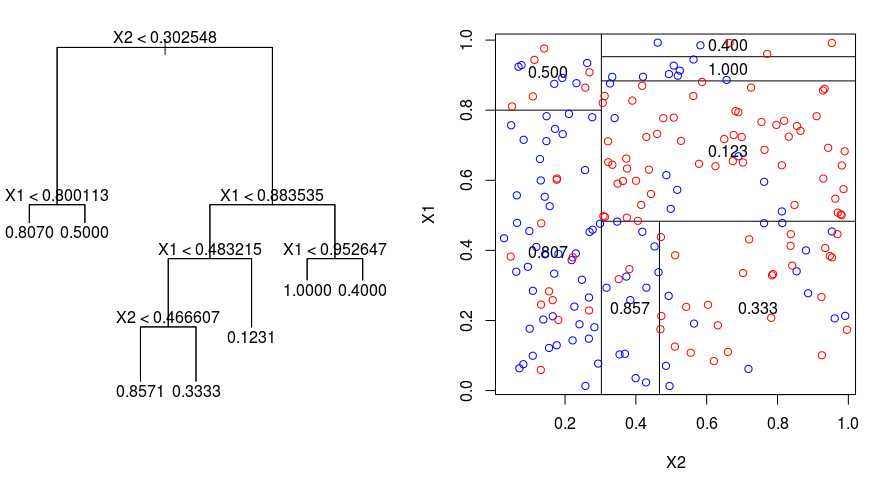
Laten we kijken naar de onderstaande afbeelding, die helpt de aard van de opsplitsing te visualiseren die door een regressieboom wordt uitgevoerd. Deze toont een ongesnoeide boom en een regressieboom die is gefit op een willekeurige dataset. Beide visualisaties laten een reeks splitsingsregels zien, beginnend bovenaan de boom. Merk op dat elke splitsing van het domein is uitgelijnd met een van de feature-assen. Het concept van asparallelle splitsing generaliseert eenvoudig naar dimensies groter dan twee. Voor een feature‑ruimte van grootte $p$, een deelverzameling van $\mathbb{R}^p$, wordt de ruimte verdeeld in $M$ regio's, $R_{m}$, die elk een $p$‑dimensionaal "hyperblok" vormen.
Om een regressieboom te bouwen, gebruik je eerst recursief binair splitsen om een grote boom te laten groeien op de trainingsdata, en stop je pas wanneer elk terminale knooppunt minder heeft dan een minimumaantal observaties. Recursief binair splitsen is een gulzig en top‑down algoritme dat de Residual Sum of Squares (RSS) minimaliseert, een foutmaat die ook in lineaire regressie wordt gebruikt. De RSS, in het geval van een gesegmenteerde feature‑ruimte met M partities, wordt gegeven door:
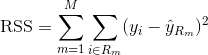
Vanaf de top van de boom splits je deze in 2 takken, waarmee je een partitie in 2 ruimten creëert. Je voert deze specifieke splitsing bovenaan de boom meerdere keren uit en kiest de splitsing van de features die de (huidige) RSS minimaliseert.
Vervolgens pas je cost complexity pruning toe op de grote boom om een reeks beste subbomen te verkrijgen als functie van $\alpha$. Het basisidee is hier om een extra afstemmingsparameter te introduceren, aangeduid met $\alpha$, die de diepte van de boom en de pasvorm op de trainingsdata in balans brengt.
Je kunt K‑voudige crossvalidatie gebruiken om $\alpha$ te kiezen. Deze techniek houdt simpelweg in dat je de trainingsobservaties in K vouwen verdeelt om de testfout van de subbomen te schatten. Je doel is om degene te selecteren die tot de laagste fout leidt.
Een classificatieboom lijkt sterk op een regressieboom, behalve dat deze wordt gebruikt om een kwalitatieve in plaats van een kwantitatieve respons te voorspellen.
Weet je nog: bij een regressieboom wordt de voorspelde respons voor een observatie gegeven door het gemiddelde van de respons van de trainingsobservaties die tot hetzelfde terminale knooppunt behoren. Bij een classificatieboom voorspel je daarentegen dat elke observatie behoort tot de meest voorkomende klasse van trainingsobservaties in de regio waartoe zij behoort.
Bij de interpretatie van een classificatieboom ben je vaak niet alleen geïnteresseerd in de klassevoorspelling die bij een bepaald regionaal terminale knooppunt hoort, maar ook in de klasseverdelingen onder de trainingsobservaties die in die regio vallen.
Het laten groeien van een classificatieboom lijkt sterk op het laten groeien van een regressieboom. Net als in de regressiecontext gebruik je recursief binair splitsen om een classificatieboom te laten groeien. In de classificatiecontext kan de Residual Sum of Squares echter niet worden gebruikt als criterium voor binaire splitsingen. In plaats daarvan kun je een van de drie onderstaande methoden gebruiken:
E = 1 - argmaxc($\hat{\pi}_{mc}$)
waarin $\hat{\pi}_{mc}$ het aandeel trainingsdata in regio Rm voorstelt dat tot klasse c behoort.
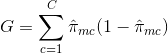
De cross‑entropy neemt een waarde nabij nul aan als de $\hat{\pi}_{mc}$’s allemaal dicht bij 0 of dicht bij 1 liggen. Daarom neemt, net als bij de Gini‑index, de cross‑entropy een kleine waarde aan als het m‑de knooppunt zuiver is. In feite blijken de Gini‑index en cross‑entropy numeriek erg op elkaar te lijken.
Bij het bouwen van een classificatieboom worden meestal de Gini‑index of de cross‑entropy gebruikt om de kwaliteit van een bepaalde splitsing te beoordelen, omdat ze gevoeliger zijn voor knooppuntzuiverheid dan de classificatiefout. Elk van deze drie benaderingen kan worden gebruikt bij het snoeien van de boom, maar de classificatiefout is te verkiezen als de voorspellingsnauwkeurigheid van de uiteindelijke gesnoeide boom het doel is.
Hoe graag we het algoritme en zijn sterke punten ook begrijpen, het is net zo belangrijk de zwakke punten te kennen. De waarheid is dat beslisbomen niet altijd de beste keuze zijn, net zoals dat voor alle machinelearning‑algoritmen geldt.
Hier zijn de voordelen en nadelen:
Ondanks deze nadelen blijven beslisbomen populair in veel toepassingen vanwege hun eenvoud, uitlegbaarheid en veelzijdigheid.
Laten we ensemblemethoden verkennen die de sterke punten van beslisbomen benutten en tegelijkertijd enkele beperkingen aanpakken: bagging, boosting en random forests.
De hierboven besproken beslisbomen lijden onder hoge variantie, wat betekent dat als je de trainingsdata willekeurig in twee delen splitst en op beide helften een beslisboom fit, de resultaten behoorlijk kunnen verschillen. Daarentegen zal een procedure met lage variantie vergelijkbare resultaten opleveren wanneer deze herhaaldelijk op verschillende datasets wordt toegepast.
Bagging, of bootstrap aggregation, is een techniek om de variantie van je voorspellingen te verkleinen door de resultaten te combineren van meerdere classificatoren die zijn gemodelleerd op verschillende subsamples van dezelfde dataset. Hier is de vergelijking voor bagging:
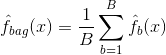
waarin je $B$ verschillende gebootstrapte trainingsdatasets genereert. Je traint je methode op de $b$‑de gebootstrapte trainingsset om $\hat{f}_{b}(x)$ te krijgen, en neemt ten slotte het gemiddelde van de voorspellingen.
De onderstaande visual laat de drie stappen in bagging zien:
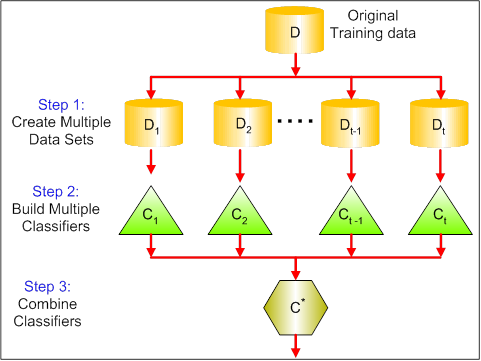
Stap 1: Je vervangt de originele data door nieuwe data. De nieuwe data hebben meestal een fractie van de kolommen en rijen van de originele data, die vervolgens als hyperparameters in het baggingmodel kunnen worden gebruikt.
Stap 2: Je bouwt classificatoren op elke dataset. Meestal kun je dezelfde classificator gebruiken voor het maken van modellen en voorspellingen.
Stap 3: Tot slot combineer je de voorspellingen van alle classificatoren met een gemiddelde waarde, afhankelijk van het probleem. Over het algemeen zijn deze gecombineerde waarden robuuster dan één enkel model.
Hoewel bagging de voorspellingen kan verbeteren voor veel regressie- en classificatiemethoden, is het vooral nuttig voor beslisbomen. Om bagging toe te passen op regressie-/classificatiebomen construeer je simpelweg $B$ regressie-/classificatiebomen met $B$ gebootstrapte trainingssets en neem je het gemiddelde van de resulterende voorspellingen. Deze bomen worden diep gegroeid en niet gesnoeid. Daardoor heeft elke individuele boom een hoge variantie maar lage bias. Het middelen van deze $B$ bomen reduceert de variantie.
In brede zin is aangetoond dat bagging indrukwekkende verbeteringen in nauwkeurigheid kan geven door honderden of zelfs duizenden bomen te combineren in één procedure.
Random forests is een veelzijdige machinelearning‑methode die zowel regressie‑ als classificatietaken aankan. Het voert ook dimensionale‑reductiemethoden uit, behandelt missende waarden, uitschieters en andere essentiële stappen van data‑exploratie en doet dat doorgaans behoorlijk goed.
Random forests verbeteren gebagde bomen met een kleine aanpassing die de bomen decorreleert. Net als bij bagging bouw je een aantal beslisbomen op gebootstrapte trainingssteekproeven. Maar bij het bouwen van deze beslisbomen wordt bij elke overweging van een splitsing een willekeurige steekproef van m voorspellers gekozen als splitkandidaten uit de volledige set van $p$ voorspellers. De splitsing mag slechts één van die $m$ voorspellers gebruiken. Dit is het belangrijkste verschil tussen random forests en bagging; want bij bagging is de keuze van voorspellers $m = p$.
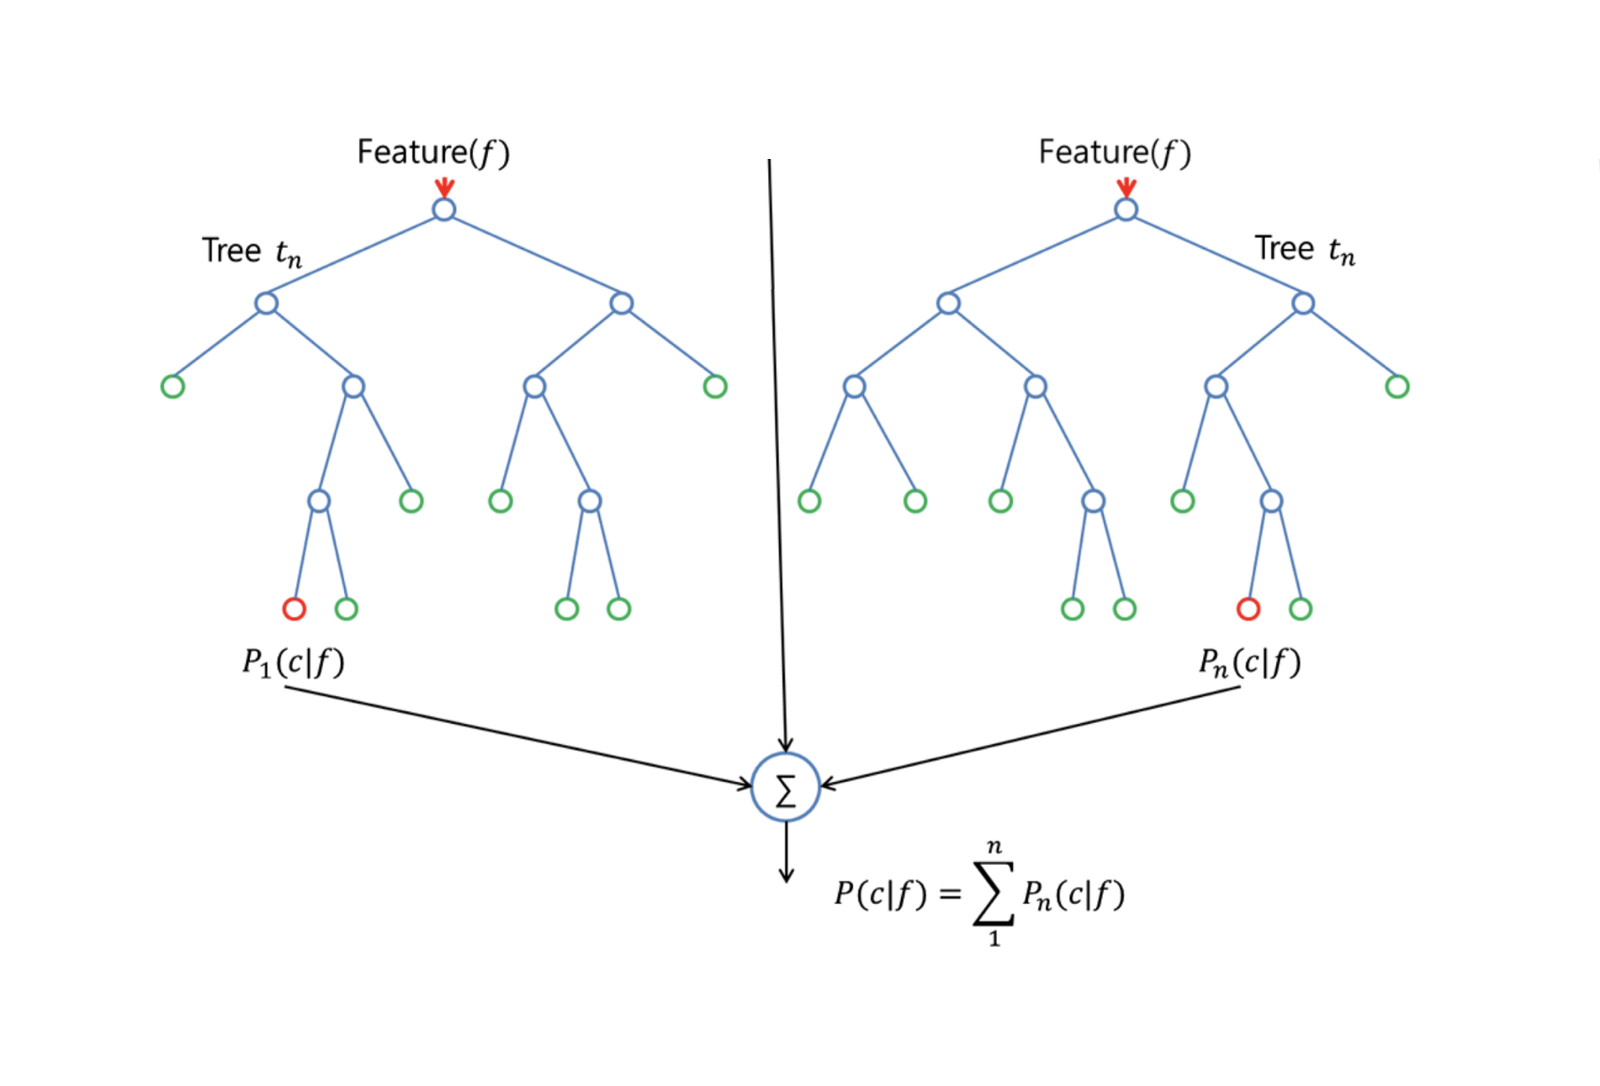
Om een random forest te laten groeien, doe je het volgende:
Neem eerst aan dat het aantal gevallen in de trainingsset K is. Neem vervolgens een willekeurige steekproef van deze K gevallen en gebruik deze steekproef als trainingsset voor het laten groeien van de boom.
Als er $p$ invoervariabelen zijn, specificeer dan een aantal $m < p$ zodat je bij elk knooppunt $m$ willekeurige variabelen uit de $p$ kunt selecteren. De beste splitsing op deze $m$ wordt gebruikt om het knooppunt te splitsen.
Elke boom wordt vervolgens zo groot mogelijk gegroeid en snoeien is niet nodig.
Agregeer tot slot de voorspellingen van de doelbomen om nieuwe data te voorspellen.
Random forests zijn zeer effectief in het schatten van missende data en het behouden van nauwkeurigheid wanneer een groot deel van de data ontbreekt. Ze kunnen ook fouten balanceren in datasets met scheve klassen. Het belangrijkst: ze kunnen enorme datasets met hoge dimensionaliteit aan. Een nadeel is echter dat je ruisrijke datasets relatief eenvoudig kunt overfitten, vooral bij regressie.
Boosting is een andere benadering om de voorspellingen van een beslisboom te verbeteren. Net als bagging en random forests is het een algemene aanpak die kan worden toegepast op veel statistische leermethoden voor regressie of classificatie. Ter herinnering: bagging houdt in dat je meerdere kopieën van de oorspronkelijke trainingsdataset maakt met de bootstrap, een afzonderlijke beslisboom fit op elke kopie en vervolgens alle bomen combineert om één voorspellend model te creëren. Opmerkelijk is dat elke boom wordt gebouwd op een gebootstrapte dataset, onafhankelijk van de andere bomen.
Boosting werkt op een vergelijkbare manier, behalve dat de bomen sequentieel worden gegroeid: elke boom wordt gegroeid met informatie uit eerder gegroeide bomen. Boosting omvat geen bootstrap‑sampling; in plaats daarvan wordt elke boom gefit op een aangepaste versie van de originele dataset.
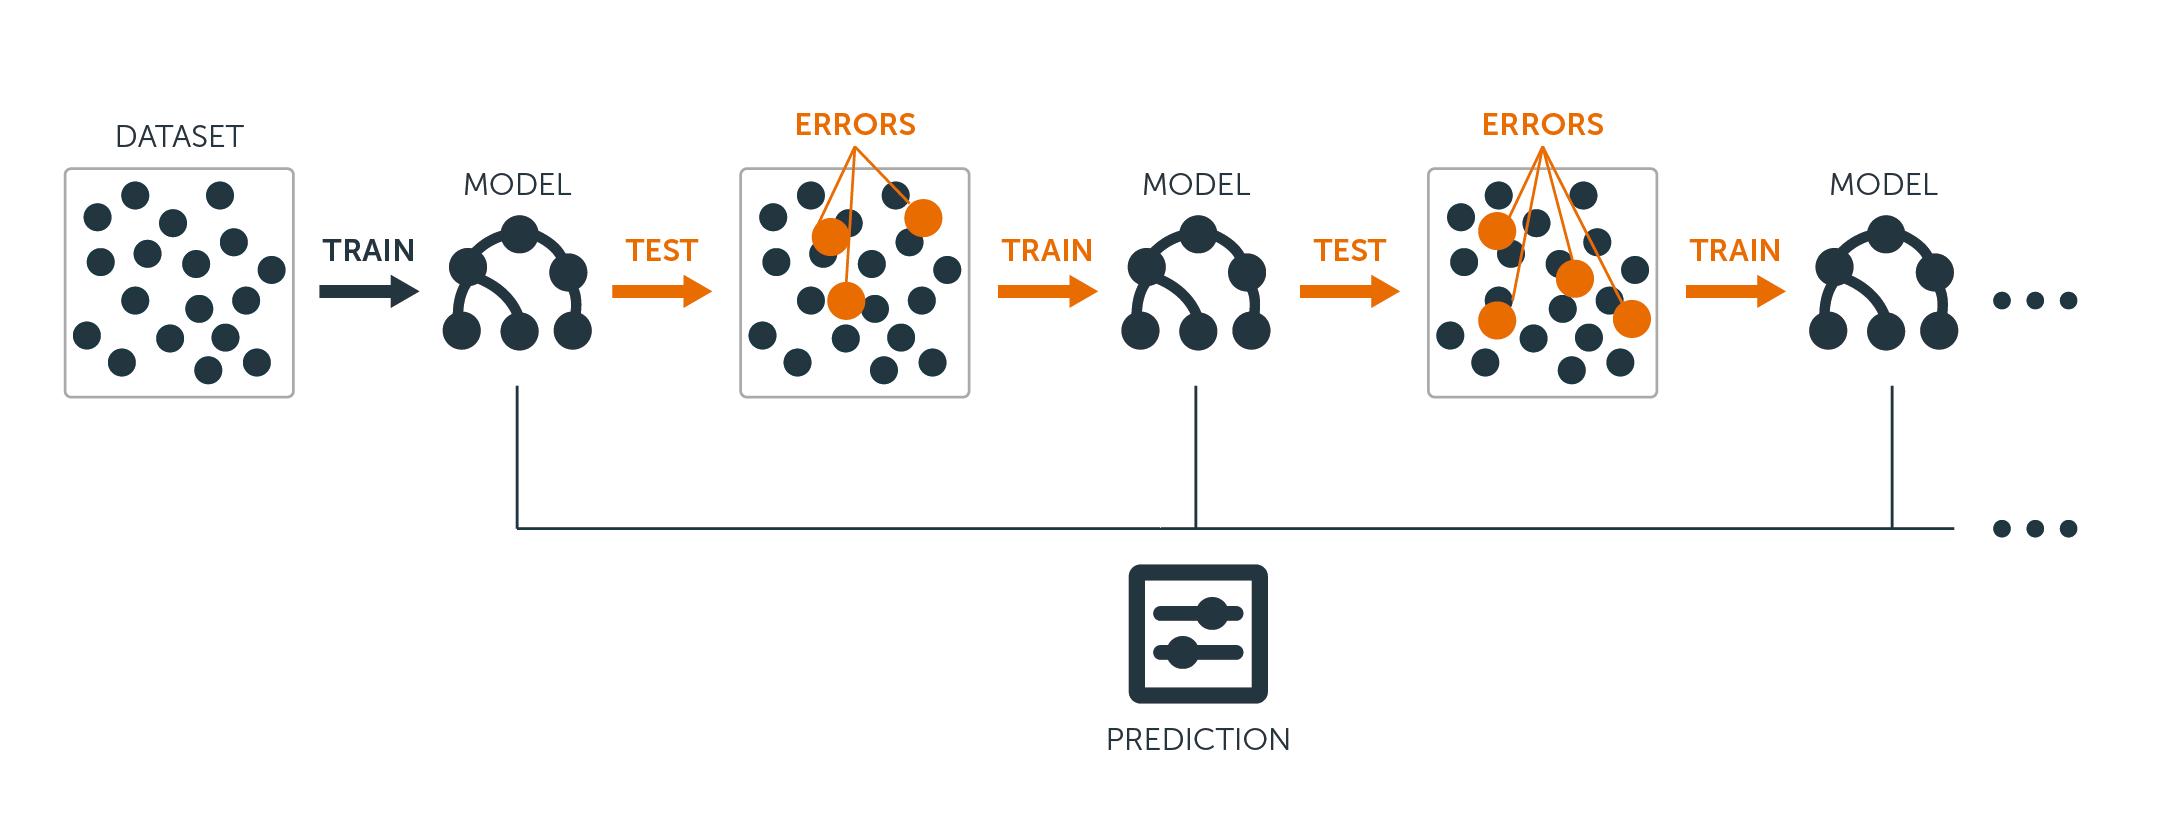
Voor zowel regressie- als classificatiebomen werkt boosting als volgt:
In plaats van één grote beslisboom op de data te fitten, wat neerkomt op hard fitten en mogelijk overfitten, leert boosting juist langzaam.
Gegeven het huidige model fit je een beslisboom op de residuen van het model. Dat wil zeggen: je fit een boom met de huidige residuen, in plaats van de uitkomst $Y$, als respons.
Daarna voeg je deze nieuwe beslisboom toe aan de gefitte functie om de residuen bij te werken. Elk van deze bomen kan vrij klein zijn, met slechts enkele terminale knooppunten, bepaald door de parameter $d$ in het algoritme. Door kleine bomen op de residuen te fitten, verbeter je $\hat{f}$ langzaam in gebieden waar het niet goed presteert.
De shrinkage‑parameter $\nu$ vertraagt het proces nog verder, waardoor meer en anders gevormde bomen de residuen kunnen aanpakken.
Boosting is erg nuttig wanneer je veel data hebt en verwacht dat de beslisbomen erg complex worden. Boosting is gebruikt om vele uitdagende classificatie‑ en regressieproblemen op te lossen, waaronder risicoanalyse, sentimentanalyse, voorspellende advertenties, prijsmodellering, verkoopschatting en patiëntdiagnoses.
Essentieel is dat deze algoritmen de voorspellingen van meerdere beslisbomen combineren om de algehele prestaties en stabiliteit te verbeteren. Nu we de geavanceerde algoritmen begrijpen, gaan we voor deze tutorial verder met de eenvoudige beslisboommodellen.
We hebben veel theorie en intuïtie achter beslisboommodellen en varianten behandeld, maar niets gaat boven zelf aan de slag gaan: modellen bouwen en hun prestaties stap voor stap evalueren.
Voor de volgende voorbeelden gebruiken we de populaire Boston Housing‑dataset.
De Boston Housing‑dataset bevat informatie over de huizenmarkt in Boston, Massachusetts, in de jaren 70. Hij heeft 506 observaties en 14 variabelen, waaronder 13 features en 1 doelvariabele.
De features in de Boston Housing‑dataset zijn:
De doelvariabele is MEDV, de mediaanwaarde van door eigenaar bewoonde woningen in $1000’en.
Het doel is om de mediaanwaarde van door eigenaar bewoonde woningen (in duizenden dollars) te voorspellen op basis van de gegeven features.
In R is de data beschikbaar in een pakket genaamd “MASS.” Je moet voor deze tutorial meerdere pakketten installeren en laden. Omdat dit zich herhaalt, laten we dit proces één keer zien met het MASS‑pakket; je herhaalt het wanneer je een nieuw pakket ziet in deze gids.
# install the package
install.packages("MASS")

# Load the MASS package
library(MASS)

# Load the Boston Housing dataset
data(Boston)
Het is vaak nodig de data te verkennen met visualisaties en enkele preprocessing‑stappen uit te voeren voordat je gaat modelleren. Laten we naar de verdeling van de variabelen kijken met histogrammen.
Hier is de code om ze te maken:
# Load the library
library(tidymodels)
library(tidyr)

# Prepare the dataset for ggplot2
boston_data_long <- Boston %>%
 pivot_longer(cols = everything(),
              names_to = "variable",
              values_to = "value")

# Create a histogram for all numeric variables in one plot
boston_histograms <- ggplot(boston_data_long, aes(x = value)) +
 geom_histogram(bins = 30, color = "black", fill = "lightblue") +
 facet_wrap(~variable, scales = "free", ncol = 4) +
 labs(title = "Histograms of Numeric Variables in the Boston Housing Dataset",
      x = "Value",
      y = "Frequency") +
 theme_minimal()

# Plot the histograms
print(boston_histograms)
En de output ziet er zo uit:

We zien enkele uitschieters, vooral in kolommen als RAD, TAX en NOX. Ons doel in deze tutorial is focussen op de fase van het beslisboom‑modelleren; laten we de dataset dus splitsen in trainings‑ en testsets.
# Split the data into training and testing sets

set.seed(123)
data_split <- initial_split(Boston, prop = 0.75)
train_data <- training(data_split)
test_data <- testing(data_split)
Laten we nu duiken in het modelleren en het evalueren van de modelprestaties.
Met de functie decision_tree() uit het Tidymodels‑pakket in R is het eenvoudig om eerst een modelspecificatie voor een beslisboom te maken en vervolgens het model te fitten op de trainingsdata.
# Create a decision tree model specification
tree_spec <- decision_tree() %>%
 set_engine("rpart") %>%
 set_mode("regression")

# Fit the model to the training data
tree_fit <- tree_spec %>%
 fit(medv ~ ., data = train_data)
We gebruiken hier de “regression”‑modus; voor een classificatiebeslisboom zouden we de “classification”‑modus gebruiken.
Om de prestaties van het model te evalueren, gebruiken we het Tidymodels‑pakket om de root mean squared error (RMSE) en de R‑kwadraatwaarde voor ons beslisboommodel op de testdata te berekenen.
# Make predictions on the testing data
predictions <- tree_fit %>%
 predict(test_data) %>%
 pull(.pred)

# Calculate RMSE and R-squared
metrics <- metric_set(rmse, rsq)
model_performance <- test_data %>%
 mutate(predictions = predictions) %>%
 metrics(truth = medv, estimate = predictions)

print(model_performance)
Je krijgt een output met twee prestatiematen: Root Mean Squared Error (RMSE) en R‑kwadraat (R²).
 .metric .estimator .estimate
 <chr>   <chr>          <dbl>
1 rmse    standard       5.22
2 rsq standard 0.689Dus, zijn onze modelresultaten goed genoeg?
We kunnen ook de hyperparameters optimaliseren om extra prestaties te winnen, of kiezen voor complexere modellen zoals Random Forests en XGBoost ten koste van uitlegbaarheid.
Als je tevreden bent met het model, is het tijd om het model voorspellingen te laten doen.
Dit gaat hetzelfde als met de testdata via de functie predict(), maar we moeten een nieuwe dataset aanleveren die informatie nabootst over een nieuw huis in Boston. Dat is een mogelijk scenario wanneer het model live gaat in productie.
# Make predictions on new data
new_data <- tribble(
 ~crim, ~zn, ~indus, ~chas, ~nox, ~rm, ~age, ~dis, ~rad, ~tax, ~ptratio, ~black, ~lstat,
 0.03237, 0, 2.18, 0, 0.458, 6.998, 45.8, 6.0622, 3, 222, 18.7, 394.63, 2.94
)
predictions <- predict(tree_fit, new_data)
print(predictions)
En je krijgt de voorspelde mediaanwaarde (in $1000’en) van dit specifieke huis:
# A tibble: 1 × 1
 .pred
 <dbl>
1  37.8
Daarmee heb je de stappen om een beslisboommodel te bouwen in handen — laten we nu focussen op hoe we kunnen interpreteren wat er in het model gebeurt, voor onszelf en voor de stakeholders die de oplossing gebruiken die we zojuist hebben gebouwd.
Het grootste voordeel, zoals eerder aangegeven, is de uitlegbaarheid van beslisboommodellen. Laten we de beslisboom visualiseren om het model beter te begrijpen:
# Load the library
library(rpart.plot)

# Plot the decision tree
rpart.plot(tree_fit$fit, type = 4, extra = 101, under = TRUE, cex = 0.8, box.palette = "auto")
Je ziet een plot zoals deze:

Het uitvoerdiagram van de functie rpart.plot toont een beslisboom‑representatie van het model. In dit diagram vertegenwoordigt elk knooppunt een splitsing in de beslisboom op basis van de predictoren. Het diagram bevat verschillende elementen die helpen de beslisboom te interpreteren:
De knooppunten worden weergegeven door cirkels en zijn met lijnen verbonden, wat de hiërarchische structuur van de beslisboom toont. De boom begint met een wortel bovenaan, en vertakt vervolgens naar interne knooppunten, uiteindelijk leidend naar de terminale knooppunten of bladeren onderaan.
Elk intern knooppunt toont het splitsingscriterium: de predictor en de waarde die wordt gebruikt om de data in twee subsets te splitsen.
Bijvoorbeeld, een knooppunt kan “RM < 6.8” tonen, wat aangeeft dat observaties met een gemiddeld aantal kamers per woning (RM) kleiner dan 6,8 de linker tak volgen, terwijl observaties met RM groter dan of gelijk aan 6,8 de rechter tak volgen.
De waarde n in elk knooppunt staat voor het aantal observaties in de dataset die in dat specifieke knooppunt vallen. Bijvoorbeeld, als een knooppunt "n = 100" toont, betekent dit dat 100 observaties in de dataset voldoen aan de criteria van de bovenliggende knooppunten.
De percentagewaarde helpt je de relatieve grootte van elk knooppunt ten opzichte van de volledige dataset te begrijpen, en laat zien hoe de data wordt gesplitst en verdeeld over de boom. Een hoger percentage betekent dat een groter deel van de data het beslispad naar dit knooppunt volgt, terwijl een lager percentage een kleiner deel aangeeft.
De voorspelde waarde bij elk knooppunt wordt weergegeven als een getal in een gekleurde cirkel (knooppunt). In een regressieboom is dit de gemiddelde waarde van de doelvariabele voor alle observaties die in dat knooppunt vallen.
Bijvoorbeeld, het laatste bladknooppunt met 47 betekent dat de gemiddelde doelvariabele (in ons geval de mediaanwaarde van door eigenaar bewoonde woningen) voor alle observaties in dat knooppunt 47 is.
Bij het interpreteren van uitkomsten begin je bij het wortelknooppunt en volg je de takken op basis van de splitsingscriteria totdat je een terminale knoop bereikt. De voorspelde waarde in de terminale knoop geeft de voorspelling van het model voor een gegeven observatie én de onderliggende redenering.
Als je de regels liever in tekstvorm wilt extraheren (in plaats van door het diagram te lopen), dan kan dat ook, met dezelfde library die we gebruikten om het diagram te plotten.
Hier is de code:
rules <- rpart.rules(tree_fit$fit)
print(rules)
En je ziet een output met de voorspelde waarden en de regels die het volgt om tot die waarde te komen, zoals hieronder:
medv
  11 when rm <  6.9        & lstat >= 15 & crim >= 7.5
  17 when rm <  6.9        & lstat >= 15 & crim <  7.5
  22 when rm <  6.5        & lstat <  15               & dis >= 1.6
  26 when rm is 6.9 to 7.4 & lstat >=  7
  27 when rm is 6.5 to 6.9 & lstat <  15
  34 when rm <  6.5        & lstat <  15               & dis <  1.6
  34 when rm is 6.9 to 7.4 & lstat <   7
  47 when rm >=        7.4
Nu je de regels ziet, vraag je je misschien af hoe de beslissing met 3–4 variabelen kan worden genomen terwijl we veel meer variabelen aan de boom voeren.
Blijkbaar zijn sommige variabelen belangrijker dan andere. Laten we dit beter begrijpen.
We hebben het boomdiagram en de werking van het model al bekeken. Een laatste aspect van de interpretatie is het begrijpen van de belangrijke variabelen uit de dataset.
Waarom dit belangrijk is:
In beslisbomen wordt variabele‑belang meestal bepaald door de features die worden gebruikt voor splitsingen in de knooppunten. Features die hoger in de boom splitsen of vaker worden gebruikt, kunnen als belangrijker worden beschouwd.
Het belang van een variabele kan worden gekwantificeerd door de reductie in de onzuiverheidsmaat (bijv. Gini‑index of mean squared error) die ze oplevert wanneer ze wordt gebruikt voor een splitsing. Het “VIP”‑pakket in R neemt de complexiteit weg; de plot kun je verkrijgen met onderstaande code:
# Load the necessary library
library(vip)

# Create a variable importance plot
var_importance <- vip::vip(tree_fit, num_features = 10)
print(var_importance)
En je krijgt de onderstaande variable‑importance‑plot:

Zodra je de plot ziet, kun je verder onderzoek doen naar waarom deze variabelen belangrijk zijn, samen met domeinexperts. Op basis van de bovenstaande plot kunnen we bijvoorbeeld de top 3 belangrijkste variabelen en de onderbouwing afleiden:
Vergeet dus niet de variable‑importance‑plot te bekijken voordat je je model finaliseert; dit helpt je betere features te maken en te selecteren om de prestaties te optimaliseren.
In deze tutorial hebben we de basisconcepten van beslisbomen verkend en niet alleen modellen gebouwd maar ze ook geïnterpreteerd. Beslisbomen zijn krachtige en uitlegbare modellen voor zowel classificatie‑ als regressietaken en vormen een essentieel onderdeel van de gereedschapskist van een data scientist.
Naarmate je vaardigheden groeien, moedigen we je aan dieper te duiken in de wereld van beslisbomen, alternatieve algoritmen te verkennen en je R‑vaardigheden te versterken. Hier zijn enkele resources voor je volgende stap:
Zonder twijfel stelt het uitbreiden van je kennis en het experimenteren met nieuwe tools en technieken je in staat uiteenlopende uitdagingen aan te gaan en waardevolle inzichten te leveren in je projecten.
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

