
Last chance! 50% off DataCamp Premium
Sale ends in

Kendinizi bir labirentte yol alırken hayal edin. Her adımda, sizi çıkışa yaklaştıran ya da labirentin derinliklerine götüren bir kararla karşılaşırsınız. Bu, karmaşık verileri anlamamıza ve en iyi hareket tarzını seçmemize yardımcı olan güçlü ve sezgisel bir makine öğrenimi yöntemi olan karar ağacı algoritmasına benzer.
Karar ağacı algoritması, belirli koşullara dayanarak bir veri kümesini gitgide daha küçük alt kümelere böler. Yaprakları ve düğümleri olan dallı bir ağaç gibi, tek bir kök düğümle başlar ve her biri bir özelliğin değerine dayalı bir kararı temsil eden birden fazla dala genişler. Ağacın son yaprakları olası sonuçları veya tahminleri ifade eder.
Bu makale, R programlama dilini kullanarak sizi karar ağaçlarının dünyasıyla tanıştıracaktır. Temelleri ele alacak, popüler karar ağacı algoritması türlerine dalacak, ağaç tabanlı yöntemleri keşfedecek ve sizi adım adım bir örnekle yönlendireceğiz. Sonunda, daha iyi, veriye dayalı kararlar almak için karar ağaçlarının gücünden yararlanabileceksiniz.
Karar ağaçları, sadelikleri, yorumlanabilirlikleri ve çok yönlülükleri nedeniyle makine öğreniminde özeldir.
Hem regresyon (sürekli değerlerin tahmini) hem de sınıflandırma (kategorik değerlerin tahmini) problemleri için kullanılabilen denetimli bir makine öğrenimi algoritmasıdır. Ayrıca, bagging, boosting ve rastgele ormanlar gibi daha gelişmiş tekniklerin temelini oluştururlar.
Aşağıdaki diyagram, karar ağaçlarının arkasındaki terminolojileri gösterecektir:
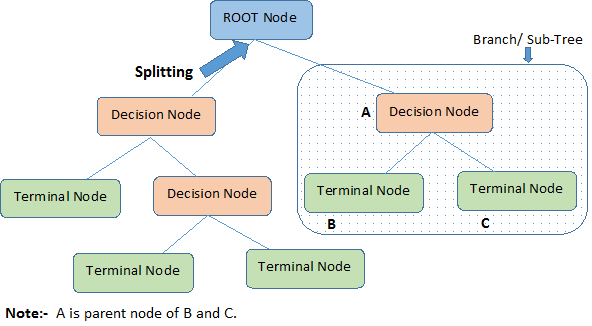
Bir karar ağacı, tüm kitleyi veya örneklemi ifade eden bir kök düğümle başlar, ardından bölme adı verilen bir yöntemle iki veya daha fazla homojen gruba ayrılır. Alt düğümler daha fazla bölündüğünde karar düğümleri olarak adlandırılır; bölünmeyenler ise terminal düğümler veya yapraklar olarak adlandırılır. Tam bir ağacın bir bölümüne dal denir.
Karar ağaçlarının hem regresyon hem de sınıflandırma görevlerinde kullanılabildiğini belirledik; öyleyse karar ağacı türlerinin arkasındaki algoritmayı anlayalım.
Hem regresyon hem de sınıflandırma karar ağaçlarını sezgisel olarak anlayalım; her birindeki benzerlikler ve farklar ile hata fonksiyonlarına bakalım.
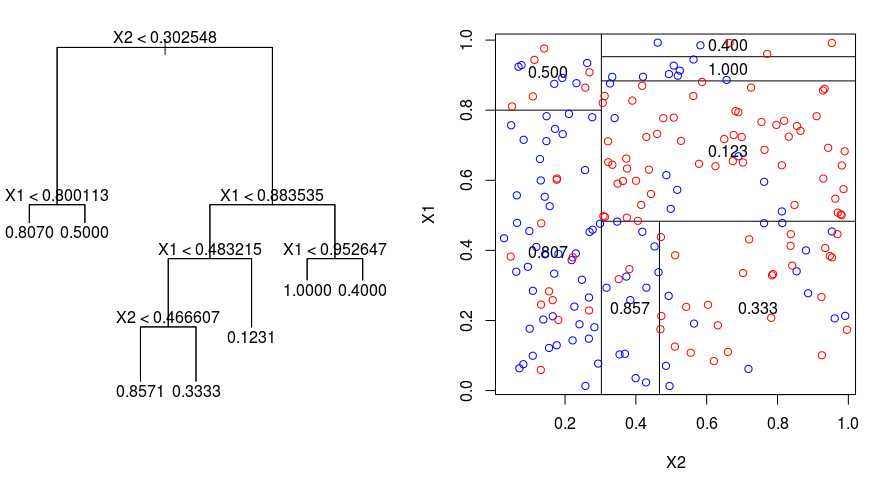
Aşağıdaki görsele göz atalım; bu görsel bir Regresyon Ağacı tarafından gerçekleştirilen bölümlendirmenin doğasını görselleştirmeye yardımcı olur. Bu, budanmamış bir ağacı ve rastgele bir veri kümesine uydurulmuş bir regresyon ağacını gösterir. Her iki görselleştirme de ağacın tepesinden başlayan bir dizi bölme kuralını gösterir. Alanın her bölünmesinin özellik eksenlerinden biriyle hizalı olduğuna dikkat edin. Eksenlere paralel bölme kavramı, ikiden büyük boyutlara da doğrudan genelleştirilebilir. Boyutu $p$ olan bir özellik uzayı, $\mathbb{R}^p$’nin bir alt kümesi için, uzay $M$ bölgeye, $R_{m}$’lere bölünür; bunların her biri $p$ boyutlu bir “hiper blok”tur.
Bir regresyon ağacı kurmak için önce eğitim verileri üzerinde özyinelemeli ikili bölme kullanarak büyük bir ağaç büyütürsünüz; yalnızca her terminal düğüm belirli bir asgari gözlem sayısının altına indiğinde durursunuz. Özyinelemeli İkili Bölme, regresyon bağlamlarında da kullanılan bir hata ölçüsü olan Hata Kareler Toplamını (RSS) en aza indirmek için kullanılan açgözlü ve yukarıdan aşağıya bir algoritmadır. M bölümlü bir özellik uzayı durumunda RSS şu şekilde verilir:
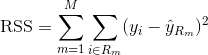
Ağacın tepesinden başlayarak onu 2 dala böler, 2 uzayın bir bölümünü oluşturursunuz. Daha sonra bu özel bölmeyi ağacın tepesinde birçok kez uygular ve (mevcut) RSS’yi en aza indiren özellik bölmesini seçersiniz.
Sonraki adımda, $\alpha$’nın bir fonksiyonu olarak en iyi alt ağaçların bir dizisini elde etmek için büyük ağaca maliyet karmaşıklığı budaması uygularsınız. Buradaki temel fikir, ağacın derinliği ile eğitim verilerine uyum iyiliğini dengeleyen, $\alpha$ ile gösterilen ek bir ayar parametresi tanıtmaktır.
$\alpha$’yı seçmek için K-katlanmış çapraz doğrulama kullanabilirsiniz. Bu teknik, alt ağaçların test hata oranını tahmin etmek için eğitim gözlemlerini K katmana bölmeyi içerir. Amacınız hata oranını en düşük yapanı seçmektir.
Sınıflandırma ağacı, bir regresyon ağacına çok benzer; tek fark, nicel bir yanıt yerine nitel bir yanıtı tahmin etmek için kullanılmasıdır.
Bir regresyon ağacında bir gözlem için tahmin edilen yanıtın, aynı terminal düğüme ait eğitim gözlemlerinin yanıtlarının ortalamasıyla verildiğini hatırlayın. Buna karşılık, bir sınıflandırma ağacında, her gözlemin ait olduğu bölgede en sık görülen sınıfa ait olduğunu tahmin edersiniz.
Bir sınıflandırma ağacının sonuçlarını yorumlarken, genellikle yalnızca belirli bir terminal düğüm bölgesine karşılık gelen sınıf tahminiyle değil, aynı zamanda o bölgeye düşen eğitim gözlemleri arasındaki sınıf oranlarıyla da ilgilenirsiniz.
Bir sınıflandırma ağacını büyütme görevi, bir regresyon ağacını büyütme görevine oldukça benzerdir. Regresyon ayarında olduğu gibi, sınıflandırma ağacını büyütmek için özyinelemeli ikili bölme kullanırsınız. Ancak sınıflandırma bağlamında, ikili bölmeler için ölçüt olarak Hata Kareler Toplamı kullanılamaz. Bunun yerine aşağıdaki 3 yöntemden birini kullanabilirsiniz:
E = 1 - argmaxc($\hat{\pi}_{mc}$)
burada $\hat{\pi}_{mc}$, Rm bölgesindeki eğitim verilerinin sınıf c’ye ait olan kısmını temsil eder.
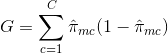
Çapraz entropi, $\hat{\pi}_{mc}$’lerin tümü 0’a ya da 1’e yakınsa sıfıra yakın bir değer alır. Bu nedenle, Gini indeksinde olduğu gibi, m’inci düğüm safsa çapraz entropi küçük bir değer alır. Nitekim, Gini indeksi ve çapraz entropinin sayısal olarak oldukça benzer olduğu görülür.
Bir sınıflandırma ağacı kurarken, belirli bir bölmenin kalitesini değerlendirmek için genellikle Gini indeksi veya çapraz entropi kullanılır; zira bu ölçütler, sınıflandırma hata oranına kıyasla düğüm saflığına daha duyarlıdır. Ağacı budarken bu 3 yaklaşımdan herhangi biri kullanılabilir; ancak nihai budanmış ağacın tahmin doğruluğu hedefleniyorsa sınıflandırma hata oranı tercih edilir.
Algoritmayı ve güçlü yönlerini anlamak istediğimiz kadar, zayıf yönlerini de kavramak çok önemlidir. Gerçek şu ki, karar ağaçları tüm makine öğrenimi problemleri için en iyi seçim değildir; bu, tüm makine öğrenimi algoritmaları için de geçerlidir.
İşte avantajlar ve dezavantajlar:
Bu dezavantajlara rağmen, karar ağaçları sadelikleri, yorumlanabilirlikleri ve çok yönlülükleri sayesinde birçok uygulamada popüler bir seçim olmaya devam etmektedir.
Karar ağaçlarının güçlü yönlerinden yararlanırken bazı sınırlamalarını da ele alan ağaç tabanlı topluluk yöntemlerini keşfedelim: bagging, boosting ve rastgele ormanlar.
Yukarıda bahsedilen karar ağaçları yüksek varyans sorunundan muzdariptir; yani eğitim verisini rastgele iki parçaya ayırıp her yarısına bir karar ağacı uydurursanız, elde edeceğiniz sonuçlar oldukça farklı olabilir. Buna karşılık, düşük varyanslı bir prosedür, farklı veri kümelerine defalarca uygulandığında benzer sonuçlar verir.
Bagging veya bootstrap toplulaştırma, aynı veri kümesinin farklı alt örnekleri üzerinde modellenmiş birden çok sınıflandırıcının sonucunu birleştirerek tahminlerinizin varyansını azaltmak için kullanılan bir tekniktir. Bagging için denklem şöyledir:
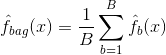
burada $B$ farklı bootstrap’lenmiş eğitim veri kümesi üretirsiniz. Ardından $b$’inci bootstrap eğitim kümesi üzerinde yönteminizi eğiterek $\hat{f}_{b}(x)$ elde eder, son olarak tahminlerin ortalamasını alırsınız.
Aşağıdaki görsel bagging’deki 3 farklı adımı gösterir:
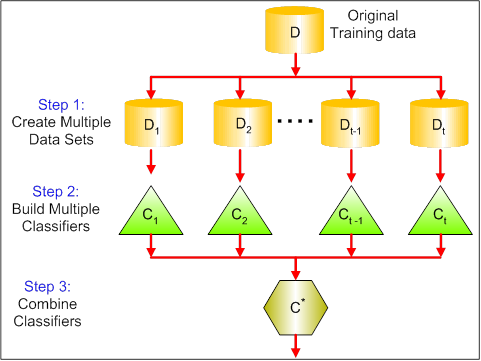
Adım 1: Burada özgün veriyi yeni verilerle değiştirirsiniz. Yeni veriler genellikle özgün verinin sütun ve satırlarının bir kısmına sahiptir; bu kısımlar, bagging modelinde hiperparametre olarak da kullanılabilir.
Adım 2: Her veri kümesi üzerinde sınıflandırıcılar kurarsınız. Genel olarak, modeller ve tahminler için aynı sınıflandırıcıyı kullanabilirsiniz.
Adım 3: Son olarak, probleme bağlı olarak tüm sınıflandırıcıların tahminlerini birleştirmek için ortalama bir değer kullanırsınız. Genellikle bu birleştirilmiş değerler tek bir modelden daha sağlamdır.
Bagging, pek çok regresyon ve sınıflandırma yöntemi için tahminleri iyileştirebilse de özellikle karar ağaçları için faydalıdır. Regresyon/sınıflandırma ağaçlarına bagging uygulamak için, $B$ bootstrap’lenmiş eğitim kümesi kullanarak $B$ regresyon/sınıflandırma ağacı inşa eder ve ortaya çıkan tahminlerin ortalamasını alırsınız. Bu ağaçlar derin büyütülür ve budanmaz. Dolayısıyla her bir ağacın varyansı yüksektir; ancak önyargısı düşüktür. Bu $B$ ağacın ortalaması varyansı azaltır.
Genel olarak, yüzlerce hatta binlerce ağacı tek bir prosedürde birleştirerek doğrulukta etkileyici iyileştirmeler sağladığı gösterilmiştir.
Rastgele Ormanlar, hem regresyon hem de sınıflandırma görevlerini yerine getirebilen çok yönlü bir makine öğrenimi yöntemidir. Boyut indirgeme yöntemleri uygular, eksik değerleri ve aykırı değerleri ele alır ve veri keşfinin diğer temel adımlarını üstlenir; üstelik bunu oldukça iyi yapar.
Rastgele Ormanlar, ağaçları dekorale eden küçük bir ayarlamayla bagging’i iyileştirir. Bagging’de olduğu gibi, bootstrap’lenmiş eğitim örnekleri üzerinde birçok karar ağacı kurarsınız. Ancak bu karar ağaçlarını kurarken, bir ağaçta her bölme düşünüldüğünde, tüm $p$ yordayıcı kümesinden rastgele seçilmiş m yordayıcı bölme adayı olarak belirlenir. Bölme, yalnızca bu $m$ yordayıcıdan biri kullanılarak yapılabilir. Bu, rastgele ormanlar ile bagging arasındaki temel farktır; zira bagging’de yordayıcı seçimi için $m = p$’dir.
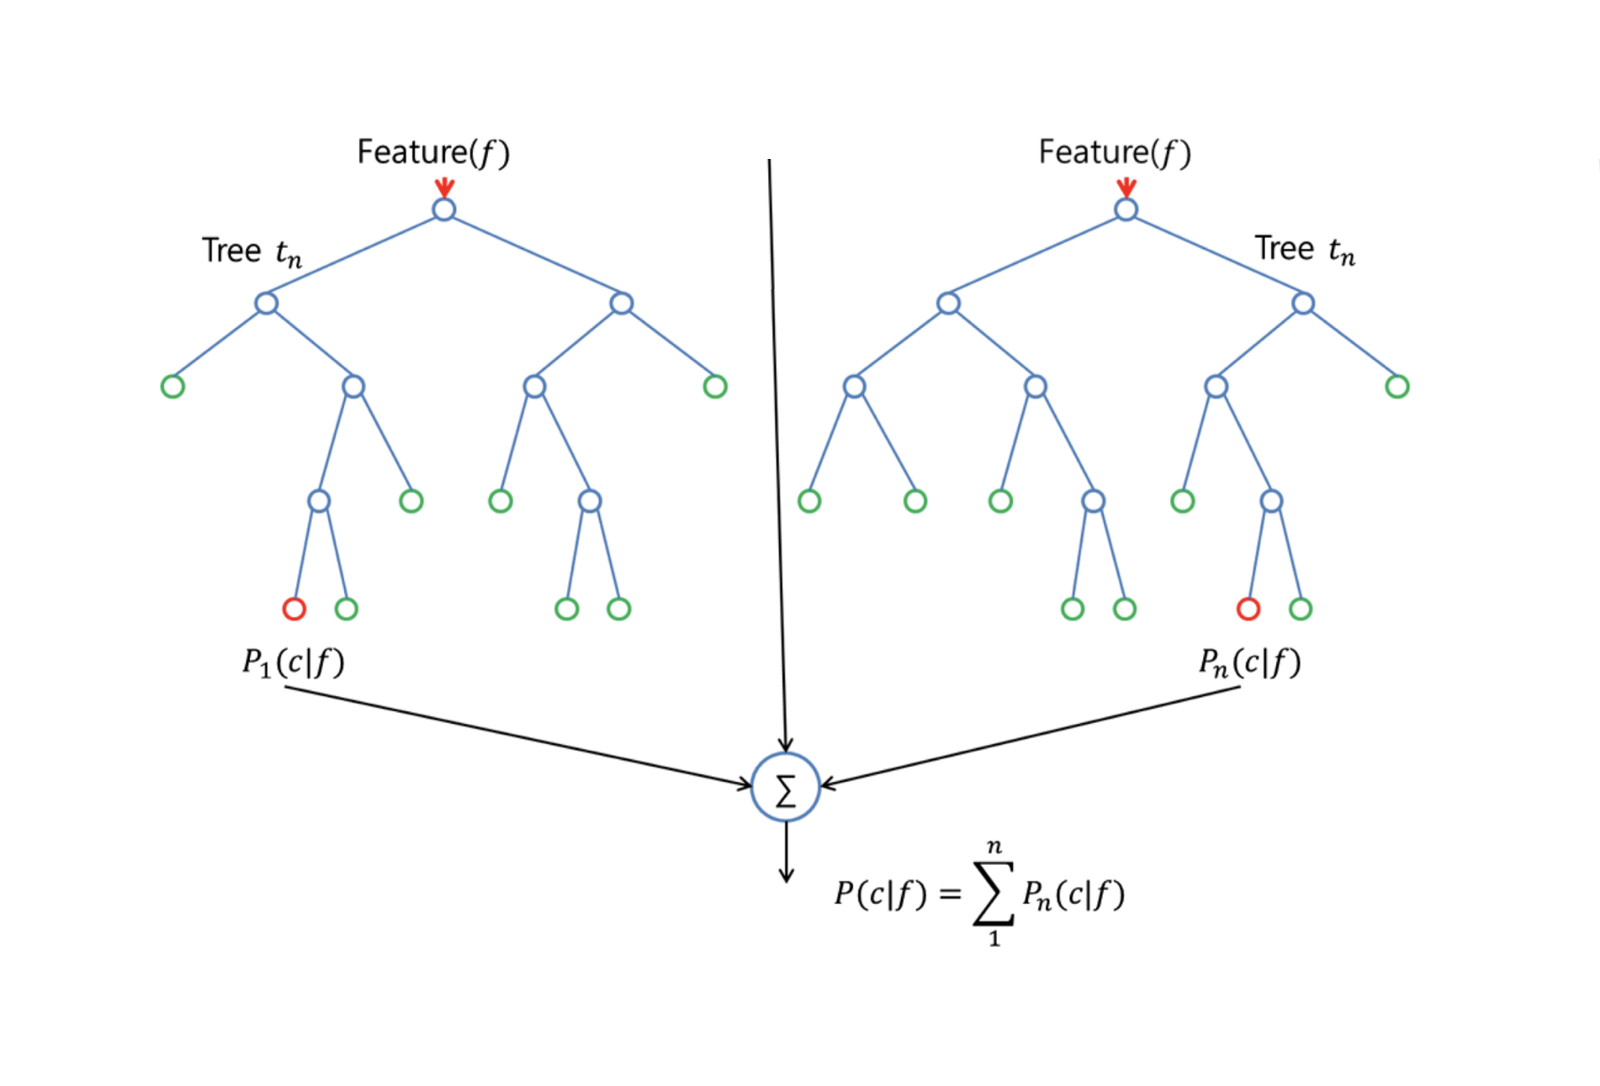
Bir rastgele ormanı büyütmek için şunları yapmalısınız:
Önce eğitim setindeki vaka sayısının K olduğunu varsayın. Ardından bu K vakanın rastgele bir örneğini alın ve bu örneği ağacı büyütmek için eğitim seti olarak kullanın.
Eğer $p$ giriş değişkeni varsa, her düğümde $p$ içinden rastgele $m$ değişken seçebileceğiniz şekilde $m < p$ bir sayı belirleyin. Bu $m$ içindeki en iyi bölme, düğümü bölmek için kullanılır.
Her ağaç daha sonra mümkün olan en büyük ölçüde büyütülür ve budama gerekmez.
Son olarak, hedef ağaçların tahminlerini birleştirerek yeni verileri tahmin edin.
Rastgele Ormanlar, eksik verileri tahmin etmede ve verilerin büyük bir kısmı eksik olduğunda bile doğruluğu korumada çok etkilidir. Ayrıca sınıfların dengesiz olduğu veri kümelerinde hataları dengeleyebilir. En önemlisi, büyük boyutluluğa sahip devasa veri kümelerini işleyebilir. Ancak Rastgele Ormanlar kullanmanın bir dezavantajı, özellikle regresyon durumunda, gürültülü veri kümelerinde kolayca aşırı uyum gösterebilmenizdir.
Boosting, bir karar ağacından elde edilen tahminleri iyileştirmek için başka bir yaklaşımdır. Bagging ve rastgele ormanlar gibi, regresyon veya sınıflandırma için birçok istatistiksel öğrenme yöntemine uygulanabilen genel bir yaklaşımdır. Bagging’in, bootstrap kullanarak özgün eğitim veri kümesinin birden çok kopyasını oluşturmaya, her kopyaya ayrı bir karar ağacı uydurmaya ve ardından tek bir öngörücü model oluşturmak için tüm ağaçları birleştirmeye dayandığını hatırlayın. Dikkat çekici biçimde, her ağaç diğerlerinden bağımsız olan bootstrap’lenmiş bir veri seti üzerinde kurulur.
Boosting benzer şekilde çalışır; ancak ağaçlar ardışık olarak büyütülür: Her ağaç, daha önce büyütülmüş ağaçlardan gelen bilgileri kullanarak büyür. Boosting bootstrap örneklemesi içermez; bunun yerine, her ağaç özgün veri setinin değiştirilmiş bir versiyonu üzerinde uydurulur.
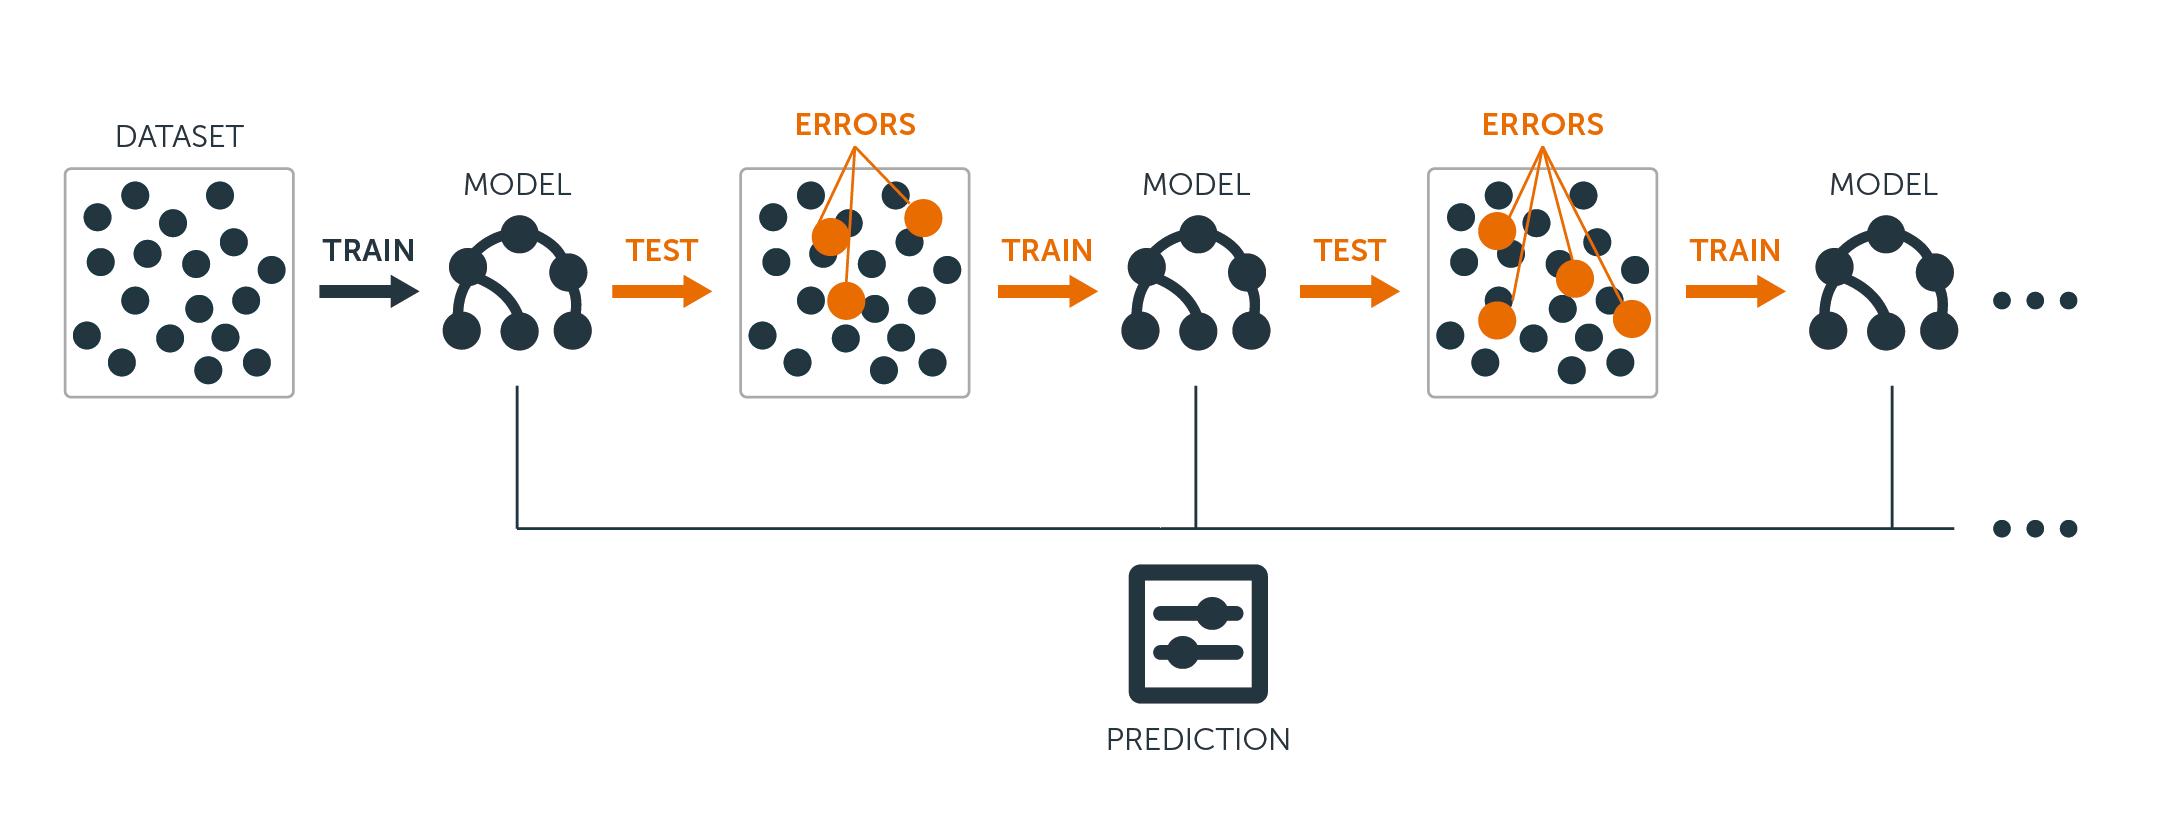
Hem regresyon hem de sınıflandırma ağaçları için boosting şu şekilde çalışır:
Veriye tek bir büyük karar ağacı uydurmak, veriye sıkı sıkıya uymak ve potansiyel olarak aşırı uyum göstermek anlamına gelirken, boosting yaklaşımı bunun yerine yavaş öğrenir.
Mevcut model verildiğinde, modelin artıklarına bir karar ağacı uydurursunuz. Yani, yanıt olarak $Y$ yerine mevcut artıklar kullanılarak bir ağaç uydurursunuz.
Daha sonra bu yeni karar ağacını uydurulmuş fonksiyona ekleyerek artıkları güncellersiniz. Bu ağaçların her biri, algoritmadaki $d$ parametresiyle belirlenen yalnızca birkaç terminal düğüme sahip olacak şekilde oldukça küçük olabilir. Artıklara küçük ağaçlar uydurarak, $\hat{f}$’i iyi performans göstermediği alanlarda yavaşça iyileştirirsiniz.
$\nu$ daraltma parametresi süreci daha da yavaşlatır; böylece daha fazla ve farklı şekillerdeki ağaçların artıklara yönelmesini sağlar.
Elinizde çok fazla veri olduğunda ve karar ağaçlarının çok karmaşık olmasını beklediğinizde boosting çok kullanışlıdır. Risk analizi, duygu analizi, öngörüsel reklamcılık, fiyat modelleme, satış tahmini ve hasta teşhisi gibi pek çok zorlu sınıflandırma ve regresyon problemi boosting ile çözülmüştür.
Özünde bu algoritmalar, genel performansı ve kararlılığı iyileştirmek için birden çok karar ağacının tahminlerini birleştirir. Gelişmiş algoritmaları anladığımıza göre, bu eğitimin kapsamı için basit karar ağacı modelleriyle devam edeceğiz.
Karar ağacı modellerinin ve varyasyonlarının arkasındaki teori ve sezgiyi bolca öğrendik; ancak adım adım model kurup performanslarını değerlendirmek kadar etkili bir şey yoktur.
Aşağıdaki örneklerde popüler Boston Konut Veri Seti’ni kullanacağız.
Boston Konut veri seti, 1970’lerde Massachusetts, Boston’daki konut piyasası hakkında bilgi içerir. 506 gözlem ve 14 değişkenden oluşur; 13 özellik ve 1 hedef değişken dahil.
Boston Konut veri setindeki özellikler şunlardır:
Hedef değişken MEDV’dir ve ev sahibi tarafından oturulan evlerin medyan değerini 1000 $ cinsinden temsil eder.
Amaç, verilen özelliklere dayanarak ev sahibi tarafından oturulan evlerin medyan değerini (bin dolar cinsinden) tahmin etmektir.
R’da veriler “MASS” adlı bir pakette sunulur. Bu eğitim için birden fazla paketi kurmanız ve yüklemeniz gerekecek. Tekrarı önlemek için, bu süreci MASS paketiyle bir kez gösterelim; bu rehberde yeni bir paket gördüğünüzde aynı adımları tekrarlayacaksınız.
# install the package
install.packages("MASS")

# Load the MASS package
library(MASS)

# Load the Boston Housing dataset
data(Boston)
Modellemeye geçmeden önce verileri görselleştirmelerle keşfetmek ve veri ön işleme adımlarını uygulamak sıklıkla gereklidir. Değişkenlerin dağılımlarına histogramlar üzerinden bakalım.
Bunları oluşturmak için kod şöyle:
# Load the library
library(tidymodels)
library(tidyr)

# Prepare the dataset for ggplot2
boston_data_long <- Boston %>%
 pivot_longer(cols = everything(),
              names_to = "variable",
              values_to = "value")

# Create a histogram for all numeric variables in one plot
boston_histograms <- ggplot(boston_data_long, aes(x = value)) +
 geom_histogram(bins = 30, color = "black", fill = "lightblue") +
 facet_wrap(~variable, scales = "free", ncol = 4) +
 labs(title = "Histograms of Numeric Variables in the Boston Housing Dataset",
      x = "Value",
      y = "Frequency") +
 theme_minimal()

# Plot the histograms
print(boston_histograms)
Ve çıktı şu şekilde görünür:

Bazı aykırı değerlere rastlıyoruz; özellikle RAD, TAX ve NOX sütunlarında. Bu eğitimin hedefi karar ağacı modelleme aşamasına odaklanmak olduğundan, veri setini eğitim ve test setlerine ayıralım.
# Split the data into training and testing sets

set.seed(123)
data_split <- initial_split(Boston, prop = 0.75)
train_data <- training(data_split)
test_data <- testing(data_split)
Şimdi modellemeye ve model performansını değerlendirmeye dalalım.
R’daki Tidymodels paketinden decision_tree() işlevini kullanarak önce bir karar ağacı model tanımı oluşturmak ve ardından modeli eğitim verileri üzerinde uydurmak oldukça kolaydır.
# Create a decision tree model specification
tree_spec <- decision_tree() %>%
 set_engine("rpart") %>%
 set_mode("regression")

# Fit the model to the training data
tree_fit <- tree_spec %>%
 fit(medv ~ ., data = train_data)
Burada “regression” modunu kullanıyoruz; bir sınıflandırma karar ağacı için “classification” modunu kullanmamız gerekirdi.
Modelin performansını değerlendirmek için, Tidymodels paketini kullanarak test verileri üzerinde karar ağacı modelimiz için kök ortalama kare hata (RMSE) ve R-kare değerini hesaplayacağız.
# Make predictions on the testing data
predictions <- tree_fit %>%
 predict(test_data) %>%
 pull(.pred)

# Calculate RMSE and R-squared
metrics <- metric_set(rmse, rsq)
model_performance <- test_data %>%
 mutate(predictions = predictions) %>%
 metrics(truth = medv, estimate = predictions)

print(model_performance)
Çıktıda iki performans metriği göreceksiniz: Kök Ortalama Kare Hata (RMSE) ve R-kare (R²).
 .metric .estimator .estimate
 <chr>   <chr>          <dbl>
1 rmse    standard       5.22
2 rsq standard 0.689Peki, model sonuçlarımız yeterince iyi mi?
Ayrıca, modelden daha fazla performans almak için hiperparametreleri optimize edebilir veya model yorumlanabilirliği pahasına Rastgele Ormanlar ve XGBoost gibi daha karmaşık modellere yönelebilirsiniz.
Modelden memnun kaldığınızda, onu tahminler yapması için kullanma zamanı gelmiştir.
Bu, test verilerinde predict() işleviyle yaptığımızın aynısıdır; ancak Boston’daki yeni bir ev hakkında bilgi taklit eden yeni bir veri seti sağlamamız gerekir. Bu, modelin üretim ortamında çalıştığı olası bir senaryodur.
# Make predictions on new data
new_data <- tribble(
 ~crim, ~zn, ~indus, ~chas, ~nox, ~rm, ~age, ~dis, ~rad, ~tax, ~ptratio, ~black, ~lstat,
 0.03237, 0, 2.18, 0, 0.458, 6.998, 45.8, 6.0622, 3, 222, 18.7, 394.63, 2.94
)
predictions <- predict(tree_fit, new_data)
print(predictions)
Ve bu özel evin tahmin edilen medyan değerini (1000 $ cinsinden) alırsınız:
# A tibble: 1 × 1
 .pred
 <dbl>
1  37.8
Bununla birlikte, bir karar ağacı modelini kurma adımlarına hakimsiniz — şimdi, hem kendimiz hem de oluşturduğumuz çözümü kullanan paydaş için modelin içinde neler olup bittiğini nasıl yorumlayabileceğimize odaklanalım.
Daha önce belirttiğimiz gibi en büyük avantaj, karar ağacı modellerinin yorumlanabilirliğidir. Modeli daha iyi anlamak için karar ağacını görselleştirelim:
# Load the library
library(rpart.plot)

# Plot the decision tree
rpart.plot(tree_fit$fit, type = 4, extra = 101, under = TRUE, cex = 0.8, box.palette = "auto")
Şuna benzer bir grafik göreceksiniz:

rpart.plot işlevinin çıktı diyagramı, modelin bir karar ağacı gösterimini sunar. Bu diyagramda, her düğüm yordayıcı değişkenlere dayalı bir bölmeyi temsil eder. Çıktı diyagramı, karar ağacını yorumlamamıza yardımcı olabilecek birkaç bilgi içerir:
Düğümler dairelerle temsil edilir ve ağacın hiyerarşik yapısını göstermek üzere çizgilerle bağlanır. Ağaç, en üstte bir kök düğümle başlar; iç düğümlere dallanır ve nihayetinde altta terminal düğümlere ya da yapraklara ulaşır.
Her iç düğüm, veriyi iki alt kümeye bölmek için kullanılan yordayıcı değişkeni ve değeri içeren bölme ölçütünü gösterir.
Örneğin, bir düğüm “RM < 6.8” gösterebilir; bu, konut başına ortalama oda sayısı (RM) 6,8’den küçük olan gözlemlerin sol dala, RM 6,8’den büyük veya eşit olanların sağ dala gideceği anlamına gelir.
Her düğümdeki n değeri, veri setinde o belirli düğüme düşen gözlem sayısını temsil eder. Örneğin, bir düğüm “n = 100” gösteriyorsa, bu 100 gözlemin, o düğümün üst düğümlerinin ölçütlerini karşıladığı anlamına gelir.
Yüzde değeri, verinin ağaç boyunca nasıl bölünüp dağıldığını göstererek, her düğümün tüm veri setine kıyasla göreli büyüklüğünü anlamanıza yardımcı olur. Daha yüksek bir yüzde, belirli düğüme giden karar yolunu daha büyük bir veri oranının izlediğine; daha düşük bir yüzde ise daha küçük bir oranın o düğüme ulaştığına işaret eder.
Her düğümde tahmin edilen değer, renkli bir daire (düğüm) içinde bir sayı olarak gösterilir. Bir regresyon ağacında bu, o düğüme düşen tüm gözlemlerin hedef değişkeninin ortalama değeridir.
Örneğin, son yaprak düğümünde 47 yazması, o düğümdeki tüm gözlemler için hedef değişkenin ortalama değerinin (bizim durumda ev sahibi tarafından oturulan evlerin medyan değeri) 47 olduğunu gösterir.
Herhangi bir sonucu yorumlarken, kök düğümden başlayıp bölme ölçütlerine göre dalları takip ederek terminal bir düğüme ulaşın. Terminal düğümdeki tahmin edilen değer, belirli bir gözlem için modelin tahminini ve kararın arkasındaki gerekçeyi verir.
Yine de kuralları diyagramı gezmek yerine metin biçiminde çıkarmayı tercih ediyorsanız — bunu da, diyagramı çizdirmek için kullandığımız aynı kütüphaneyle yapabilirsiniz.
Bunu yapmak için kod şöyle:
rules <- rpart.rules(tree_fit$fit)
print(rules)
Ve aşağıda olduğu gibi, tahmin edilen değerlerle bu değere ulaşmak için izlediği kuralları içeren bir çıktı görürsünüz:
medv
  11 when rm <  6.9        & lstat >= 15 & crim >= 7.5
  17 when rm <  6.9        & lstat >= 15 & crim <  7.5
  22 when rm <  6.5        & lstat <  15               & dis >= 1.6
  26 when rm is 6.9 to 7.4 & lstat >=  7
  27 when rm is 6.5 to 6.9 & lstat <  15
  34 when rm <  6.5        & lstat <  15               & dis <  1.6
  34 when rm is 6.9 to 7.4 & lstat <   7
  47 when rm >=        7.4
Kuralları gördüğünüze göre, birçok değişkeni karar ağacına beslerken nasıl olup da 3–4 değişkenle karar verilebildiğini merak edebilirsiniz.
Görünüşe göre bazı değişkenler diğerlerinden daha önemlidir. Bu kavramı daha iyi anlayalım.
Ağaç diyagramını ve modelin nasıl çalıştığını zaten inceledik. Yorumlamanın son bir yönü de veri setindeki önemli değişkenleri anlamaktır.
Bunun neden kritik olduğuna dair bazı noktalar:
Karar ağaçlarında değişken önemi genellikle düğümlerde bölme için kullanılan özelliklerle belirlenir. Ağaçta daha yukarılarda bölme için kullanılan veya daha sık kullanılan özellikler daha önemli kabul edilebilir.
Bir değişkenin önemi, bölme için kullanıldığında getirdiği safsızlık ölçüsü azalışı (ör. Gini indeksi veya ortalama kare hata) ile nicelenebilir. R’deki “VIP” paketi tüm karmaşıklıkları ortadan kaldırır ve aşağıdaki kodla grafiği elde edebilirsiniz:
# Load the necessary library
library(vip)

# Create a variable importance plot
var_importance <- vip::vip(tree_fit, num_features = 10)
print(var_importance)
Ve aşağıdaki değişken önemi grafiğini elde edersiniz:

Grafiği gördükten sonra, bu değişkenlerin neden önemli olduğuna dair alan uzmanlarıyla işbirliği yaparak daha fazla araştırma yapabilirsiniz. Örneğin, yukarıdaki grafiğe dayanarak en önemli 3 değişkeni ve mantığını şu şekilde çıkarabiliriz:
Modelinizi nihai hale getirmeden önce değişken önemi grafiğini kontrol etmeyi unutmayın; bu, performansı optimize etmek için daha iyi özellikler oluşturmanıza ve seçmenize yardımcı olabilir.
Bu eğitimde, karar ağaçlarının temel kavramlarını keşfettik ve yalnızca model kurmaya değil, onları yorumlamaya da odaklandık. Karar ağaçları, hem sınıflandırma hem de regresyon görevleri için güçlü ve yorumlanabilir modellerdir ve bir veri bilimcisinin araç setinde temel bir yere sahiptir.
Becerilerinizi geliştirmeye devam ederken, karar ağaçları dünyasına daha derin dalmanızı, alternatif algoritmaları keşfetmenizi ve R programlama yetkinliklerinizi artırmanızı öneririz. Bir sonraki adım için bazı kaynaklar:
Hiç şüphesiz, bilginizi genişletmek ve yeni araçlar ile tekniklerle denemeler yapmak, çeşitli zorlukların üstesinden gelmenizi ve projelerinize değerli içgörüler kazandırmanızı sağlayacaktır.
R Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



