
लर्निंग पाथ
डेटा इंजीनियर में Python
40 घंटा
डेटा लेक संरचित और असंरचित डेटा की भारी मात्रा को संग्रहीत करने का स्वर्ण मानक हैं, लेकिन अक्सर डेटा असंगतता, स्कीमा परिवर्तन, और प्रदर्शन समस्याओं से जूझते हैं। Delta Lake इन चुनौतियों को ACID ट्रांजैक्शन, स्कीमा प्रवर्तन, और स्केलेबल डेटा प्रोसेसिng को Apache Spark के ऊपर जोड़कर हल करता है।
इस ट्यूटोरियल में, मैं Delta Lake की बुनियादी बातें—आर्किटेक्चर, फीचर्स, और सेटअप—समझाऊँगा, और शुरुआत करने में मदद के लिए व्यावहारिक उदाहरण दूँगा।
Delta Lake एक ओपन-सोर्स स्टोरेज लेयर है जिसे Apache Spark के साथ इंटीग्रेट करने के लिए डिज़ाइन किया गया है, जिससे यह Spark इकोसिस्टम का उपयोग करने वाली टीमों के लिए पसंदीदा समाधान बनता है। यह बड़े डेटा परिवेश में ACID (Atomicity, Consistency, Isolation, Durability) ट्रांजैक्शन लाता है।
मजबूत मेटाडेटा प्रबंधन, वर्ज़न कंट्रोल, और स्कीमा प्रवर्तन सक्षम करके, Delta Lake डेटा लेकहाउस को बेहतर बनाता है और एनालिटिक्स तथा मशीन लर्निंग वर्कलोड के लिए उच्च डेटा गुणवत्ता सुनिश्चित करता है।
Delta Lake पारंपरिक डेटा आर्किटेक्चर, विशेषकर Lambda आर्किटेक्चर, में सुधार करता है, बैच और स्ट्रीमिंग डेटा प्रोसेसिंग को एकल, ACID-अनुपालक फ्रेमवर्क में एकीकृत करके।
Delta Lake का उपयोग करने वाले डेटा प्लेटफ़ॉर्म आमतौर पर मेडेलियन आर्किटेक्चर का पालन करते हैं, जो हमारे डेटा को तीन तार्किक लेयर में संगठित करता है, जिन्हें इस प्रकार परिभाषित किया जाता है:
गोल्ड टेबल को बिज़नेस इंटेलिजेंस टूल्स द्वारा उपभोग किया जा सकता है, जिससे रीयल-टाइम एनालिटिक्स सक्षम होता है और निर्णय लेने में सहायता मिलती है।
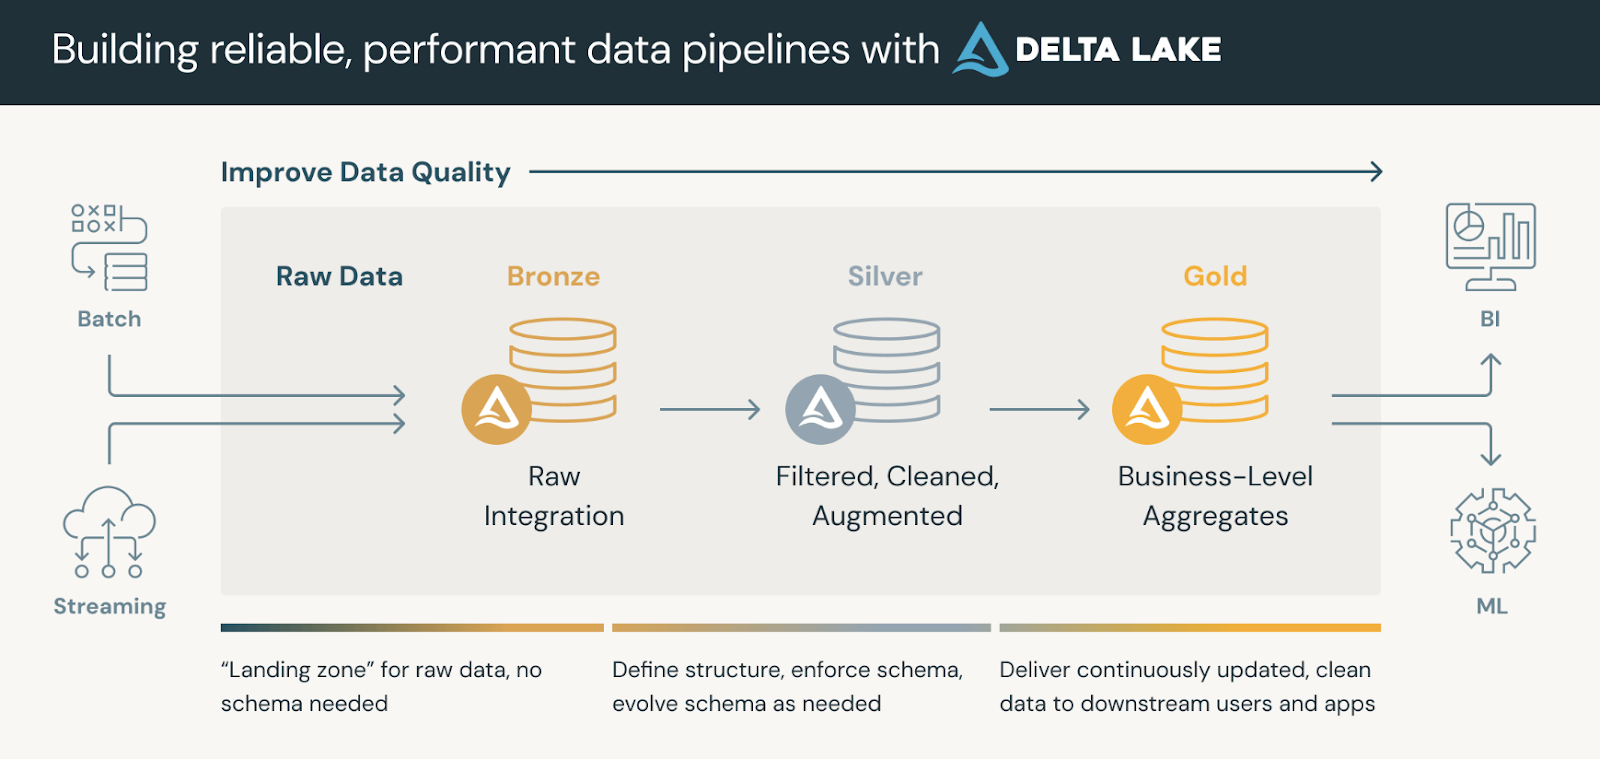
मेडेलियन आर्किटेक्चर। इमेज स्रोत: Databricks
Delta Lake top of Apache Parquet पर बना है, जो एक कॉलमनर स्टोरेज फ़ॉर्मेट है जो कुशल क्वेरी, कंप्रेशन, और स्कीमा एवोल्यूशन सक्षम करता है। हालांकि, जो Delta Lake को मानक Parquet-आधारित डेटा लेक से अलग करता है वह है DeltaLog, a ट्रांजैक्शन लॉग जो किसी डेटा सेट में किए गए सभी परिवर्तनों का इतिहास रखता है।
Delta Lake फ़ाइल फ़ॉर्मेट के मुख्य घटक शामिल हैं:
_delta_log/):जैसा कि आप देख सकते हैं, DeltaLog के बिना, मानक Parquet-आधारित डेटा लेक में ACID ट्रांजैक्शन नहीं होते और वे समवर्ती संशोधनों को सुरक्षित रूप से संभाल नहीं सकते। Delta Lake का फ़ाइल फ़ॉर्मेट स्ट्रीमिंग और बैच प्रोसेसिंग को सुसंगतता बनाए रखते हुए सह-अस्तित्व की अनुमति देता है। अंततः, मर्ज-ऑन-रीड, कॉम्पैक्शन, और ऑप्टिमाइज़्ड मेटाडेटा क्वेरी जैसी विशेषताएँ Delta टेबल को बड़े पैमाने की एनालिटिक्स के लिए अत्यंत कुशल बनाती हैं।
चलिए Delta Lake की सेटअप में डुबकी लगाते हैं! मैं इसे दो सरल चरणों में बाँटूँगा:
शुरू करने के लिए, सुनिश्चित करें कि आपके पास Apache Spark का वातावरण हो। फिर (यदि आप Python का उपयोग कर रहे हैं)
निम्न कमांड से Delta Lake पैकेज इंस्टॉल करें:
pip install pyspark delta-sparkउपरोक्त कमांड delta-spark पैकेज इंस्टॉल करता है, जो आपकी Spark सेशन को आवश्यक Delta Lake इंटीग्रेशन से लैस करता है।
पैकेज इंस्टॉल करने के बाद, अपनी Spark सेशन को Delta Lake उपयोग करने के लिए
इन सेटिंग्स से कॉन्फ़िगर करें:
from pyspark.sql import SparkSession

# Initialize a SparkSession with Delta support
spark = SparkSession.builder \
    .appName("DeltaLakePractice") \
    .config("spark.sql.extensions", "io.delta.sql.DeltaSparkSessionExtension") \
    .config("spark.sql.catalog.spark_catalog", "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
    .getOrCreate()

# Check if Spark is working
print("Spark Session Created Successfully!")
यहाँ Spark सेशन दो महत्वपूर्ण कॉन्फ़िगरेशन के साथ सेट है। पहला
Delta Lake SQL एक्सटेंशन सक्षम करता है और दूसरा Delta Lake को डिफॉल्ट
कैटलॉग परिभाषित करता है, यह सुनिश्चित करते हुए कि आपका Delta-फॉर्मेट डेटा सही तरीके से हैंडल हो।
अब मूल बातों पर आते हैं। Delta Lake एक साधारण DataFrame API का उपयोग करके ACID-अनुपालक टेबल बनाने की अनुमति देता है।
Delta फ़ॉर्मेट में DataFrame लिखकर एक Delta टेबल बनाएं:
# Sample DataFrame creation
data = [("Alice", 34), ("Bob", 45), ("Cathy", 29)]
columns = ["name", "age"]
df = spark.createDataFrame(data, columns)

# Save the DataFrame as a Delta table (overwrite mode replaces any existing data)
df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
ऊपर दिया गया कोड स्निपेट एक बेसिक DataFrame बनाता है और उसे निर्दिष्ट पथ पर Delta फ़ॉर्मेट में लिखता है। mode("overwrite") का उपयोग यह सुनिश्चित करता है कि कोई भी मौजूदा डेटा प्रतिस्थापित हो जाए।
एक बार Delta टेबल बन जाने पर, इसका डेटा इस प्रकार पढ़ें:
# Load the Delta table from a specified path
delta_df = spark.read.format("delta").load("/path/to/delta/table")
delta_df.show()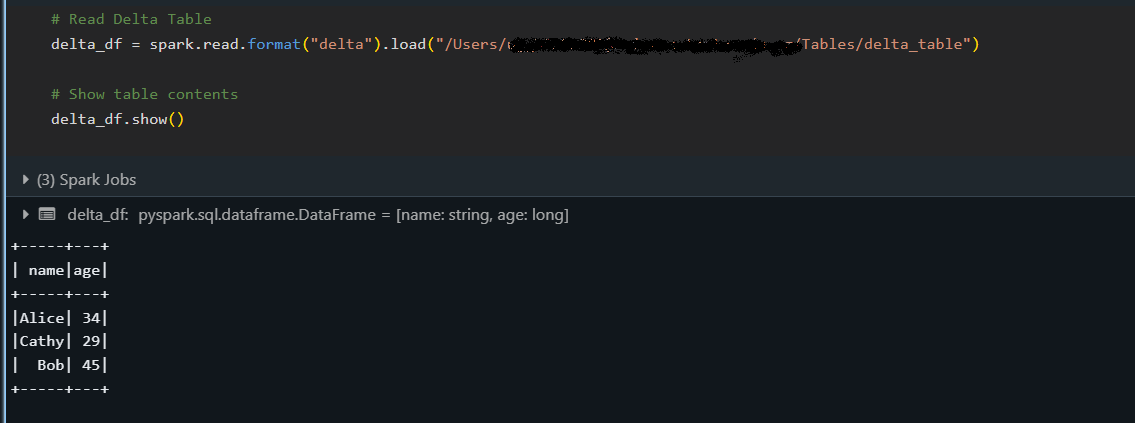
ऊपर दिया गया स्निपेट Delta टेबल को DataFrame में लोड करता है और show() मेथड से उसकी सामग्री दिखाता है, यह पुष्टि करते हुए कि डेटा सही तरीके से पढ़ा गया है।
Delta Lake कई write मोड को सपोर्ट करता है, जिससे आप नए रिकॉर्ड क्रमिक रूप से जोड़ सकते हैं (append) या मौजूदा डेटा को प्रतिस्थापित कर सकते हैं (overwrite), और यह सब ACID गारंटी बनाए रखते हुए।
मौजूदा Delta टेबल में नया डेटा जोड़ें:
# New data to append
new_data = [("David", 40)]
new_df = spark.createDataFrame(new_data, columns)

# Append data to the existing Delta table
new_df.write.format("delta").mode("append").save("/path/to/delta/table")
मोड "append" मौजूदा डेटा को प्रभावित किए बिना टेबल में नई पंक्तियाँ जोड़ने के लिए उपयोग किया जाता है।
अपडेटेड डेटा के साथ पूरी Delta टेबल को ओवरराइट करें:
# Updated data for overwrite
updated_data = [("Alice", 35), ("Bob", 46), ("Cathy", 30)]
updated_df = spark.createDataFrame(updated_data, columns)

# Overwrite the current contents of the Delta table
updated_df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
"overwrite" मोड का उपयोग Delta टेबल की सामग्री को पूरी तरह से नए अपडेटेड DataFrame से प्रतिस्थापित करता है।
यह अनुभाग Delta Lake की बेसिक ऑपरेशन से आगे की कुछ शक्तिशाली क्षमताओं को कवर करता है।
खास तौर पर, हम देखेंगे कि आप अपने डेटा के पिछले संस्करणों को कैसे देख सकते हैं, स्कीमा बदलावों को स्वचालित रूप से कैसे प्रबंधित कर सकते हैं, और कई ऑपरेशनों को एक साथ परमाणुविक रूप से कैसे निष्पादित कर सकते हैं।
Delta Lake की टाइम ट्रैवल सुविधा आपको अपनी टेबल के पिछले संस्करणों तक पहुंचने देती है। Delta टेबल पर हर write ऑपरेशन एक नया वर्ज़न बनाता है, ताकि आप अपने डेटा की पहले की स्थिति पर क्वेरी कर सकें। मैंने इस सुविधा का उपयोग डेटा परिवर्तनों का ऑडिट करने, समस्याओं को डिबग करने, या कुछ गलत होने पर पिछले स्नैपशॉट को रिस्टोर करने के लिए किया है।
# Querying an earlier version (version 0) of the Delta table:
historical_df = spark.read.format("delta") \
    .option("versionAsOf", 0) \
    .load("/path/to/delta/table")
historical_df.show()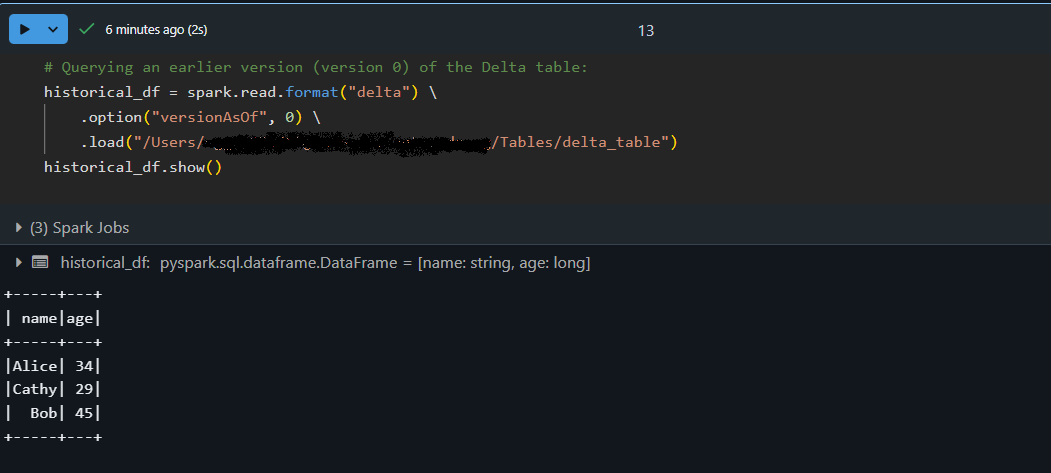
जैसे-जैसे डेटासेट विकसित होते हैं, नए कॉलम जोड़े जा सकते हैं। Delta Lake स्वचालित रूप से स्कीमा विकसित कर सकता है, नए फ़ील्ड को मौजूदा टेबल में मर्ज करते हुए डेटा संगति लागू करता है। इसका मतलब है कि आपको हर बार डेटा संरचना बदलने पर अपनी टेबल को फिर से नहीं बनाना या मैन्युअल रूप से समायोजित नहीं करना पड़ता।
आइए स्वचालित स्कीमा एवोल्यूशन का उपयोग करके अपडेटेड स्कीमा के साथ डेटा ऐपेंड करें:
# Create a DataFrame with an additional "country" column:
new_data = [("Alice", 34, "USA"), ("Bob", 45, "Canada")]
columns = ["name", "age", "country"]
new_df = spark.createDataFrame(new_data, columns)

# Append the new data to the Delta table with schema evolution enabled:
new_df.write.format("delta") \
    .mode("append") \
    .option("mergeSchema", "true") \
    .save("/path/to/delta/table")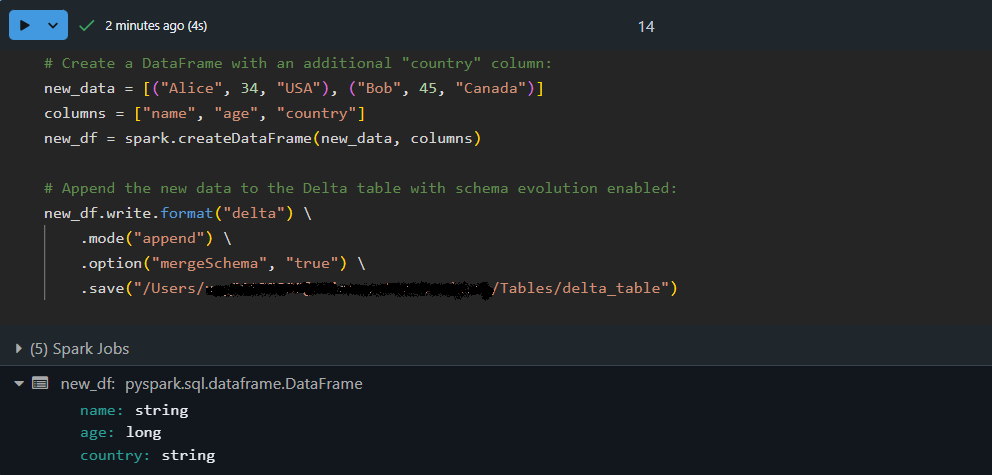
यहाँ new_df DataFrame में एक अतिरिक्त कॉलम country है। option("mergeSchema", "true") का उपयोग करके, Delta Lake इंजन टेबल के स्कीमा को अपने-आप अपडेट करता है ताकि नए कॉलम को समायोजित किया जा सके, और डेटा को सुरक्षित रूप से ऐपेंड किया जा सके!
Delta Lake के ACID ट्रांजैक्शन यह गारंटी देते हैं कि जटिल ऑपरेशन उच्च समवर्तीता के बावजूद भी विश्वसनीय रूप से निष्पादित हों। इसका अर्थ है कि ऑपरेशनों की श्रृंखला (जैसे अपडेट और इन्सर्ट) को एक एकल इकाई के रूप में माना जाता है। यदि ट्रांजैक्शन का कोई भाग विफल होता है, तो कोई परिवर्तन लागू नहीं होता, जिससे आपका डेटा सुसंगत बना रहता है।
आइए MERGE ऑपरेशन के साथ एक एटॉमिक ट्रांजैक्शन करें:
-- Execute a MERGE statement in SQL to update or insert data atomically:
MERGE INTO delta./path/to/delta/table AS target
USING (SELECT 'Alice' AS name, 35 AS age, 'USA' AS country) AS source
ON target.name = source.name AND target.country IS NULL
WHEN MATCHED THEN
   UPDATE SET target.age = source.age, target.country = source.country
WHEN NOT MATCHED THEN
   INSERT (name, age, country) VALUES (source.name, source.age, source.country)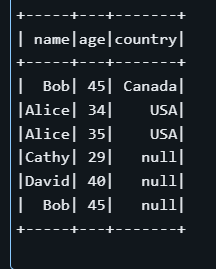
ऊपर दिए गए उदाहरण में, MERGE स्टेटमेंट लक्ष्य टेबल में उन पंक्तियों को खोजता है जहाँ नाम मेल खाता है और country फ़ील्ड NULL है। यदि मेल मिलता है, तो यह पंक्ति को अपडेट करता है; अन्यथा, एक नया रिकॉर्ड इन्सर्ट करता है।
ध्यान दें कि भले ही टेबल में पहले से “Alice” के लिए एक पंक्ति मौजूद हो, शर्त target.country IS NULL ऑपरेशन को गैर-शून्य country वाली पंक्ति को अपडेट करने के बजाय एक नई पंक्ति इन्सर्ट करने का कारण बन सकती है। यह उदाहरण ट्रांजैक्शनल ऑपरेशनों में मिलान मानदंड को सावधानीपूर्वक परिभाषित करने के महत्व को दर्शाता है।
यहाँ वे सर्वोत्तम अभ्यास हैं जो मैं Delta Lake के साथ काम करते समय अपनाता हूँ। ये आपको कुशल और अनुरक्षित डेटा पाइपलाइन बनाने में मदद कर सकते हैं।
अपने Delta टेबल का पार्टिशनिंग करना बड़े डेटासेट से निपटते समय क्वेरी प्रदर्शन को काफी हद तक सुधार सकता है।
टिप: DataFrame लिखते समय .partitionBy("column_name") विकल्प का उपयोग करें ताकि डेटा को छोटे, अधिक प्रबंधनीय हिस्सों में बाँटा जा सके (उदाहरण के लिए, दिनांक या श्रेणी के अनुसार)। यह तरीका सामान्य क्वेरी के दौरान स्कैन किए जाने वाले डेटा की मात्रा को कम करता है।
Delta Lake आपकी टेबल पर सभी ऑपरेशनों का मेटाडेटा बनाए रखने के लिए ट्रांजैक्शन लॉग (_delta_log) का उपयोग करता है।
टिप: समय-समय पर मेंटेनेंस ऑपरेशन (जैसे VACUUM कमांड) शेड्यूल करें ताकि अप्रचलित डेटा फाइलें हटाई जा सकें और मेटाडेटा सुगम हो। इससे क्वेरी प्रदर्शन तेज होता है और बड़े डेटासेट का प्रबंधन आसान होता है।
Z-ordering एक डेटा क्लस्टरिंग तकनीक है जो विशेष कॉलम पर फ़िल्टरिंग के समय क्वेरी दक्षता सुधारने के लिए डिस्क पर डेटा को व्यवस्थित करती है:
OPTIMIZE delta./path/to/delta/table
ZORDER BY (name, age);
ऊपर दिया गया SQL कमांड Delta Lake को name और age कॉलम के आधार पर डेटा को भौतिक रूप से पुनर्व्यवस्थित करने के लिए कहता है। समान मानों को साथ रखकर, इन कॉलमों पर फ़िल्टर करने वाली क्वेरी कम डेटा स्कैन करती हैं और तेज़ चलती हैं।
Delta Lake के साथ काम करते समय, आपको कभी-कभी बाधाएँ मिल सकती हैं। कुंजी यह है कि इन चुनौतियों को अपनी समझ गहरी करने और तकनीक में महारत हासिल करने के अवसर के रूप में लें। यहाँ मेरे कुछ व्यावहारिक इनसाइट और टिप्स हैं जो आपको फिर से ट्रैक पर लाने में मदद करेंगे।
आपको स्कीमा असंगतता या पार्टिशन अलाइनमेंट जैसी समस्याएँ मिल सकती हैं। उदाहरण के लिए, यदि आपका आने वाला डेटा टेबल स्कीमा से मेल नहीं खाता, तो write ऑपरेशन के दौरान त्रुटियाँ दिख सकती हैं। Delta Lake को समायोजित करने देने के लिए mergeSchema जैसे विकल्पों का उपयोग करने पर विचार करें।
साथ ही, यदि आपकी क्वेरी का प्रदर्शन गिरता है, तो जाँचें कि आपका डेटा इष्टतम रूप से पार्टिशन किया गया है या नहीं, या VACUUM जैसी मेंटेनेंस कमांड अप्रचलित फाइलों को हटाने में मदद कर सकती है या नहीं।
जब चीजें अपेक्षा के अनुरूप काम न करें, तो चिंतित न हों—यह प्रक्रिया का हिस्सा है! एक शानदार पहला कदम ट्रांजैक्शन लॉग (_delta_log डायरेक्टरी) का निरीक्षण करना है। यह लॉग ट्रांजैक्शन का विस्तृत इतिहास प्रदान करता है और यह पता लगाने में मदद कर सकता है कि कब और कहाँ चीजें बिगड़ीं।
इसके अलावा, यदि आप असंगतियाँ या अप्रत्याशित परिवर्तन देखते हैं, तो विभिन्न टेबल संस्करणों की तुलना करने के लिए टाइम ट्रैवल का उपयोग करने का प्रयास करें। यह तरीका आपको समस्या को अलग करने और त्रुटि तक पहुँचने वाली घटनाओं को समझने में मदद करेगा।
Delta Lake कई फायदे लाता है—मजबूत ACID ट्रांजैक्शन और कुशल मेटाडेटा प्रबंधन से लेकर टाइम ट्रैवल और स्कीमा एवोल्यूशन जैसी विशेषताओं तक—जो आपको लचीली और स्केलेबल डेटा पाइपलाइन बनाने में सक्षम बनाते हैं। Apache Spark के साथ इसका इंटीग्रेशन मतलब है कि यदि आप पहले से Spark इकोसिस्टम में निवेशित हैं, तो Delta Lake आपके वर्कफ़्लो को सुव्यवस्थित करने का उत्तम जोड़ हो सकता है।
जो लोग अपनी समझ को और गहरा करना चाहते हैं, मैं DataCamp पर आगे के संसाधन देखने की सलाह देता हूँ:
सीखते रहिए, और आपके डेटा सफर के लिए शुभकामनाएँ!
इन कोर्स के साथ डेटा इंजीनियरिंग के बारे में और जानें!
लर्निंग पाथ
कोर्स
कोर्स