
Last chance! 50% off DataCamp Premium
Sale ends in
Datalakes zijn de gouden standaard voor het opslaan van enorme hoeveelheden gestructureerde en ongestructureerde data, maar hebben vaak moeite met datainconsistentie, schema-evolutie en prestatieproblemen. Delta Lake lost deze uitdagingen op door ACID-transacties, schemahandhaving en schaalbare dataverwerking boven op Apache Spark toe te voegen.
In deze tutorial leg ik de basis van Delta Lake uit, inclusief de architectuur, features en installatie, met praktische voorbeelden om je op weg te helpen.
Delta Lake is een open-source opslaglaag die is ontworpen om te integreren met Apache Spark, waardoor het een voorkeursoplossing is voor teams die het Spark-ecosysteem gebruiken. Het introduceert ACID (Atomicity, Consistency, Isolation, Durability)-transacties in big-dataomgevingen.
Door betrouwbaar metadatabeheer, versiebeheer en schemahandhaving mogelijk te maken, versterkt Delta Lake data lakehouses en zorgt het voor hoge datakwaliteit voor analytics- en machine learning-workloads.
Delta Lake verbetert traditionele data-architecturen, met name de Lambda-architectuur, door batch- en streamingdataverwerking te verenigen in één, ACID-conform framework.
Dataplatformen die Delta Lake gebruiken, volgen meestal een medaillonarchitectuur, die onze data indeelt in drie logische lagen, als volgt gedefinieerd:
Gold-tabellen kunnen worden geconsumeerd door business intelligence-tools, waardoor real-time analytics mogelijk wordt en besluitvorming wordt ondersteund.
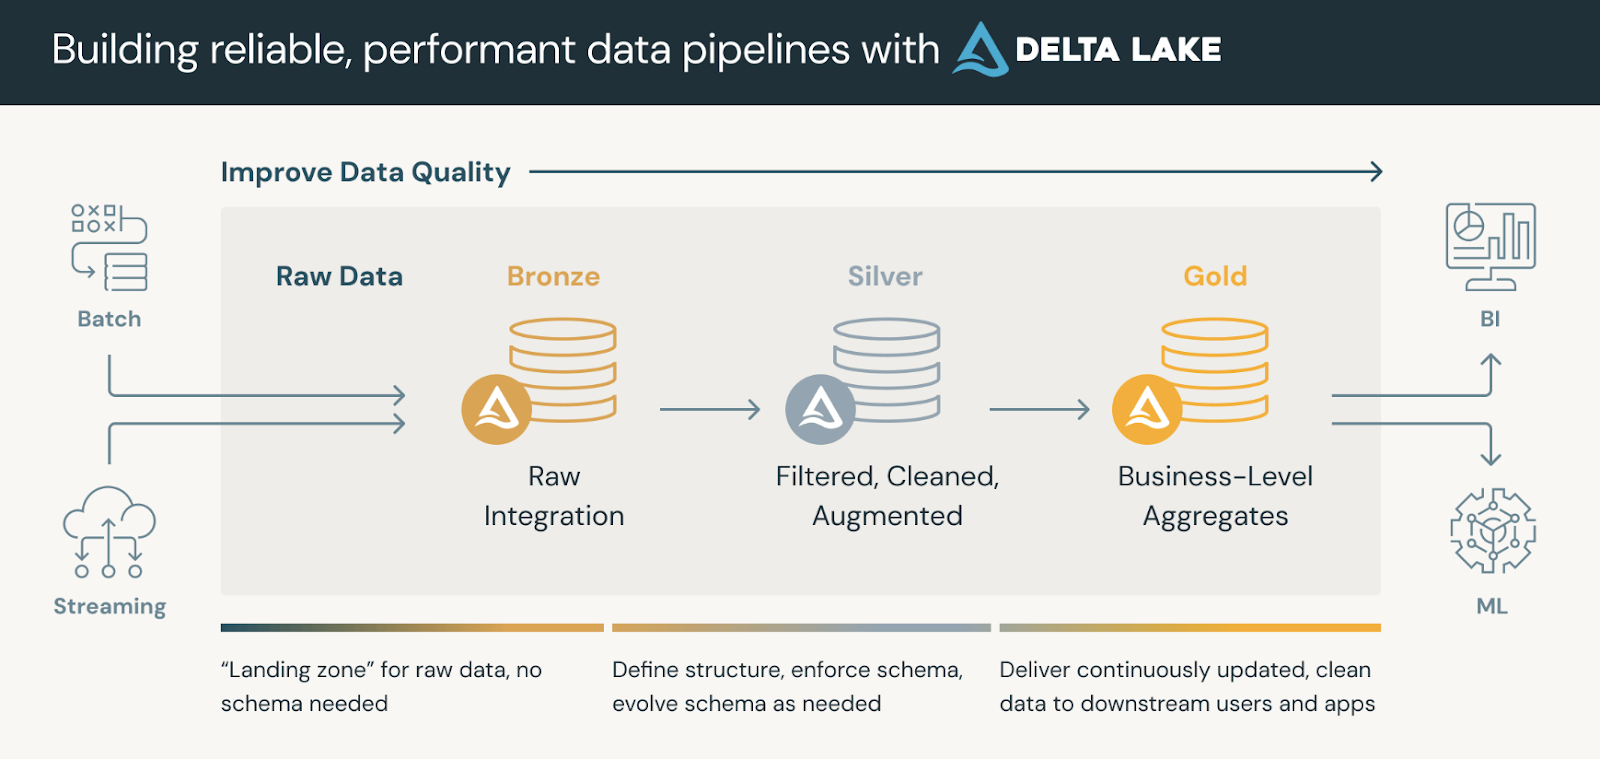
De medaillonarchitectuur. Beeldbron: Databricks
Delta Lake is gebouwd boven op Apache Parquet, een kolomnair bestandsformaat dat efficiënte querying, compressie en schema-evolutie mogelijk maakt. Wat Delta Lake echter onderscheidt van standaard Parquet-gebaseerde datalakes is de DeltaLog, een transactielog die een geschiedenis bijhoudt van alle wijzigingen die in een dataset zijn aangebracht.
Kernonderdelen van de Delta Lake-bestandsindeling zijn onder meer:
_delta_log/):Zoals je ziet, missen standaard Parquet-gebaseerde datalakes zonder de DeltaLog ACID-transacties en kunnen ze gelijktijdige wijzigingen niet veilig afhandelen. Het bestandsformaat van Delta Lake maakt het mogelijk dat streaming en batchverwerking naast elkaar bestaan met behoud van consistentie. Tot slot zorgen features zoals merge-on-read, compactie en geoptimaliseerde metadataqueries ervoor dat Delta-tabellen zeer efficiënt zijn voor grootschalige analytics.
Laten we aan de slag gaan met het instellen van Delta Lake! Ik deel het op in twee eenvoudige stappen:
Zorg eerst dat je een Apache Spark-omgeving hebt. Installeer vervolgens het
Delta Lake-pakket (als je Python gebruikt) met het volgende commando:
pip install pyspark delta-sparkBovenstaand commando installeert het delta-spark-pakket, dat je Spark-sessie voorziet van de nodige Delta Lake-integraties.
Na installatie van het pakket configureer je je Spark-sessie om Delta Lake te gebruiken met
deze instellingen:
from pyspark.sql import SparkSession

# Initialize a SparkSession with Delta support
spark = SparkSession.builder \
    .appName("DeltaLakePractice") \
    .config("spark.sql.extensions", "io.delta.sql.DeltaSparkSessionExtension") \
    .config("spark.sql.catalog.spark_catalog", "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
    .getOrCreate()

# Check if Spark is working
print("Spark Session Created Successfully!")
Hier is de Spark-sessie opgezet met twee cruciale configuraties. De eerste schakelt
Delta Lake SQL-extensies in en de tweede definieert Delta Lake als de standaard
catalogus, zodat je Delta-formaat data correct wordt afgehandeld.
Laten we nu de basis doornemen. Met Delta Lake kun je ACID-conforme tabellen maken met een eenvoudige DataFrame-API.
Maak een Delta-tabel door een DataFrame in Delta-formaat weg te schrijven:
# Sample DataFrame creation
data = [("Alice", 34), ("Bob", 45), ("Cathy", 29)]
columns = ["name", "age"]
df = spark.createDataFrame(data, columns)

# Save the DataFrame as a Delta table (overwrite mode replaces any existing data)
df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
De bovenstaande code maakt een basic DataFrame en schrijft dit naar een opgegeven pad in Delta-formaat. Met mode("overwrite") vervang je eventuele bestaande data.
Zodra een Delta-tabel is gemaakt, lees je de data als volgt:
# Load the Delta table from a specified path
delta_df = spark.read.format("delta").load("/path/to/delta/table")
delta_df.show()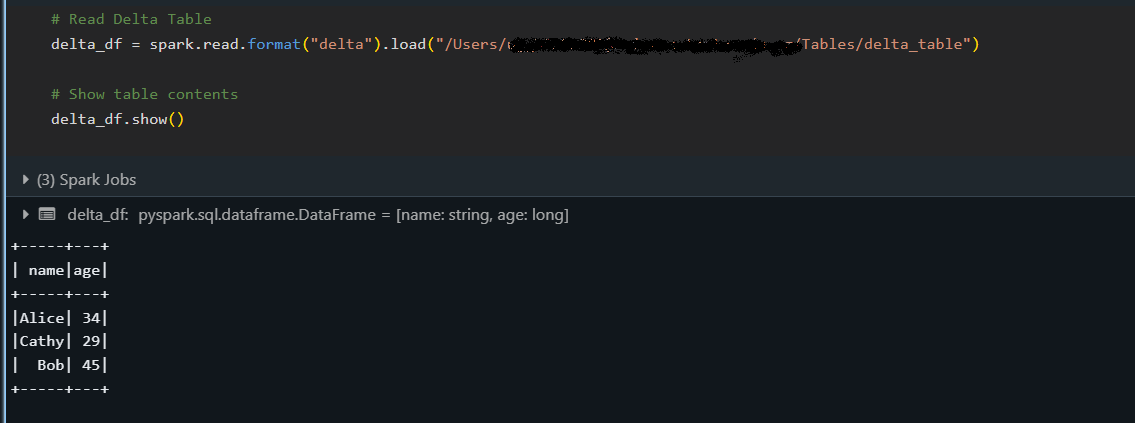
De snippet hierboven laadt de Delta-tabel in een DataFrame en toont de inhoud met de show()-methode, als bevestiging dat de data correct is gelezen.
Delta Lake ondersteunt meerdere schrijfmodes, zodat je nieuwe records incrementeel kunt toevoegen (append) of bestaande data kunt vervangen (overwrite), met behoud van ACID-garanties.
Voeg nieuwe data toe aan een bestaande Delta-tabel:
# New data to append
new_data = [("David", 40)]
new_df = spark.createDataFrame(new_data, columns)

# Append data to the existing Delta table
new_df.write.format("delta").mode("append").save("/path/to/delta/table")
De modus "append" wordt gebruikt om nieuwe rijen toe te voegen aan de tabel zonder de bestaande data te beïnvloeden.
Overschrijf de hele Delta-tabel met bijgewerkte data:
# Updated data for overwrite
updated_data = [("Alice", 35), ("Bob", 46), ("Cathy", 30)]
updated_df = spark.createDataFrame(updated_data, columns)

# Overwrite the current contents of the Delta table
updated_df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
Met de "overwrite"-modus vervang je de inhoud van de Delta-tabel volledig door de nieuwe, bijgewerkte DataFrame.
In dit gedeelte behandelen we enkele krachtige functionaliteiten van Delta Lake, naast de basisbewerkingen.
We verkennen met name hoe je terug kunt kijken naar eerdere dataversies, automatisch schemawijzigingen beheert en meerdere bewerkingen atomair kunt uitvoeren.
Met de time travel-functie van Delta Lake kun je eerdere versies van je tabel benaderen. Elke schrijfbewerking op een Delta-tabel creëert een nieuwe versie, zodat je een eerdere staat van je data kunt bevragen. Ik heb deze feature gebruikt om datawijzigingen te auditen, problemen te debuggen of een vorige snapshot te herstellen als er iets misgaat.
# Querying an earlier version (version 0) of the Delta table:
historical_df = spark.read.format("delta") \
    .option("versionAsOf", 0) \
    .load("/path/to/delta/table")
historical_df.show()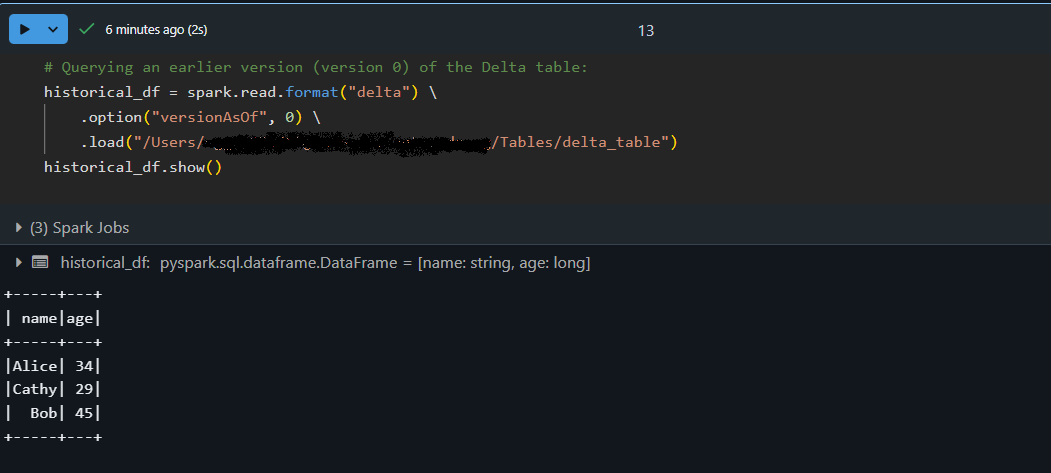
Naarmate datasets evolueren, kunnen er nieuwe kolommen bijkomen. Delta Lake kan het schema automatisch laten meegroeien door nieuwe velden in een bestaande tabel te mergen, terwijl de data consistent blijft. Dit betekent dat je je tabel niet hoeft te recreëren of handmatig aan te passen wanneer je datastructuur verandert.
Laten we data toevoegen met een bijgewerkt schema via automatische schema-evolutie:
# Create a DataFrame with an additional "country" column:
new_data = [("Alice", 34, "USA"), ("Bob", 45, "Canada")]
columns = ["name", "age", "country"]
new_df = spark.createDataFrame(new_data, columns)

# Append the new data to the Delta table with schema evolution enabled:
new_df.write.format("delta") \
    .mode("append") \
    .option("mergeSchema", "true") \
    .save("/path/to/delta/table")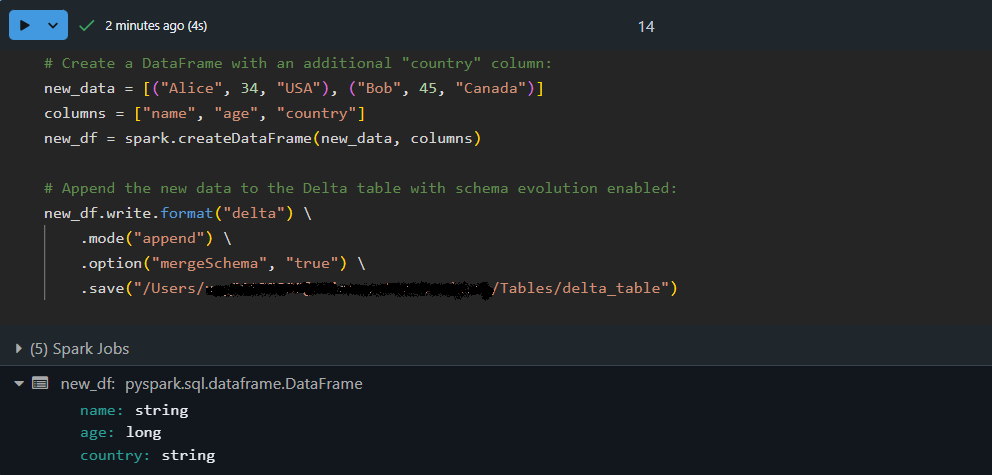
Hier bevat het DataFrame new_df een extra kolom, country. Door option("mergeSchema", "true") te gebruiken, werkt de Delta Lake-engine automatisch het schemas van de tabel bij om de nieuwe kolom op te nemen, terwijl de data veilig wordt toegevoegd!
ACID-transacties in Delta Lake garanderen dat complexe operaties betrouwbaar worden uitgevoerd — zelfs bij hoge gelijktijdigheid. Dit betekent dat een reeks bewerkingen (zoals updates en inserts) als één geheel wordt behandeld. Als een deel van de transactie faalt, wordt er niets toegepast, zodat je data consistent blijft.
Laten we een atomaire transactie uitvoeren met een MERGE-operatie:
-- Execute a MERGE statement in SQL to update or insert data atomically:
MERGE INTO delta./path/to/delta/table AS target
USING (SELECT 'Alice' AS name, 35 AS age, 'USA' AS country) AS source
ON target.name = source.name AND target.country IS NULL
WHEN MATCHED THEN
   UPDATE SET target.age = source.age, target.country = source.country
WHEN NOT MATCHED THEN
   INSERT (name, age, country) VALUES (source.name, source.age, source.country)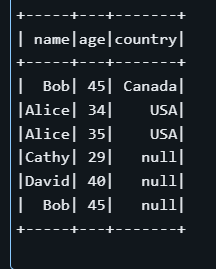
In het bovenstaande voorbeeld zoekt de MERGE-instructie naar rijen in de doeltabel waar de naam overeenkomt en het veld country NULL is. Als er een match is, wordt de rij bijgewerkt; anders wordt er een nieuw record ingevoegd.
Let op dat, ook al staat er mogelijk al een rij voor „Alice” in de tabel, de voorwaarde target.country IS NULL ertoe kan leiden dat de operatie een nieuwe rij invoegt in plaats van een rij met een niet-lege country bij te werken. Dit voorbeeld laat zien hoe belangrijk het is om de matchcriteria in transactionele operaties zorgvuldig te definiëren.
Dit zijn de best practices die ik volg wanneer ik met Delta Lake werk. Ze helpen je efficiënte, onderhoudbare datapijplijnen te bouwen.
Het partitioneren van je Delta-tabellen kan de queryprestaties aanzienlijk verbeteren bij grote datasets.
Tip: Gebruik bij het schrijven van je DataFrame de optie .partitionBy("column_name") om je data op te delen in kleinere, beter hanteerbare stukken (bijvoorbeeld op datum of categorie). Deze aanpak vermindert de hoeveelheid data die tijdens typische queries wordt gescand.
Delta Lake gebruikt een transactielog (de _delta_log) om metadata bij te houden voor alle bewerkingen op je tabel.
Tip: Plan periodieke onderhoudsbewerkingen (zoals het VACUUM-commando) om verouderde databestanden te verwijderen en de metadata te stroomlijnen. Dit resulteert in snellere queryprestaties en eenvoudiger beheer van grote datasets.
Z-ordering is een dataclusteringstechniek die data op schijf organiseert om de query-efficiëntie te verbeteren, vooral bij filteren op specifieke kolommen:
OPTIMIZE delta./path/to/delta/table
ZORDER BY (name, age);
Met het bovenstaande SQL-commando instrueer je Delta Lake om de data fysiek te herstructureren op basis van de kolommen name en age. Door vergelijkbare waarden te groeperen, hoeven queries die op deze kolommen filteren minder data te scannen en draaien ze sneller.
Tijdens het werken met Delta Lake kun je af en toe tegen obstakels aanlopen. De kunst is om deze uitdagingen te zien als kansen om je begrip te verdiepen en de technologie te beheersen. Hier zijn enkele van mijn praktische inzichten en tips om je weer op weg te helpen.
Je kunt problemen tegenkomen zoals schema-mismatches of partitie-afstemmingsproblemen. Als je binnenkomende data bijvoorbeeld niet overeenkomt met het tabelschema, kun je fouten zien tijdens schrijfbewerkingen. Overweeg opties zoals mergeSchema te gebruiken zodat Delta Lake zich kan aanpassen.
Controleer ook bij prestatieverlies of je data optimaal is gepartitioneerd of dat een onderhoudscommando zoals VACUUM kan helpen om verouderde bestanden te verwijderen.
Als dingen niet werken zoals verwacht, geen zorgen—het hoort erbij! Een goede eerste stap is het inspecteren van het transactielog (te vinden in de map _delta_log). Dit log biedt een gedetailleerde geschiedenis van transacties en helpt je te achterhalen wanneer en waar het misging.
Als je bovendien inconsistenties of onverwachte wijzigingen opmerkt, probeer dan time travel te gebruiken om verschillende tabelversies te vergelijken. Deze aanpak helpt je het probleem te isoleren en de gebeurtenissen te begrijpen die tot de fout hebben geleid.
Delta Lake biedt tal van voordelen—van robuuste ACID-transacties en efficiënt metadatabeheer tot features zoals time travel en schema-evolutie—die je in staat stellen veerkrachtige en schaalbare datapijplijnen te bouwen. De integratie met Apache Spark betekent dat Delta Lake de perfecte aanvulling kan zijn om je workflows te stroomlijnen als je al in het Spark-ecosysteem werkt.
Voor wie zijn kennis verder wil verdiepen, raad ik aan om meer bronnen op DataCamp te verkennen:
Veel leerplezier en succes met je datareis!
Leer meer over data engineering met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min


