
Programma
Ingegnere dei dati in Python
40 ore
I data lake sono lo standard per archiviare grandi quantità di dati strutturati e non strutturati, ma spesso soffrono di inconsistenza, difficoltà nell’evoluzione dello schema e problemi di performance. Delta Lake risolve queste sfide aggiungendo transazioni ACID, enforcement degli schemi e data processing scalabili su Apache Spark.
In questo tutorial ti spiegherò le basi di Delta Lake, inclusi architettura, funzionalità e configurazione, con esempi pratici per aiutarti a iniziare.
Delta Lake è un progetto open-source per lo strato di storage progettato per integrarsi con Apache Spark, il che lo rende una soluzione preferita per i team che utilizzano l’ecosistema Spark. Introduce transazioni ACID (Atomicità, Consistenza, Isolamento, Durabilità) negli ambienti big data.
Abilitando una gestione robusta dei metadati, il controllo di versione e l’enforcement dello schema, Delta Lake migliora i data lakehouse e garantisce alta qualità dei dati per carichi analitici e di machine learning.
Delta Lake migliora le architetture dati tradizionali, in particolare la Lambda architecture, unificando l’elaborazione di dati batch e streaming in un unico framework conforme ad ACID.
Le piattaforme dati che usano Delta Lake seguono di solito una medallion architecture, che organizza i dati in tre livelli logici definiti come segue:
Le Gold table possono essere consumate da strumenti di business intelligence, abilitando analytics in tempo reale e supportando le decisioni.
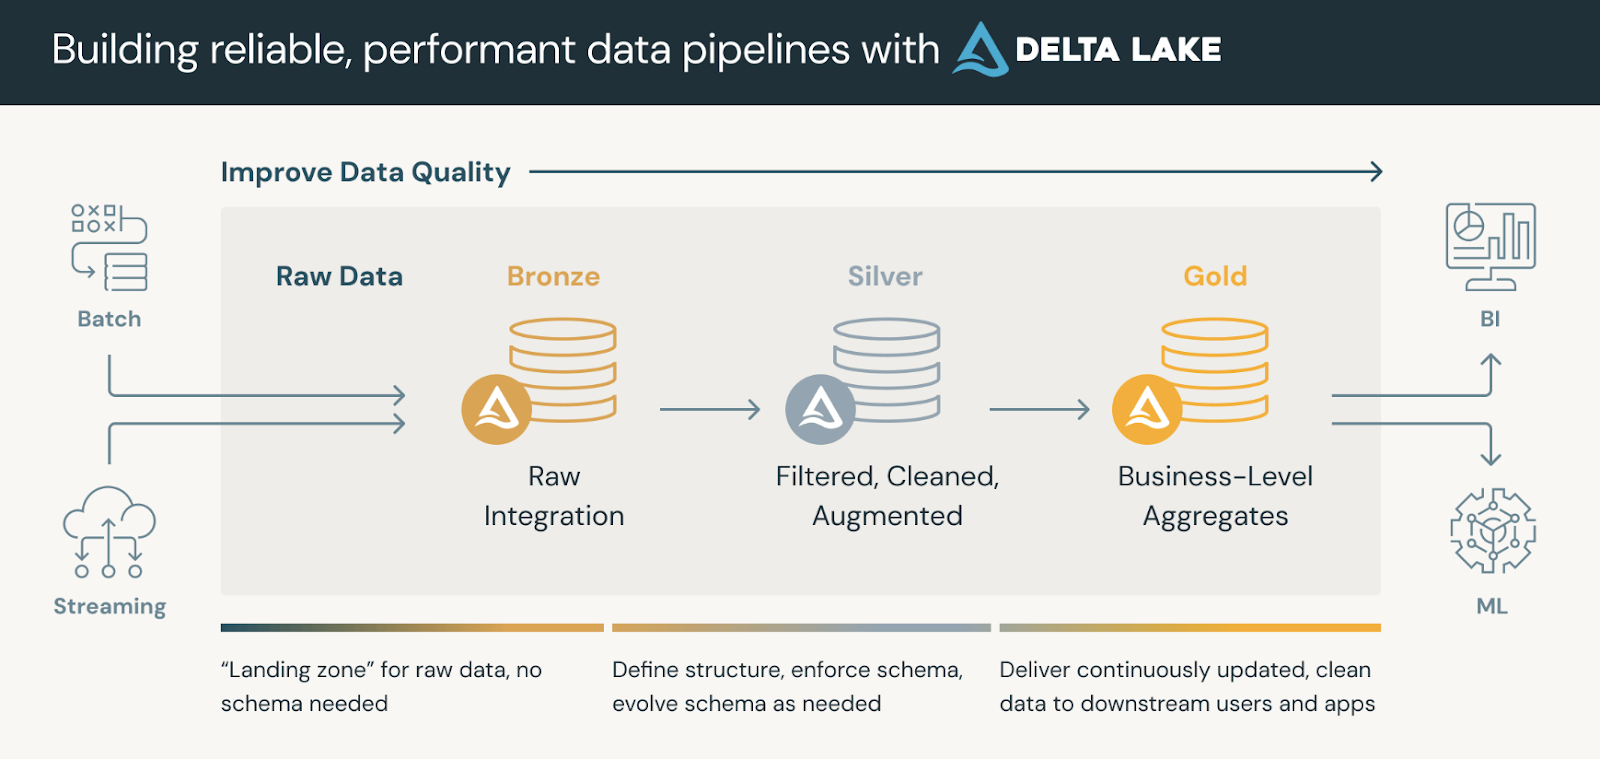
La medallion architecture. Fonte immagine: Databricks
Delta Lake è costruito sopra Apache Parquet, un formato di archiviazione colonnare che abilita query efficienti, compressione ed evoluzione dello schema. Tuttavia, ciò che differenzia Delta Lake dai data lake basati su Parquet standard è il DeltaLog, un registro delle transazioni che mantiene uno storico di tutte le modifiche apportate a un dataset.
I componenti principali del formato file di Delta Lake includono:
_delta_log/):Come puoi vedere, senza il DeltaLog i data lake basati su Parquet standard non dispongono di transazioni ACID e non possono gestire in sicurezza modifiche concorrenti. Il formato file di Delta Lake consente la coesistenza di elaborazioni streaming e batch mantenendo la consistenza. Infine, funzionalità come merge-on-read, compattazione e query sui metadati ottimizzate rendono le tabelle Delta molto efficienti per analytics su larga scala.
Tuffiamoci nella configurazione di Delta Lake! La dividerò in due semplici passaggi:
Per iniziare, assicurati di avere un ambiente Apache Spark. Quindi installa il
pacchetto Delta Lake (se usi Python) con il seguente comando:
pip install pyspark delta-sparkIl comando sopra installa il pacchetto delta-spark, che dota la tua sessione Spark delle integrazioni necessarie con Delta Lake.
Dopo aver installato il pacchetto, configura la tua sessione Spark per usare Delta Lake con
queste impostazioni:
from pyspark.sql import SparkSession

# Initialize a SparkSession with Delta support
spark = SparkSession.builder \
    .appName("DeltaLakePractice") \
    .config("spark.sql.extensions", "io.delta.sql.DeltaSparkSessionExtension") \
    .config("spark.sql.catalog.spark_catalog", "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
    .getOrCreate()

# Check if Spark is working
print("Spark Session Created Successfully!")
Qui, la sessione Spark è configurata con due impostazioni critiche. La prima abilita
le estensioni SQL di Delta Lake e la seconda definisce Delta Lake come
catalog predefinito, assicurando che i tuoi dati in formato Delta siano gestiti correttamente.
Ora passiamo alle basi. Delta Lake ti consente di creare tabelle conformi ad ACID usando una semplice API DataFrame.
Crea una tabella Delta scrivendo un DataFrame in formato Delta:
# Sample DataFrame creation
data = [("Alice", 34), ("Bob", 45), ("Cathy", 29)]
columns = ["name", "age"]
df = spark.createDataFrame(data, columns)

# Save the DataFrame as a Delta table (overwrite mode replaces any existing data)
df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
Lo snippet sopra crea un DataFrame di base e lo scrive in un percorso specificato usando il formato Delta. Usare mode("overwrite") garantisce che eventuali dati esistenti vengano sostituiti.
Una volta creata una tabella Delta, leggi i suoi dati come segue:
# Load the Delta table from a specified path
delta_df = spark.read.format("delta").load("/path/to/delta/table")
delta_df.show()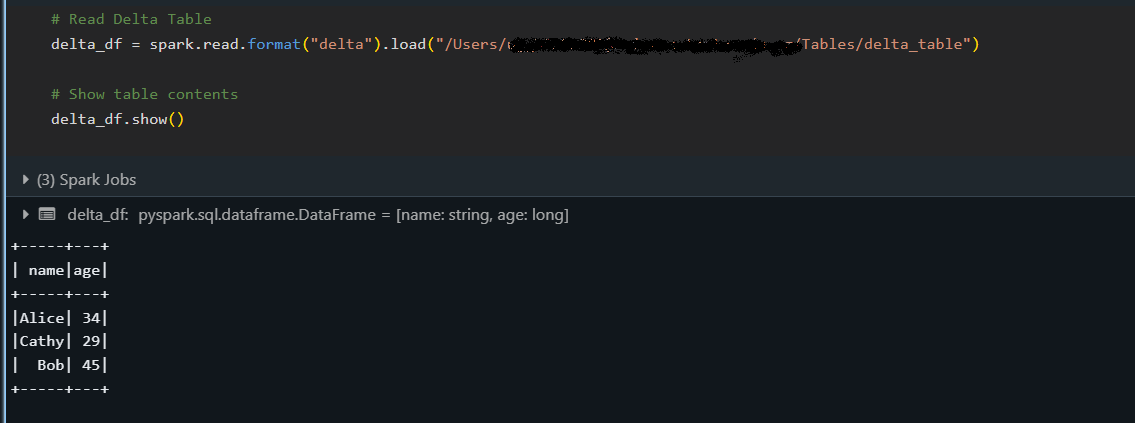
Lo snippet sopra carica la tabella Delta in un DataFrame e ne mostra il contenuto con il metodo show(), confermando che i dati sono stati letti correttamente.
Delta Lake supporta più modalità di scrittura, permettendoti di aggiungere nuovi record in modo incrementale (append) o sostituire i dati esistenti (overwrite) mantenendo le garanzie ACID.
Aggiungi nuovi dati a una tabella Delta esistente:
# New data to append
new_data = [("David", 40)]
new_df = spark.createDataFrame(new_data, columns)

# Append data to the existing Delta table
new_df.write.format("delta").mode("append").save("/path/to/delta/table")
La modalità "append" viene usata per aggiungere nuove righe alla tabella senza influire sui dati esistenti.
Sovrascrivi l’intera tabella Delta con dati aggiornati:
# Updated data for overwrite
updated_data = [("Alice", 35), ("Bob", 46), ("Cathy", 30)]
updated_df = spark.createDataFrame(updated_data, columns)

# Overwrite the current contents of the Delta table
updated_df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
Usando la modalità "overwrite" sostituisci interamente il contenuto della tabella Delta con il nuovo DataFrame aggiornato.
Questa sezione copre alcune delle potenti funzionalità di Delta Lake oltre alle operazioni di base.
In particolare, vedremo come tornare alle versioni passate dei dati, gestire automaticamente i cambiamenti di schema ed eseguire transazioni multi-operazione in modo atomico.
La funzione di time travel di Delta Lake ti consente di accedere a versioni precedenti della tua tabella. Ogni operazione di scrittura su una tabella Delta crea una nuova versione, così puoi interrogare uno stato precedente dei tuoi dati. Io ho usato questa funzione per controllare le modifiche ai dati, fare debug o ripristinare uno snapshot precedente se qualcosa va storto.
# Querying an earlier version (version 0) of the Delta table:
historical_df = spark.read.format("delta") \
    .option("versionAsOf", 0) \
    .load("/path/to/delta/table")
historical_df.show()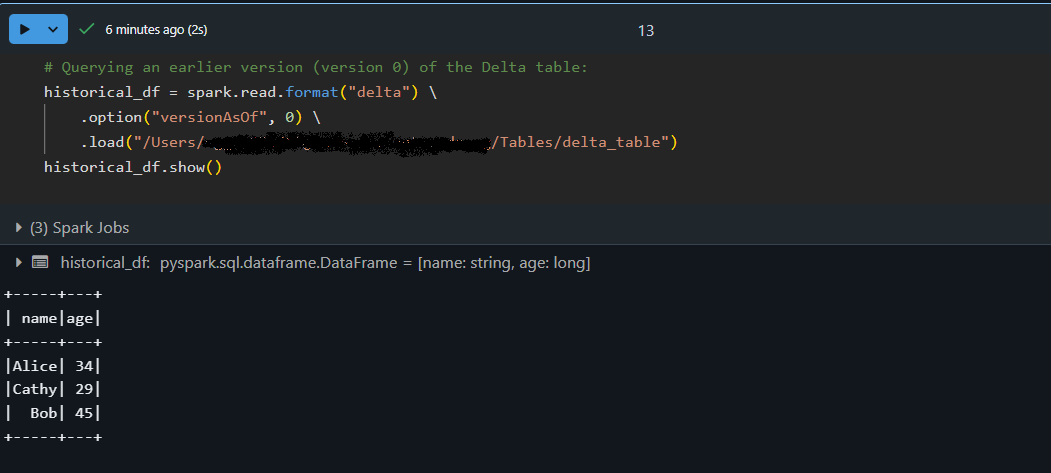
Con l’evoluzione dei dataset, potrebbero essere aggiunte nuove colonne. Delta Lake può evolvere automaticamente lo schema, unendo i nuovi campi a una tabella esistente pur facendo rispettare la consistenza dei dati. Questo significa che non devi ricreare o modificare manualmente la tabella ogni volta che la struttura dei dati cambia.
Ecco come accodare dati con uno schema aggiornato usando l’evoluzione automatica dello schema:
# Create a DataFrame with an additional "country" column:
new_data = [("Alice", 34, "USA"), ("Bob", 45, "Canada")]
columns = ["name", "age", "country"]
new_df = spark.createDataFrame(new_data, columns)

# Append the new data to the Delta table with schema evolution enabled:
new_df.write.format("delta") \
    .mode("append") \
    .option("mergeSchema", "true") \
    .save("/path/to/delta/table")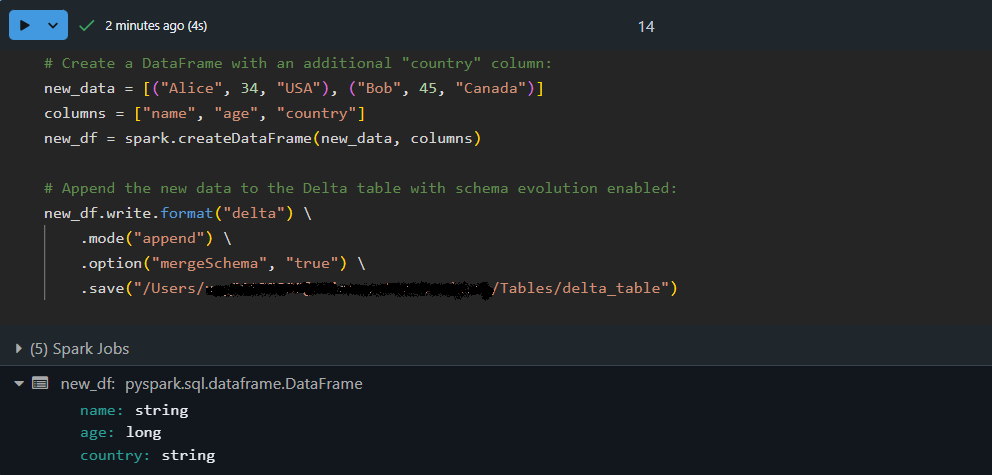
Qui, il DataFrame new_df contiene una colonna extra, country. Usando option("mergeSchema", "true"), il motore di Delta Lake aggiorna automaticamente lo schema della tabella per accogliere la nuova colonna mentre accoda i dati in sicurezza!
Le transazioni ACID di Delta Lake garantiscono che operazioni complesse vengano eseguite in modo affidabile, anche in alta concorrenza. Ciò significa che una serie di operazioni (come update e insert) è trattata come un’unica unità. Se una parte della transazione fallisce, non viene applicata alcuna modifica, assicurando che i dati rimangano consistenti.
Eseguiamo una transazione atomica con un’operazione MERGE:
-- Execute a MERGE statement in SQL to update or insert data atomically:
MERGE INTO delta./path/to/delta/table AS target
USING (SELECT 'Alice' AS name, 35 AS age, 'USA' AS country) AS source
ON target.name = source.name AND target.country IS NULL
WHEN MATCHED THEN
   UPDATE SET target.age = source.age, target.country = source.country
WHEN NOT MATCHED THEN
   INSERT (name, age, country) VALUES (source.name, source.age, source.country)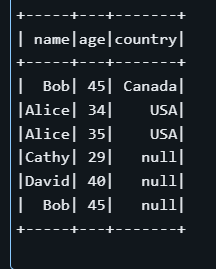
Nell’esempio sopra, l’istruzione MERGE cerca righe nella tabella di destinazione in cui il nome corrisponde e il campo country è NULL. Se trova una corrispondenza, aggiorna la riga; altrimenti, inserisce un nuovo record.
Nota che, anche se nella tabella potrebbe esserci già una riga per “Alice”, la condizione target.country IS NULL può far sì che l’operazione inserisca una nuova riga invece di aggiornare una riga con country non nullo. Questo esempio dimostra l’importanza di definire con attenzione i criteri di matching nelle operazioni transazionali.
Ecco le best practice che seguo quando lavoro con Delta Lake. Possono aiutarti a costruire pipeline dati efficienti e manutenibili.
Partizionare le tue tabelle Delta può migliorare significativamente le prestazioni delle query quando lavori con dataset di grandi dimensioni.
Suggerimento: quando scrivi il tuo DataFrame, usa l’opzione .partitionBy("column_name") per suddividere i dati in blocchi più piccoli e gestibili (ad esempio, per data o categoria). Questo approccio riduce la quantità di dati scansionata durante le query tipiche.
Delta Lake usa un transaction log (il _delta_log) per mantenere i metadati di tutte le operazioni sulla tua tabella.
Suggerimento: pianifica operazioni di manutenzione periodiche (come il comando VACUUM) per rimuovere file obsoleti e snellire i metadati. Ne derivano query più veloci e una gestione più semplice di dataset di grandi dimensioni.
Lo Z-ordering è una tecnica di clustering dei dati che organizza i dati su disco per migliorare l’efficienza delle query, soprattutto quando si filtrano colonne specifiche:
OPTIMIZE delta./path/to/delta/table
ZORDER BY (name, age);
Il comando SQL sopra dice a Delta Lake di riorganizzare fisicamente i dati in base alle colonne name e age. Co-localizzando valori simili, le query che filtrano su queste colonne eseguono meno scansioni e risultano più rapide.
Lavorando con Delta Lake, potresti imbatterti occasionalmente in ostacoli. L’idea chiave è trattare queste sfide come opportunità per approfondire la comprensione e padroneggiare la tecnologia. Ecco alcuni spunti pratici e consigli per rimetterti in carreggiata.
Potresti incontrare problemi come incongruenze di schema o allineamento delle partizioni. Ad esempio, se i dati in ingresso non corrispondono allo schema della tabella, potresti vedere errori durante le scritture. Valuta l’uso di opzioni come mergeSchema per consentire a Delta Lake di adeguarsi.
Inoltre, se le performance delle query calano, verifica se i dati sono partizionati in modo ottimale o se un comando di manutenzione come VACUUM può aiutare a rimuovere file obsoleti.
Quando le cose non funzionano come previsto, niente panico: fa parte del processo! Un ottimo primo passo è ispezionare il transaction log (nella directory _delta_log). Questo log offre uno storico dettagliato delle transazioni e può aiutarti a individuare quando e dove si è verificato il problema.
Inoltre, se noti inconsistenze o cambiamenti inattesi, prova a usare il time travel per confrontare versioni diverse della tabella. Questo approccio ti aiuterà a isolare il problema e a capire gli eventi che hanno portato all’errore.
Delta Lake offre numerosi vantaggi—dalle robuste transazioni ACID e una gestione efficiente dei metadati a funzionalità come time travel ed evoluzione dello schema—che ti consentono di costruire pipeline dati resilienti e scalabili. La sua integrazione con Apache Spark significa che, se sei già investito nell’ecosistema Spark, Delta Lake potrebbe essere l’aggiunta perfetta per snellire i tuoi workflow.
Per chi vuole approfondire, ti invito a esplorare ulteriori risorse su DataCamp:
Buono studio e in bocca al lupo per il tuo percorso nei dati!
Scopri di più sul data engineering con questi corsi!
Programma
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



