
Last chance! 50% off DataCamp Premium
Sale ends in
Buy Now
Hãy bắt tay vào thiết lập Delta Lake! Tôi sẽ chia thành hai bước đơn giản:
Để bắt đầu, hãy đảm bảo bạn có môi trường Apache Spark. Sau đó cài đặt
gói Delta Lake (nếu dùng Python) với lệnh sau:
pip install pyspark delta-sparkLệnh trên cài đặt gói delta-spark, trang bị cho phiên Spark của bạn các tích hợp cần thiết với Delta Lake.
Sau khi cài đặt gói, hãy cấu hình phiên Spark để sử dụng Delta Lake với
các thiết lập sau:
from pyspark.sql import SparkSession
# Initialize a SparkSession with Delta support
spark = SparkSession.builder \
.appName("DeltaLakePractice") \
.config("spark.sql.extensions", "io.delta.sql.DeltaSparkSessionExtension") \
.config("spark.sql.catalog.spark_catalog", "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
.getOrCreate()
# Check if Spark is working
print("Spark Session Created Successfully!")Tại đây, phiên Spark được thiết lập với hai cấu hình trọng yếu. Cấu hình đầu kích hoạt
các phần mở rộng SQL của Delta Lake và cấu hình thứ hai đặt Delta Lake làm
catalog mặc định, đảm bảo dữ liệu định dạng Delta của bạn được xử lý đúng.
Giờ hãy đi vào những điều cơ bản. Delta Lake cho phép bạn tạo các bảng tuân thủ ACID bằng API DataFrame đơn giản.
Tạo một bảng Delta bằng cách ghi một DataFrame theo định dạng Delta:
# Sample DataFrame creation
data = [("Alice", 34), ("Bob", 45), ("Cathy", 29)]
columns = ["name", "age"]
df = spark.createDataFrame(data, columns)
# Save the DataFrame as a Delta table (overwrite mode replaces any existing data)
df.write.format("delta").mode("overwrite").save("/path/to/delta/table")Đoạn mã trên tạo một DataFrame cơ bản và ghi nó vào đường dẫn chỉ định với định dạng Delta. Dùng mode("overwrite") đảm bảo mọi dữ liệu hiện có sẽ được thay thế.
Khi đã tạo bảng Delta, hãy đọc dữ liệu như sau:
# Load the Delta table from a specified path
delta_df = spark.read.format("delta").load("/path/to/delta/table")
delta_df.show()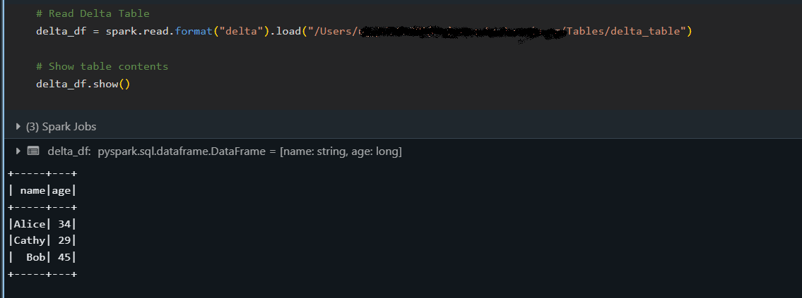
Đoạn mã trên tải bảng Delta vào một DataFrame và hiển thị nội dung bằng phương thức show(), xác nhận dữ liệu đã được đọc chính xác.
Delta Lake hỗ trợ nhiều chế độ ghi, cho phép bạn thêm bản ghi mới (append) theo cách tăng dần hoặc thay thế dữ liệu hiện có (overwrite) trong khi vẫn duy trì đảm bảo ACID.
Thêm dữ liệu mới vào một bảng Delta hiện có:
# New data to append
new_data = [("David", 40)]
new_df = spark.createDataFrame(new_data, columns)
# Append data to the existing Delta table
new_df.write.format("delta").mode("append").save("/path/to/delta/table")Chế độ "append" được dùng để thêm hàng mới vào bảng mà không ảnh hưởng dữ liệu hiện có.
Ghi đè toàn bộ bảng Delta bằng dữ liệu đã cập nhật:
# Updated data for overwrite
updated_data = [("Alice", 35), ("Bob", 46), ("Cathy", 30)]
updated_df = spark.createDataFrame(updated_data, columns)
# Overwrite the current contents of the Delta table
updated_df.write.format("delta").mode("overwrite").save("/path/to/delta/table")Sử dụng chế độ "overwrite" sẽ thay thế hoàn toàn nội dung của bảng Delta bằng DataFrame mới đã cập nhật.
Phần này đề cập đến một số chức năng mạnh mẽ của Delta Lake vượt ra ngoài các thao tác cơ bản.
Cụ thể, chúng ta sẽ khám phá cách bạn có thể nhìn lại các phiên bản dữ liệu trước đó, tự động quản lý thay đổi lược đồ và thực hiện các giao dịch đa thao tác một cách nguyên tử.
Tính năng du hành thời gian của Delta Lake cho phép bạn truy cập các phiên bản trước của bảng. Mỗi thao tác ghi trên bảng Delta tạo ra một phiên bản mới để bạn có thể truy vấn trạng thái dữ liệu trước đó. Tôi đã dùng tính năng này để kiểm toán thay đổi dữ liệu, gỡ lỗi hoặc khôi phục ảnh chụp trước đó nếu có sự cố.
# Querying an earlier version (version 0) of the Delta table:
historical_df = spark.read.format("delta") \
.option("versionAsOf", 0) \
.load("/path/to/delta/table")
historical_df.show()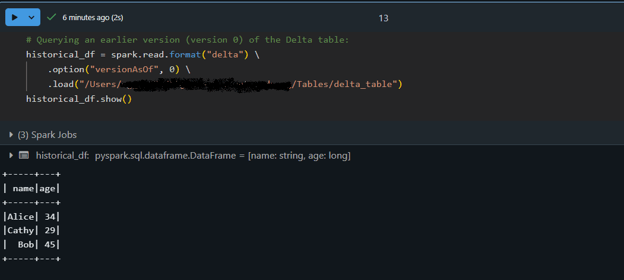
Khi tập dữ liệu phát triển, có thể thêm các cột mới. Delta Lake có thể tự động tiến hóa lược đồ, gộp các trường mới vào một bảng hiện có đồng thời thực thi tính nhất quán. Điều này có nghĩa bạn không phải tạo lại hoặc điều chỉnh thủ công bảng mỗi khi cấu trúc dữ liệu thay đổi.
Hãy thêm dữ liệu với lược đồ đã cập nhật bằng tiến hóa lược đồ tự động:
# Create a DataFrame with an additional "country" column:
new_data = [("Alice", 34, "USA"), ("Bob", 45, "Canada")]
columns = ["name", "age", "country"]
new_df = spark.createDataFrame(new_data, columns)
# Append the new data to the Delta table with schema evolution enabled:
new_df.write.format("delta") \
.mode("append") \
.option("mergeSchema", "true") \
.save("/path/to/delta/table")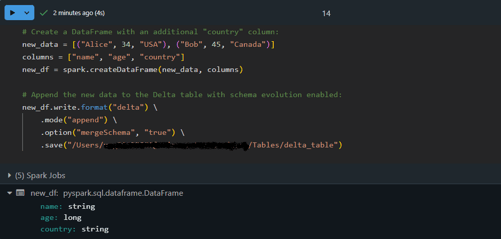
Ở đây, DataFrame new_df chứa một cột bổ sung, country. Bằng cách option("mergeSchema", "true"), công cụ Delta Lake sẽ tự động cập nhật lược đồ của bảng để chứa cột mới trong khi thêm dữ liệu một cách an toàn!
Các giao dịch ACID của Delta Lake đảm bảo rằng các thao tác phức tạp được thực thi đáng tin cậy — ngay cả khi có mức độ đồng thời cao. Điều này có nghĩa một chuỗi thao tác (như cập nhật và chèn) được coi là một đơn vị duy nhất. Nếu bất kỳ phần nào của giao dịch thất bại, sẽ không áp dụng thay đổi nào, đảm bảo dữ liệu của bạn vẫn nhất quán.
Hãy thực hiện một giao dịch nguyên tử với thao tác MERGE:
-- Execute a MERGE statement in SQL to update or insert data atomically:
MERGE INTO delta./path/to/delta/table AS target
USING (SELECT 'Alice' AS name, 35 AS age, 'USA' AS country) AS source
ON target.name = source.name AND target.country IS NULL
WHEN MATCHED THEN
UPDATE SET target.age = source.age, target.country = source.country
WHEN NOT MATCHED THEN
INSERT (name, age, country) VALUES (source.name, source.age, source.country)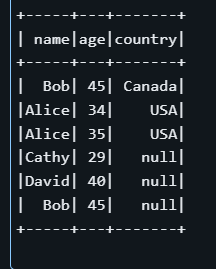
Trong ví dụ trên, câu lệnh MERGE tìm các hàng trong bảng đích nơi tên trùng khớp và trường country bằng NULL. Nếu tìm thấy, nó sẽ cập nhật hàng đó; nếu không, nó sẽ chèn một bản ghi mới.
Lưu ý rằng dù trong bảng có thể đã có một hàng cho “Alice”, điều kiện target.country IS NULL có thể khiến thao tác chèn hàng mới thay vì cập nhật hàng có trường country khác NULL. Ví dụ này cho thấy tầm quan trọng của việc xác định tiêu chí khớp cẩn trọng trong các giao dịch.
Dưới đây là những thực hành tốt tôi áp dụng khi làm việc với Delta Lake. Chúng có thể giúp bạn xây dựng pipeline dữ liệu hiệu quả và dễ bảo trì.
Phân vùng các bảng Delta có thể cải thiện đáng kể hiệu năng truy vấn khi làm việc với tập dữ liệu lớn.
Mẹo: Khi ghi DataFrame, hãy dùng tùy chọn .partitionBy("column_name") để chia dữ liệu thành các phần nhỏ, dễ quản lý hơn (ví dụ theo ngày hoặc danh mục). Cách tiếp cận này giảm lượng dữ liệu phải quét trong các truy vấn điển hình.
Delta Lake sử dụng nhật ký giao dịch (_delta_log) để duy trì siêu dữ liệu cho mọi thao tác trên bảng của bạn.
Mẹo: Lên lịch bảo trì định kỳ (chẳng hạn lệnh VACUUM) để loại bỏ tệp dữ liệu lỗi thời và tinh gọn siêu dữ liệu. Điều này giúp truy vấn nhanh hơn và quản lý tập dữ liệu lớn dễ dàng hơn.
Z-ordering là kỹ thuật gom cụm dữ liệu sắp xếp dữ liệu trên đĩa để cải thiện hiệu quả truy vấn, đặc biệt khi lọc theo các cột cụ thể:
OPTIMIZE delta./path/to/delta/table
ZORDER BY (name, age);Lệnh SQL trên yêu cầu Delta Lake sắp xếp lại dữ liệu vật lý dựa trên các cột name và age. Bằng cách đặt các giá trị tương tự gần nhau, các truy vấn lọc theo những cột này sẽ quét ít dữ liệu hơn và chạy nhanh hơn.
Khi làm việc với Delta Lake, đôi khi bạn có thể gặp trở ngại. Điều quan trọng là xem những thách thức này như cơ hội để hiểu sâu hơn và làm chủ công nghệ. Dưới đây là một số góc nhìn thực tiễn và mẹo của tôi để giúp bạn quay lại đúng hướng.
Bạn có thể gặp các vấn đề như sai lệch lược đồ hoặc không khớp phân vùng. Ví dụ, nếu dữ liệu đầu vào không khớp với lược đồ bảng, bạn có thể gặp lỗi khi ghi. Hãy cân nhắc sử dụng các tùy chọn như mergeSchema để cho phép Delta Lake điều chỉnh.
Ngoài ra, nếu hiệu năng truy vấn giảm, hãy kiểm tra liệu dữ liệu đã được phân vùng tối ưu hay chưa, hoặc lệnh bảo trì như VACUUM có thể giúp loại bỏ tệp lỗi thời.
Khi mọi thứ không hoạt động như mong đợi, đừng lo — đó là một phần của quá trình! Bước đầu tiên tuyệt vời là kiểm tra nhật ký giao dịch (nằm trong thư mục _delta_log). Nhật ký này cung cấp lịch sử giao dịch chi tiết và có thể giúp bạn xác định thời điểm và nơi vấn đề phát sinh.
Ngoài ra, nếu bạn nhận thấy sự không nhất quán hoặc thay đổi bất ngờ, hãy thử dùng du hành thời gian để so sánh các phiên bản bảng khác nhau. Cách này sẽ giúp bạn cô lập vấn đề và hiểu chuỗi sự kiện dẫn đến lỗi.
Delta Lake mang lại nhiều lợi thế — từ giao dịch ACID vững chắc và quản lý siêu dữ liệu hiệu quả đến các tính năng như du hành thời gian và tiến hóa lược đồ — giúp bạn xây dựng pipeline dữ liệu bền bỉ và có khả năng mở rộng. Việc tích hợp với Apache Spark có nghĩa Delta Lake có thể là bổ sung hoàn hảo để tinh gọn quy trình nếu bạn đã đầu tư vào hệ sinh thái Spark.
Đối với những ai muốn đào sâu, tôi khuyến khích bạn khám phá thêm các tài nguyên trên DataCamp:
Chúc bạn học tốt và thành công trên hành trình dữ liệu!
Delta Lake là một lớp lưu trữ mã nguồn mở bổ sung các giao dịch ACID, thực thi và tiến hóa lược đồ, cùng khả năng du hành thời gian cho Apache Spark. Điều này giúp quản lý dữ liệu đáng tin cậy hơn và mang lại các tính năng mà data lake truyền thống không có.
Để thiết lập Delta Lake, hãy cài đặt Apache Spark và gói delta-spark (dùng lệnh như pip install pyspark delta-spark). Sau đó, cấu hình phiên Spark của bạn với các thiết lập dành riêng cho Delta Lake để bật phần mở rộng SQL và đặt Delta làm catalog mặc định.
Các tính năng quan trọng gồm giao dịch ACID cho thao tác dữ liệu vững chắc, du hành thời gian để truy vấn dữ liệu lịch sử, tiến hóa lược đồ tự động để xử lý thay đổi cấu trúc dữ liệu và quản lý siêu dữ liệu tối ưu để tăng tốc truy vấn.
Các vấn đề thường gặp như sai lệch lược đồ hoặc sự cố phân vùng có thể được xử lý bằng cách dùng các tùy chọn như mergeSchema hoặc tối ưu việc phân vùng dữ liệu. Ngoài ra, kiểm tra _delta_log và dùng truy vấn du hành thời gian có thể giúp xác định và khắc phục lỗi.
Nên phân vùng dữ liệu hiệu quả, lên lịch tác vụ bảo trì định kỳ như VACUUM để quản lý các tệp lỗi thời, và tận dụng các kỹ thuật như Z-ordering để tối ưu hiệu năng truy vấn — tất cả đều được đề cập trong phần thực hành tốt của bài viết.
Tôi là một kỹ sư dữ liệu và người xây dựng cộng đồng, làm việc với pipeline dữ liệu, đám mây và công cụ AI, đồng thời viết các hướng dẫn thực hành, tác động cao cho DataCamp và các nhà phát triển mới nổi.

blog
 Matt Crabtree• 10 phút
Tìm hiểu thêm về kỹ thuật dữ liệu với các khóa học này!
Lộ trình
Nắm vững các kỹ năng được săn đón để thu thập, làm sạch, quản lý dữ liệu một cách hiệu quả, cũng như lên lịch và giám sát các quy trình xử lý dữ liệu, giúp bạn nổi bật trong lĩnh vực kỹ thuật dữ liệu.
Khóa học
Tìm hiểu quản lý dữ liệu trong Databricks với Delta Lake, bao gồm giao dịch ACID, kiểm soát lược đồ và bảo mật.
Khóa học
Thao tác dữ liệu và tạo bộ đặc trưng học máy trong Spark bằng SQL với Python.


Data lake là tiêu chuẩn vàng để lưu trữ lượng dữ liệu có cấu trúc và phi cấu trúc khổng lồ nhưng thường gặp khó khăn về tính nhất quán dữ liệu, tiến hóa lược đồ và hiệu năng. Delta Lake giải quyết những thách thức này bằng cách bổ sung giao dịch ACID, thực thi lược đồ và xử lý dữ liệu có khả năng mở rộng trên nền Apache Spark.
Trong hướng dẫn này, tôi sẽ giải thích các kiến thức cơ bản về Delta Lake, bao gồm kiến trúc, tính năng và thiết lập, kèm theo các ví dụ thực tiễn để giúp bạn bắt đầu.
Delta Lake là gì?
Delta Lake là một lớp lưu trữ mã nguồn mở được thiết kế để tích hợp với Apache Spark, trở thành giải pháp ưa thích cho các đội nhóm dùng hệ sinh thái Spark. Nó đưa các giao dịch ACID (Atomicity, Consistency, Isolation, Durability) vào môi trường dữ liệu lớn.
Bằng cách kích hoạt quản lý siêu dữ liệu vững chắc, kiểm soát phiên bản và thực thi lược đồ, Delta Lake nâng cấp các data lakehouse và đảm bảo chất lượng dữ liệu cao cho các tác vụ phân tích và học máy.
Các tính năng của Delta Lake
Kiến trúc Delta Lake
Delta Lake cải thiện các kiến trúc dữ liệu truyền thống, đặc biệt là kiến trúc Lambda, bằng cách hợp nhất xử lý dữ liệu theo lô và theo luồng vào một khung làm việc tuân thủ ACID duy nhất.
Các nền tảng dữ liệu sử dụng Delta Lake thường tuân theo kiến trúc huy chương (medallion), tổ chức dữ liệu thành ba lớp logic như sau:
Các bảng Gold có thể được các công cụ BI tiêu thụ, cho phép phân tích thời gian thực và hỗ trợ ra quyết định.
Kiến trúc huy chương. Nguồn ảnh: Databricks
Định dạng tệp của Delta Lake
Delta Lake được xây dựng trên Apache Parquet, một định dạng lưu trữ theo cột giúp truy vấn hiệu quả, nén và tiến hóa lược đồ. Tuy nhiên, điểm khác biệt của Delta Lake so với các data lake dựa trên Parquet tiêu chuẩn là DeltaLog, một nhật ký giao dịch ghi lại lịch sử mọi thay đổi đối với một tập dữ liệu.
Các thành phần cốt lõi của định dạng tệp Delta Lake gồm:
_delta_log/):Như bạn thấy, nếu không có DeltaLog, các data lake dựa trên Parquet tiêu chuẩn thiếu giao dịch ACID và không thể xử lý an toàn các sửa đổi đồng thời. Định dạng tệp của Delta Lake cho phép xử lý streaming và batch cùng tồn tại trong khi vẫn duy trì tính nhất quán. Cuối cùng, các tính năng như merge-on-read, nén gộp và truy vấn siêu dữ liệu tối ưu khiến các bảng Delta cực kỳ hiệu quả cho phân tích quy mô lớn.