

搭建 Delta Lake
让我们开始动手搭建 Delta Lake!我会将流程拆分为两个简单步骤:
步骤 1:安装 Apache Spark 与 Delta Lake
首先,确保您已有 Apache Spark 环境。然后安装
Delta Lake 包(若使用 Python),命令如下:
pip install pyspark delta-spark上述命令会安装 delta-spark 包,为您的 Spark 会话添加 Delta Lake 集成功能。
步骤 2:在 Spark 中配置 Delta Lake
安装完成后,使用以下配置让 Spark 会话启用 Delta Lake:
设置如下:
from pyspark.sql import SparkSession
# Initialize a SparkSession with Delta support
spark = SparkSession.builder \
.appName("DeltaLakePractice") \
.config("spark.sql.extensions", "io.delta.sql.DeltaSparkSessionExtension") \
.config("spark.sql.catalog.spark_catalog", "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
.getOrCreate()
# Check if Spark is working
print("Spark Session Created Successfully!")此处的 Spark 会话包含两项关键配置。第一项启用
Delta Lake SQL 扩展,第二项将 Delta Lake 设置为默认
目录,确保正确处理 Delta 格式的数据。
Delta Lake 基础
现在进入基础操作。Delta Lake 允许您使用简洁的 DataFrame API 创建符合 ACID 的表。
步骤 1:创建 Delta 表
通过以 Delta 格式写出一个 DataFrame 来创建 Delta 表:
# Sample DataFrame creation
data = [("Alice", 34), ("Bob", 45), ("Cathy", 29)]
columns = ["name", "age"]
df = spark.createDataFrame(data, columns)
# Save the DataFrame as a Delta table (overwrite mode replaces any existing data)
df.write.format("delta").mode("overwrite").save("/path/to/delta/table")上述代码创建一个基本的 DataFrame,并以 Delta 格式写入指定路径。使用 mode("overwrite") 可确保替换任何已存在的数据。
步骤 2:读取 Delta 表
创建 Delta 表后,可按如下方式读取其数据:
# Load the Delta table from a specified path
delta_df = spark.read.format("delta").load("/path/to/delta/table")
delta_df.show()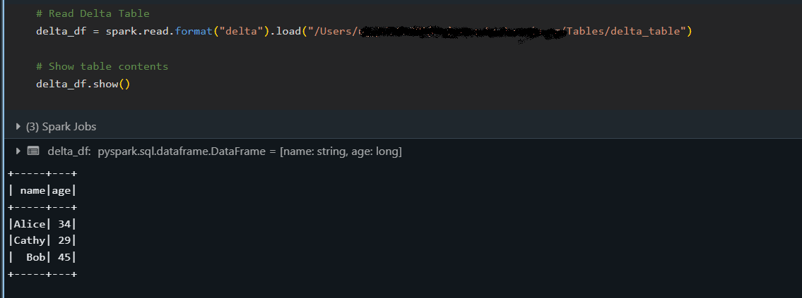
上述代码将 Delta 表加载为 DataFrame,并通过 show() 方法展示其内容,以确认数据已被正确读取。
步骤 3:写入 Delta 表(追加与覆写)
Delta Lake 支持多种写入模式,既可增量追加新记录(append),也可替换现有数据(overwrite),同时保持 ACID 保证。
追加数据
向现有 Delta 表追加新数据:
# New data to append
new_data = [("David", 40)]
new_df = spark.createDataFrame(new_data, columns)
# Append data to the existing Delta table
new_df.write.format("delta").mode("append").save("/path/to/delta/table")使用 "append" 模式可在不影响现有数据的情况下为表添加新行。
覆写数据
用更新后的数据覆写整个 Delta 表:
# Updated data for overwrite
updated_data = [("Alice", 35), ("Bob", 46), ("Cathy", 30)]
updated_df = spark.createDataFrame(updated_data, columns)
# Overwrite the current contents of the Delta table
updated_df.write.format("delta").mode("overwrite").save("/path/to/delta/table")使用 "overwrite" 模式会将 Delta 表的内容完全替换为新的更新 DataFrame。
Delta Lake 高级特性
本节介绍 Delta Lake 在基础操作之外的一些强大功能。
我们将重点探讨如何回看数据的历史版本、自动管理模式变更,以及以原子性方式执行包含多步操作的事务。
时光回溯(查询历史版本数据)
Delta Lake 的时光回溯功能允许您访问表的历史版本。对 Delta 表的每一次写入都会创建一个新版本,从而可以查询数据的早期状态。我曾使用该功能来审计数据变更、调试问题,或在出现异常时恢复到先前快照。
# Querying an earlier version (version 0) of the Delta table:
historical_df = spark.read.format("delta") \
.option("versionAsOf", 0) \
.load("/path/to/delta/table")
historical_df.show()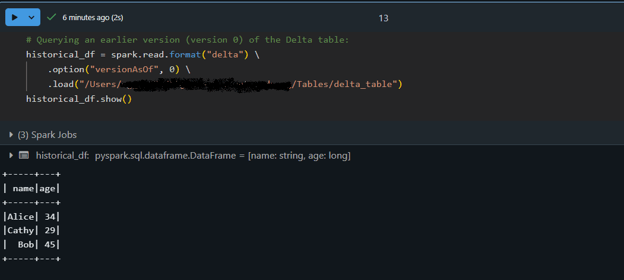
模式演进与强制
随着数据集发展,可能会新增列。Delta Lake 可以自动演进模式,将新字段合并到现有表中,同时强制数据一致性。这意味着当数据结构变化时,您无需重建或手动调整表结构。
让我们使用自动模式演进来追加一个更新了模式的数据集:
# Create a DataFrame with an additional "country" column:
new_data = [("Alice", 34, "USA"), ("Bob", 45, "Canada")]
columns = ["name", "age", "country"]
new_df = spark.createDataFrame(new_data, columns)
# Append the new data to the Delta table with schema evolution enabled:
new_df.write.format("delta") \
.mode("append") \
.option("mergeSchema", "true") \
.save("/path/to/delta/table")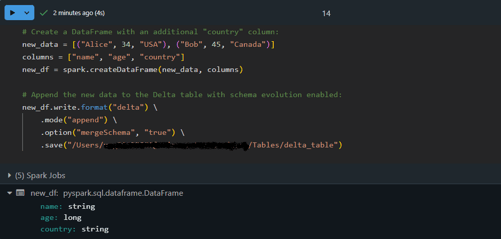
这里 DataFrame new_df 多了一个 country 列。通过option("mergeSchema", "true"),Delta Lake 引擎会在追加数据的同时自动更新表模式以容纳新列,且过程安全!
Delta Lake 事务(ACID)
Delta Lake 的 ACID 事务保证复杂操作在高并发下也能可靠执行。这意味着一系列操作(如更新与插入)会被当作一个整体处理;若任一步骤失败,将不会应用任何更改,从而确保数据保持一致。
让我们用 MERGE 操作执行一次原子事务:
-- Execute a MERGE statement in SQL to update or insert data atomically:
MERGE INTO delta./path/to/delta/table AS target
USING (SELECT 'Alice' AS name, 35 AS age, 'USA' AS country) AS source
ON target.name = source.name AND target.country IS NULL
WHEN MATCHED THEN
UPDATE SET target.age = source.age, target.country = source.country
WHEN NOT MATCHED THEN
INSERT (name, age, country) VALUES (source.name, source.age, source.country)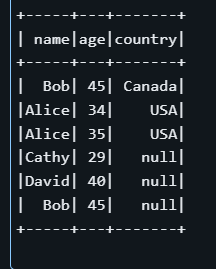
在上述示例中,MERGE 语句会查找目标表中名称匹配且 country 字段为 NULL 的行。若匹配成功则更新该行;否则插入一条新记录。
请注意,即使表中可能已经存在名为“Alice”的行,条件 target.country IS NULL 也可能导致此次操作插入新行,而不是更新一个 country 非空的行。该示例强调了在事务操作中谨慎定义匹配条件的重要性。
使用 Delta Lake 的最佳实践
以下是我在使用 Delta Lake 时遵循的最佳实践,有助于您构建高效、可维护的数据管道。
高效的数据分区
在处理大型数据集时,为 Delta 表进行合理分区可以显著提升查询性能。
提示: 写出 DataFrame 时,使用 .partitionBy("column_name") 选项,按日期或类别等维度将数据切分为更小且易管理的块。此举能减少典型查询的扫描数据量。
使用 Delta Lake 管理元数据
Delta Lake 使用事务日志(_delta_log)维护表上所有操作的元数据。
提示: 定期安排维护操作(如 VACUUM 命令)以清理过时数据文件并精简元数据。这将带来更快的查询性能,并简化大数据集的管理。
使用 Z-ordering 优化性能
Z-ordering 是一种数据聚类技术,可在磁盘上组织数据以提升查询效率,尤其在按特定列过滤时:
OPTIMIZE delta./path/to/delta/table
ZORDER BY (name, age);上述 SQL 命令指示 Delta Lake 按 name 与 age 列对数据进行物理重排。通过将相似值就近存放,针对这些列进行过滤的查询所需扫描的数据更少,运行更快。
Delta Lake 的排障与调试
使用 Delta Lake 时,您可能偶尔会遇到阻碍。关键在于把这些挑战当作深化理解与掌握技术的机会。以下是一些实用见解与技巧,帮助您迅速回到正轨。
常见错误与解决方案
您可能会遇到模式不匹配或分区对齐问题。例如,当导入数据与表模式不一致时,写入操作可能报错。可考虑使用 mergeSchema 等选项让 Delta Lake 自动调整。
此外,若查询性能下降,请检查数据是否已得到合理分区,或是否需要执行 VACUUM 等维护命令以移除过时文件。
调试 Delta 表操作
当结果与预期不符时,无需慌张——这很正常!良好的第一步是检查事务日志(位于 _delta_log 目录)。该日志提供详尽的事务历史,帮助您定位问题发生的时间与位置。
另外,如果发现不一致或异常变更,尝试使用时光回溯对比不同表版本。这有助于您隔离问题并理解导致错误的事件链。
结语
Delta Lake 提供了众多优势——从健壮的 ACID 事务与高效的元数据管理,到时光回溯与模式演进等特性——使您能够构建弹性且可扩展的数据管道。它与 Apache Spark 的集成意味着,若您已投入 Spark 生态,Delta Lake 将是精简工作流的理想补充。
若您希望进一步深入了解,建议在 DataCamp 上探索以下资源:
- Databricks Concepts 课程——学习 Databricks 与 Delta Lake 背后的核心原理,了解它们如何增强数据处理与分析工作流。
- Big Data Fundamentals with PySpark 课程——动手实践 Apache Spark 与 PySpark,掌握高效处理大规模数据集的技术。
- Introduction to Data Engineering 课程——掌握数据工程的基础概念,为管理大数据打下坚实基础。
- Understanding Modern Data Architecture 课程——探索现代数据架构的最佳实践与趋势,助您在当今动态的数据领域保持领先。
祝您学习顺利,在数据之旅中一切顺风!
FAQs
什么是 Delta Lake?它与传统数据湖有何不同?
Delta Lake 是一个开源存储层,为 Apache Spark 增加了 ACID 事务、模式强制与演进,以及时光回溯能力。这使数据管理更可靠,并实现传统数据湖所缺乏的功能。
如何在我的 Apache Spark 环境中搭建 Delta Lake?
要在 Apache Spark 环境中搭建 Delta Lake,请安装 Apache Spark 与 delta-spark 包(可使用如 pip install pyspark delta-spark 这样的命令)。随后在 Spark 会话中配置特定于 Delta Lake 的设置,启用 SQL 扩展并将 Delta 指定为默认目录。
哪些关键特性能让 Delta Lake 成为有价值的工具?
重要特性包括用于稳健数据操作的 ACID 事务、可查询历史数据的时光回溯、自动模式演进以应对数据结构变更,以及优化的元数据管理以提升查询性能。
在使用 Delta Lake 时遇到错误,我该如何处理?
常见问题(如模式不匹配或分区问题)可通过使用 mergeSchema 等选项或优化数据分区来解决。此外,检查 _delta_log 并利用时光回溯查询可帮助定位与解决错误。
在数据管道中使用 Delta Lake 时应遵循哪些最佳实践?
建议高效地对数据进行分区,定期安排诸如 VACUUM 的维护任务以清理过时文件,并利用 Z-ordering 等技术优化查询性能——这些都在本文的最佳实践部分有所涵盖。

我是一名数据工程师兼社区建设者,专注于数据管道、云端与 AI 工具链,同时为 DataCamp 和新兴开发者撰写实用且高影响力的教程。
数据湖是存储海量结构化与非结构化数据的黄金标准,但常常面临数据不一致、模式演进与性能等问题。Delta Lake 通过在 Apache Spark 之上引入 ACID 事务、模式强制与可扩展的数据处理,来解决这些挑战。
在本教程中,我将讲解 Delta Lake 的基础,包括其架构、特性与搭建方式,并提供实用示例帮助您快速上手。
什么是 Delta Lake?
Delta Lake 是一个开源的存储层,旨在与 Apache Spark 集成,对使用 Spark 生态的团队而言是理想选择。它为大数据环境引入了 ACID(原子性、一致性、隔离性、持久性)事务。
通过提供健壮的元数据管理、版本控制与模式强制,Delta Lake 强化了数据湖仓,并为分析与机器学习工作负载确保高数据质量。
Delta Lake 的特性
Delta Lake 架构
Delta Lake 改进了传统数据架构,特别是 Lambda 架构,通过统一批处理与流式数据处理为一个遵循 ACID 的框架。
采用 Delta Lake 的数据平台通常遵循勋章架构(Medallion Architecture),将数据组织为以下三个逻辑层:
黄金表可以被商业智能工具消费,支持实时分析与决策制定。
勋章架构。图片来源:Databricks
Delta Lake 文件格式
Delta Lake 构建在 Apache Parquet 之上,这是一种列式存储格式,可实现高效查询、压缩与模式演进。然而,使 Delta Lake 有别于标准基于 Parquet 的数据湖的是DeltaLog,一个事务日志,用于维护数据集的所有变更历史。
Delta Lake 文件格式的核心组件包括:
_delta_log/):如您所见,没有 DeltaLog 的标准基于 Parquet 的数据湖缺乏 ACID 事务,也无法安全处理并发修改。Delta Lake 的文件格式使流式与批处理能够共存并保持一致性。最后,诸如按读合并(merge-on-read)、压缩(compaction)与优化的元数据查询等功能,让 Delta 表在大规模分析场景中非常高效。