

Delta Lake Kurulumu
Delta Lake kurulumuna dalalım! Bunu iki basit adımda ele alacağım:
Adım 1: Apache Spark ve Delta Lake’i yükleyin
Başlamak için bir Apache Spark ortamına sahip olduğunuzdan emin olun. Ardından (Python kullanıyorsanız)
Delta Lake paketini aşağıdaki komutla kurun:
pip install pyspark delta-sparkYukarıdaki komut, Spark oturumunuzu gerekli Delta Lake entegrasyonlarıyla donatan delta-spark paketini kurar.
Adım 2: Delta Lake’i Spark ile yapılandırın
Paketi kurduktan sonra Spark oturumunuzu Delta Lake’i kullanacak şekilde şu
ayarlarla yapılandırın:
from pyspark.sql import SparkSession
# Initialize a SparkSession with Delta support
spark = SparkSession.builder \
.appName("DeltaLakePractice") \
.config("spark.sql.extensions", "io.delta.sql.DeltaSparkSessionExtension") \
.config("spark.sql.catalog.spark_catalog", "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
.getOrCreate()
# Check if Spark is working
print("Spark Session Created Successfully!")Burada Spark oturumu iki kritik yapılandırmayla kurulmuştur. İlki
Delta Lake SQL uzantılarını etkinleştirir, ikincisi ise Delta Lake’i varsayılan
katalog olarak tanımlar; böylece Delta formatlı verileriniz doğru şekilde işlenir.
Delta Lake Temelleri
Şimdi temellere geçelim. Delta Lake, basit bir DataFrame API’si kullanarak ACID uyumlu tablolar oluşturmanıza olanak tanır.
Adım 1: Bir Delta tablosu oluşturma
Bir DataFrame’i Delta formatında yazarak bir Delta tablosu oluşturun:
# Sample DataFrame creation
data = [("Alice", 34), ("Bob", 45), ("Cathy", 29)]
columns = ["name", "age"]
df = spark.createDataFrame(data, columns)
# Save the DataFrame as a Delta table (overwrite mode replaces any existing data)
df.write.format("delta").mode("overwrite").save("/path/to/delta/table")Yukarıdaki kod parçası, temel bir DataFrame oluşturur ve belirli bir yola Delta formatını kullanarak yazar. mode("overwrite") kullanılması, mevcut verilerin değiştirilmesini sağlar.
Adım 2: Bir Delta tablosundan okuma
Bir Delta tablosu oluşturulduktan sonra verilerini şu şekilde okuyun:
# Load the Delta table from a specified path
delta_df = spark.read.format("delta").load("/path/to/delta/table")
delta_df.show()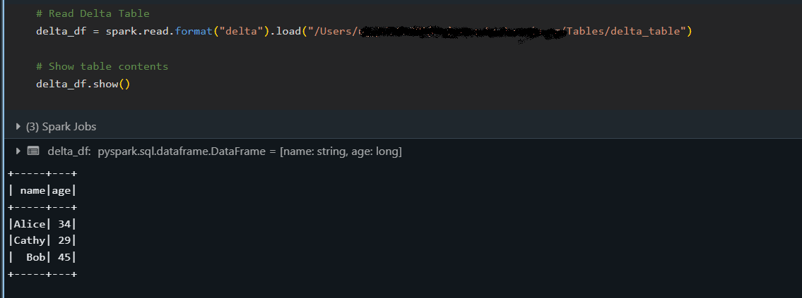
Yukarıdaki parça, Delta tablosunu bir DataFrame’e yükler ve show() yöntemiyle içeriğini görüntüler; bu da verilerin doğru okunduğunu doğrular.
Adım 3: Bir Delta tablosuna yazma (ekleme ve üzerine yazma)
Delta Lake, ACID garantilerini korurken yeni kayıtları artımlı olarak eklemenize (append) veya mevcut verileri değiştirmenize (overwrite) olanak tanıyan birden çok yazma modu destekler.
Veri ekleme
Var olan bir Delta tablosuna yeni veri ekleyin:
# New data to append
new_data = [("David", 40)]
new_df = spark.createDataFrame(new_data, columns)
# Append data to the existing Delta table
new_df.write.format("delta").mode("append").save("/path/to/delta/table")Tabloya yeni satırlar eklemek için "append" modu kullanılır; mevcut veriler etkilenmez.
Veri üzerine yazma
Güncellenmiş verilerle tüm Delta tablosunun üzerine yazın:
# Updated data for overwrite
updated_data = [("Alice", 35), ("Bob", 46), ("Cathy", 30)]
updated_df = spark.createDataFrame(updated_data, columns)
# Overwrite the current contents of the Delta table
updated_df.write.format("delta").mode("overwrite").save("/path/to/delta/table")"overwrite" modunu kullanmak, Delta tablosunun içeriğini tamamen yeni, güncellenmiş DataFrame ile değiştirir.
Delta Lake İleri Düzey Özellikler
Bu bölüm, temel işlemlerin ötesindeki güçlü Delta Lake işlevlerini kapsar.
Özellikle, verinizin geçmiş sürümlerine nasıl bakabileceğinizi, şema değişikliklerini otomatik olarak nasıl yöneteceğinizi ve çoklu işlemleri atomik olarak nasıl gerçekleştireceğinizi inceleyeceğiz.
Zaman yolculuğu (verinin eski sürümlerini sorgulama)
Delta Lake’in zaman yolculuğu özelliği, tablonuzun önceki sürümlerine erişmenizi sağlar. Delta tablosundaki her yazma işlemi yeni bir sürüm oluşturur; böylece verinizin önceki durumunu sorgulayabilirsiniz. Bu özelliği veri değişikliklerini denetlemek, sorun gidermek veya bir şeyler ters gittiğinde önceki bir anlık görüntüyü geri yüklemek için kullandım.
# Querying an earlier version (version 0) of the Delta table:
historical_df = spark.read.format("delta") \
.option("versionAsOf", 0) \
.load("/path/to/delta/table")
historical_df.show()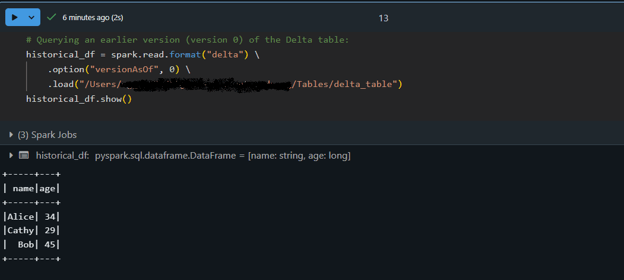
Şema evrimi ve zorlama
Veri kümeleri geliştikçe yeni sütunlar eklenebilir. Delta Lake, şema evrimini otomatik olarak yönetebilir; yeni alanları mevcut bir tabloya birleştirirken veri tutarlılığını zorlar. Bu, veri yapınız her değiştiğinde tablonuzu yeniden oluşturmak veya manuel ayar yapmak zorunda kalmayacağınız anlamına gelir.
Otomatik şema evrimi kullanarak güncellenmiş şemayla veri ekleyelim:
# Create a DataFrame with an additional "country" column:
new_data = [("Alice", 34, "USA"), ("Bob", 45, "Canada")]
columns = ["name", "age", "country"]
new_df = spark.createDataFrame(new_data, columns)
# Append the new data to the Delta table with schema evolution enabled:
new_df.write.format("delta") \
.mode("append") \
.option("mergeSchema", "true") \
.save("/path/to/delta/table")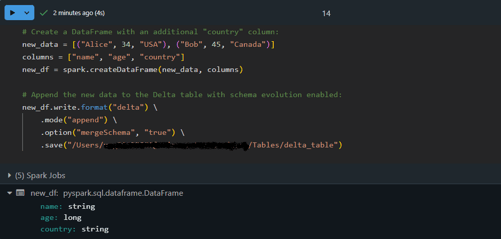
Burada new_df DataFrame’i, fazladan bir country sütunu içerir. option("mergeSchema", "true") kullanılarak Delta Lake motoru, veriyi güvenle eklerken tablonun şemasını yeni sütunu içerecek şekilde otomatik olarak günceller.
Delta Lake işlemleri (ACID)
Delta Lake’in ACID işlemleri, karmaşık işlemlerin yüksek eşzamanlılık altında bile güvenilir şekilde çalışmasını garanti eder. Bu, (güncellemeler ve eklemeler gibi) bir dizi işlemin tek bir birim olarak ele alındığı anlamına gelir. İşlemin herhangi bir kısmı başarısız olursa hiçbir değişiklik uygulanmaz ve veriniz tutarlı kalır.
Bir MERGE işlemiyle atomik bir işlem gerçekleştirelim:
-- Execute a MERGE statement in SQL to update or insert data atomically:
MERGE INTO delta./path/to/delta/table AS target
USING (SELECT 'Alice' AS name, 35 AS age, 'USA' AS country) AS source
ON target.name = source.name AND target.country IS NULL
WHEN MATCHED THEN
UPDATE SET target.age = source.age, target.country = source.country
WHEN NOT MATCHED THEN
INSERT (name, age, country) VALUES (source.name, source.age, source.country)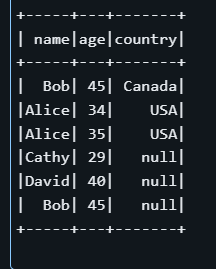
Yukarıdaki örnekte MERGE ifadesi, hedef tabloda adın eşleştiği ve ülke alanının NULL olduğu satırları arar. Eşleşme bulunursa satırı günceller; aksi halde yeni bir kayıt ekler.
Dikkat edin: Tabloda “Alice” için zaten bir satır olsa bile, target.country IS NULL koşulu, ülkesi boş olmayan bir satırı güncellemek yerine yeni bir satır eklenmesine yol açabilir. Bu örnek, işlemsel eşleştirme ölçütlerini dikkatle tanımlamanın önemini gösterir.
Delta Lake Kullanımı için En İyi Uygulamalar
Delta Lake ile çalışırken izlediğim en iyi uygulamalar şunlardır. Bunlar, verimli ve sürdürülebilir veri hatları oluşturmanıza yardımcı olabilir.
Verimli veri bölümleme
Delta tablolarınızı bölümlemek, büyük veri kümeleriyle çalışırken sorgu performansını önemli ölçüde artırabilir.
İpucu: DataFrame’inizi yazarken .partitionBy("column_name") seçeneğini kullanarak verinizi (örneğin tarihe veya kategoriye göre) daha küçük ve yönetilebilir parçalara ayırın. Bu yaklaşım, tipik sorgular sırasında taranan veri miktarını azaltır.
Delta Lake ile meta veri yönetimi
Delta Lake, tablonuzdaki tüm işlemlerin meta verilerini korumak için (_delta_log) işlem günlüğünü kullanır.
İpucu: Gereksiz veri dosyalarını kaldırmak ve meta verileri düzenlemek için (örneğin VACUUM komutu gibi) periyodik bakım işlemleri planlayın. Bu, daha hızlı sorgular ve büyük veri kümelerinin daha kolay yönetilmesiyle sonuçlanır.
Z-ordering ile performansı optimize etme
Z-ordering, özellikle belirli sütunlarda filtreleme yaparken sorgu verimliliğini artırmak için veriyi disk üzerinde kümelendiren bir tekniktir:
OPTIMIZE delta./path/to/delta/table
ZORDER BY (name, age);Yukarıdaki SQL komutu, Delta Lake’e veriyi name ve age sütunlarına göre fiziksel olarak yeniden düzenlemesini söyler. Benzer değerler birlikte konumlandırıldığında, bu sütunlarda filtreleme yapan sorgular daha az veri tarar ve daha hızlı çalışır.
Delta Lake’te Sorun Giderme ve Hata Ayıklama
Delta Lake ile çalışırken ara sıra engellerle karşılaşabilirsiniz. Önemli olan, bu zorlukları anlayışınızı derinleştirmek ve teknolojide ustalaşmak için bir fırsat olarak görmektir. İşte sizi tekrar yola sokacak bazı pratik içgörülerim ve ipuçlarım.
Yaygın hatalar ve çözümler
Şema uyumsuzlukları veya bölüm hizalama sorunları gibi problemlerle karşılaşabilirsiniz. Örneğin, gelen veriniz tablo şemasıyla eşleşmiyorsa yazma işlemleri sırasında hatalar görebilirsiniz. Delta Lake’in uyum sağlaması için mergeSchema gibi seçenekleri kullanmayı düşünün.
Ayrıca, sorgu performansınız düşerse verinizin en uygun şekilde bölümlenip bölümlenmediğini kontrol edin veya VACUUM gibi bir bakım komutunun eski dosyaları temizlemeye yardımcı olup olmayacağını değerlendirin.
Delta tablo işlemlerinde hata ayıklama
Beklediğiniz gibi çalışmayan durumlarda endişelenmeyin—bu sürecin bir parçası! Harika bir ilk adım, (_delta_log dizininde bulunan) işlem günlüğünü incelemektir. Bu günlük, işlemlerin ayrıntılı bir geçmişini sunar ve işlerin ne zaman ve nerede raydan çıktığını belirlemenize yardımcı olabilir.
Ek olarak, tutarsızlıklar veya beklenmedik değişiklikler fark ederseniz, farklı tablo sürümlerini karşılaştırmak için zaman yolculuğunu kullanmayı deneyin. Bu yaklaşım, sorunu izole etmenize ve hataya yol açan olayları anlamanıza yardımcı olacaktır.
Sonuç
Delta Lake; sağlam ACID işlemlerinden verimli meta veri yönetimine, zaman yolculuğu ve şema evrimi gibi özelliklere kadar, dayanıklı ve ölçeklenebilir veri hatları kurmanızı sağlayan pek çok avantaj sunar. Apache Spark ile entegrasyonu sayesinde, halihazırda Spark ekosistemine yatırım yaptıysanız Delta Lake iş akışlarınızı kolaylaştırmak için mükemmel bir ek olabilir.
Daha derinlemesine öğrenmek isteyenler için, DataCamp’teki şu kaynakları keşfetmenizi öneririm:
- Databricks Concepts kursu – Databricks ve Delta Lake’in arkasındaki temel ilkeleri, veri işleme ve analitik iş akışlarını nasıl geliştirdiklerini öğrenin.
- Big Data Fundamentals with PySpark kursu – Apache Spark ve PySpark ile uygulamalı deneyim kazanarak büyük veri kümelerini verimli şekilde işleme tekniklerinde ustalaşın.
- Introduction to Data Engineering kursu – Veri mühendisliğinin temel kavramlarını kavrayın ve büyük veriyi yönetmek için sağlam bir temel oluşturun.
- Understanding Modern Data Architecture kursu – Modern veri mimarisindeki güncel en iyi uygulamaları ve trendleri keşfedin; günümüzün dinamik veri ortamında önde kalın.
Keyifli öğrenmeler ve veri yolculuğunuzda başarılar!
SSS
Delta Lake nedir ve geleneksel veri göllerinden nasıl ayrılır?
Delta Lake, Apache Spark’a ACID işlemleri, şema zorlama ve evrimi ile zaman yolculuğu yetenekleri ekleyen açık kaynaklı bir depolama katmanıdır. Bu, veri yönetimini daha güvenilir hale getirir ve geleneksel veri göllerinde bulunmayan özellikleri etkinleştirir.
Apache Spark ortamımda Delta Lake’i nasıl kurabilirim?
Delta Lake’i kurmak için Apache Spark ve delta-spark paketini (örneğin pip install pyspark delta-spark gibi bir komutla) yükleyin. Ardından, SQL uzantılarını etkinleştiren ve Delta’yı varsayılan katalog olarak belirleyen Delta Lake’e özgü ayarlarla Spark oturumunuzu yapılandırın.
Delta Lake’i değerli bir araç yapan başlıca özellikler nelerdir?
Önemli özellikler arasında sağlam veri işlemleri için ACID işlemleri, geçmiş verileri sorgulamak için zaman yolculuğu, veri yapısındaki değişiklikleri yönetmek için otomatik şema evrimi ve daha hızlı sorgu performansı için optimize edilmiş meta veri yönetimi bulunur.
Delta Lake ile çalışırken hatalarla karşılaşırsam hangi adımları izlemeliyim?
Şema uyumsuzlukları veya bölümleme sorunları gibi yaygın problemler, mergeSchema gibi seçenekleri kullanarak ya da veri bölümlerinizi optimize ederek giderilebilir. Ayrıca _delta_log’u incelemek ve zaman yolculuğu sorgularını kullanmak, hataları tespit edip çözmenize yardımcı olabilir.
Delta Lake’i veri hatlarımda kullanırken hangi en iyi uygulamaları izlemeliyim?
Verinizi verimli şekilde bölümlemeniz, eski dosyaları yönetmek için VACUUM gibi periyodik bakım görevleri planlamanız ve sorgu performansını optimize etmek için Z-ordering gibi tekniklerden yararlanmanız önerilir—tüm bunlar makaledeki en iyi uygulamalar bölümünde ele alınmıştır.

Veri hatları, bulut ve YZ araçları üzerinde çalışan; aynı zamanda DataCamp ve gelişmekte olan geliştiriciler için pratik, yüksek etkili eğiticiler yazan bir veri mühendisi ve topluluk inşacısıyım.



Veri gölleri, büyük miktarda yapılandırılmış ve yapılandırılmamış veriyi depolamada altın standarttır; ancak veri tutarsızlığı, şema evrimi ve performans sorunlarıyla sıklıkla mücadele eder. Delta Lake, Apache Spark üzerine ACID işlemleri, şema zorlaması ve ölçeklenebilir veri işleme ekleyerek bu zorlukları çözer.
Bu eğitimde, başlarken size yardımcı olacak pratik örneklerle birlikte Delta Lake’in mimarisi, özellikleri ve kurulumunu içeren temel bilgilerini açıklayacağım.
Delta Lake Nedir?
Delta Lake, Apache Spark ile bütünleşecek şekilde tasarlanmış, açık kaynaklı bir depolama katmanıdır ve Spark ekosistemini kullanan ekipler için tercih edilen bir çözümdür. Büyük veri ortamlarına ACID (Atomicity, Consistency, Isolation, Durability) işlemlerini getirir.
Sağlam meta veri yönetimi, sürüm kontrolü ve şema zorlaması sağlayarak Delta Lake, veri gölevlerini (lakehouse) güçlendirir ve analitik ile makine öğrenimi iş yükleri için yüksek veri kalitesi sunar.
Delta Lake özellikleri
Delta Lake mimarisi
Delta Lake, özellikle Lambda mimarisini, yığın ve akış veri işlemeyi birleştirerek tek bir ACID uyumlu çerçevede geleneksel veri mimarilerini geliştirir.
Delta Lake kullanan veri platformları genellikle veriyi aşağıdaki gibi tanımlanan üç mantıksal katmana ayıran madalyon mimarisini takip eder:
Altın tablolar, gerçek zamanlı analitiği etkinleştirerek iş zekâsı araçları tarafından tüketilebilir ve karar almayı destekler.
Madalyon mimarisi. Görsel kaynağı: Databricks
Delta Lake Dosya Formatı
Delta Lake, Apache Parquet üstüne kuruludur, sütün bazlı bir depolama formatı olup verimli sorgulama, sıkıştırma ve şema evrimini mümkün kılar. Ancak Delta Lake’i standart Parquet tabanlı veri göllerinden ayıran şey, bir veri kümesinde yapılan tüm değişikliklerin geçmişini tutan DeltaLog adlı bir işlem günlüğüdür.
Delta Lake dosya formatının temel bileşenleri şunlardır:
_delta_log/):Görüldüğü gibi, DeltaLog olmadan, standart Parquet tabanlı veri gölleri ACID işlemlerinden yoksundur ve eşzamanlı değişiklikleri güvenli şekilde işleyemez. Delta Lake’in dosya formatı, tutarlılığı korurken akış ve yığın işlemenin bir arada bulunmasını sağlar. Son olarak, okuma sırasında birleştirme (merge-on-read), sıkıştırma ve optimize edilmiş meta veri sorguları gibi özellikler, Delta tablolarını büyük ölçekli analitik için son derece verimli kılar.