
Kursus
Meta AI baru saja memperkenalkan Llama 3.3, model dengan 70 miliar parameter yang menghadirkan kinerja sebanding dengan Llama 3.1 405B yang jauh lebih besar, namun dengan tuntutan komputasi yang jauh lebih rendah.
Kami menilai ini sangat menarik karena membuat AI berkualitas tinggi lebih mudah diakses oleh developer yang tidak memiliki akses ke perangkat keras mahal.
Dirancang untuk tugas berbasis teks seperti percakapan multibahasa, bantuan pengkodean, dan pembuatan data sintetis, Llama 3.3 hanya berfokus pada masukan dan keluaran teks—bukan untuk menangani gambar atau audio.
Dalam blog ini, kami akan mengulas apa yang membuat model ini menonjol dan membantu Anda memutuskan apakah ini cocok untuk proyek Anda.
Apa Itu Llama 3.3?
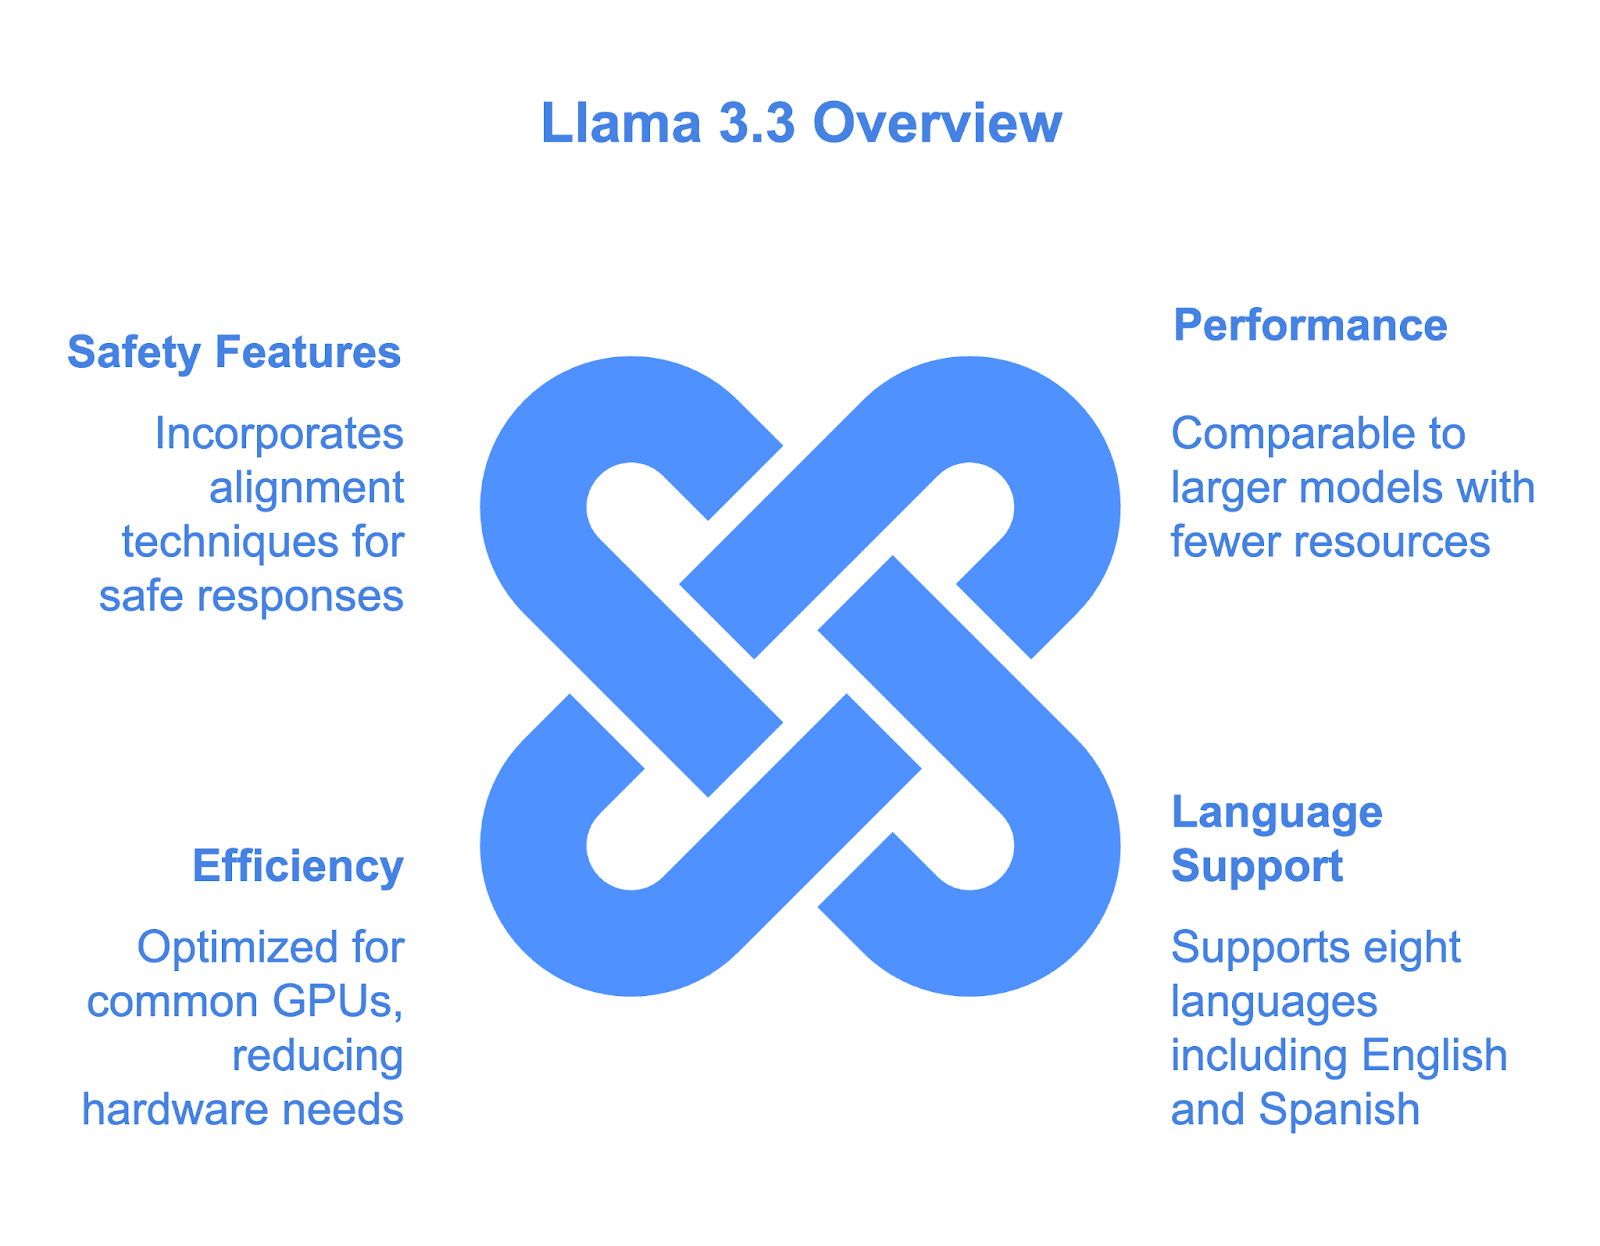
Llama 3.3 adalah model bahasa besar terbaru dari Meta AI, dan kami memandangnya sebagai langkah untuk membuat AI tingkat lanjut lebih mudah diakses untuk berbagai proyek. Dengan 70 miliar parameter, model ini menawarkan kinerja setara dengan Llama 3.1 405B yang jauh lebih besar, tetapi dengan kebutuhan perangkat keras yang jauh lebih rendah. Ini berarti kami dapat mengeksplorasi aplikasi AI canggih tanpa memerlukan perangkat khusus yang mahal.
Model ini dirancang khusus untuk masukan dan keluaran teks, sehingga tidak menangani gambar, audio, atau media lainnya. Kami mendapati model ini sangat efektif untuk tugas seperti percakapan multibahasa, bantuan pengkodean, dan pembuatan data sintetis. Dengan dukungan delapan bahasa, termasuk Inggris, Spanyol, Hindi, dan Jerman, ini adalah opsi kuat untuk proyek yang membutuhkan kemampuan multibahasa.
Yang menonjol bagi kami adalah fokusnya pada efisiensi. Llama 3.3 dioptimalkan untuk berjalan di GPU umum, sehingga praktis untuk penerapan lokal dan lebih mudah untuk eksperimen. Model ini juga menggabungkan teknik alignment untuk memastikan responsnya bermanfaat dan aman, yang kami tahu penting untuk aplikasi sensitif.
Di bagian ini, kami telah menguraikan dasar-dasar tentang Llama 3.3, namun kami akan membahas lebih dalam pada bagian berikutnya. Kami akan membahas cara kerjanya, cara mulai menggunakannya, dan performanya dalam benchmark, sehingga Anda dapat menentukan apakah ini cocok untuk pekerjaan Anda.
Bagaimana Cara Kerja Llama 3.3?
Berikut cara Llama 3.3 beroperasi, diuraikan agar mudah dipahami baik Anda sudah familiar dengan model bahasa besar maupun baru mulai mengeksplorasinya.
Arsitektur: Efisien dan skalabel
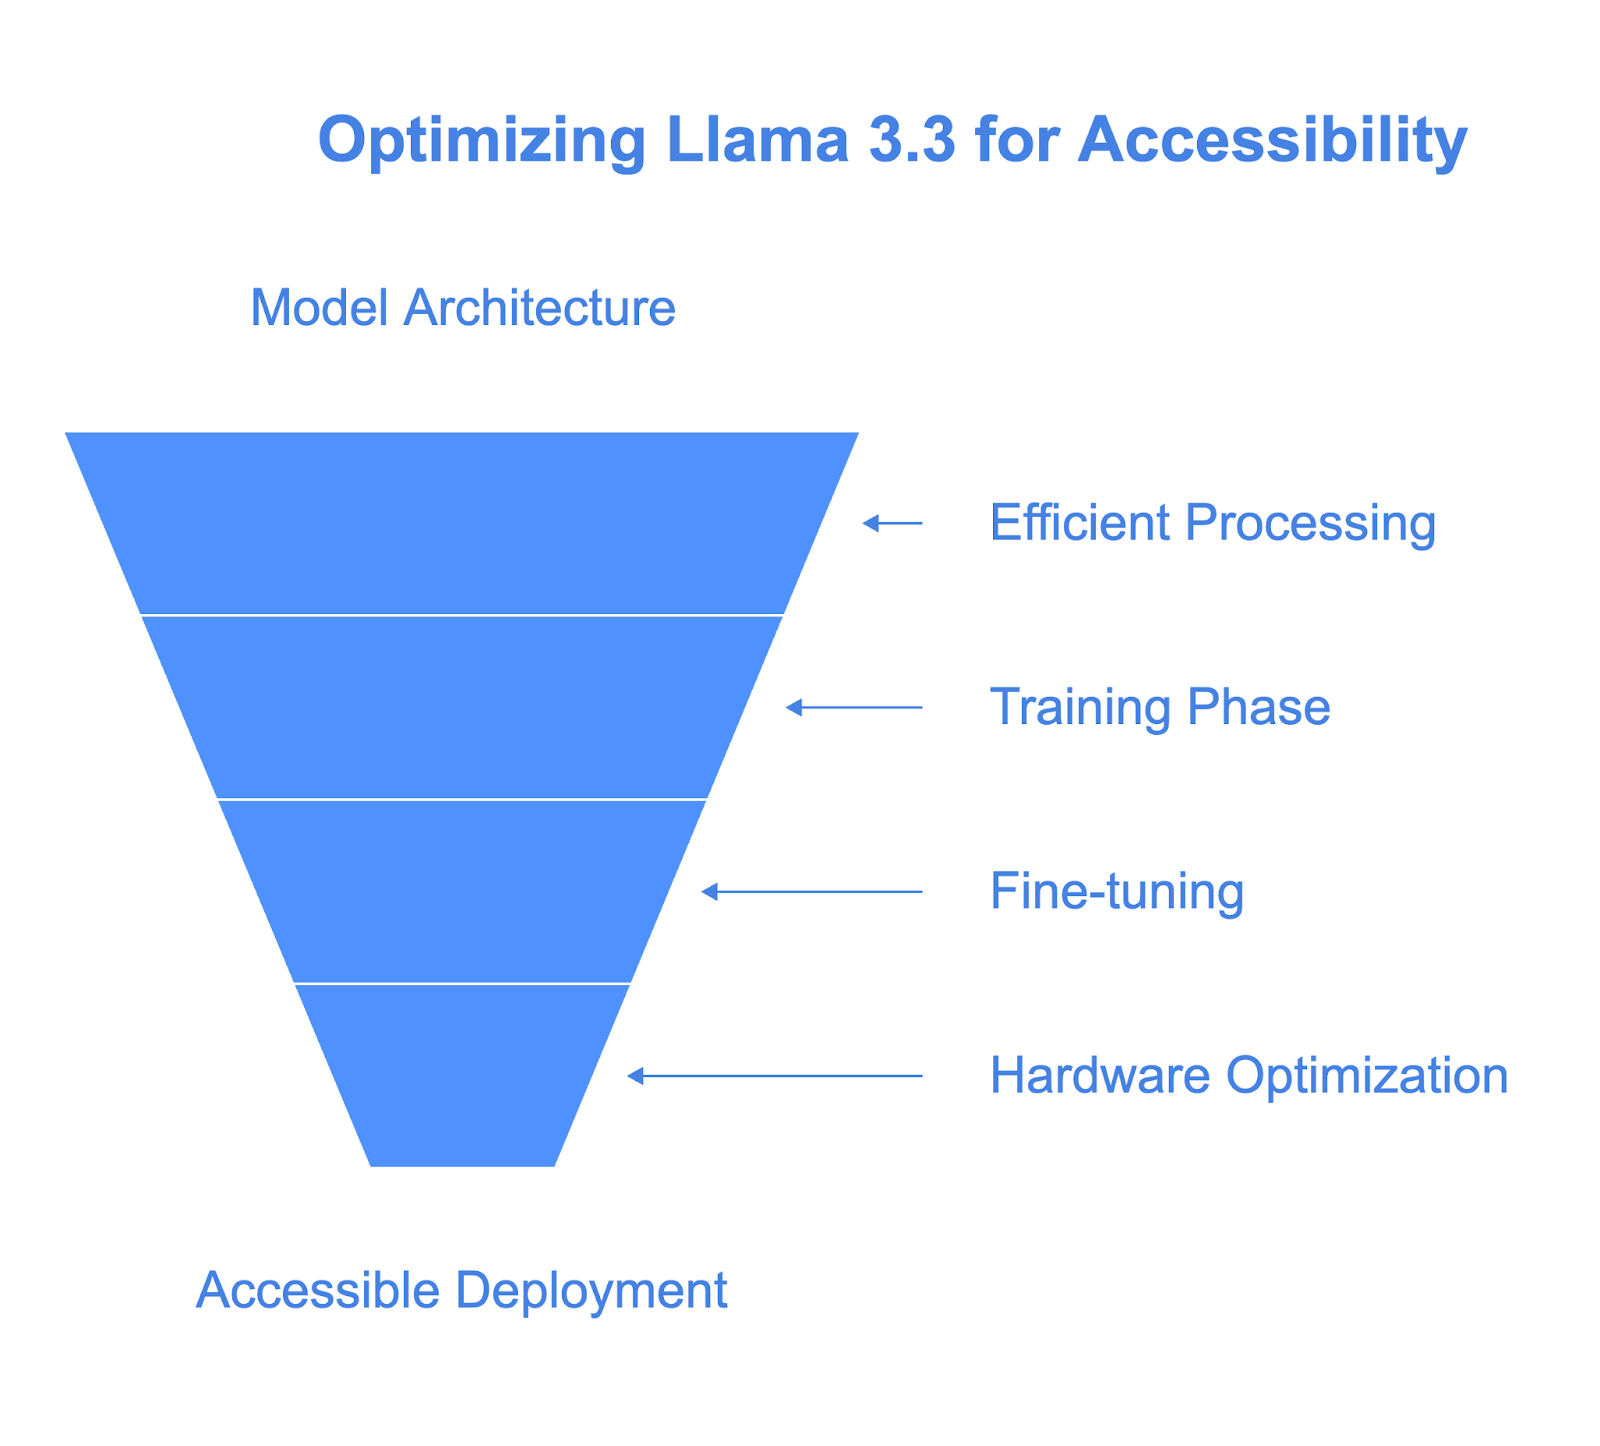
Inti dari Llama 3.3 adalah arsitektur berbasis transformer dengan 70 miliar parameter. Jika Anda belum familiar, parameter pada dasarnya adalah “kenop” yang disetel model selama pelatihan untuk mempelajari pola dan hubungan dalam teks. Inilah yang memungkinkan Llama 3.3 menghasilkan respons yang koheren dan relevan secara konteks.
Yang membedakan Llama 3.3 adalah penggunaan Grouped-Query Attention (GQA). Ini membuat model lebih efisien dengan memungkinkan pemrosesan teks lebih cepat dan dengan sumber daya komputasi yang lebih sedikit. Itulah mengapa model ini dapat mencapai kinerja serupa dengan Llama 3.1 405B yang jauh lebih besar sekaligus jauh lebih ringan pada perangkat keras.
Pelatihan dan fine-tuning
Melatih model seperti Llama 3.3 dimulai dengan mengeksposnya ke dataset yang sangat besar—15 triliun token teks dari sumber yang tersedia publik. Ini memberi model pemahaman bahasa dan pengetahuan yang luas.
Namun kami tahu pelatihan mentah saja tidak cukup untuk membuat model berguna dalam skenario dunia nyata. Di sinilah fine-tuning berperan:
- Supervised fine-tuning (SFT): Di sini, model belajar dari contoh-contoh respons yang dipilih dengan cermat. Anggap ini sebagai memberikan “standar emas” tentang bagaimana seharusnya model berperilaku.
- Reinforcement learning dengan umpan balik manusia (RLHF): Ini melibatkan pengumpulan umpan balik dari manusia tentang bagaimana kinerja model dan menggunakan umpan balik itu untuk menyempurnakan perilakunya.
Pendekatan ganda ini memastikan Llama 3.3 selaras dengan harapan manusia, baik dari segi kegunaan maupun keamanan.
Dirancang untuk perangkat keras yang terjangkau
Llama 3.3 dirancang untuk berjalan secara lokal pada workstation developer umum, sehingga dapat diakses oleh developer tanpa infrastruktur tingkat enterprise. Berbeda dengan model yang lebih besar seperti Llama 3.1 405B, model ini membutuhkan daya komputasi yang jauh lebih sedikit sambil mempertahankan kinerja yang kuat.
Efisiensi ini sebagian besar berkat Grouped-Query Attention (GQA), yang mengoptimalkan cara model memproses teks dengan mengurangi penggunaan memori dan mempercepat inferensi.
Model ini juga mendukung teknik kuantisasi, seperti presisi 8-bit dan 4-bit, melalui alat seperti bitsandbytes. Teknik-teknik ini menurunkan kebutuhan memori secara signifikan tanpa banyak mengorbankan performa.
Selain itu, model ini berskala baik di berbagai konfigurasi perangkat keras, dari GPU tunggal hingga sistem terdistribusi, menawarkan fleksibilitas untuk eksperimen lokal maupun penerapan yang lebih besar.
Dalam praktiknya, ini berarti kami dapat bereksperimen atau menerapkan Llama 3.3 pada perangkat keras yang lebih terjangkau, menghindari biaya tinggi yang biasanya terkait dengan model AI tingkat lanjut. Ini menjadikannya pilihan praktis bagi developer dan tim yang ingin menyeimbangkan performa dengan aksesibilitas.
Benchmark Llama 3.3
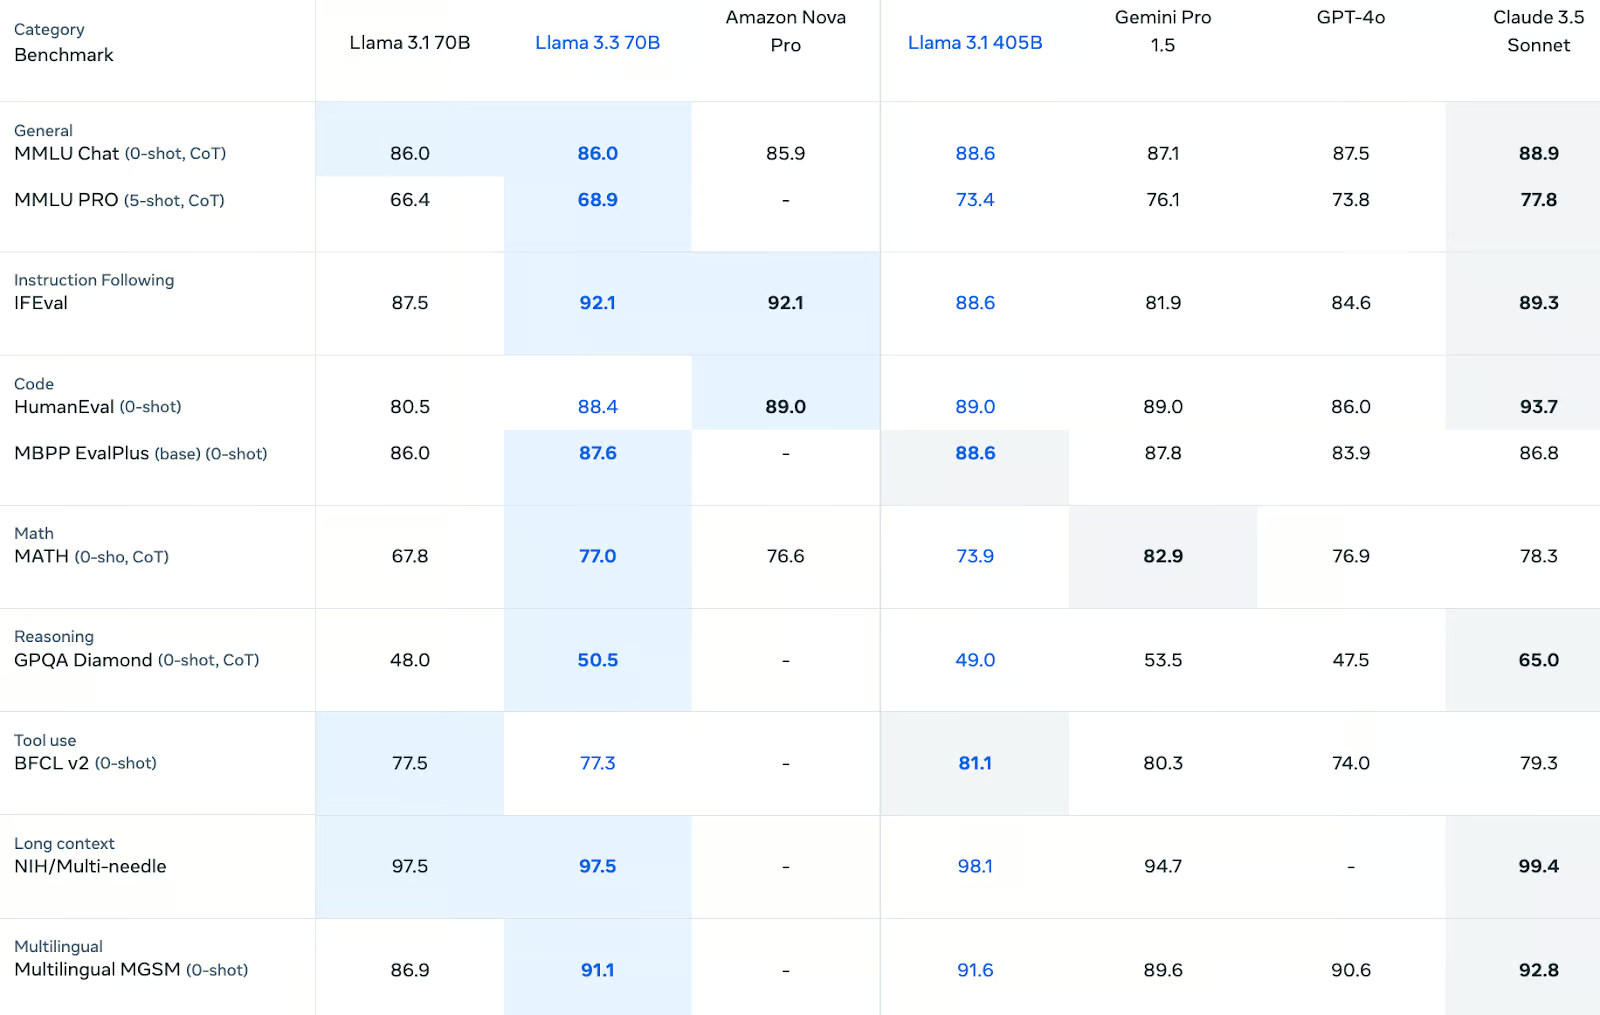
Llama 3.3 tampil baik di berbagai benchmark, dengan hasil menonjol pada instruction following, pengkodean, dan penalaran multibahasa. Meskipun tidak selalu melampaui model yang lebih besar seperti Llama 3.1 405B atau Claude 3.5 Sonnet, model ini memberikan hasil yang andal dan kompetitif di sebagian besar kategori. Bagi developer yang mencari model seimbang yang menangani beragam tugas secara efektif, Llama 3.3 adalah opsi kuat.
Pengetahuan umum dan penalaran
Dalam tugas pengetahuan umum, Llama 3.3 memberikan hasil solid. Model ini meraih skor 86,0 pada MMLU Chat (0-shot, CoT), menyamai pendahulunya Llama 3.1 70B dan tetap kompetitif dengan Amazon Nova Pro (85,9). Namun, sedikit di bawah Llama 3.1 405B (88,6) dan Claude 3.5 Sonnet (88,9) yang lebih besar.
Pada benchmark yang lebih menantang MMLU PRO (5-shot, CoT), Llama 3.3 meningkat dibanding Llama 3.1 70B dengan skor 68,9, namun tetap di belakang Llama 3.1 405B (73,4) dan Claude 3.5 Sonnet (77,8).
Untuk tugas penalaran, Llama 3.3 meraih 50,5 pada GPQA Diamond (0-shot, CoT), sedikit lebih baik daripada Llama 3.1 70B (48,0). Meski berada di belakang beberapa pesaing seperti Claude 3.5 Sonnet (65,0), ini menunjukkan kemajuan dalam penalaran terstruktur.
Instruction following
Llama 3.3 unggul dalam tugas mengikuti instruksi, meraih 92,1 pada IFEval, yang mengukur seberapa baik model mematuhi instruksi pengguna. Hasil ini menempatkannya di depan Llama 3.1 405B (88,6) dan GPT-4o (84,6), serta mendekati Claude 3.5 Sonnet (89,3). Performa di kategori ini menyoroti kemampuan alignment-nya, yang krusial untuk aplikasi seperti chatbot dan asisten tugas-spesifik.
Kemampuan pengkodean
Benchmark pengkodean adalah titik kuat Llama 3.3. Pada HumanEval (0-shot), model ini meraih 88,4, sedikit di bawah Llama 3.1 405B (89,0) dan setara dengan Gemini Pro 1.5. Demikian pula, pada MBPP EvalPlus (dasar), model ini mencapai 87,6, sedikit lebih baik dari Llama 3.1 70B (86,0). Hasil ini menegaskan efektivitasnya dalam menghasilkan kode dan menyelesaikan tugas terkait pemrograman.
Matematika dan penalaran simbolik
Dalam penalaran simbolik, Llama 3.3 menunjukkan kemajuan signifikan. Model ini meraih 77,0 pada MATH (0-shot, CoT), melampaui Llama 3.1 70B (67,8) dan Amazon Nova Pro (76,6). Namun, masih di bawah Gemini Pro 1.5 (82,9). Meski bukan pemimpin di kategori ini, performanya cukup baik untuk banyak tugas penalaran terstruktur.
Kemampuan multibahasa
Llama 3.3 menunjukkan kekuatan signifikan dalam penalaran multibahasa, meraih 91,1 pada MGSM (0-shot). Ini merupakan peningkatan besar dibanding Llama 3.1 70B (86,9) dan menempatkannya dekat dengan Claude 3.5 Sonnet (92,8). Performa di kategori ini menjadikannya pilihan tepat untuk aplikasi multibahasa seperti penerjemahan dan dukungan pelanggan global.
Penggunaan alat dan performa konteks panjang
Untuk penggunaan alat, Llama 3.3 meraih 77,3 pada BFCL v2 (0-shot), sebanding dengan Llama 3.1 70B (77,5) namun di bawah Llama 3.1 405B (81,1). Dalam menangani masukan konteks panjang, model ini meraih 97,5 pada NIH/Multi-Needle, menyamai Llama 3.1 70B dan sedikit di bawah Llama 3.1 405B (98,1). Hasil ini menunjukkan kemampuan kuat untuk alur kerja berbantuan alat dan skenario input yang diperluas.
Use Case Llama 3.3
Llama 3.3 membuka berbagai kemungkinan bagi developer dan peneliti berkat keseimbangan performa kuat dan efisiensi perangkat keras. Kami menghargai bagaimana model ini berjalan efektif pada workstation developer standar, menjadikannya opsi yang mudah dijangkau bagi mereka yang tidak memiliki infrastruktur tingkat enterprise. Berikut beberapa area di mana model ini bisa bermanfaat.
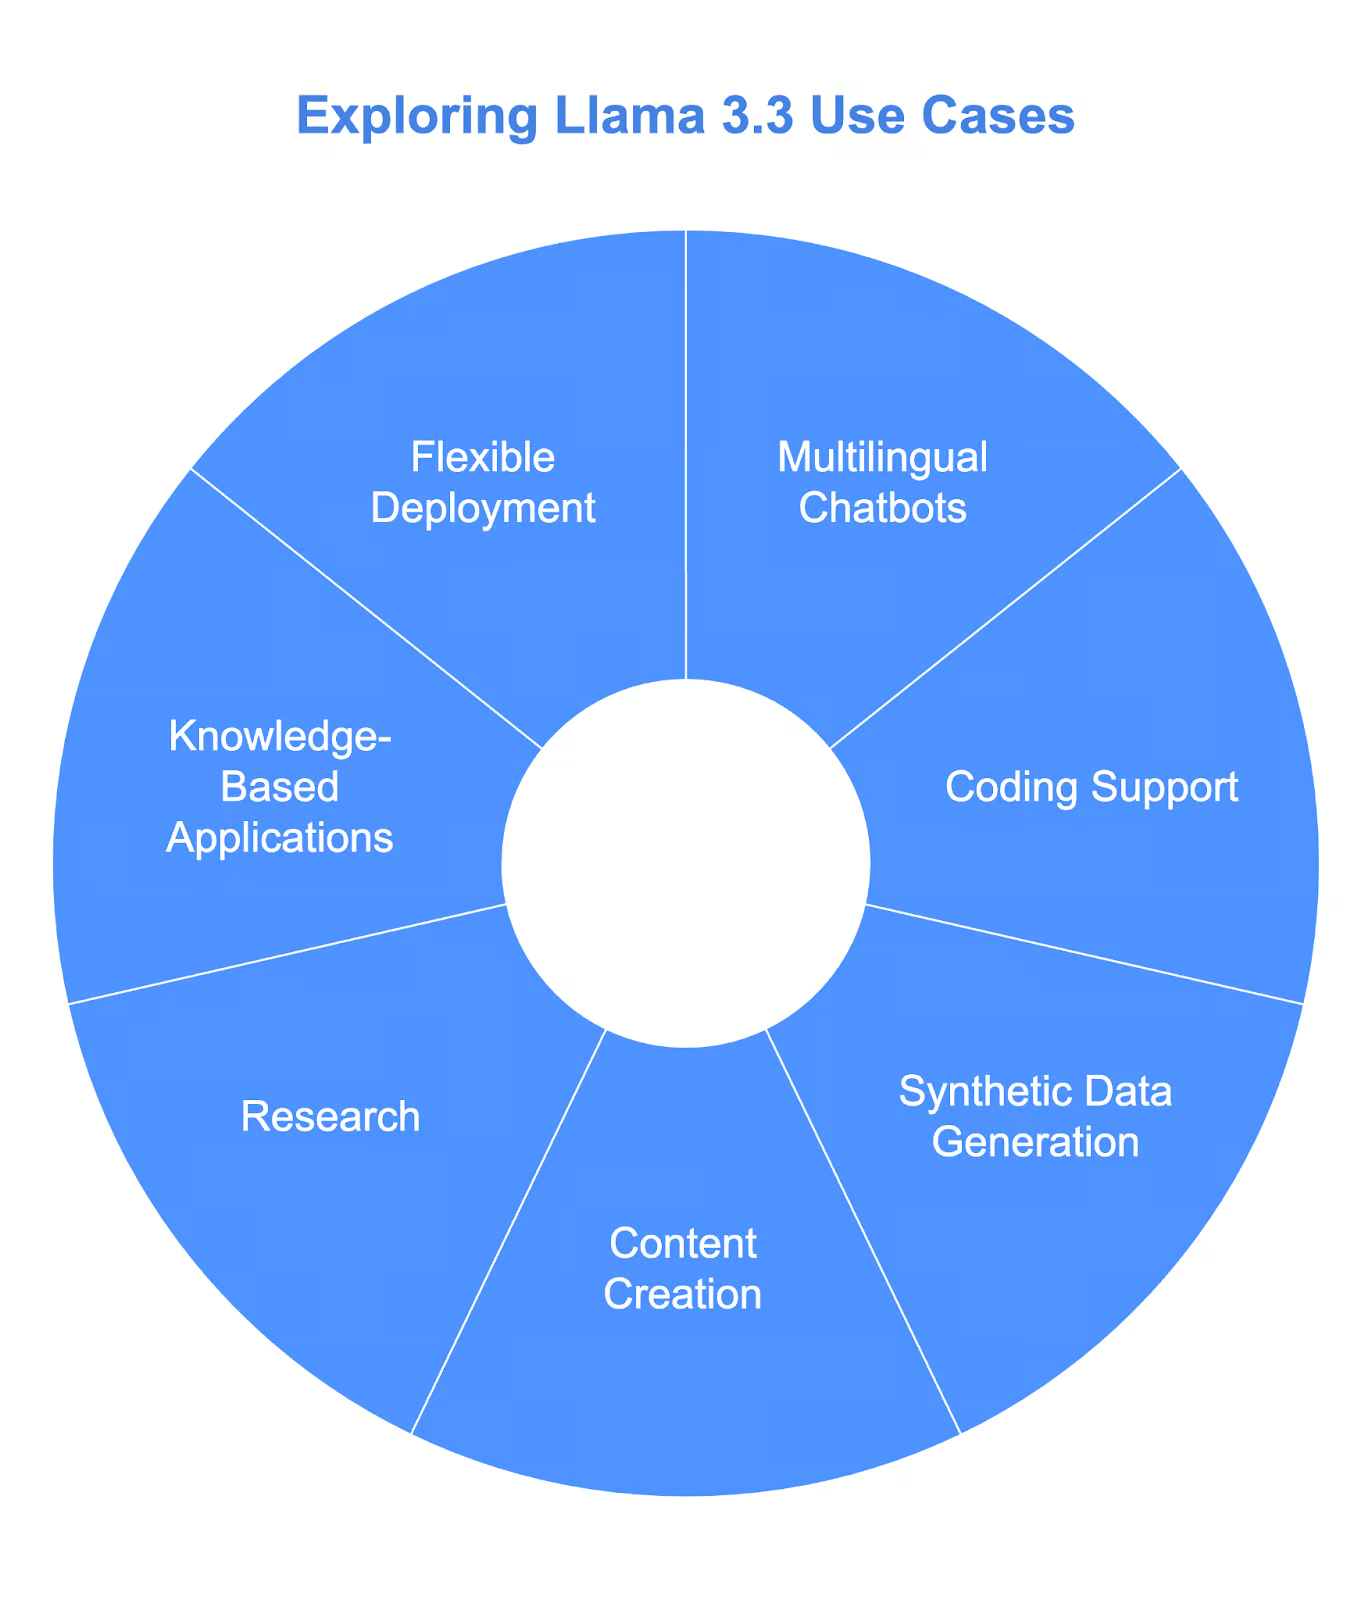
1. Chatbot dan asisten multibahasa
Salah satu kekuatan Llama 3.3 adalah kemampuannya menangani banyak bahasa. Dengan dukungan untuk delapan bahasa inti—termasuk Inggris, Spanyol, Prancis, dan Hindi—model ini ideal untuk membangun chatbot atau asisten virtual multibahasa.
Yang menonjol bagi kami adalah Anda tidak memerlukan pusat data untuk memulai. Developer dapat membuat prototipe dan menerapkan sistem ini pada perangkat keras mereka sendiri, baik untuk dukungan pelanggan, alat edukasi, atau aplikasi percakapan lainnya.
Sebagai contoh, kami dapat menggunakan Llama 3.3 untuk membuat chatbot layanan pelanggan yang menjawab pertanyaan dalam berbagai bahasa, sambil tetap berjalan efisien pada satu GPU.
2. Dukungan pengkodean dan pengembangan perangkat lunak
Dengan skor kuat pada benchmark pengkodean seperti HumanEval dan MBPP EvalPlus, Llama 3.3 adalah asisten andal untuk menghasilkan kode, debug, atau bahkan melengkapi skrip yang belum selesai.
Yang kami nilai sangat berharga adalah seberapa baik model ini berjalan pada perangkat pribadi. Alih-alih mengandalkan sistem cloud yang mahal, Anda dapat menjalankan Llama 3.3 secara lokal untuk mengotomatisasi tugas berulang, menghasilkan boilerplate code, atau membuat unit test. Bagi tim atau developer solo, ini membuat dukungan pengkodean AI tingkat lanjut menjadi praktis dan terjangkau.
3. Pembuatan data sintetis
Area lain di mana Llama 3.3 unggul adalah dalam menghasilkan dataset sintetis. Baik Anda membangun chatbot, melatih classifier, atau mengerjakan proyek NLP, kemampuan untuk menghasilkan data berlabel berkualitas tinggi dapat menghemat banyak waktu dan tenaga.
Kami menilai use case ini sangat berharga bagi tim kecil yang membutuhkan data spesifik domain tetapi tidak memiliki sumber daya untuk mengumpulkannya secara manual. Karena Llama 3.3 berjalan pada perangkat keras tingkat developer, Anda dapat menghasilkan data secara lokal, menurunkan biaya dan menyederhanakan alur kerja.
4. Pembuatan konten dan lokalisasi multibahasa
Kemampuan multibahasa Llama 3.3 juga menjadikannya kandidat kuat untuk pembuatan konten. Kami melihat potensinya dalam memproduksi materi pemasaran terlokalisasi, menerjemahkan dokumen teknis, atau membuat blog multibahasa. Developer dapat melakukan fine-tune model untuk menyesuaikan nada atau gaya, memastikan keluaran sesuai dengan audiens yang dituju.
Misalnya, Anda bisa menggunakan Llama 3.3 untuk membuat draf deskripsi produk dalam beberapa bahasa, meningkatkan proses lokalisasi tanpa perlu tim penerjemah khusus.
5. Riset dan eksperimen
Bagi peneliti, Llama 3.3 menyediakan platform solid untuk mengeksplorasi pemodelan bahasa, alignment, atau teknik fine-tuning. Yang membuatnya menarik adalah efisiensinya—Anda tidak perlu akses ke infrastruktur cloud raksasa untuk bereksperimen dengan AI tingkat lanjut.
Ini menjadikannya alat yang hebat untuk proyek akademik atau riset industri, terutama saat mengeksplorasi area seperti safety alignment atau melatih model yang lebih kecil dan terspesialisasi melalui distilasi.
6. Aplikasi berbasis pengetahuan
Kemampuan pemrosesan teks yang kuat dari Llama 3.3 juga cocok untuk aplikasi seperti tanya jawab, peringkasan, dan pembuatan laporan. Tugas-tugas ini sering memerlukan penanganan volume teks yang besar secara efisien, sesuatu yang dapat dikelola Llama 3.3 dengan baik bahkan pada perangkat pribadi.
Sebagai contoh, kami dapat menggunakannya untuk secara otomatis merangkum umpan balik pelanggan atau menghasilkan dokumentasi internal, menghemat waktu sekaligus menjaga akurasi.
7. Penerapan fleksibel untuk tim kecil
Terakhir, kami menilai Llama 3.3 adalah opsi hebat untuk startup, developer solo, atau tim kecil yang menginginkan kemampuan AI tingkat lanjut tanpa biaya infrastruktur tingkat enterprise. Kemampuannya untuk berjalan di server lokal atau bahkan satu workstation menjadikannya solusi praktis untuk sistem produksi yang ringan.
Cara Mengakses Llama 3.3
Meta menyediakan akses ke Llama 3.3 melalui situs khusus mereka: Llama Downloads. Di sini, Anda akan menemukan tautan ke kartu model resmi, detail lisensi, dan dokumentasi tambahan untuk membantu Anda memulai.
Untuk panduan mendalam, kami merekomendasikan menelusuri sumber resmi berikut:
- Kartu model dan petunjuk penggunaan di GitHub: Repositori Meta di GitHub.
- Halaman model di Hugging Face: Llama 3.3-70B di Hugging Face.
Platform ini menyediakan dokumentasi terperinci dan forum komunitas tempat Anda dapat bertanya atau memecahkan masalah.
Harga Llama 3.3
Menurut kami, struktur harga ini membuat Llama 3.3 sangat menarik bagi developer dengan anggaran terbatas atau yang menskalakan proyek dengan kebutuhan token tinggi. Baik Anda menjalankannya secara lokal maupun melalui platform, tarif kompetitif ini memastikan AI berkualitas tinggi dapat diakses tanpa menguras anggaran.
Biaya token input
Untuk memproses 1 juta token input, Llama 3.3 dihargai $0,1, yang setara dengan pendahulunya, Llama 3.1 70B. Dibandingkan model lain, ini salah satu tarif terendah:
- Amazon Nova Pro mengenakan biaya $0,80, delapan kali lebih mahal untuk volume yang sama.
- GPT-4o dan Claude 3.5 Sonnet masing-masing berharga $2,5 dan $3,0, jauh lebih tinggi daripada Llama 3.3.
Biaya input yang rendah ini membuat Llama 3.3 sangat cocok untuk aplikasi yang memerlukan pemrosesan teks dalam jumlah besar, seperti chatbot atau alat analisis teks.
Biaya token output
Untuk 1 juta token output, Llama 3.3 dihargai $0,4, kembali setara dengan biaya Llama 3.1 70B. Berikut perbandingannya:
- Amazon Nova Pro dihargai $1,8, lebih dari empat kali lipat Llama 3.3.
- GPT-4o mengenakan $10,0, dan Claude 3.5 Sonnet mengenakan $15,0, menjadikan Llama 3.3 opsi paling ekonomis dengan selisih lebar.
Untuk aplikasi yang menghasilkan teks dalam jumlah besar, seperti pembuatan data sintetis atau pembuatan konten, Llama 3.3 menawarkan penghematan biaya yang signifikan.
Kesimpulan
Kami memandang Llama 3.3 sebagai contoh meyakinkan bagaimana model bahasa besar dapat menyeimbangkan kapabilitas dengan aksesibilitas.
Sebagai model dengan 70 miliar parameter, model ini menghadirkan kinerja yang sebanding dengan Llama 3.1 405B yang jauh lebih besar tetapi dengan kebutuhan komputasi yang jauh lebih rendah.
Bagi developer yang tidak memiliki akses ke perangkat keras tingkat enterprise, model ini mewakili cara praktis untuk mengintegrasikan AI berkualitas tinggi ke dalam alur kerja mereka.
FAQ
Apa perbedaan Llama 3.3 dengan Llama 3.2?
Llama 3.3 menyempurnakan Llama 3.2 dengan fine-tuning yang lebih baik (SFT dan RLHF), fitur keamanan yang diperluas, dukungan multibahasa (8 bahasa), jendela konteks lebih panjang (128k token), dan performa benchmark yang lebih kuat. Model ini juga menambahkan kapabilitas penggunaan alat, efisiensi energi yang ditingkatkan, dan kerangka AI yang bertanggung jawab yang tangguh, menjadikannya lebih bertenaga dan serbaguna.
Apa perbedaan Llama 3.3 dengan Llama 405B?
Llama 3.3 menghadirkan performa yang sebanding dengan Llama 3.1 405B namun jauh lebih efisien, membutuhkan daya komputasi yang jauh lebih sedikit untuk dijalankan.
Bahasa apa saja yang didukung Llama 3.3?
Llama 3.3 secara native mendukung bahasa Inggris, Prancis, Jerman, Hindi, Italia, Portugis, Spanyol, dan Thai. Developer dapat melakukan fine-tune untuk bahasa lain, tetapi diperlukan pengamanan tambahan.
Benchmark apa yang paling dikuasai Llama 3.3?
Llama 3.3 meraih skor tinggi pada benchmark seperti MMLU, HumanEval, dan MGSM, melampaui banyak model lain dalam kategori seperti penalaran, pengkodean, dan kapabilitas multibahasa.
Apakah Llama 3.3 dapat berjalan pada perangkat keras developer standar?
Ya, Llama 3.3 dirancang untuk berjalan pada GPU umum dan workstation tingkat developer, sehingga dapat diakses oleh developer tanpa infrastruktur tingkat enterprise.
Saya adalah editor dan penulis yang mengulas blog, tutorial, dan berita AI, memastikan semuanya selaras dengan strategi konten yang kuat dan praktik terbaik SEO. Saya telah menulis kursus data science tentang Python, statistik, probabilitas, dan visualisasi data. Saya juga telah menerbitkan novel pemenang penghargaan dan menghabiskan waktu luang untuk menulis skenario serta menyutradarai film.

Saya penulis dan editor data science dengan kontribusi pada artikel riset di jurnal ilmiah. Saya sangat tertarik pada aljabar linear, statistika, R, dan sejenisnya. Saya juga cukup sering bermain catur!

