
कोर्स
स्केलेबल एजेंटिक सिस्टम बनाना
1 घंटा 30 मिनट
21.8K
GLM 4.7 Flash एक नया जारी ओपन-वेट बड़ा भाषा मॉडल है, जिसने इसलिए विशेष ध्यान खींचा है क्योंकि इसे लोकली चलाया जा सकता है और फिर भी कोडिंग, रीज़निंग और एजेंट-स्टाइल वर्कफ़्लो के लिए मजबूत प्रदर्शन देता है।
कई आधुनिक मॉडलों के विपरीत जो पेड API या क्लाउड-होस्टेड इंफ्रास्ट्रक्चर पर निर्भर होते हैं, GLM 4.7 Flash को हल्के इन्फ़ेरेंस फ़्रेमवर्क का उपयोग करके पूरी तरह लोकल हार्डवेयर पर चलाया जा सकता है। यह उन डेवलपर्स के लिए आकर्षक विकल्प है जो अपने मॉडलों पर पूरा नियंत्रण, ऑफ़लाइन उपयोग, पूर्वानुमेय लागत, और डेवलपमेंट के दौरान तेज़ इटरेशन चाहते हैं।
सही सेटअप और क्वांटाइज़ेशन के साथ, यह मॉडल कंज़्यूमर GPUs पर उच्च टोकन जेनरेशन स्पीड हासिल कर सकता है, साथ ही उपयोगी रीज़निंग गुणवत्ता बनाए रखता है।
इस ट्यूटोरियल में, मैं आपको दिखाऊँगा कि llama.cpp का उपयोग करके GLM 4.7 Flash को लोकली चलाने के लिए आवश्यक सिस्टम एनवायरनमेंट कैसे सेटअप करें। फोकस सेटअप को सरल, साफ़-सुथरा और पुनरुत्पादन योग्य रखने पर है। हम मॉडल डाउनलोड करेंगे, llama.cpp को बिल्ड और कॉन्फ़िगर करेंगे, और फिर मॉडल को वेब एप्लिकेशन तथा API-आधारित इन्फ़ेरेंस सर्वर दोनों से टेस्ट करेंगे।
ट्यूटोरियल के आगे, हम लोकल llama.cpp सर्वर को एक AI कोडिंग एजेंट के साथ इंटीग्रेट करेंगे, जिससे ऑटोमेटेड कोड जेनरेशन, एक्ज़ीक्यूशन और टेस्टिंग वर्कफ़्लो सक्षम होंगे। आप हमारा गाइड GLM-4.7 को लोकली कैसे चलाएँ भी देख सकते हैं।
GLM 4.7 Flash को लोकली चलाने से पहले, सुनिश्चित करें कि आपका सिस्टम निम्नलिखित आवश्यकताओं को पूरा करता है।
फुल प्रिसिजन या उच्च बिट क्वांटाइज़ेशन के लिए:
4-बिट क्वांटाइज़्ड मॉडल के लिए
Q4_K_XL क्वांटाइज़ेशन मेमोरी उपयोग को काफ़ी घटाते हुए भी मजबूत रीज़निंग और कोडिंग प्रदर्शन बनाए रखता है, जिससे यह RTX 3090, RTX 4080 और RTX 4090 जैसे GPUs के लिए उपयुक्त बनता है। यह वैरिएंट उन उपयोगकर्ताओं के लिए आदर्श है जो फुल प्रिसिजन वेट्स चलाए बिना उच्च टोकन थ्रूपुट चाहते हैं।
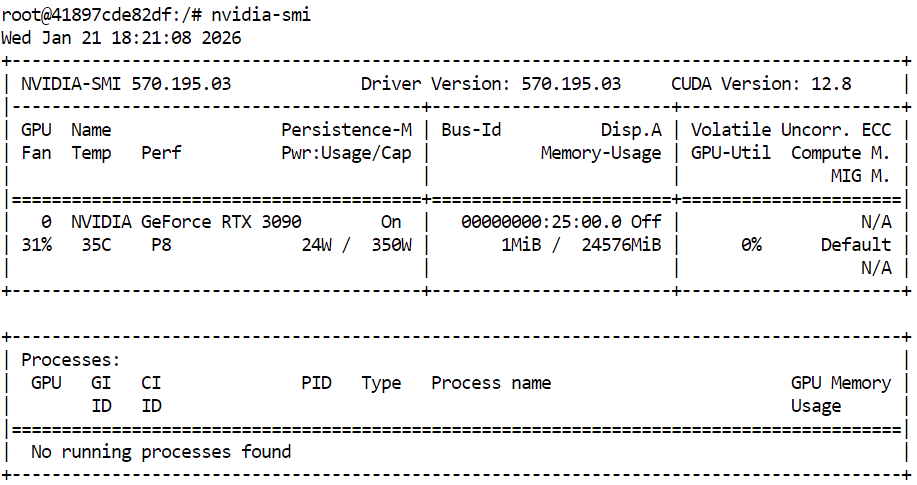
llama.cpp को बिल्ड करने और GLM 4.7 Flash चलाने से पहले, पहले सुनिश्चित करें कि आपका NVIDIA GPU और ड्राइवर्स सही तरह इंस्टॉल हैं। इससे यह सुनिश्चित होता है कि CUDA उपलब्ध है और सिस्टम GPU-एक्सेलरेटेड इन्फ़ेरेंस चला सकता है।
nvidia-smiआउटपुट RTX 3090 के साथ CUDA वर्ज़न 12.8 और 24GB GPU मेमोरी उपलब्ध दिखाता है, जो GLM 4.7 Flash और इसके क्वांटाइज़्ड वैरिएंट्स चलाने के लिए पर्याप्त है।
अब एक टर्मिनल खोलें और एक साफ़ वर्कस्पेस और डायरेक्टरी संरचना परिभाषित करें। इससे सोर्स कोड, मॉडल फ़ाइलें, और कैश डेटा संगठित रहते हैं, परमिशन समस्याओं से बचाव होता है, और सेटअप को दोहराना आसान बनता है।
export WORKDIR="/workspace"
export LLAMA_DIR="$WORKDIR/llama.cpp"
export MODEL_DIR="$WORKDIR/models/unsloth/GLM-4.7-Flash-GGUF"
वह डायरेक्टरी बनाएँ जहाँ मॉडल फ़ाइलें स्टोर होंगी, और होम डायरेक्टरी के बजाय वर्कस्पेस के अंदर Hugging Face कैश लोकेशन कॉन्फ़िगर करें। इससे डाउनलोड परफ़ॉर्मेंस बेहतर होता है और गैरज़रूरी चेतावनियाँ नहीं आतीं।
mkdir -p "$MODEL_DIR"
export HF_HOME="$WORKDIR/.cache/huggingface"
export HUGGINGFACE_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
export HF_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
अतिरिक्त एनवायरनमेंट वेरिएबल सेट करें ताकि सिमलिंक चेतावनियाँ दबें और हाई-परफ़ॉर्मेंस डाउनलोड सक्षम हों।
export HF_HUB_DISABLE_SYMLINKS_WARNING=1
export HF_XET_HIGH_PERFORMANCE=1
अंत में, llama.cpp को बिल्ड करने और डाउनलोड मैनेज करने हेतु आवश्यक सिस्टम डिपेंडेंसी इंस्टॉल करें।
sudo apt-get update
sudo apt-get install -y \
  build-essential cmake git curl libcurl4-openssl-dev
अब तक सिस्टम एनवायरनमेंट तैयार है। अगला सेक्शन CUDA सपोर्ट सक्षम करके llama.cpp को क्लोन और बिल्ड करने पर केंद्रित होगा।
एनवायरनमेंट तैयार होने के बाद, अगला कदम llama.cpp इंस्टॉल करना और CUDA सपोर्ट सक्षम करके इसे बिल्ड करना है। इससे GLM 4.7 Flash GPU पर कुशलतापूर्वक चल पाएगा।
टर्मिनल में, अपने वर्कस्पेस में जाएँ। फिर आधिकारिक llama.cpp रिपॉज़िटरी क्लोन करने के लिए निम्न कमांड चलाएँ।
git clone https://github.com/ggml-org/llama.cpp "$LLAMA_DIR"रिपॉज़िटरी क्लोन होने के बाद, सोर्स फ़ाइलें वर्कस्पेस डायरेक्टरी में डाउनलोड हो जाएँगी।
Cloning into '/workspace/llama.cpp'...
remote: Enumerating objects: 76714, done.
remote: Counting objects: 100% (238/238), done.
remote: Compressing objects: 100% (157/157), done.
remote: Total 76714 (delta 172), reused 81 (delta 81), pack-reused 76476 (from 3)
Receiving objects: 100% (76714/76714), 282.23 MiB | 13.11 MiB/s, done.
Resolving deltas: 100% (55422/55422), done.
Updating files: 100% (2145/2145), done.
अब CMake का उपयोग करके बिल्ड कॉन्फ़िगर करें और स्पष्ट रूप से CUDA सपोर्ट सक्षम करें। यह क़दम GPU-एक्सेलरेटेड बाइनरीज़ कम्पाइल करने के लिए बिल्ड सिस्टम तैयार करता है।
cmake "$LLAMA_DIR" -B "$LLAMA_DIR/build" \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON
कॉन्फ़िगरेशन पूर्ण होने पर, आवश्यक llama.cpp बाइनरीज़ बिल्ड करें। यह कमांड कोर इन्फ़ेरेंस टूल्स कम्पाइल करती है, जिनमें कमांड-लाइन इंटरफेस और इन्फ़ेरेंस सर्वर शामिल हैं।
cmake --build "$LLAMA_DIR/build" --config Release -j --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
बिल्ड समाप्त होने के बाद, कम्पाइल्ड बाइनरीज़ को आसान एक्सेस के लिए मुख्य llama.cpp डायरेक्टरी में कॉपी करें।
cp "$LLAMA_DIR/build/bin/llama-"* "$LLAMA_DIR/"अंत में, इन्फ़ेरेंस सर्वर की हेल्प कमांड चलाकर सत्यापित करें कि llama.cpp सही तरह बिल्ड हुआ है और CUDA डिटेक्ट हो रही है।
"$LLAMA_DIR/llama-server" --help >/dev/null && echo "✔ llama.cpp built"यदि CUDA सपोर्ट सही तरह सक्षम है, तो आउटपुट पुष्टि करेगा कि CUDA डिवाइस मिला, जिसमें GPU मॉडल और कंप्यूट कैपेबिलिटी शामिल होगी।
ggml_cuda_init: found 1 CUDA devices:
  Device 0: NVIDIA GeForce RTX 3090, compute capability 8.6, VMM: yes
✔ llama.cpp builtllama.cpp बिल्ड हो चुका है और CUDA सपोर्ट सत्यापित है, अब अगला कदम GLM 4.7 Flash मॉडल डाउनलोड करना है। इस ट्यूटोरियल में, हम बड़े मॉडल फ़ाइलों के तेज़ और विश्वसनीय डाउनलोड के लिए Hugging Face Hub के साथ Xet सपोर्ट का उपयोग करते हैं।
उसी टर्मिनल में, हाई-परफ़ॉर्मेंस मॉडल डाउनलोड के लिए आवश्यक Python पैकेज इंस्टॉल करने हेतु निम्न कमांड चलाएँ।
pip -q install -U "huggingface_hub[hf_xet]" hf-xet
pip -q install -U hf_transfer
इसके बाद, टर्मिनल में निम्न Python स्क्रिप्ट चलाएँ ताकि 4-बिट क्वांटाइज़्ड मॉडल वैरिएंट डाउनलोड हो। यह स्क्रिप्ट पहले परिभाषित वर्कस्पेस पथों का उपयोग करती है और केवल आवश्यक GGUF फ़ाइल डाउनलोड करती है।
python - <<'PY'
import os
from huggingface_hub import snapshot_download

model_dir = os.environ["MODEL_DIR"]

snapshot_download(
    repo_id="unsloth/GLM-4.7-Flash-GGUF",
    local_dir=model_dir,
    allow_patterns=["*UD-Q4_K_XL*"],
)

print("✔ Download complete:", model_dir)
PY
डाउनलोड पूरा होने पर, आपको आउटपुट दिखेगा जो पुष्टि करेगा कि मॉडल फ़ाइल सफलतापूर्वक प्राप्त हो गई है, कुल आकार लगभग 17.5 GB है।
Fetching 1 files: 100%|███████████████████████████████████████████████████████████████████████████████████| 1/1 [00:52<00:00, 52.80s/it]
Download complete: 100%|████████████████████████████████████████████████████████████████████████████| 17.5G/17.5G [00:52<00:00, 480MB/s]✔ Download complete: /workspace/models/unsloth/GLM-4.7-Flash-GGUF
अंत में, सत्यापित करें कि मॉडल फ़ाइल टार्गेट डायरेक्टरी में मौजूद है।
ls -lh "$MODEL_DIR"आपको GLM-4.7-Flash-UD-Q4_K_XL.gguf फ़ाइल सूचीबद्ध दिखनी चाहिए, जो पुष्टि करती है कि मॉडल इन्फ़ेरेंस के लिए तैयार है।
total 17G
-rw-rw-rw- 1 root root 17G Jan 21 18:46 GLM-4.7-Flash-UD-Q4_K_XL.ggufमॉडल डाउनलोड हो चुका है और llama.cpp CUDA सपोर्ट के साथ बिल्ड है, अब अगला कदम इन्फ़ेरेंस सर्वर लॉन्च करना है। इससे GLM 4.7 Flash एक लोकल API के रूप में उपलब्ध हो जाएगा, जिसे यूज़र इंटरफेसेज़, स्क्रिप्ट्स और AI कोडिंग एजेंट्स उपयोग कर सकेंगे।
कृपया वही टर्मिनल सेशन और वर्कस्पेस उपयोग करें जिसे आपने पिछले सेक्शनों में कॉन्फ़िगर किया था।
सबसे पहले, डाउनलोड की गई GGUF मॉडल फ़ाइल खोजें और उसका पथ एक एनवायरनमेंट वेरिएबल में स्टोर करें।
export MODEL_FILE="$(ls "$MODEL_DIR"/*.gguf | grep -i UD-Q4_K_XL | head -n 1)"अब निम्न कमांड का उपयोग करके llama.cpp इन्फ़ेरेंस सर्वर शुरू करें। यह कॉन्फ़िगरेशन RTX 3090 के लिए ऑप्टिमाइज़्ड है और थ्रूपुट, लेटेंसी और कॉन्टेक्स्ट लंबाई के बीच संतुलन रखती है।
$LLAMA_DIR/llama-server \
  --model "$MODEL_FILE" \
  --alias "GLM-4.7-Flash" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 16384 \
  --temp 0.7 \
  --top-p 1 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
--ubatch-size 256--model इन्फ़ेरेंस के लिए चयनित GLM 4.7 Flash GGUF मॉडल फ़ाइल लोड करता है।--alias एक पठनीय मॉडल नाम असाइन करता है जो API रेस्पॉन्स और लॉग्स में दिखाई देता है।--threads 32 CPU थ्रेड्स का उपयोग करता है ताकि हाई-कोर सिस्टम पर टोकनाइज़ेशन, शेड्यूलिंग, और रिक्वेस्ट हैंडलिंग हो सके।--host सर्वर को सभी नेटवर्क इंटरफ़ेस पर बाइंड करता है ताकि इसे लोकली या नेटवर्क पर अन्य मशीनों से एक्सेस किया जा सके।--ctx-size बड़ा कॉन्टेक्स्ट विंडो सेट करता है जो लंबे प्रॉम्प्ट सपोर्ट और GPU मेमोरी उपयोग के बीच संतुलन रखता है।--temp मध्यम रैंडमनेस लागू करता है ताकि रेस्पॉन्स गुणवत्ता बेहतर हो पर रीज़निंग स्थिरता प्रभावित न हो।--top-p न्यूक्लियस फ़िल्टरिंग को निष्क्रिय करता है ताकि जेनरेशन के दौरान पूर्ण टोकन डिस्ट्रीब्यूशन उपलब्ध रहे।--port 8080 इन्फ़ेरेंस सर्वर को एक मानक लोकल डेवलपमेंट पोर्ट पर एक्सपोज़ करता है।--fit ऑटोमैटिक मेमोरी फ़िटिंग सक्षम करता है ताकि VRAM लिमिट से ऊपर जाए बिना GPU उपयोग अधिकतम हो।--prio समवर्ती रिक्वेस्ट के तहत इन्फ़ेरेंस वर्कलोड के लिए संतुलित प्राथमिकता स्तर सेट करता है।--jinja स्ट्रक्चर्ड प्रॉम्प्ट्स और एजेंट-स्टाइल वर्कफ़्लो के लिए Jinja टेम्पलेटिंग सक्षम करता है।--flash-attn GPU द्वारा समर्थित होने पर स्वचालित रूप से Flash Attention सक्षम करता है ताकि थ्रूपुट बढ़े।--batch-size बड़े बैच प्रोसेसिंग की अनुमति देता है ताकि RTX 3090 पर टोकन थ्रूपुट बेहतर हो।--ubatch-size बड़े बैच को छोटे माइक्रो-बैच में विभाजित करता है ताकि मेमोरी प्रेशर और लेटेंसी नियंत्रित रहे।सर्वर शुरू होते ही, यह मॉडल को GPU मेमोरी में लोड करेगा और पोर्ट 8080 पर रिक्वेस्ट सुनना शुरू करेगा। इस बिंदु पर, GLM 4.7 Flash लोकली चल रहा है और चैट, कम्प्लीशन, और एजेंट-आधारित वर्कफ़्लो के लिए HTTP एंडपॉइंट्स के ज़रिए एक्सेस किया जा सकता है।
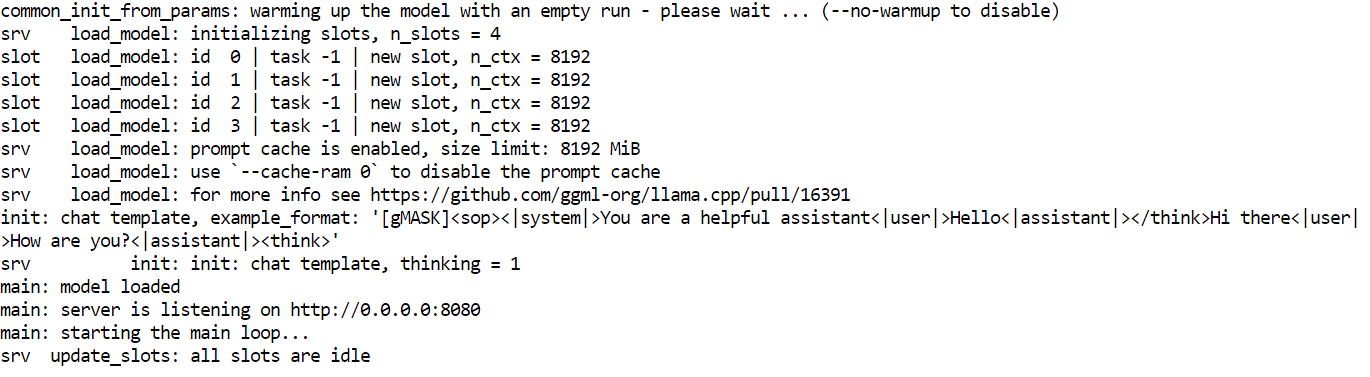
इन्फ़ेरेंस सर्वर चल रहा है, अब आप बिल्ट-इन वेब UI, डायरेक्ट HTTP रिक्वेस्ट और OpenAI-कम्पैटिबल Python SDK सहित कई इंटरफेसेज़ से GLM 4.7 Flash का परीक्षण कर सकते हैं।
llama.cpp वेब इंटरफेस यहाँ उपलब्ध है: http://0.0.0.0:8080
इस URL को कॉपी करें और अपने वेब ब्राउज़र में खोलें ताकि ChatGPT जैसी सरल चैट इंटरफेस तक पहुँच हो सके।
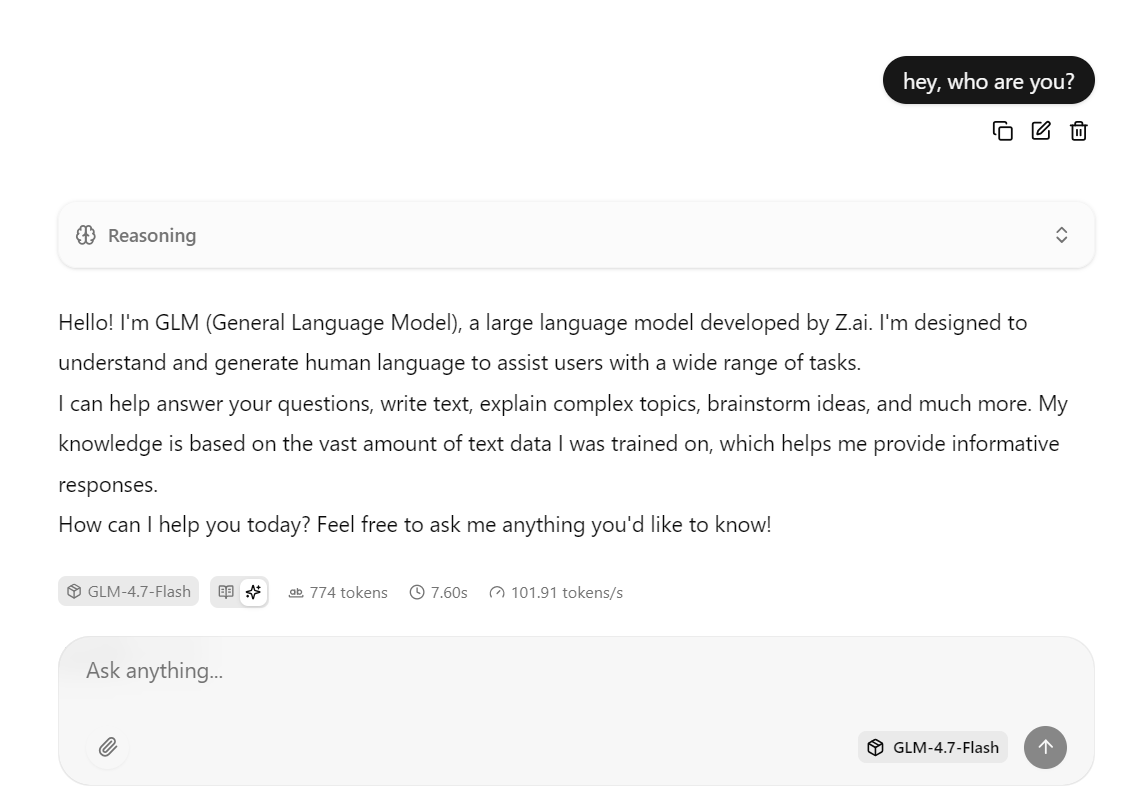
एक प्रॉम्प्ट दर्ज करें, और मॉडल तुरंत रेस्पॉन्स जनरेट करना शुरू कर देगा।
यह सेटअप स्पीड के लिए ऑप्टिमाइज़्ड है: RTX 3090 पर CUDA सक्षम करके मॉडल चलाया जा रहा है, जहाँ उपलब्ध हो वहाँ Flash Attention का उपयोग होता है, और उच्च थ्रूपुट के लिए बैचिंग सेटिंग्स ट्यून हैं।
व्यवहार में, यह कॉन्फ़िगरेशन छोटे से मध्यम रेस्पॉन्स के लिए लगभग 100 टोकन प्रति सेकंड तक पहुँच सकता है।
आप उसी सर्वर से curl कमांड का उपयोग करके भी इंटरैक्ट कर सकते हैं। एक नया टर्मिनल विंडो खोलें और चैट कम्प्लीशन प्रॉम्प्ट भेजने के लिए निम्न रिक्वेस्ट चलाएँ।
curl -N http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer local" \
  -d '{
    "model": "GLM-4.7-Flash",
    "messages": [
      { "role": "user", "content": "Write a short bash script that prints numbers 1 to 5." }
    ]
  }'
आप OpenAI Python SDK इंस्टॉल करके भी मॉडल टेस्ट कर सकते हैं।
pip -q install openaiइस Python उदाहरण में, OpenAI क्लाइंट को लोकली चल रहे llama.cpp इन्फ़ेरेंस सर्वर को रिक्वेस्ट भेजने के लिए कॉन्फ़िगर किया गया है।
base_url लोकल API एंडपॉइंट की ओर इशारा करता है, और API कुंजी फ़ील्ड SDK द्वारा आवश्यक है पर इसे किसी भी प्लेसहोल्डर मान पर सेट किया जा सकता है क्योंकि ऑथेंटिकेशन लोकली हैंडल होता है।
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local"
)
इसके बाद क्लाइंट, इन्फ़ेरेंस सर्वर लॉन्च करते समय परिभाषित मॉडल एलियस का उपयोग करके GLM 4.7 Flash को एक चैट कम्प्लीशन रिक्वेस्ट भेजता है। प्रॉम्प्ट मानक चैट फ़ॉर्मैट में दिया जाता है और रेस्पॉन्स एक स्ट्रक्चर्ड ऑब्जेक्ट के रूप में वापस आता है।
r = client.chat.completions.create(
    model="GLM-4.7-Flash",
    messages=[{"role": "user", "content": "Build me a Simple API server using FastAPI"}]
)

print(r.choices[0].message.content)
कुछ ही सेकंड में, मॉडल पूरा रेस्पॉन्स लौटाएगा, जिसमें उदाहरण कोड और व्याख्याएँ शामिल होंगी।
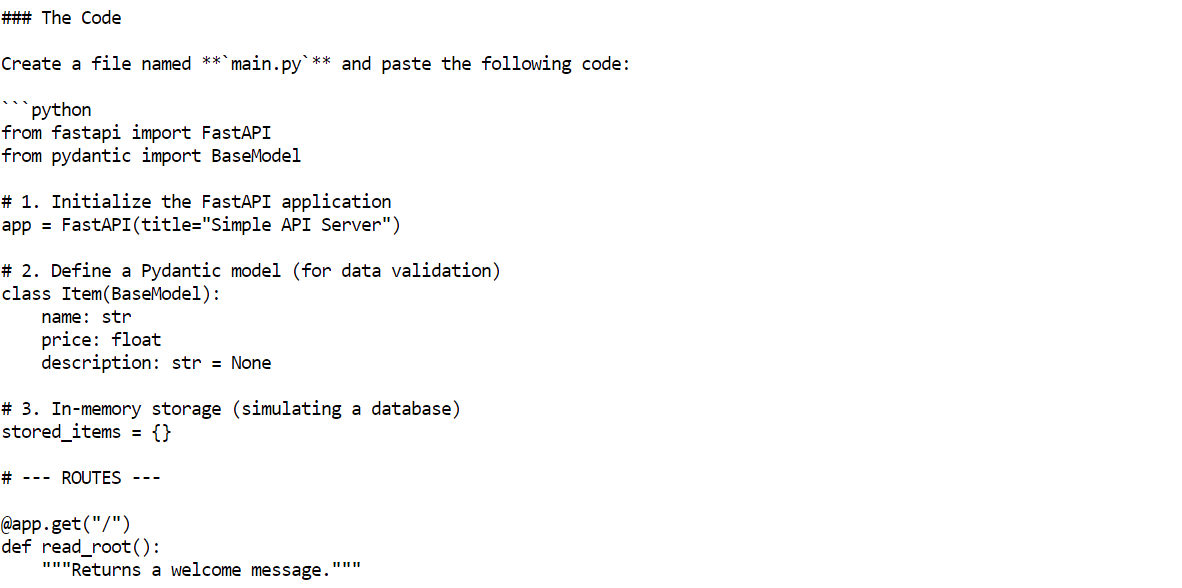
OpenCode एक ओपन सोर्स AI कोडिंग एजेंट है, जिसे लोकली चलाने के लिए डिज़ाइन किया गया है और जो कोड जेनरेशन, फ़ाइल एडिटिंग, कमांड एक्ज़ीक्यूशन, और इटरेटिव प्रॉब्लम सॉल्विंग जैसे एजेंटिक वर्कफ़्लो सपोर्ट करता है।
क्लाउड-आधारित कोडिंग असिस्टेंट्स के विपरीत, OpenCode को सेल्फ-होस्टेड इन्फ़ेरेंस सर्वर से कनेक्ट किया जा सकता है, जिससे आप पूरी तरह लोकल और मुफ़्त AI कोडिंग सेटअप बना सकते हैं।
इस ट्यूटोरियल में, OpenCode को OpenAI-कम्पैटिबल API के माध्यम से GLM 4.7 Flash चलाने वाले लोकल llama.cpp सर्वर का उपयोग करने के लिए कॉन्फ़िगर किया गया है।
शुरू करने के लिए, वही टर्मिनल सेशन उपयोग करें और आधिकारिक इंस्टॉलेशन स्क्रिप्ट से OpenCode इंस्टॉल करें।
curl -fsSL https://opencode.ai/install | bash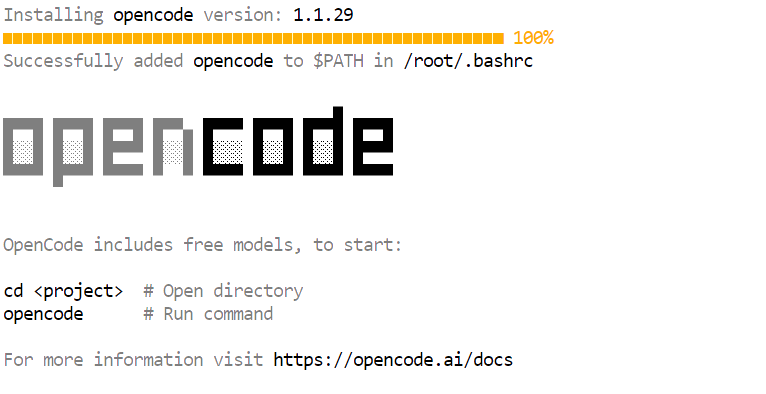 इंस्टॉलेशन के बाद, अपना PATH अपडेट करें ताकि opencode कमांड टर्मिनल में उपलब्ध हो।
export PATH="$HOME/.local/bin:$PATH"एक नया टर्मिनल विंडो खोलें और सत्यापित करें कि OpenCode सही तरह इंस्टॉल हुआ है।
opencode --versionआपको निम्न जैसा वर्ज़न नंबर दिखेगा।
1.1.29इसके बाद, OpenCode कॉन्फ़िगरेशन डायरेक्टरी बनाएँ। फिर OpenCode कॉन्फ़िगरेशन फ़ाइल बनाएँ और llama.cpp को प्रोवाइडर के रूप में परिभाषित करें। यह कॉन्फ़िगरेशन OpenCode को बताती है कि सभी रिक्वेस्ट लोकली चल रहे इन्फ़ेरेंस सर्वर को भेजें और GLM 4.7 Flash मॉडल का उपयोग करें।
mkdir -p ~/.config/opencode


cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llamacpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama.cpp (local)",
      "options": {
        "baseURL": "http://127.0.0.1:8080/v1"
      },
      "models": {
        "GLM-4.7-Flash": {
          "name": "GLM-4.7-Flash (UD-Q4_K_XL)"
        }
      }
    }
  },
  "model": "GLM-4.7-Flash"
}
EOF
अंत में, OpenCode को ऑथेंटिकेट करें। यह चरण टूल द्वारा आवश्यक है, पर चूँकि इन्फ़ेरेंस सर्वर लोकल है, API कुंजी कोई भी प्लेसहोल्डर मान हो सकती है।
opencode auth loginप्रॉम्प्ट आने पर, निम्न मानों का उपयोग करें।
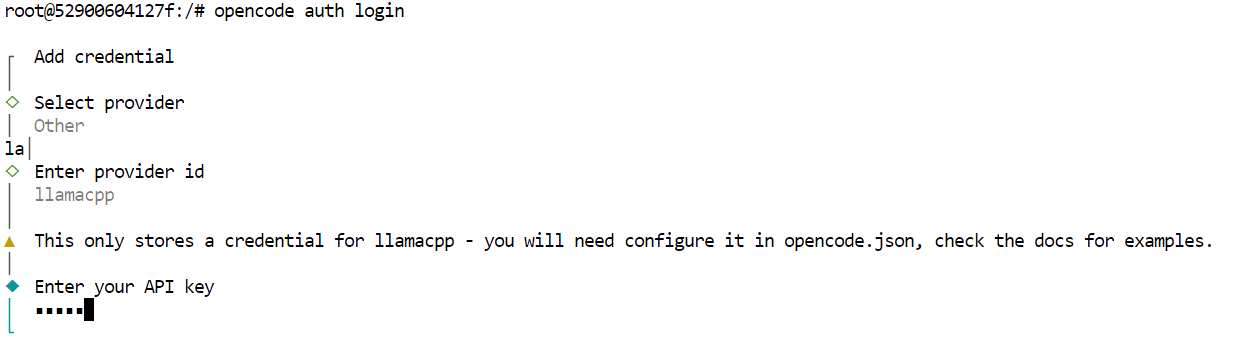
इस बिंदु पर, OpenCode पूरी तरह लोकल llama.cpp सर्वर के माध्यम से GLM 4.7 Flash उपयोग करने के लिए कॉन्फ़िगर हो चुका है।
OpenCode कॉन्फ़िगर और लोकल llama.cpp सर्वर से कनेक्ट होने के बाद, अब आप GLM 4.7 Flash को एक पूरी तरह ऑटोमेटेड AI कोडिंग एजेंट के रूप में उपयोग कर सकते हैं।
एक नया प्रोजेक्ट डायरेक्टरी बनाएँ और उसमें जाएँ।
mkdir -p /workspace/project
cd /workspace/project
इसके बाद, उसी टर्मिनल से OpenCode लॉन्च करें।
opencodeOpenCode शुरू होने पर, Tab कुंजी दबाएँ और Plan मोड पर स्विच करें। इस मोड में, बताइए आप क्या बनवाना चाहते हैं।
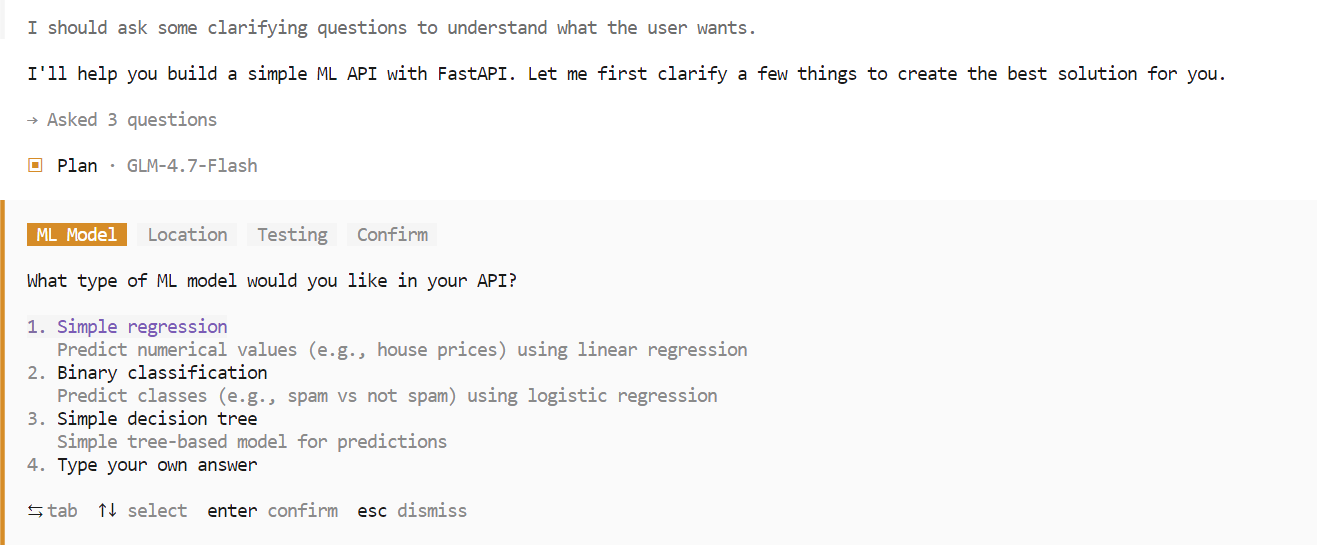
उदाहरण के लिए, OpenCode से कहें कि FastAPI का उपयोग करके एक सरल मशीन लर्निंग-पावर्ड API बनाए। OpenCode स्वचालित रूप से प्रोजेक्ट की योजना बनाएगा, कोड जनरेट करेगा, API सर्वर चलाएगा और इम्प्लीमेंटेशन का परीक्षण करेगा।
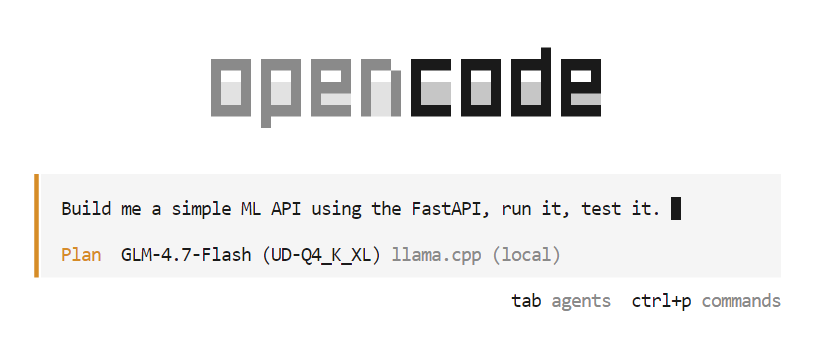
प्लानिंग चरण के दौरान, OpenCode आवश्यकताओं को स्पष्ट करने के लिए फ़ॉलो-अप प्रश्न पूछ सकता है, जैसे फ़्रेमवर्क चुनना, एंडपॉइंट्स, या प्रोजेक्ट स्ट्रक्चर। अपनी पसंद के विकल्प चुनें और आगे बढ़ने की पुष्टि करें।
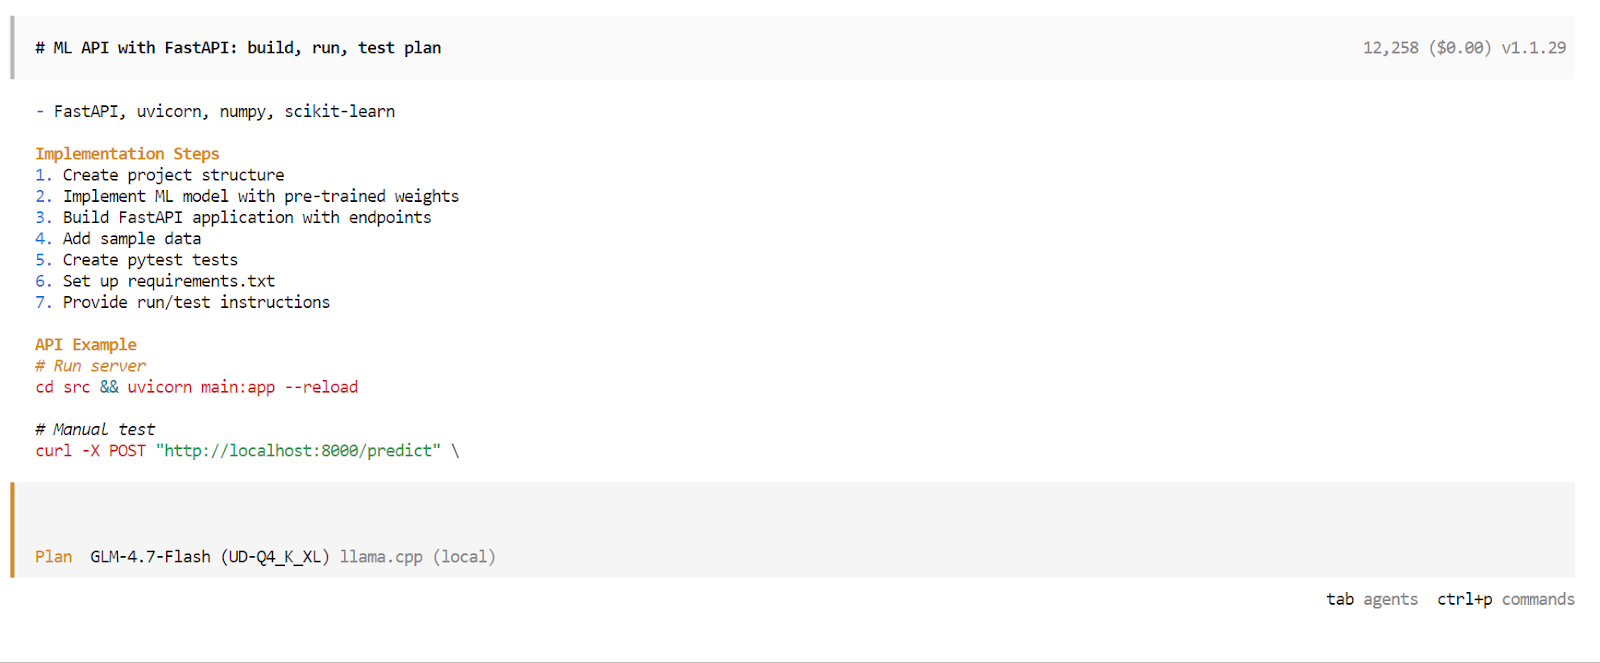
प्लानिंग चरण पूरा होने पर, OpenCode एक विस्तृत एक्ज़ीक्यूशन प्लान प्रस्तुत करेगा। प्लान की समीक्षा करें और यदि यह आपकी अपेक्षाओं से मेल खाता है तो इसे अनुमोदित करें। फिर Tab फिर से दबाएँ और Plan मोड से Build मोड पर स्विच करें।
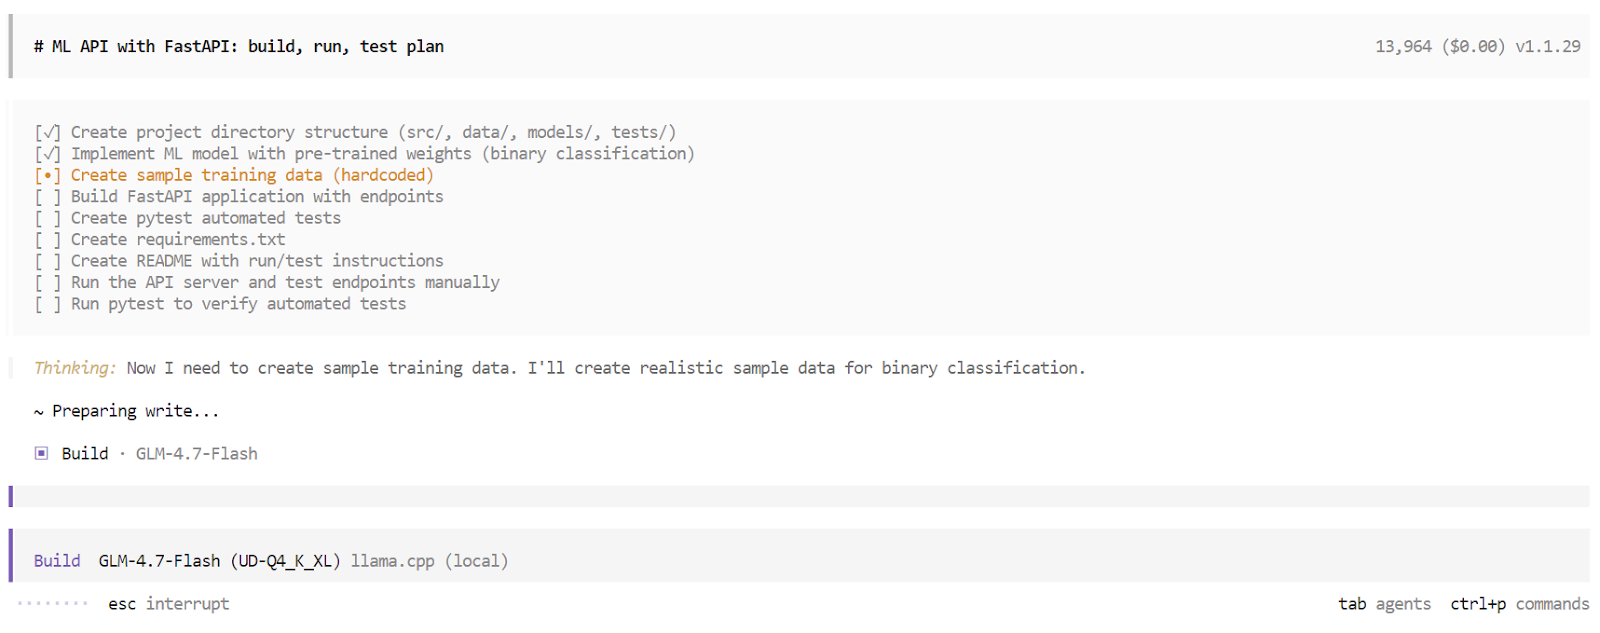
Build मोड में, OpenCode एक स्ट्रक्चर्ड टास्क सूची बनाता है और प्रत्येक चरण को क्रमशः एक्ज़ीक्यूट करता है। इसमें फ़ाइलें जनरेट करना, कोड लिखना, डिपेंडेंसी इंस्टॉल करना, सर्वर चलाना और टेस्ट्स एक्ज़ीक्यूट करना शामिल है। आप रियल टाइम में प्रत्येक टास्क को पूरा होते देख सकते हैं।
बिल्ड प्रक्रिया पूरी होने पर, OpenCode एप्लिकेशन का एक संपूर्ण ओवरव्यू देता है। इसमें उपयोग निर्देश, उदाहरण रिक्वेस्ट, और ऑटोमेटेड टेस्ट्स के परिणाम शामिल होते हैं। इस बिंदु पर, आपके पास एक पूरी तरह काम करने वाला एप्लिकेशन है जिसे एक लोकल AI कोडिंग एजेंट ने आपकी मशीन पर ही बनाकर वैलिडेट किया है।
GLM 4.7 Flash पूरी तरह लोकल AI कोडिंग एजेंट्स की दिशा में एक सशक्त क़दम है। एक तेज़, सक्षम रीज़निंग मॉडल को पूरी तरह लोकल हार्डवेयर पर चलाने और OpenCode जैसे टूल्स के साथ इंटीग्रेट करने की क्षमता, क्लाउड-निर्भर वर्कफ़्लो से अर्थपूर्ण बदलाव का संकेत है।
फिर भी, GLM 4.7 Flash की सीमाएँ हैं। यद्यपि यह छोटे से मध्यम आकार के टास्क के लिए अच्छा प्रदर्शन करता है, यह अधिक जटिल, बहु-चरणीय कोडिंग वर्कफ़्लो में संघर्ष कर सकता है। कॉन्टेक्स्ट जल्दी भर सकता है, टूल एक्ज़ीक्यूशन कभी-कभी असफल हो सकता है, और कुछ मामलों में एजेंट प्रक्रिया के मध्य में रुक सकता है, आगे बढ़ने के लिए नए सेशन की आवश्यकता होती है।
ये मुद्दे एक हल्के, स्पीड के लिए ऑप्टिमाइज़्ड MoE मॉडल से अपेक्षित हैं, जो अधिकतम रीज़निंग गहराई के बजाय गति पर केंद्रित है।
कच्ची क्षमता की दृष्टि से, GLM 4.7 Flash पूर्ण GLM 4.7 मॉडल के स्तर पर नहीं है, जो Claude 4.5 Sonnet जैसे मॉडलों के प्रदर्शन के क़रीब है। ट्रेड-ऑफ स्पष्ट है: GLM 4.7 Flash पीक रीज़निंग स्ट्रेंथ की तुलना में स्पीड, एफिशिएंसी और लोकल उपयोगिता को प्राथमिकता देता है।
इस ट्यूटोरियल पर कार्य करना और इन्फ़ेरेंस सर्वर को ट्यून करना एक मूल्यवान अनुभव रहा। उच्च प्रिसिजन वैरिएंट्स चलाना और कॉन्टेक्स्ट विंडो बढ़ाना कोडिंग विश्वसनीयता में सुधार कर सकता है, पर सर्वोत्तम परिणाम पाने के लिए तापमान, टॉप p, बैच साइज़ और कॉन्टेक्स्ट लंबाई जैसे पैरामीटर्स के साथ सावधानीपूर्वक प्रयोग आवश्यक है। एक इष्टतम सेटअप तक पहुँचना एक इटरेटिव प्रक्रिया है।
कुल मिलाकर, GLM 4.7 Flash उन डेवलपर्स के लिए व्यावहारिक और उत्साहजनक विकल्प है जो आज तेज़, लोकल और मुफ़्त AI कोडिंग एजेंट चाहते हैं, और जैसे-जैसे टूलिंग और मॉडल विकसित होंगे, सुधार की स्पष्ट गुंजाइश बनी हुई है।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स