
Khóa học
Xây dựng Hệ thống Agentic có thể mở rộng
1 giờ 30 phút
21.7K
GLM 4.7 Flash là một mô hình ngôn ngữ lớn mở trọng số vừa ra mắt và thu hút nhiều chú ý vì có thể chạy cục bộ nhưng vẫn cho hiệu năng mạnh ở các tác vụ viết mã, suy luận và quy trình dạng agent.
Khác với nhiều mô hình hiện đại phụ thuộc vào API trả phí hoặc hạ tầng đám mây, GLM 4.7 Flash có thể chạy hoàn toàn trên phần cứng cục bộ với các khung suy luận gọn nhẹ. Điều này khiến nó trở thành lựa chọn hấp dẫn cho nhà phát triển muốn toàn quyền kiểm soát mô hình, dùng offline, chi phí dự đoán được và vòng lặp phát triển nhanh.
Với thiết lập và lượng tử hóa phù hợp, mô hình có thể đạt tốc độ sinh token cao trên GPU phổ thông mà vẫn giữ chất lượng suy luận hữu ích.
Trong hướng dẫn này, tôi sẽ dẫn bạn thiết lập môi trường hệ thống cần thiết để chạy GLM 4.7 Flash cục bộ bằng llama.cpp. Trọng tâm là giữ cho việc thiết lập đơn giản, sạch và có thể tái tạo. Chúng ta sẽ tải mô hình, build và cấu hình llama.cpp, rồi kiểm thử mô hình qua cả ứng dụng web và máy chủ suy luận dựa trên API.
Ở phần sau, chúng ta sẽ tích hợp máy chủ llama.cpp cục bộ với một tác nhân AI viết mã, kích hoạt quy trình tự động tạo mã, thực thi và kiểm thử. Bạn cũng có thể xem hướng dẫn cách chạy GLM-4.7 cục bộ.
Trước khi chạy GLM 4.7 Flash cục bộ, hãy đảm bảo hệ thống của bạn đáp ứng các yêu cầu sau.
Đối với độ chính xác đầy đủ hoặc lượng tử hóa bit cao hơn:
Đối với mô hình lượng tử hóa 4-bit
Lượng tử hóa Q4_K_XL giúp giảm đáng kể bộ nhớ sử dụng trong khi vẫn giữ hiệu năng suy luận và viết mã mạnh, phù hợp với các GPU như RTX 3090, RTX 4080 và RTX 4090. Biến thể này lý tưởng nếu bạn muốn tốc độ sinh token cao mà không cần chạy trọng số độ chính xác đầy đủ.
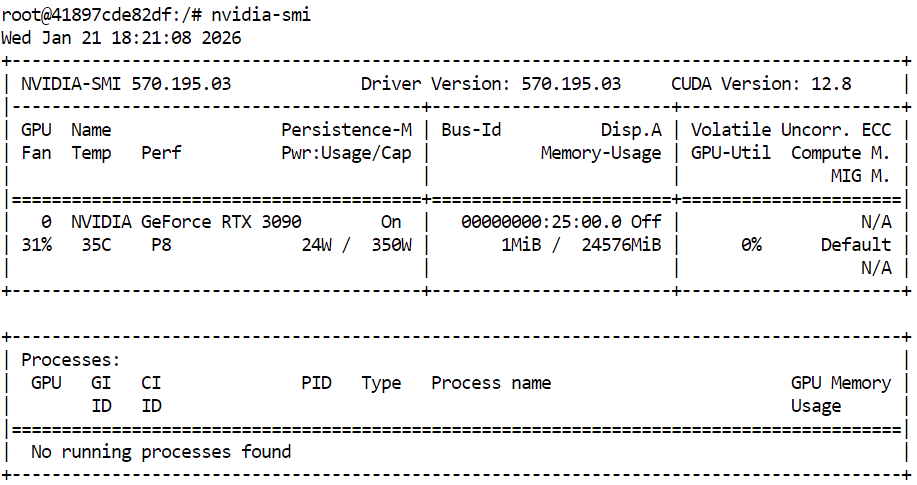
Trước khi build llama.cpp và chạy GLM 4.7 Flash, hãy xác nhận GPU NVIDIA và driver đã được cài đặt đúng. Điều này đảm bảo CUDA sẵn sàng và hệ thống có thể chạy suy luận tăng tốc GPU.
nvidia-smiKết quả hiển thị RTX 3090 với CUDA phiên bản 12.8 và 24GB bộ nhớ GPU khả dụng, đủ để chạy GLM 4.7 Flash và các biến thể lượng tử hóa của nó.
Tiếp theo, mở terminal và xác định một workspace sạch cùng cấu trúc thư mục. Việc này giúp tổ chức mã nguồn, tệp mô hình và dữ liệu cache, tránh lỗi quyền truy cập và dễ tái tạo thiết lập.
export WORKDIR="/workspace"
export LLAMA_DIR="$WORKDIR/llama.cpp"
export MODEL_DIR="$WORKDIR/models/unsloth/GLM-4.7-Flash-GGUF"
Tạo thư mục lưu tệp mô hình và cấu hình vị trí cache của Hugging Face bên trong workspace thay vì thư mục home. Điều này cải thiện tốc độ tải và tránh cảnh báo không cần thiết.
mkdir -p "$MODEL_DIR"
export HF_HOME="$WORKDIR/.cache/huggingface"
export HUGGINGFACE_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
export HF_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
Đặt thêm biến môi trường để tắt cảnh báo symlink và bật tải xuống hiệu năng cao.
export HF_HUB_DISABLE_SYMLINKS_WARNING=1
export HF_XET_HIGH_PERFORMANCE=1
Cuối cùng, cài các phụ thuộc hệ thống cần thiết để build llama.cpp và quản lý tải xuống.
sudo apt-get update
sudo apt-get install -y \
  build-essential cmake git curl libcurl4-openssl-dev
Đến đây, môi trường hệ thống đã sẵn sàng. Phần tiếp theo sẽ tập trung vào việc clone và build llama.cpp với hỗ trợ CUDA.
Khi môi trường đã được chuẩn bị, bước tiếp theo là cài đặt llama.cpp và build với hỗ trợ CUDA. Điều này cho phép GLM 4.7 Flash chạy hiệu quả trên GPU.
Trong terminal, điều hướng đến workspace của bạn. Sau đó chạy lệnh sau để clone repository chính thức của llama.cpp.
git clone https://github.com/ggml-org/llama.cpp "$LLAMA_DIR"Sau khi clone, các tệp nguồn sẽ được tải về thư mục workspace.
Cloning into '/workspace/llama.cpp'...
remote: Enumerating objects: 76714, done.
remote: Counting objects: 100% (238/238), done.
remote: Compressing objects: 100% (157/157), done.
remote: Total 76714 (delta 172), reused 81 (delta 81), pack-reused 76476 (from 3)
Receiving objects: 100% (76714/76714), 282.23 MiB | 13.11 MiB/s, done.
Resolving deltas: 100% (55422/55422), done.
Updating files: 100% (2145/2145), done.
Tiếp theo, cấu hình build bằng CMake và bật hỗ trợ CUDA một cách tường minh. Bước này chuẩn bị hệ thống build để biên dịch các binary tăng tốc GPU.
cmake "$LLAMA_DIR" -B "$LLAMA_DIR/build" \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON
Khi cấu hình hoàn tất, hãy build các binary cần thiết của llama.cpp. Lệnh này biên dịch các công cụ suy luận lõi, gồm giao diện dòng lệnh và máy chủ suy luận.
cmake --build "$LLAMA_DIR/build" --config Release -j --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
Sau khi build xong, sao chép các binary đã biên dịch vào thư mục chính của llama.cpp để tiện truy cập.
cp "$LLAMA_DIR/build/bin/llama-"* "$LLAMA_DIR/"Cuối cùng, xác minh llama.cpp đã được build đúng và CUDA được nhận diện bằng cách chạy lệnh trợ giúp của máy chủ suy luận.
"$LLAMA_DIR/llama-server" --help >/dev/null && echo "✔ llama.cpp built"Nếu hỗ trợ CUDA được bật đúng, đầu ra sẽ xác nhận đã phát hiện thiết bị CUDA, bao gồm model GPU và compute capability.
ggml_cuda_init: found 1 CUDA devices:
  Device 0: NVIDIA GeForce RTX 3090, compute capability 8.6, VMM: yes
✔ llama.cpp builtSau khi build llama.cpp và xác minh hỗ trợ CUDA, bước tiếp theo là tải mô hình GLM 4.7 Flash. Trong hướng dẫn này, chúng ta dùng Hugging Face Hub với hỗ trợ Xet để tải nhanh và ổn định các tệp mô hình lớn.
Trong cùng cửa sổ terminal, gõ các lệnh sau để cài đặt các gói Python cần thiết cho việc tải mô hình hiệu năng cao.
pip -q install -U "huggingface_hub[hf_xet]" hf-xet
pip -q install -U hf_transfer
Tiếp theo, chạy đoạn script Python sau trong terminal để tải biến thể mô hình lượng tử hóa 4-bit. Script này dùng các đường dẫn workspace đã định nghĩa và chỉ tải tệp GGUF cần thiết.
python - <<'PY'
import os
from huggingface_hub import snapshot_download

model_dir = os.environ["MODEL_DIR"]

snapshot_download(
    repo_id="unsloth/GLM-4.7-Flash-GGUF",
    local_dir=model_dir,
    allow_patterns=["*UD-Q4_K_XL*"],
)

print("✔ Download complete:", model_dir)
PY
Khi tải xong, bạn sẽ thấy đầu ra xác nhận tệp mô hình đã được lấy thành công, với tổng dung lượng khoảng 17,5 GB.
Fetching 1 files: 100%|███████████████████████████████████████████████████████████████████████████████████| 1/1 [00:52<00:00, 52.80s/it]
Download complete: 100%|████████████████████████████████████████████████████████████████████████████| 17.5G/17.5G [00:52<00:00, 480MB/s]✔ Download complete: /workspace/models/unsloth/GLM-4.7-Flash-GGUF
Cuối cùng, xác minh tệp mô hình có mặt trong thư mục đích.
ls -lh "$MODEL_DIR"Bạn sẽ thấy tệp GLM-4.7-Flash-UD-Q4_K_XL.gguf được liệt kê, xác nhận mô hình sẵn sàng để suy luận.
total 17G
-rw-rw-rw- 1 root root 17G Jan 21 18:46 GLM-4.7-Flash-UD-Q4_K_XL.ggufKhi đã tải mô hình và build llama.cpp với hỗ trợ CUDA, bước tiếp theo là khởi chạy máy chủ suy luận. Máy chủ này sẽ công bố GLM 4.7 Flash dưới dạng API cục bộ có thể được dùng bởi giao diện người dùng, script và tác nhân AI viết mã.
Hãy dùng cùng một phiên terminal và workspace bạn đã cấu hình ở các phần trước.
Đầu tiên, xác định tệp mô hình GGUF đã tải và lưu đường dẫn vào biến môi trường.
export MODEL_FILE="$(ls "$MODEL_DIR"/*.gguf | grep -i UD-Q4_K_XL | head -n 1)"Tiếp theo, khởi động máy chủ suy luận llama.cpp bằng lệnh sau. Cấu hình này được tối ưu cho RTX 3090, cân bằng thông lượng, độ trễ và độ dài ngữ cảnh.
$LLAMA_DIR/llama-server \
  --model "$MODEL_FILE" \
  --alias "GLM-4.7-Flash" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 16384 \
  --temp 0.7 \
  --top-p 1 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
--ubatch-size 256--model nạp tệp mô hình GGUF GLM 4.7 Flash đã chọn để suy luận.--alias gán tên mô hình dễ đọc hiển thị trong phản hồi API và log.--threads dùng 32 luồng CPU để hỗ trợ tokenization, lập lịch và xử lý yêu cầu trên hệ thống nhiều nhân.--host bind máy chủ vào mọi giao diện mạng để có thể truy cập cục bộ hoặc từ máy khác trong mạng.--ctx-size đặt cửa sổ ngữ cảnh lớn, cân bằng giữa hỗ trợ prompt dài và sử dụng bộ nhớ GPU.--temp áp dụng độ ngẫu nhiên vừa phải để cải thiện chất lượng phản hồi mà không làm giảm ổn định suy luận.--top-p tắt lọc nucleus để cho phép toàn bộ phân phối token trong quá trình sinh.--port 8080 công bố máy chủ suy luận trên cổng phát triển cục bộ tiêu chuẩn.--fit bật tự động khớp bộ nhớ để tối đa hóa sử dụng GPU mà không vượt giới hạn VRAM.--prio đặt mức ưu tiên cân bằng cho tải suy luận khi có yêu cầu đồng thời.--jinja bật hỗ trợ Jinja cho prompt có cấu trúc và quy trình dạng agent.--flash-attn tự động bật Flash Attention khi GPU hỗ trợ để tăng thông lượng.--batch-size cho phép xử lý batch lớn để cải thiện thông lượng token trên RTX 3090.--ubatch-size chia batch lớn thành micro-batch nhỏ để kiểm soát áp lực bộ nhớ và độ trễ.Khi máy chủ khởi động, nó sẽ nạp mô hình vào bộ nhớ GPU và bắt đầu lắng nghe yêu cầu trên cổng 8080. Lúc này, GLM 4.7 Flash đang chạy cục bộ và có thể truy cập qua các endpoint HTTP cho chat, completion và quy trình dựa trên agent.
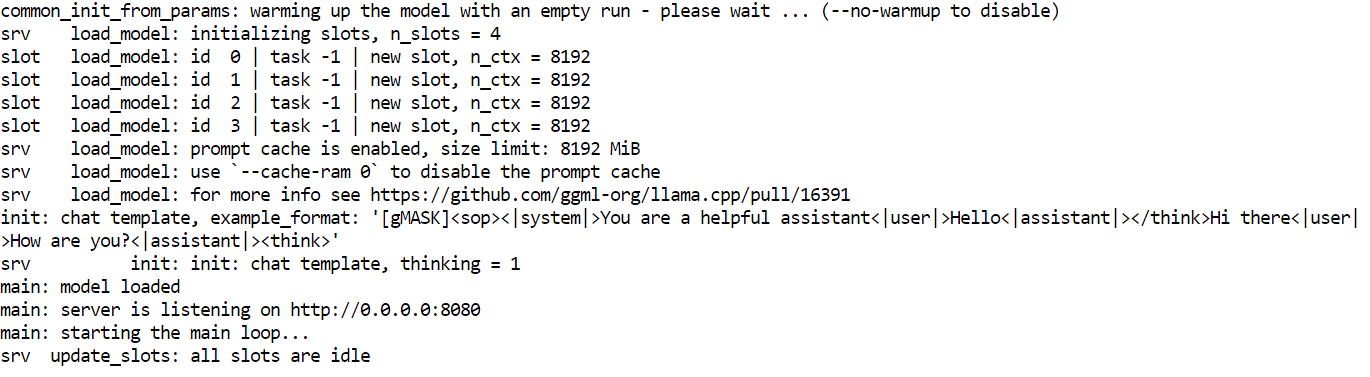
Khi máy chủ suy luận đang chạy, bạn có thể kiểm thử GLM 4.7 Flash bằng nhiều giao diện, gồm web UI tích hợp, yêu cầu HTTP trực tiếp và SDK Python tương thích OpenAI.
Giao diện web của llama.cpp có tại: http://0.0.0.0:8080
Sao chép URL này và mở trong trình duyệt để truy cập giao diện chat đơn giản tương tự ChatGPT.
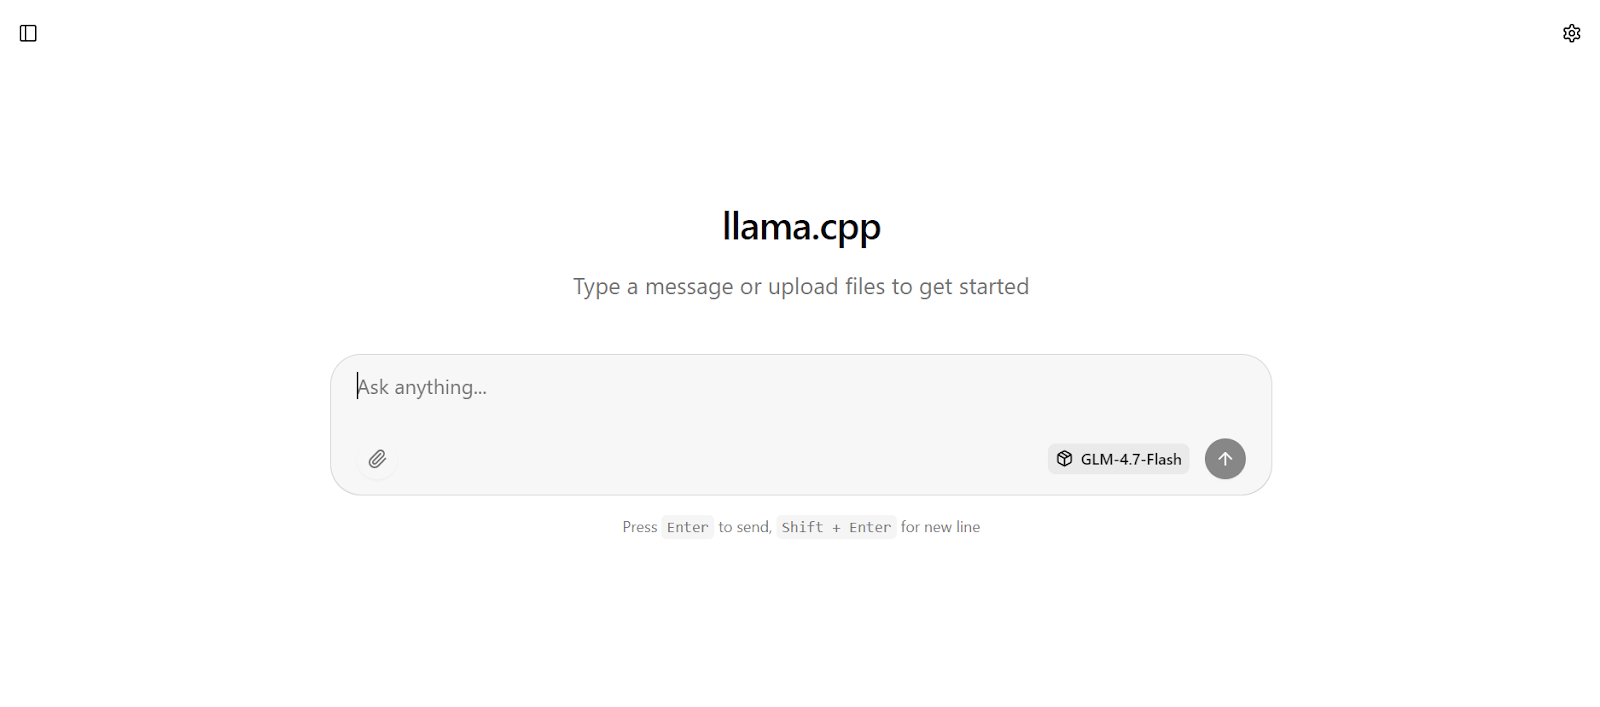
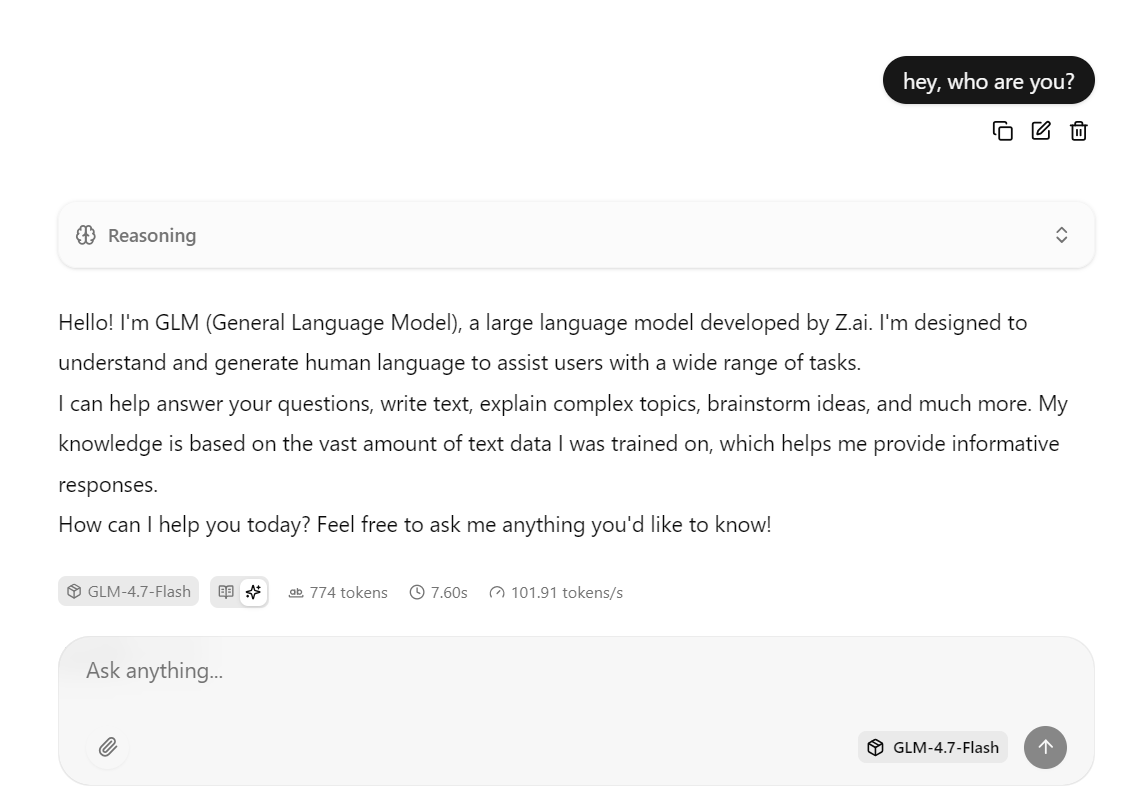
Nhập một prompt, mô hình sẽ bắt đầu tạo phản hồi ngay lập tức.
Thiết lập này được tối ưu cho tốc độ bằng cách chạy mô hình trên RTX 3090 với CUDA bật, dùng Flash Attention khi có và cấu hình batching để đạt thông lượng cao.
Trong thực tế, cấu hình này có thể đạt khoảng 100 token/giây cho các phản hồi ngắn đến trung bình.
Bạn cũng có thể tương tác với cùng máy chủ bằng lệnh curl. Mở một cửa sổ terminal mới và chạy yêu cầu sau để gửi prompt chat completion.
curl -N http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer local" \
  -d '{
    "model": "GLM-4.7-Flash",
    "messages": [
      { "role": "user", "content": "Write a short bash script that prints numbers 1 to 5." }
    ]
  }'
Bạn cũng có thể kiểm thử mô hình bằng Python bằng cách cài đặt OpenAI Python SDK.
pip -q install openaiTrong ví dụ Python này, client OpenAI được cấu hình để gửi yêu cầu tới máy chủ suy luận llama.cpp đang chạy cục bộ.
Trường base_url trỏ tới endpoint API cục bộ, và trường API key là bắt buộc với SDK nhưng có thể đặt giá trị bất kỳ vì xác thực được xử lý cục bộ.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local"
)
Client sau đó gửi một yêu cầu chat completion tới GLM 4.7 Flash dùng alias mô hình đã định khi khởi chạy máy chủ suy luận. Prompt được cung cấp theo định dạng chat chuẩn, và phản hồi trả về dưới dạng đối tượng có cấu trúc.
r = client.chat.completions.create(
    model="GLM-4.7-Flash",
    messages=[{"role": "user", "content": "Build me a Simple API server using FastAPI"}]
)

print(r.choices[0].message.content)
Chỉ sau vài giây, mô hình sẽ trả về phản hồi hoàn chỉnh, bao gồm mã ví dụ và giải thích.
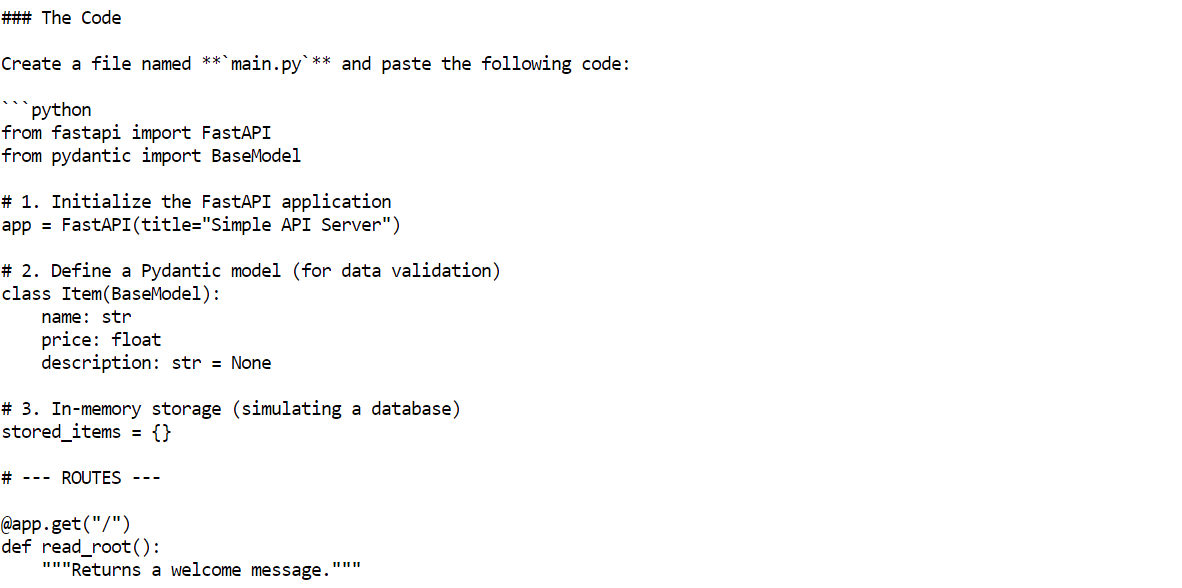
OpenCode là một tác nhân AI viết mã nguồn mở được thiết kế để chạy cục bộ, hỗ trợ các quy trình dạng agent như tạo mã, chỉnh sửa tệp, thực thi lệnh và giải quyết vấn đề lặp.
Khác với trợ lý viết mã trên đám mây, OpenCode có thể kết nối với máy chủ suy luận tự lưu trữ, cho phép bạn xây dựng một thiết lập tác nhân AI viết mã hoàn toàn cục bộ và miễn phí.
Trong hướng dẫn này, OpenCode được cấu hình để dùng máy chủ llama.cpp cục bộ chạy GLM 4.7 Flash thông qua API tương thích OpenAI.
Để bắt đầu, dùng cùng phiên terminal và cài đặt OpenCode bằng script cài đặt chính thức.
curl -fsSL https://opencode.ai/install | bash Sau khi cài đặt, cập nhật PATH để lệnh opencode khả dụng trong terminal.
export PATH="$HOME/.local/bin:$PATH"Mở cửa sổ terminal mới và xác minh OpenCode đã được cài đặt đúng.
opencode --versionBạn sẽ thấy số phiên bản tương tự như sau.
1.1.29Tiếp theo, tạo thư mục cấu hình OpenCode. Sau đó, tạo tệp cấu hình OpenCode và định nghĩa llama.cpp là nhà cung cấp. Cấu hình này chỉ định OpenCode gửi mọi yêu cầu tới máy chủ suy luận cục bộ và dùng mô hình GLM 4.7 Flash.
mkdir -p ~/.config/opencode


cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llamacpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama.cpp (local)",
      "options": {
        "baseURL": "http://127.0.0.1:8080/v1"
      },
      "models": {
        "GLM-4.7-Flash": {
          "name": "GLM-4.7-Flash (UD-Q4_K_XL)"
        }
      }
    }
  },
  "model": "GLM-4.7-Flash"
}
EOF
Cuối cùng, xác thực OpenCode. Bước này là bắt buộc với công cụ, nhưng vì máy chủ suy luận là cục bộ, API key có thể là giá trị bất kỳ.
opencode auth loginKhi được hỏi, hãy dùng các giá trị sau.
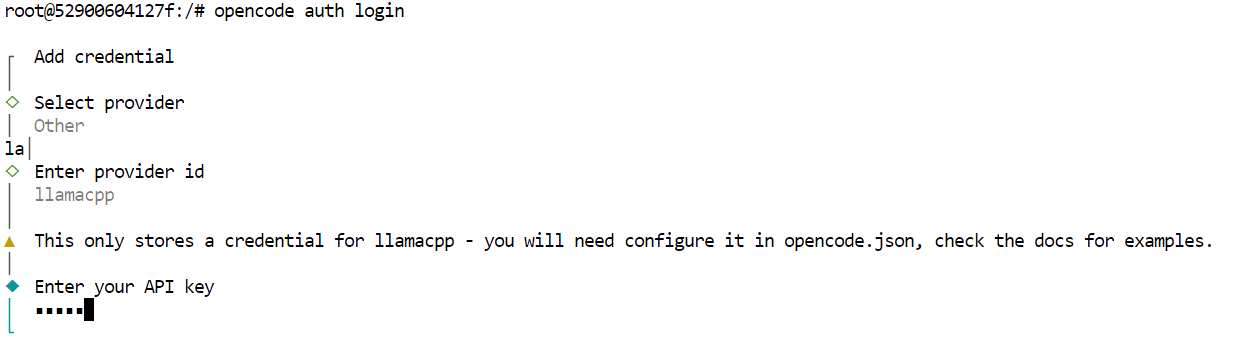
Tại thời điểm này, OpenCode đã được cấu hình đầy đủ để dùng GLM 4.7 Flash thông qua máy chủ llama.cpp cục bộ.
Khi OpenCode đã được cấu hình và kết nối với máy chủ llama.cpp cục bộ, bạn có thể dùng GLM 4.7 Flash như một tác nhân AI viết mã tự động hoàn chỉnh.
Bắt đầu bằng cách tạo thư mục dự án mới và đi vào đó.
mkdir -p /workspace/project
cd /workspace/project
Tiếp theo, khởi chạy OpenCode từ cùng terminal.
opencodeKhi OpenCode khởi động, nhấn phím Tab để chuyển sang Chế độ lập kế hoạch (Plan). Ở chế độ này, mô tả những gì bạn muốn xây dựng.
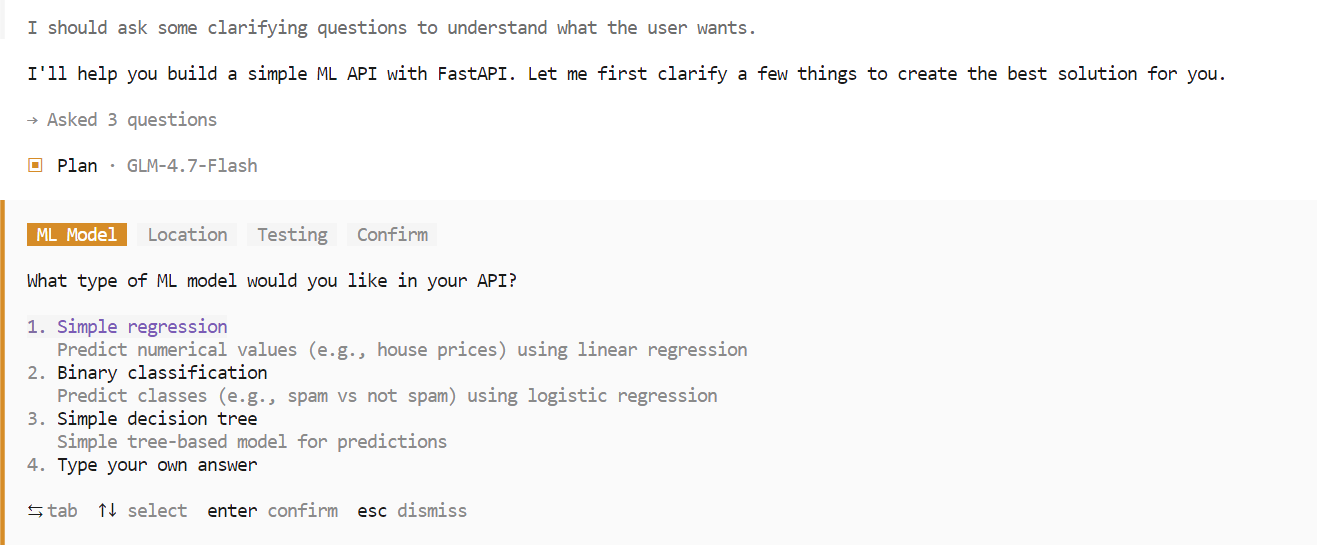
Ví dụ, nhập prompt yêu cầu OpenCode tạo một API đơn giản dùng FastAPI có tích hợp machine learning. OpenCode sẽ tự động lập kế hoạch dự án, tạo mã, chạy máy chủ API và kiểm thử triển khai.
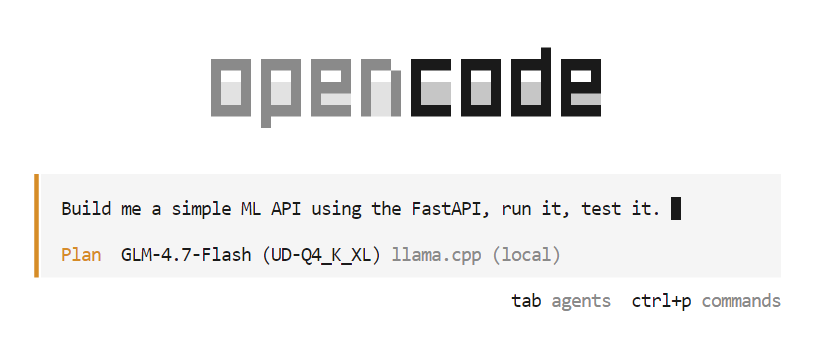
Trong giai đoạn lập kế hoạch, OpenCode có thể hỏi thêm để làm rõ yêu cầu như lựa chọn framework, endpoint hoặc cấu trúc dự án. Hãy chọn các tùy chọn bạn muốn và xác nhận để tiếp tục.
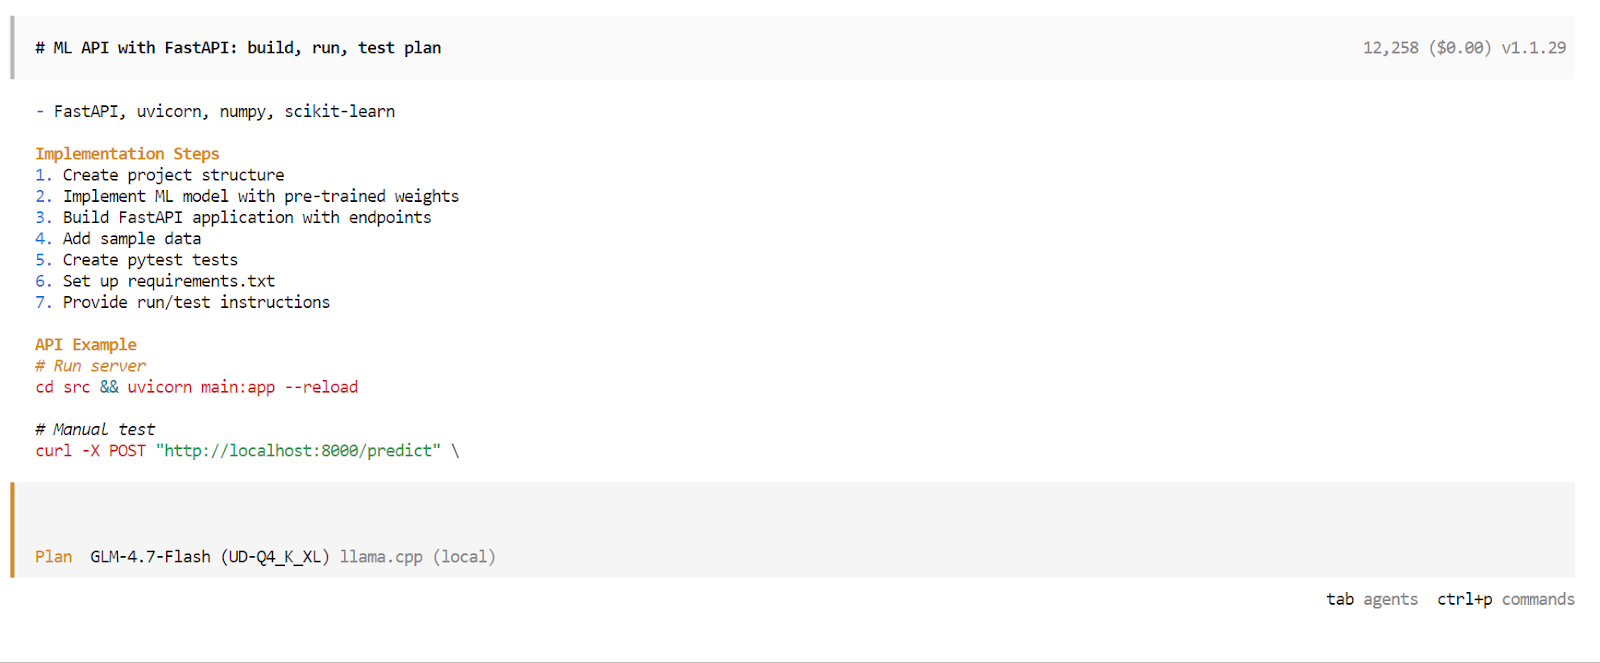
Sau khi xong giai đoạn lập kế hoạch, OpenCode sẽ đưa ra kế hoạch thực thi chi tiết. Xem lại và phê duyệt nếu phù hợp với kỳ vọng của bạn. Sau đó nhấn Tab lần nữa để chuyển từ Chế độ lập kế hoạch sang Chế độ xây dựng (Build).
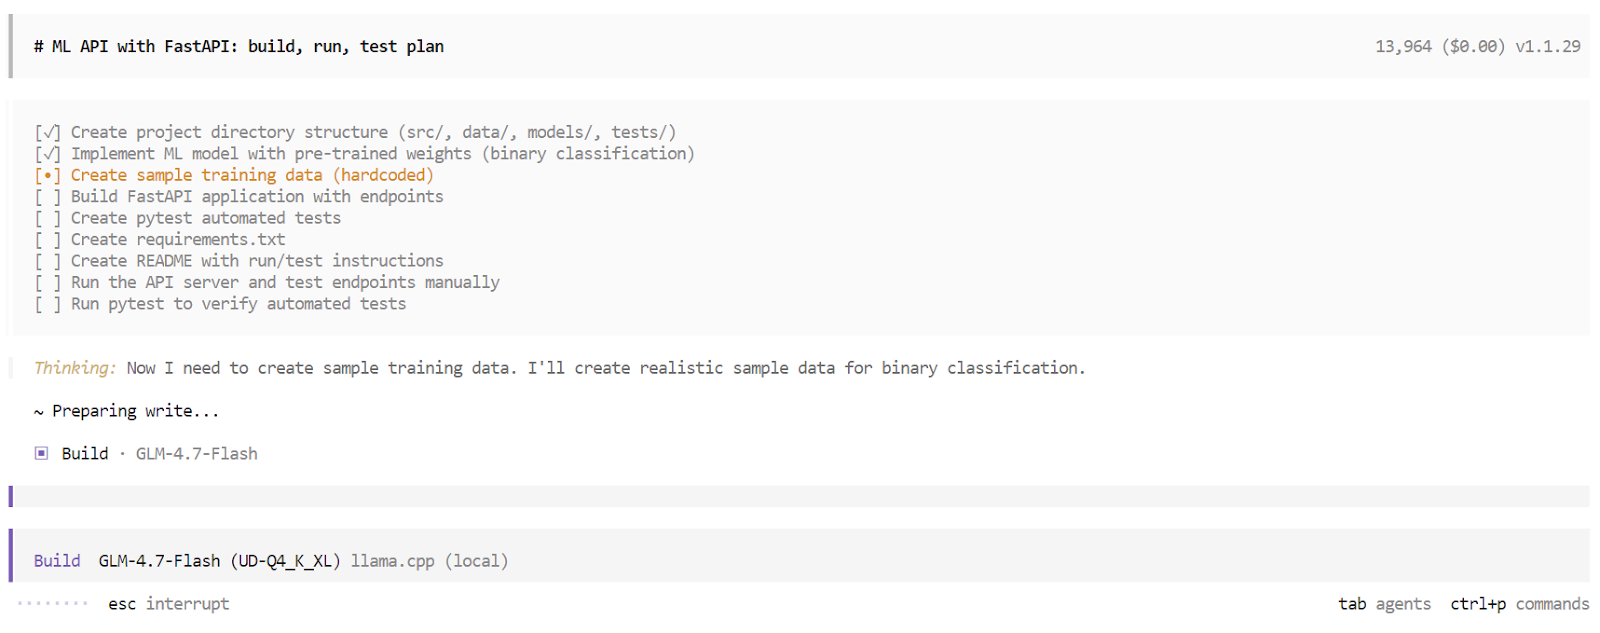
Ở Chế độ xây dựng, OpenCode tạo danh sách tác vụ có cấu trúc và thực thi từng bước tuần tự. Bao gồm tạo tệp, viết mã, cài phụ thuộc, chạy máy chủ và thực thi kiểm thử. Bạn có thể quan sát từng tác vụ được hoàn tất theo thời gian thực.
Khi quá trình build hoàn tất, OpenCode cung cấp tổng quan đầy đủ về ứng dụng, gồm hướng dẫn sử dụng, yêu cầu mẫu và kết quả kiểm thử tự động. Lúc này, bạn đã có một ứng dụng hoạt động hoàn chỉnh được xây và xác thực bởi tác nhân AI viết mã cục bộ chạy hoàn toàn trên máy của bạn.
GLM 4.7 Flash là một bước tiến mạnh mẽ hướng tới các tác nhân AI viết mã hoàn toàn cục bộ. Khả năng chạy một mô hình suy luận nhanh, đủ năng lực hoàn toàn trên phần cứng cục bộ và tích hợp với các công cụ như OpenCode là một sự chuyển dịch ý nghĩa khỏi các quy trình phụ thuộc đám mây.
Tuy vậy, GLM 4.7 Flash vẫn có hạn chế. Dù hoạt động tốt cho các tác vụ nhỏ đến trung bình, nó có thể gặp khó với quy trình viết mã phức tạp, nhiều bước. Ngữ cảnh có thể đầy nhanh, thi thoảng việc thực thi công cụ thất bại, và đôi lúc tác nhân có thể dừng giữa chừng, cần phiên mới để tiếp tục.
Những vấn đề này là điều dễ hiểu với một mô hình MoE gọn nhẹ tối ưu cho tốc độ hơn là độ sâu suy luận tối đa.
Xét về năng lực thô, GLM 4.7 Flash không cùng đẳng cấp với bản GLM 4.7 đầy đủ, vốn tiệm cận hiệu năng các mô hình như Claude 4.5 Sonnet. Sự đánh đổi khá rõ: GLM 4.7 Flash ưu tiên tốc độ, hiệu quả và khả năng dùng cục bộ hơn là sức mạnh suy luận đỉnh cao.
Làm theo hướng dẫn này và tinh chỉnh máy chủ suy luận là một trải nghiệm giá trị. Chạy các biến thể độ chính xác cao hơn và tăng cửa sổ ngữ cảnh có thể cải thiện độ tin cậy khi viết mã, nhưng để đạt kết quả tốt nhất cần thử nghiệm cẩn thận với các tham số như nhiệt độ, top p, kích thước batch và độ dài ngữ cảnh. Tối ưu hóa là một quá trình lặp.
Nhìn chung, GLM 4.7 Flash là lựa chọn thực tế và thú vị cho nhà phát triển muốn có tác nhân AI viết mã nhanh, cục bộ và miễn phí ngay hôm nay, với dư địa cải thiện rõ ràng khi công cụ và mô hình tiếp tục phát triển.
Khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học