
Last chance! 50% off DataCamp Premium
Sale ends in
GLM 4.7 Flash è un modello open-weight di grandi dimensioni appena rilasciato che ha attirato molta attenzione perché può essere eseguito in locale offrendo comunque ottime prestazioni per coding, reasoning e flussi di lavoro in stile agente.
A differenza di molti modelli moderni che dipendono da API a pagamento o da infrastrutture in cloud, GLM 4.7 Flash può essere eseguito interamente su hardware locale usando framework di inferenza leggeri. È quindi un'opzione interessante per gli sviluppatori che vogliono il pieno controllo sui propri modelli, uso offline, costi prevedibili e iterazioni rapide durante lo sviluppo.
Con la giusta configurazione e quantizzazione, il modello può raggiungere alte velocità di generazione token su GPU consumer mantenendo una qualità di ragionamento utile.
In questo tutorial ti guiderò nella configurazione dell'ambiente di sistema necessario per eseguire GLM 4.7 Flash in locale usando llama.cpp. L'obiettivo è mantenere l'installazione semplice, pulita e riproducibile. Scaricheremo il modello, compileremo e configureremo llama.cpp, quindi testeremo il modello sia con un'applicazione web sia con un server di inferenza basato su API.
Più avanti nel tutorial, integreremo il server locale di llama.cpp con un agente di coding AI, abilitando flussi di lavoro di generazione, esecuzione e test del codice automatizzati. Puoi anche consultare la nostra guida su come eseguire GLM-4.7 in locale.
Prima di eseguire GLM 4.7 Flash in locale, assicurati che il tuo sistema soddisfi i seguenti requisiti.
Per la piena precisione o quantizzazione a bit più alti:
Per il modello quantizzato a 4 bit
La quantizzazione Q4_K_XL riduce in modo significativo l'uso di memoria preservando solide prestazioni di ragionamento e coding, rendendola adatta a GPU come RTX 3090, RTX 4080 e RTX 4090. Questa variante è ideale per chi vuole un alto throughput di token senza eseguire pesi a piena precisione.
Prima di compilare llama.cpp ed eseguire GLM 4.7 Flash, verifica che la tua GPU NVIDIA e i driver siano installati correttamente. Questo assicura che CUDA sia disponibile e che il sistema possa eseguire l'inferenza accelerata da GPU.
nvidia-smiL'output mostra una RTX 3090 con versione CUDA 12.8 e 24GB di memoria GPU disponibili, sufficiente per eseguire GLM 4.7 Flash e le sue varianti quantizzate.
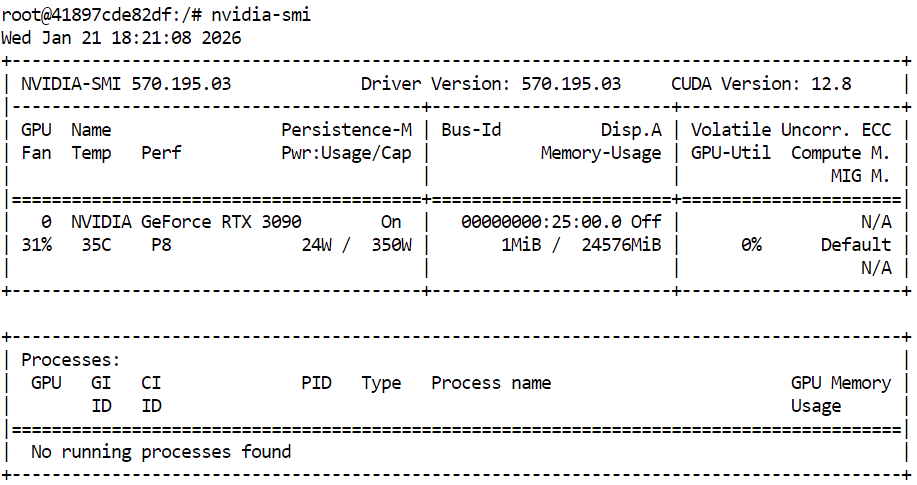
Poi apri un terminale e definisci uno spazio di lavoro pulito e una struttura di directory. Questo mantiene ordinati codice sorgente, file del modello e dati di cache, aiuta a evitare problemi di permessi e rende l'installazione facile da riprodurre.
export WORKDIR="/workspace"
export LLAMA_DIR="$WORKDIR/llama.cpp"
export MODEL_DIR="$WORKDIR/models/unsloth/GLM-4.7-Flash-GGUF"
Crea la directory in cui verranno archiviati i file del modello e configura le posizioni della cache di Hugging Face all'interno dello spazio di lavoro invece che nella home. Questo migliora le prestazioni di download ed evita avvisi non necessari.
mkdir -p "$MODEL_DIR"
export HF_HOME="$WORKDIR/.cache/huggingface"
export HUGGINGFACE_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
export HF_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
Imposta variabili d'ambiente aggiuntive per sopprimere gli avvisi sui symlink e abilitare download ad alte prestazioni.
export HF_HUB_DISABLE_SYMLINKS_WARNING=1
export HF_XET_HIGH_PERFORMANCE=1
Infine, installa le dipendenze di sistema richieste per compilare llama.cpp e gestire i download.
sudo apt-get update
sudo apt-get install -y \
  build-essential cmake git curl libcurl4-openssl-dev
A questo punto, l'ambiente di sistema è pronto. La prossima sezione si concentrerà sul clonare e compilare llama.cpp con il supporto CUDA abilitato.
Con l'ambiente pronto, il passo successivo è installare llama.cpp e compilarlo con il supporto CUDA abilitato. Questo permette a GLM 4.7 Flash di girare in modo efficiente sulla GPU.
Nel terminale, vai al tuo workspace. Poi esegui il seguente comando per clonare il repository ufficiale di llama.cpp.
git clone https://github.com/ggml-org/llama.cpp "$LLAMA_DIR"Dopo il clone, i file sorgente verranno scaricati nella directory dello workspace.
Cloning into '/workspace/llama.cpp'...
remote: Enumerating objects: 76714, done.
remote: Counting objects: 100% (238/238), done.
remote: Compressing objects: 100% (157/157), done.
remote: Total 76714 (delta 172), reused 81 (delta 81), pack-reused 76476 (from 3)
Receiving objects: 100% (76714/76714), 282.23 MiB | 13.11 MiB/s, done.
Resolving deltas: 100% (55422/55422), done.
Updating files: 100% (2145/2145), done.
Quindi configura la build con CMake e abilita esplicitamente il supporto CUDA. Questo passaggio prepara il sistema di build a compilare i binari accelerati su GPU.
cmake "$LLAMA_DIR" -B "$LLAMA_DIR/build" \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON
Una volta terminata la configurazione, compila i binari necessari di llama.cpp. Questo comando compila gli strumenti di inferenza principali, tra cui l'interfaccia a riga di comando e il server di inferenza.
cmake --build "$LLAMA_DIR/build" --config Release -j --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
Dopo la compilazione, copia i binari generati nella directory principale di llama.cpp per un accesso più semplice.
cp "$LLAMA_DIR/build/bin/llama-"* "$LLAMA_DIR/"Infine, verifica che llama.cpp sia stato compilato correttamente e che CUDA venga rilevata eseguendo il comando di help del server di inferenza.
"$LLAMA_DIR/llama-server" --help >/dev/null && echo "✔ llama.cpp built"Se il supporto CUDA è abilitato correttamente, l'output confermerà che è stato rilevato un dispositivo CUDA, includendo il modello della GPU e la compute capability.
ggml_cuda_init: found 1 CUDA devices:
  Device 0: NVIDIA GeForce RTX 3090, compute capability 8.6, VMM: yes
✔ llama.cpp builtCon llama.cpp compilato e il supporto CUDA verificato, il passo successivo è scaricare il modello GLM 4.7 Flash. In questo tutorial, usiamo Hugging Face Hub con supporto Xet per abilitare download veloci e affidabili di file di modello di grandi dimensioni.
Nello stesso terminale, digita i seguenti comandi per installare i pacchetti Python necessari per download ad alte prestazioni del modello.
pip -q install -U "huggingface_hub[hf_xet]" hf-xet
pip -q install -U hf_transfer
Quindi esegui il seguente script Python nel terminale per scaricare la variante quantizzata a 4 bit. Questo script usa i percorsi dello spazio di lavoro definiti in precedenza e scarica solo il file GGUF richiesto.
python - <<'PY'
import os
from huggingface_hub import snapshot_download

model_dir = os.environ["MODEL_DIR"]

snapshot_download(
    repo_id="unsloth/GLM-4.7-Flash-GGUF",
    local_dir=model_dir,
    allow_patterns=["*UD-Q4_K_XL*"],
)

print("✔ Download complete:", model_dir)
PY
Al termine del download, dovresti vedere un output che conferma il recupero del file del modello, per una dimensione totale di circa 17,5 GB.
Fetching 1 files: 100%|███████████████████████████████████████████████████████████████████████████████████| 1/1 [00:52<00:00, 52.80s/it]
Download complete: 100%|████████████████████████████████████████████████████████████████████████████| 17.5G/17.5G [00:52<00:00, 480MB/s]✔ Download complete: /workspace/models/unsloth/GLM-4.7-Flash-GGUF
Infine, verifica che il file del modello sia presente nella directory di destinazione.
ls -lh "$MODEL_DIR"Dovresti vedere elencato il file GLM-4.7-Flash-UD-Q4_K_XL.gguf, a conferma che il modello è pronto per l'inferenza.
total 17G
-rw-rw-rw- 1 root root 17G Jan 21 18:46 GLM-4.7-Flash-UD-Q4_K_XL.ggufCon il modello scaricato e llama.cpp compilato con supporto CUDA, il passaggio successivo è avviare il server di inferenza. Questo esporrà GLM 4.7 Flash come un'API locale utilizzabile da interfacce utente, script e agenti di coding AI.
Usa la stessa sessione di terminale e lo stesso workspace configurati nelle sezioni precedenti.
Per prima cosa, individua il file modello GGUF scaricato e memorizza il suo percorso in una variabile d'ambiente.
export MODEL_FILE="$(ls "$MODEL_DIR"/*.gguf | grep -i UD-Q4_K_XL | head -n 1)"Poi avvia il server di inferenza di llama.cpp con il seguente comando. Questa configurazione è ottimizzata per una RTX 3090 e bilancia throughput, latenza e lunghezza del contesto.
$LLAMA_DIR/llama-server \
  --model "$MODEL_FILE" \
  --alias "GLM-4.7-Flash" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 16384 \
  --temp 0.7 \
  --top-p 1 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
--ubatch-size 256--model carica il file modello GGUF di GLM 4.7 Flash selezionato per l'inferenza.--alias assegna un nome leggibile al modello che appare nelle risposte API e nei log.--threads usa 32 thread CPU per supportare tokenizzazione, scheduling e gestione delle richieste su un sistema con molti core.--host associa il server a tutte le interfacce di rete così da poter essere accessibile in locale o da altre macchine in rete.--ctx-size imposta una finestra di contesto ampia che bilancia supporto a prompt lunghi e uso della memoria GPU.--temp applica una casualità moderata per migliorare la qualità delle risposte senza compromettere la stabilità del ragionamento.--top-p disabilita il filtraggio nucleus per consentire l'intera distribuzione di token durante la generazione.--port 8080 espone il server di inferenza su una porta standard per lo sviluppo locale.--fit abilita l'adattamento automatico della memoria per massimizzare l'utilizzo della GPU senza superare i limiti di VRAM.--prio imposta un livello di priorità bilanciato per carichi di inferenza con richieste concorrenti.--jinja abilita il supporto ai template Jinja per prompt strutturati e flussi di lavoro in stile agente.--flash-attn abilita automaticamente Flash Attention quando supportato dalla GPU per aumentare il throughput.--batch-size consente l'elaborazione di batch ampi per migliorare il throughput di token sulla RTX 3090.--ubatch-size suddivide i batch grandi in micro-batch più piccoli per controllare pressione sulla memoria e latenza.Una volta avviato, il server caricherà il modello nella memoria della GPU e inizierà ad ascoltare le richieste sulla porta 8080. A questo punto, GLM 4.7 Flash è in esecuzione in locale e può essere raggiunto tramite endpoint HTTP per chat, completion e flussi in stile agente.
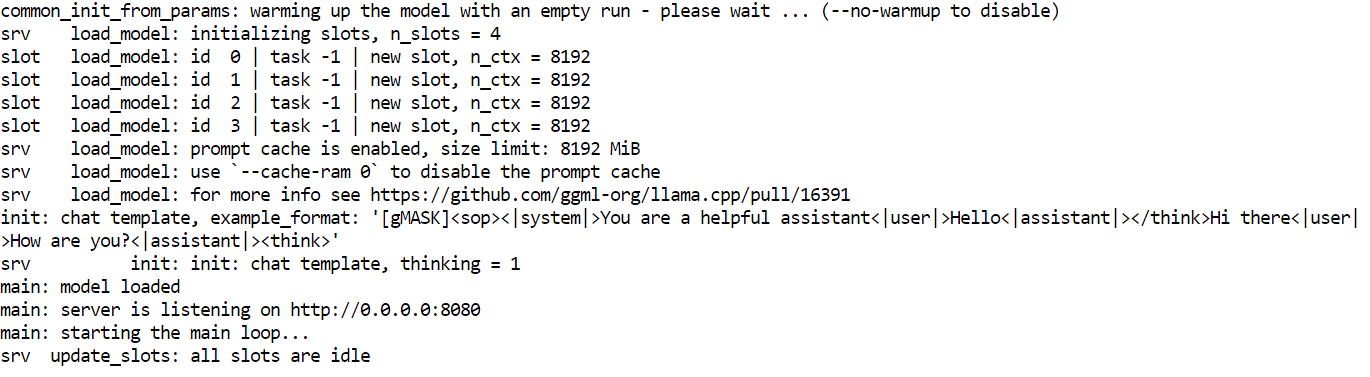
Con il server di inferenza in esecuzione, puoi ora testare GLM 4.7 Flash usando diverse interfacce, inclusa la web UI integrata, richieste HTTP dirette e l'SDK Python compatibile con OpenAI.
L'interfaccia web di llama.cpp è disponibile su: http://0.0.0.0:8080
Copia questo URL e aprilo nel browser per accedere a una semplice interfaccia chat simile a ChatGPT.
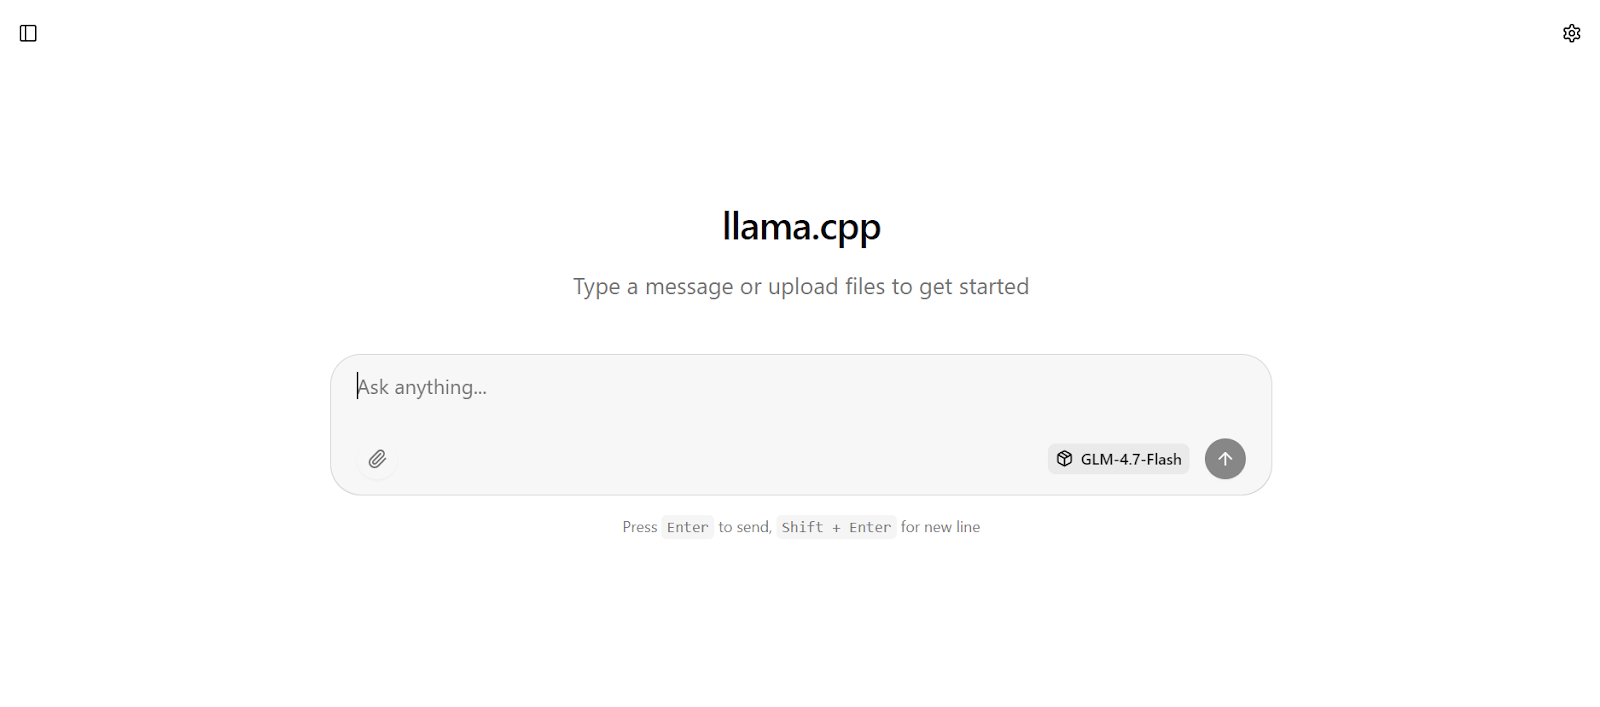
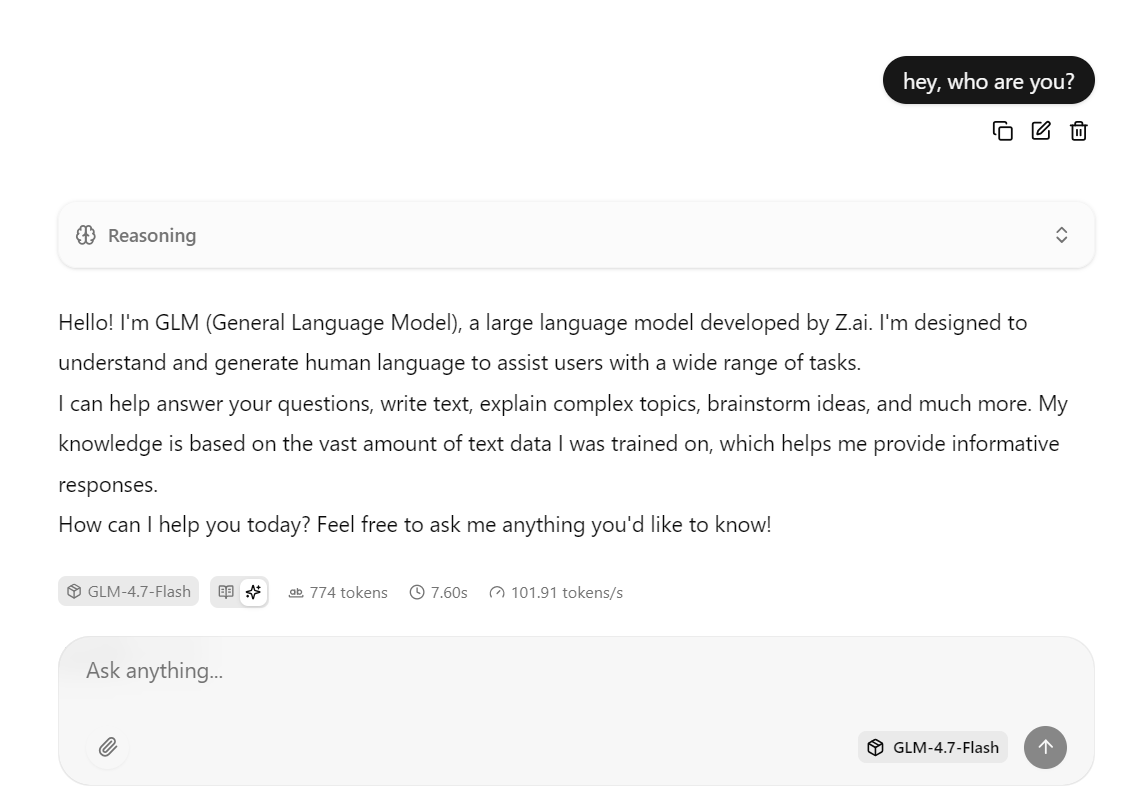
Inserisci un prompt e il modello inizierà subito a generare una risposta.
Questa configurazione è ottimizzata per la velocità eseguendo il modello su RTX 3090 con CUDA abilitato, usando Flash Attention quando disponibile e impostazioni di batching tarate per un alto throughput.
In pratica, questa configurazione può raggiungere circa 100 token al secondo per risposte brevi o medie.
Puoi anche interagire con lo stesso server usando un comando curl. Apri una nuova finestra del terminale ed esegui la seguente richiesta per inviare un prompt di chat completion.
curl -N http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer local" \
  -d '{
    "model": "GLM-4.7-Flash",
    "messages": [
      { "role": "user", "content": "Write a short bash script that prints numbers 1 to 5." }
    ]
  }'
Puoi anche testare il modello usando Python installando l'SDK Python di OpenAI.
pip -q install openaiIn questo esempio Python, il client OpenAI è configurato per inviare richieste al server di inferenza di llama.cpp in esecuzione in locale.
Il base_url punta all'endpoint API locale, e il campo API key è richiesto dall'SDK ma può essere impostato su un qualsiasi valore segnaposto, dato che l'autenticazione è gestita in locale.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local"
)
Il client invia quindi una richiesta di chat completion a GLM 4.7 Flash usando l'alias del modello definito all'avvio del server di inferenza. Il prompt è fornito nel formato chat standard e la risposta viene restituita come oggetto strutturato.
r = client.chat.completions.create(
    model="GLM-4.7-Flash",
    messages=[{"role": "user", "content": "Build me a Simple API server using FastAPI"}]
)

print(r.choices[0].message.content)
Nel giro di pochi secondi, il modello restituirà una risposta completa, con codice di esempio e spiegazioni.
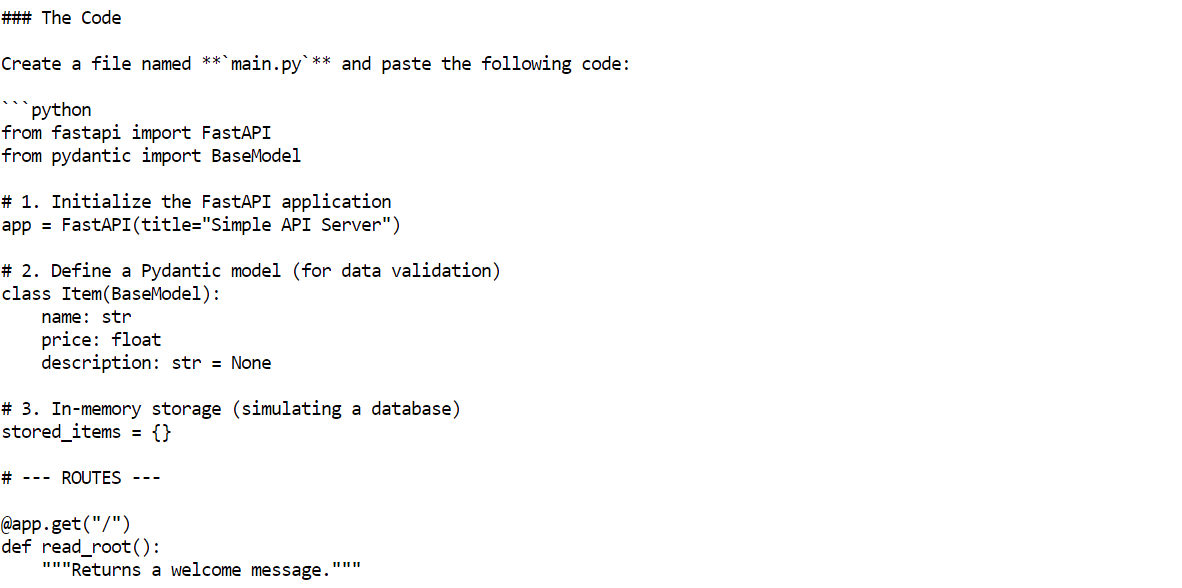
OpenCode è un agente di coding AI open source progettato per girare in locale supportando flussi di lavoro agentici come generazione di codice, modifica di file, esecuzione di comandi e problem solving iterativo.
A differenza degli assistenti di coding basati su cloud, OpenCode può connettersi a server di inferenza self-hosted, permettendoti di creare un setup di coding AI completamente locale e gratuito.
In questo tutorial, OpenCode è configurato per usare il server locale di llama.cpp che esegue GLM 4.7 Flash tramite un'API compatibile con OpenAI.
Per iniziare, usa la stessa sessione di terminale e installa OpenCode usando lo script ufficiale di installazione.
curl -fsSL https://opencode.ai/install | bash Dopo l'installazione, aggiorna il tuo PATH in modo che il comando opencode sia disponibile nel terminale.
export PATH="$HOME/.local/bin:$PATH"Apri una nuova finestra del terminale e verifica che OpenCode sia installato correttamente.
opencode --versionDovresti vedere un numero di versione simile al seguente.
1.1.29Quindi crea la directory di configurazione di OpenCode. Poi crea il file di configurazione di OpenCode e definisci llama.cpp come provider. Questa configurazione indica a OpenCode di inviare tutte le richieste al server di inferenza in esecuzione in locale e di usare il modello GLM 4.7 Flash.
mkdir -p ~/.config/opencode


cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llamacpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama.cpp (local)",
      "options": {
        "baseURL": "http://127.0.0.1:8080/v1"
      },
      "models": {
        "GLM-4.7-Flash": {
          "name": "GLM-4.7-Flash (UD-Q4_K_XL)"
        }
      }
    }
  },
  "model": "GLM-4.7-Flash"
}
EOF
Infine, autentica OpenCode. Questo passaggio è richiesto dallo strumento, ma poiché il server di inferenza è locale, la chiave API può essere un qualsiasi valore segnaposto.
opencode auth loginQuando richiesto, usa i seguenti valori.
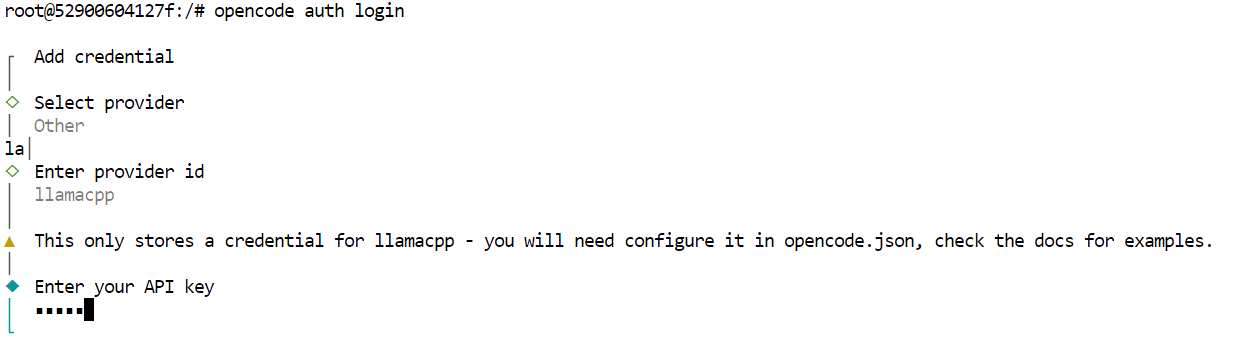
A questo punto, OpenCode è completamente configurato per usare GLM 4.7 Flash tramite il server locale di llama.cpp.
Con OpenCode configurato e connesso al server locale di llama.cpp, puoi ora usare GLM 4.7 Flash come agente di coding AI completamente automatizzato.
Inizia creando una nuova directory di progetto e spostandoti al suo interno.
mkdir -p /workspace/project
cd /workspace/project
Quindi avvia OpenCode dalla stessa shell.
opencodeUna volta avviato OpenCode, premi il tasto Tab per passare alla modalità Plan. In questa modalità, descrivi cosa vuoi costruire.
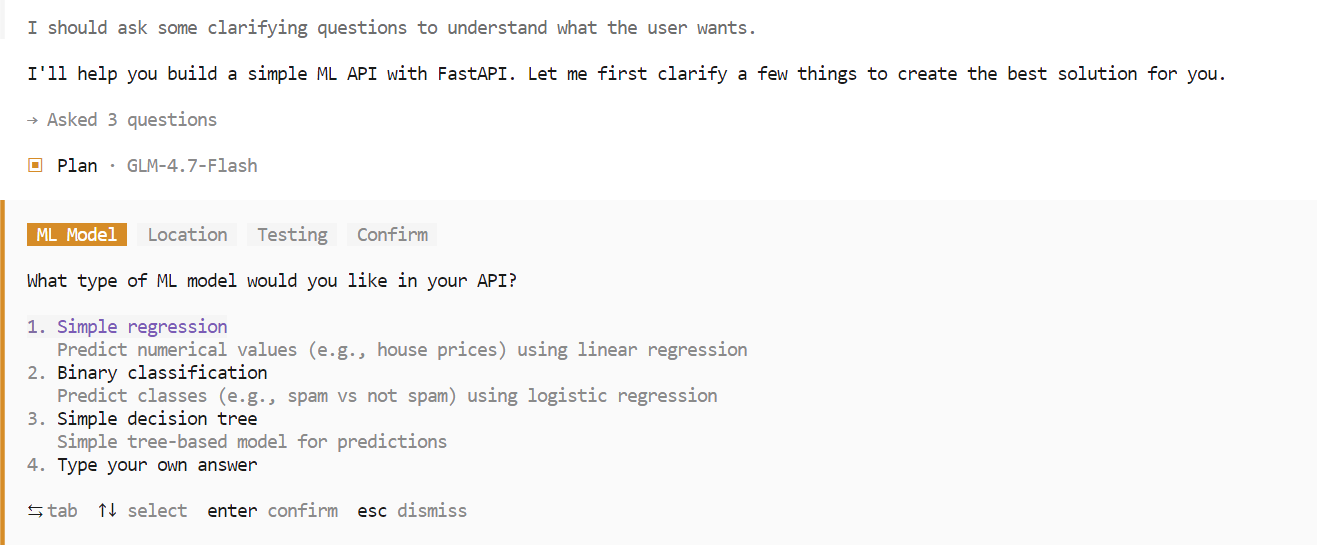
Per esempio, inserisci un prompt chiedendo a OpenCode di creare una semplice API con FastAPI alimentata da machine learning. OpenCode pianificherà automaticamente il progetto, genererà il codice, avvierà il server API e testerà l'implementazione.
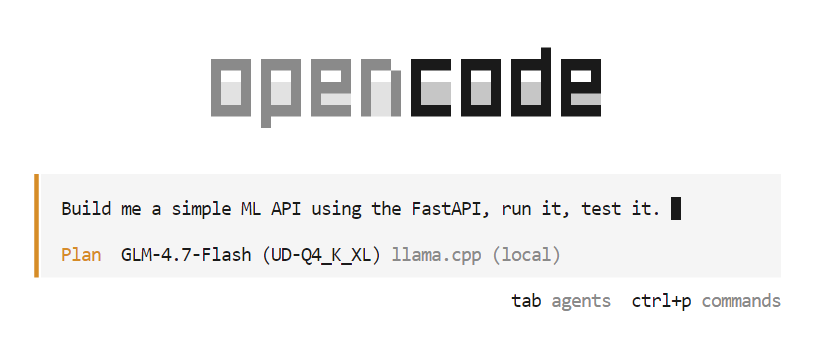
Durante la fase di pianificazione, OpenCode può porre domande di approfondimento per chiarire requisiti come scelta del framework, endpoint o struttura del progetto. Seleziona le opzioni che preferisci e conferma per procedere.
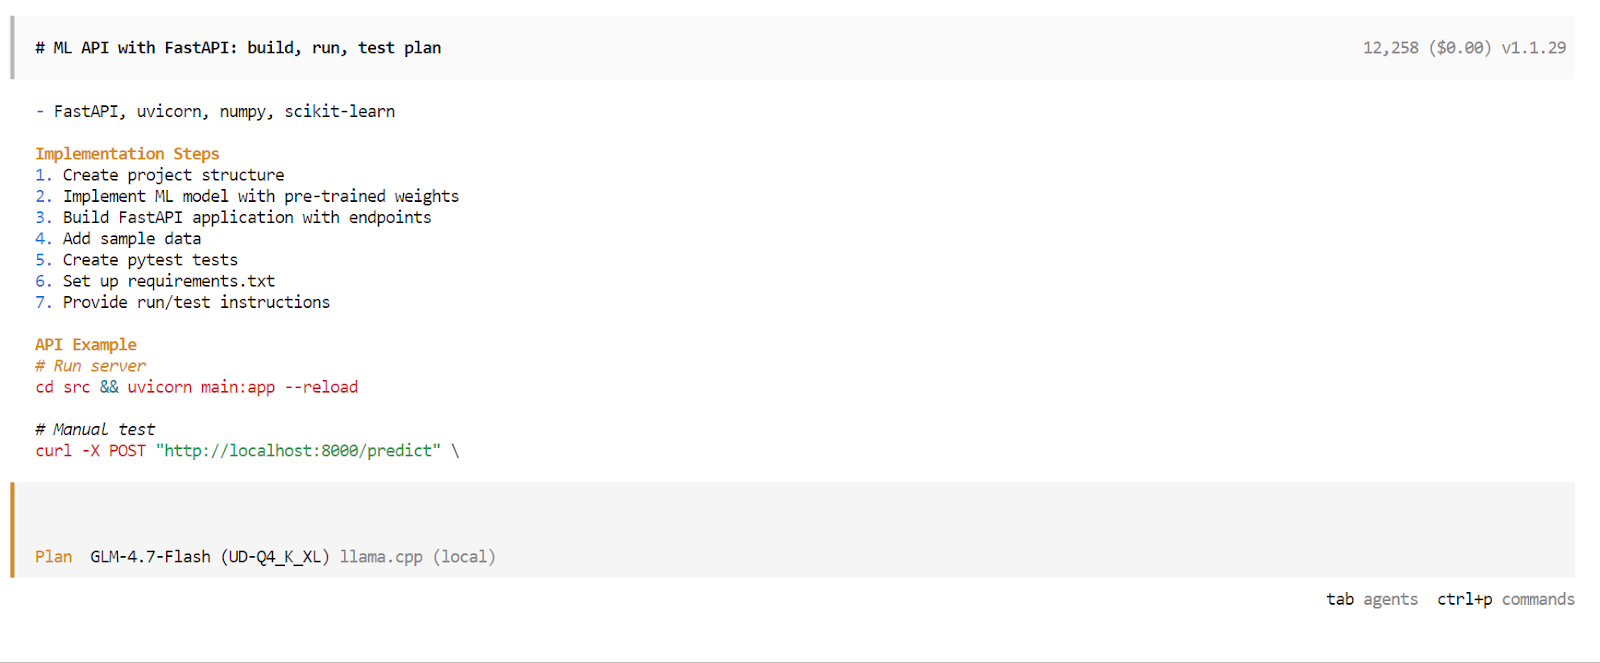
Al termine della pianificazione, OpenCode presenterà un piano di esecuzione dettagliato. Rivedilo e approvalo se corrisponde alle tue aspettative. Quindi premi di nuovo Tab per passare dalla modalità Plan alla modalità Build.
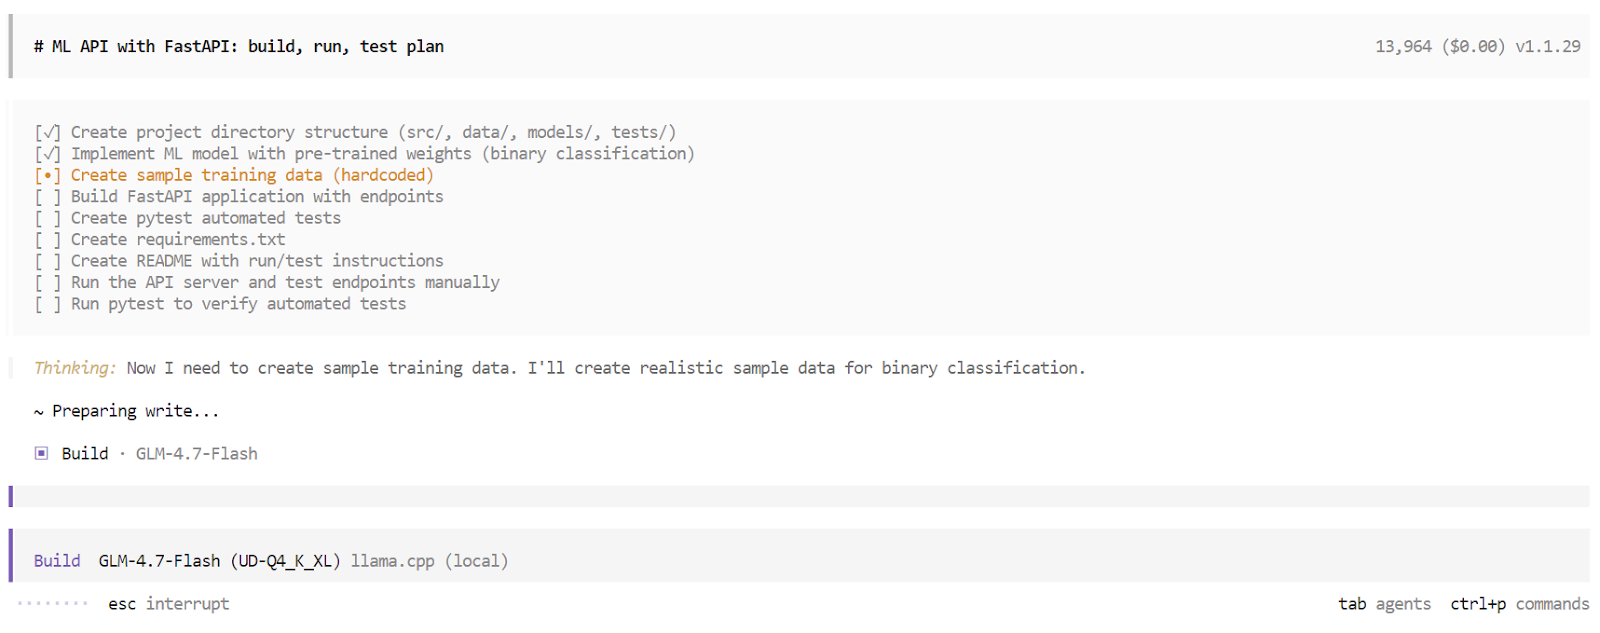
In modalità Build, OpenCode crea un elenco strutturato di task ed esegue ogni passaggio in sequenza. Questo include generare file, scrivere codice, installare dipendenze, avviare il server ed eseguire test. Puoi osservare in tempo reale il completamento di ogni task.
Una volta terminato il processo di build, OpenCode fornisce una panoramica completa dell'applicazione. Include istruzioni d'uso, richieste di esempio e risultati dei test automatici. A questo punto, hai un'applicazione pienamente funzionante, costruita e validata da un agente di coding AI locale che gira interamente sulla tua macchina.
GLM 4.7 Flash rappresenta un passo deciso verso agenti di coding AI completamente locali. La possibilità di eseguire un modello di ragionamento veloce e capace interamente su hardware locale e integrarlo con strumenti come OpenCode segna un allontanamento significativo dai flussi di lavoro dipendenti dal cloud.
Detto questo, GLM 4.7 Flash ha ancora dei limiti. Sebbene funzioni bene per task da piccoli a medi, può avere difficoltà con flussi di lavoro di coding più complessi e multi-step. Il contesto può riempirsi rapidamente, l'esecuzione degli strumenti a volte può fallire e in alcuni casi l'agente può interrompersi a metà, richiedendo una nuova sessione per proseguire.
Questi problemi sono prevedibili per un modello MoE leggero ottimizzato per la velocità più che per la massima profondità di ragionamento.
In termini di capacità pura, GLM 4.7 Flash non è allo stesso livello del modello GLM 4.7 completo, più vicino per prestazioni a modelli come Claude 4.5 Sonnet. Il compromesso è chiaro: GLM 4.7 Flash privilegia velocità, efficienza e usabilità locale rispetto al massimo potere di ragionamento.
Seguire questo tutorial e tarare il server di inferenza è stata un'esperienza preziosa. Eseguire varianti a precisione più alta e aumentare la finestra di contesto può migliorare l'affidabilità nel coding, ma ottenere i risultati migliori richiede un'attenta sperimentazione con parametri come temperatura, top p, dimensioni dei batch e lunghezza del contesto. Raggiungere una configurazione ottimale è un processo iterativo.
Nel complesso, GLM 4.7 Flash è un'opzione pratica ed entusiasmante per gli sviluppatori che oggi vogliono agenti di coding AI veloci, locali e gratuiti, con ampi margini di miglioramento man mano che strumenti e modelli evolvono.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min




