
Kurs
Ölçeklenebilir Etkin Sistemler Oluşturma
1 sa 30 dk
21.9K
GLM 4.7 Flash, yeni yayımlanan, yerelde çalıştırılabildiği hâlde kodlama, akıl yürütme ve aracısal iş akışlarında güçlü performans sunmasıyla dikkat çeken açık ağırlıklı büyük dil modelidir.
Ücretli API’lere veya bulut barındırmalı altyapıya bağlı pek çok modern modelin aksine, GLM 4.7 Flash, hafif çıkarım çerçeveleriyle tamamen yerel donanımda çalıştırılabilir. Bu da modeli üzerinde tam denetim, çevrimdışı kullanım, öngörülebilir maliyetler ve geliştirme sırasında hızlı yineleme isteyen geliştiriciler için cazip bir seçenek hâline getirir.
Doğru kurulum ve miktarsallaştırma ile model, tüketici sınıfı GPU’larda yararlı akıl yürütme kalitesini korurken yüksek belirteç üretim hızlarına ulaşabilir.
Bu eğitimde, GLM 4.7 Flash’ı llama.cpp kullanarak yerelde çalıştırmak için gereken sistem ortamını nasıl kuracağınızı adım adım anlatacağım. Odak noktamız kurulumu basit, temiz ve tekrarlanabilir tutmak olacak. Modeli indirecek, llama.cpp’yi derleyip yapılandıracak ve ardından modeli hem bir web uygulaması hem de API tabanlı bir çıkarım sunucusu ile test edeceğiz.
Eğitimin ilerleyen kısımlarında, otomatik kod üretimi, yürütme ve test iş akışlarını etkinleştirmek için yerel llama.cpp sunucusunu bir yapay zekâ kodlama aracısıyla entegre edeceğiz. Ayrıca GLM-4.7’yi yerelde çalıştırma rehberimize de göz atabilirsiniz.
GLM 4.7 Flash’ı yerelde çalıştırmadan önce, sisteminizin aşağıdaki gereksinimleri karşıladığından emin olun.
Tam hassasiyet ya da daha yüksek bit miktarsallaştırma için:
4 bit miktarsallaştırılmış model için
Q4_K_XL miktarsallaştırması, belleği önemli ölçüde azaltırken güçlü akıl yürütme ve kodlama performansını korur; bu da RTX 3090, RTX 4080 ve RTX 4090 gibi GPU’lar için uygundur. Bu varyant, tam hassasiyetli ağırlıkları çalıştırmadan yüksek belirteç verimi isteyen kullanıcılar için idealdir.
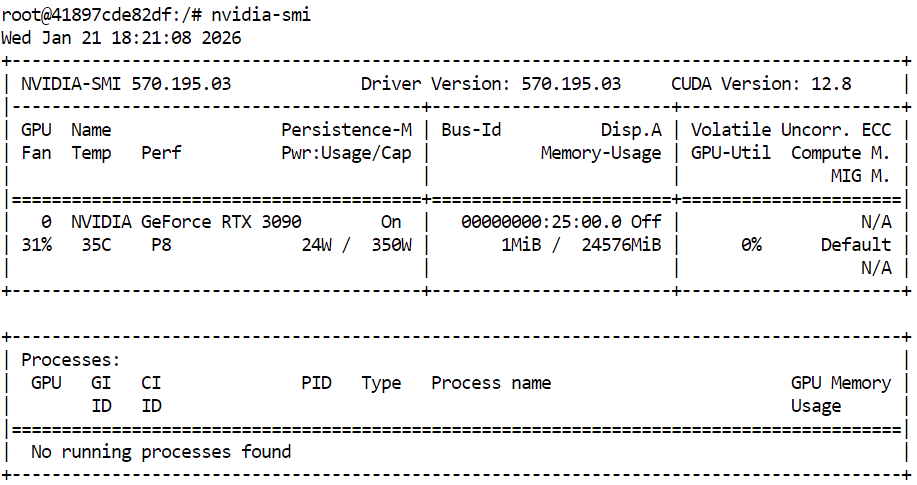
llama.cpp’yi derleyip GLM 4.7 Flash’ı çalıştırmadan önce, NVIDIA GPU’nuzun ve sürücülerinizin doğru kurulduğunu doğrulayın. Bu, CUDA’nın kullanılabilir olmasını ve sistemin GPU hızlandırmalı çıkarımı çalıştırabilmesini sağlar.
nvidia-smiÇıktı, CUDA sürümü 12.8 olan bir RTX 3090 ve 24 GB GPU belleğinin mevcut olduğunu gösterir; bu, GLM 4.7 Flash ve miktarsallaştırılmış türevlerini çalıştırmak için yeterlidir.
Ardından bir terminal açın ve temiz bir çalışma alanı ile dizin yapısı tanımlayın. Bu, kaynak kodunu, model dosyalarını ve önbellek verilerini düzenli tutar; izin sorunlarını önler ve kurulumu kolayca tekrarlanabilir kılar.
export WORKDIR="/workspace"
export LLAMA_DIR="$WORKDIR/llama.cpp"
export MODEL_DIR="$WORKDIR/models/unsloth/GLM-4.7-Flash-GGUF"
Model dosyalarının depolanacağı dizini oluşturun ve Hugging Face önbellek konumlarını ana dizin yerine çalışma alanı içinde yapılandırın. Bu, indirme performansını iyileştirir ve gereksiz uyarıları önler.
mkdir -p "$MODEL_DIR"
export HF_HOME="$WORKDIR/.cache/huggingface"
export HUGGINGFACE_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
export HF_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
Sembolik bağlantı uyarılarını bastırmak ve yüksek performanslı indirmeleri etkinleştirmek için ek ortam değişkenleri ayarlayın.
export HF_HUB_DISABLE_SYMLINKS_WARNING=1
export HF_XET_HIGH_PERFORMANCE=1
Son olarak, llama.cpp’yi derlemek ve indirmeleri yönetmek için gerekli sistem bağımlılıklarını kurun.
sudo apt-get update
sudo apt-get install -y \
  build-essential cmake git curl libcurl4-openssl-dev
Bu noktada sistem ortamı hazırdır. Bir sonraki bölümde, CUDA desteği etkinleştirilmiş şekilde llama.cpp’nin klonlanması ve derlenmesine odaklanacağız.
Ortam hazırlandıktan sonra sıradaki adım llama.cpp’yi kurmak ve CUDA desteğiyle derlemektir. Bu sayede GLM 4.7 Flash, GPU üzerinde verimli şekilde çalışır.
Terminalde çalışma alanınıza gidin. Ardından resmi llama.cpp deposunu klonlamak için aşağıdaki komutu çalıştırın.
git clone https://github.com/ggml-org/llama.cpp "$LLAMA_DIR"Depo klonlandıktan sonra kaynak dosyalar çalışma alanı dizinine indirilmiş olacaktır.
Cloning into '/workspace/llama.cpp'...
remote: Enumerating objects: 76714, done.
remote: Counting objects: 100% (238/238), done.
remote: Compressing objects: 100% (157/157), done.
remote: Total 76714 (delta 172), reused 81 (delta 81), pack-reused 76476 (from 3)
Receiving objects: 100% (76714/76714), 282.23 MiB | 13.11 MiB/s, done.
Resolving deltas: 100% (55422/55422), done.
Updating files: 100% (2145/2145), done.
Sonraki adımda CMake ile derlemeyi yapılandırın ve CUDA desteğini açıkça etkinleştirin. Bu adım, GPU hızlandırmalı ikili dosyaları derlemek için yapı sistemini hazırlar.
cmake "$LLAMA_DIR" -B "$LLAMA_DIR/build" \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON
Yapılandırma tamamlandığında, gerekli llama.cpp ikililerini derleyin. Bu komut, komut satırı arayüzü ve çıkarım sunucusu dâhil olmak üzere çekirdek çıkarım araçlarını derler.
cmake --build "$LLAMA_DIR/build" --config Release -j --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
Derleme tamamlandıktan sonra, derlenen ikili dosyaları kolay erişim için ana llama.cpp dizinine kopyalayın.
cp "$LLAMA_DIR/build/bin/llama-"* "$LLAMA_DIR/"Son olarak, çıkarım sunucusunun yardım komutunu çalıştırarak llama.cpp’nin doğru şekilde derlendiğini ve CUDA’nın algılandığını doğrulayın.
"$LLAMA_DIR/llama-server" --help >/dev/null && echo "✔ llama.cpp built"CUDA desteği doğru etkinleştirilmişse, çıktı; GPU modeli ve hesaplama yetkinliği dâhil olmak üzere bir CUDA aygıtının algılandığını onaylayacaktır.
ggml_cuda_init: found 1 CUDA devices:
  Device 0: NVIDIA GeForce RTX 3090, compute capability 8.6, VMM: yes
✔ llama.cpp builtllama.cpp derlenip CUDA desteği doğrulandıktan sonra sıradaki adım GLM 4.7 Flash modelini indirmektir. Bu eğitimde, büyük model dosyalarının hızlı ve güvenilir indirilebilmesi için Xet desteğiyle Hugging Face Hub kullanılacaktır.
Aynı terminalde, yüksek performanslı model indirmeleri için gerekli Python paketlerini yüklemek üzere aşağıdaki komutları çalıştırın.
pip -q install -U "huggingface_hub[hf_xet]" hf-xet
pip -q install -U hf_transfer
Ardından, 4 bit miktarsallaştırılmış model varyantını indirmek için terminalde aşağıdaki Python betiğini çalıştırın. Bu betik, daha önce tanımlanan çalışma alanı yollarını kullanır ve yalnızca gerekli GGUF dosyasını indirir.
python - <<'PY'
import os
from huggingface_hub import snapshot_download

model_dir = os.environ["MODEL_DIR"]

snapshot_download(
    repo_id="unsloth/GLM-4.7-Flash-GGUF",
    local_dir=model_dir,
    allow_patterns=["*UD-Q4_K_XL*"],
)

print("✔ Download complete:", model_dir)
PY
İndirme tamamlandığında, toplam yaklaşık 17,5 GB boyutlu model dosyasının başarıyla getirildiğini doğrulayan bir çıktı görmelisiniz.
Fetching 1 files: 100%|███████████████████████████████████████████████████████████████████████████████████| 1/1 [00:52<00:00, 52.80s/it]
Download complete: 100%|████████████████████████████████████████████████████████████████████████████| 17.5G/17.5G [00:52<00:00, 480MB/s]✔ Download complete: /workspace/models/unsloth/GLM-4.7-Flash-GGUF
Son olarak, hedef dizinde model dosyasının mevcut olduğunu doğrulayın.
ls -lh "$MODEL_DIR"Listede GLM-4.7-Flash-UD-Q4_K_XL.gguf dosyasını görmelisiniz; bu da modelin çıkarım için hazır olduğunu doğrular.
total 17G
-rw-rw-rw- 1 root root 17G Jan 21 18:46 GLM-4.7-Flash-UD-Q4_K_XL.ggufModel indirildi ve llama.cpp CUDA desteğiyle derlendiğine göre sıradaki adım çıkarım sunucusunu başlatmaktır. Bu, GLM 4.7 Flash’ı yerel bir API olarak sunar; kullanıcı arayüzleri, betikler ve yapay zekâ kodlama aracıları tarafından kullanılabilir.
Lütfen önceki bölümlerde yapılandırdığınız aynı terminal oturumunu ve çalışma alanını kullanın.
Önce indirilen GGUF model dosyasını bulun ve yolunu bir ortam değişkeninde saklayın.
export MODEL_FILE="$(ls "$MODEL_DIR"/*.gguf | grep -i UD-Q4_K_XL | head -n 1)"Ardından, aşağıdaki komutla llama.cpp çıkarım sunucusunu başlatın. Bu yapılandırma, RTX 3090 için en iyilenmiştir ve verim, gecikme ve bağlam uzunluğu arasında denge sağlar.
$LLAMA_DIR/llama-server \
  --model "$MODEL_FILE" \
  --alias "GLM-4.7-Flash" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 16384 \
  --temp 0.7 \
  --top-p 1 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
--ubatch-size 256--model seçilen GLM 4.7 Flash GGUF model dosyasını çıkarım için yükler.--alias API yanıtlarında ve günlüklerde görünen okunabilir bir model adı atar.--threads yüksek çekirdekli bir sistemde belirteçleştirme, zamanlama ve istek işleme için 32 CPU iş parçacığı kullanır.--host sunucuyu tüm ağ arayüzlerine bağlar; böylece yerelden veya ağdaki diğer makinelerden erişilebilir.--ctx-size uzun istem desteği ile GPU bellek kullanımı arasında denge sağlayan geniş bir bağlam penceresi ayarlar.--temp yanıtlara makul bir rastgelelik uygular; böylece akıl yürütme dengesi bozulmadan kalite artar.--top-p üretim sırasında tam belirteç dağılımına izin vermek için çekirdek filtrelemeyi devre dışı bırakır.--port 8080 çıkarım sunucusunu standart bir yerel geliştirme portunda sunar.--fit VRAM sınırlarını aşmadan GPU kullanımını en üst düzeye çıkarmak için otomatik bellek uyarlamasını etkinleştirir.--prio eşzamanlı istekler altında çıkarım iş yükleri için dengeli bir öncelik düzeyi ayarlar.--jinja yapılandırılmış istemler ve aracısal iş akışları için Jinja şablonlama desteğini etkinleştirir.--flash-attn GPU tarafından desteklendiğinde verimi artırmak için Flash Attention’ı otomatik olarak etkinleştirir.--batch-size RTX 3090’da belirteç verimini artırmak için büyük yığın işlemeye izin verir.--ubatch-size bellek baskısını ve gecikmeyi kontrol etmek için büyük yığınları daha küçük mikro yığınlara böler.Sunucu başlatıldıktan sonra modeli GPU belleğine yükler ve 8080 portunda istekleri dinlemeye başlar. Bu noktada GLM 4.7 Flash yerelde çalışmaktadır ve sohbet, tamamlama ve aracısal iş akışları için HTTP uç noktaları üzerinden erişilebilir.
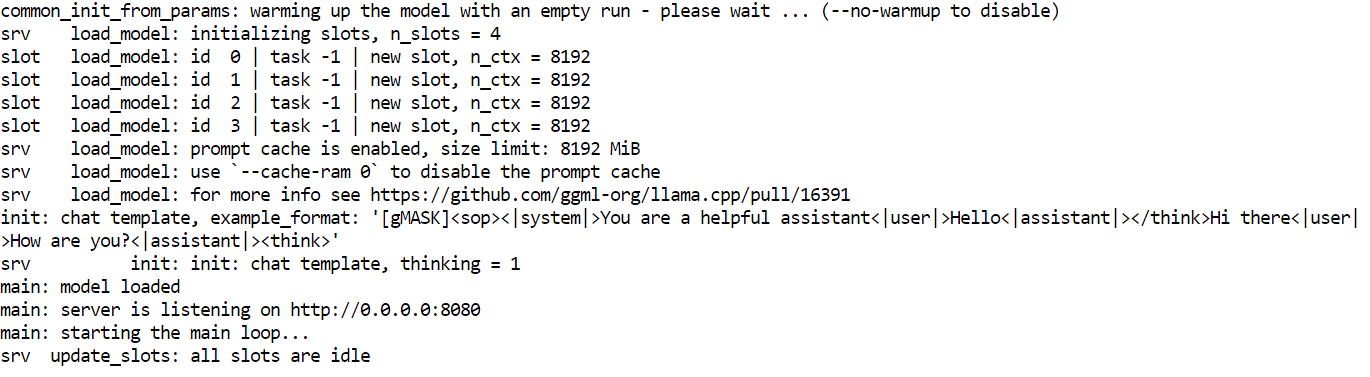
Çıkarım sunucusu çalışırken, yerleşik web arayüzü, doğrudan HTTP istekleri ve OpenAI uyumlu Python SDK’sı dâhil olmak üzere birden fazla arayüzle GLM 4.7 Flash’ı test edebilirsiniz.
llama.cpp web arayüzü şu adrestedir: http://0.0.0.0:8080
Bu URL’yi kopyalayıp web tarayıcınızda açarak ChatGPT’ye benzer basit bir sohbet arayüzüne erişin.
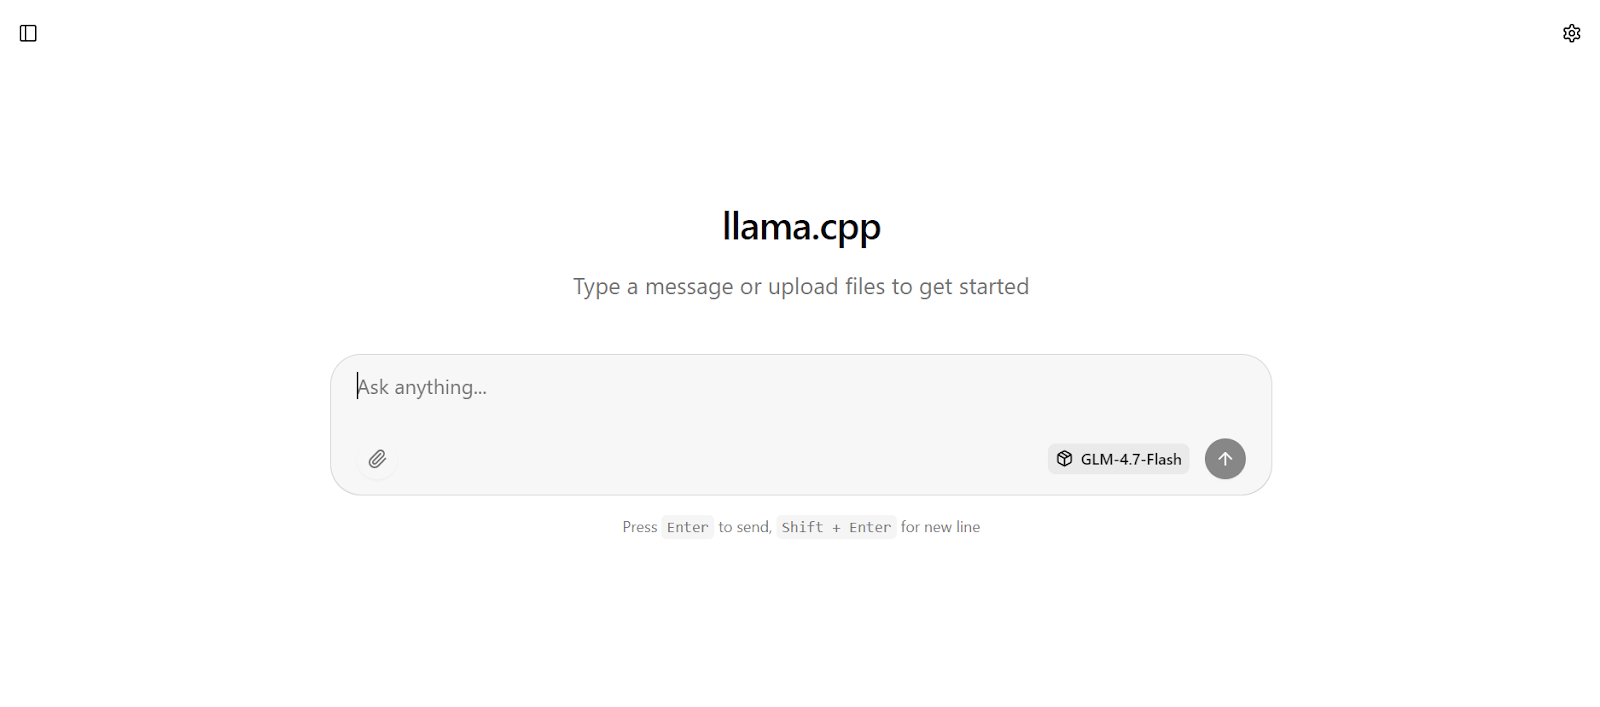
Bir istem girin; model anında yanıt üretmeye başlayacaktır.
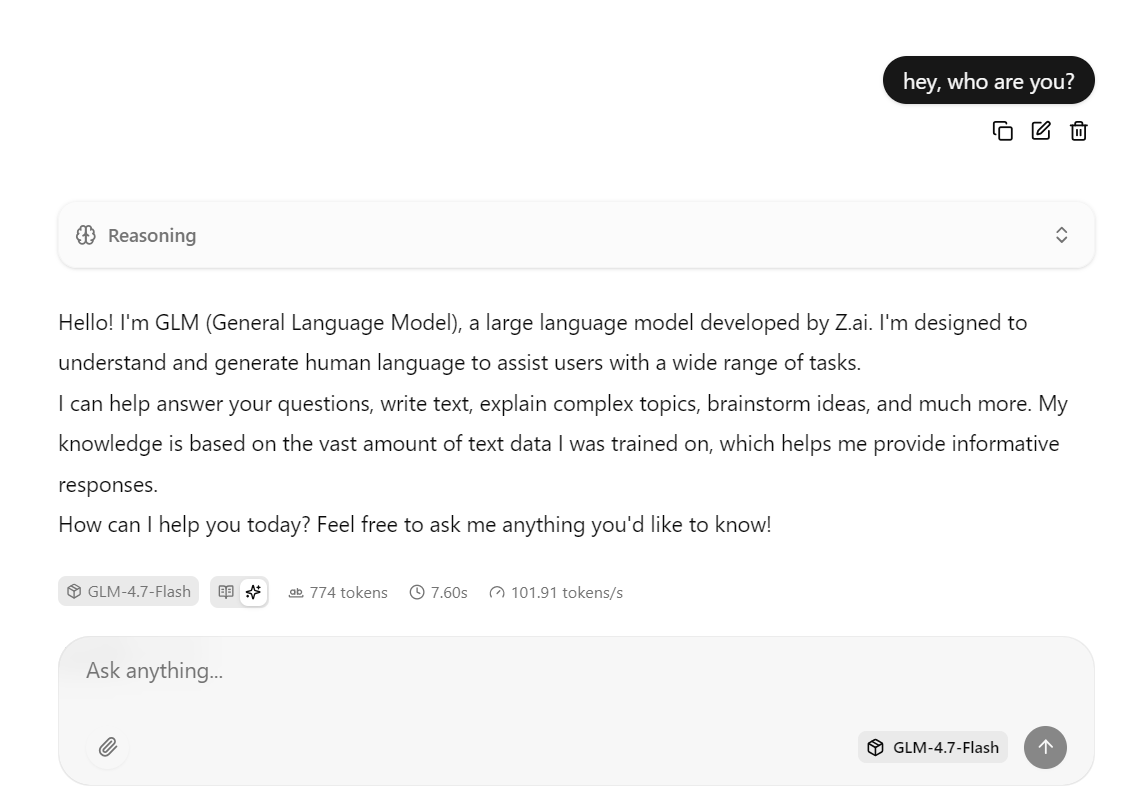
Bu kurulum; CUDA etkin bir RTX 3090’da modeli çalıştırarak, mümkün olduğunda Flash Attention kullanarak ve yüksek verim için ayarlanmış yığınlama ayarlarıyla hız için iyileştirilmiştir.
Pratikte, bu yapılandırma kısa ve orta uzunlukta yanıtlarda saniyede yaklaşık 100 belirtece ulaşabilir.
Aynı sunucuyla bir curl komutu kullanarak da etkileşime geçebilirsiniz. Yeni bir terminal penceresi açın ve sohbet tamamlama istemi göndermek için aşağıdaki isteği çalıştırın.
curl -N http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer local" \
  -d '{
    "model": "GLM-4.7-Flash",
    "messages": [
      { "role": "user", "content": "Write a short bash script that prints numbers 1 to 5." }
    ]
  }'
Modeli Python kullanarak da, OpenAI Python SDK’sını kurup test edebilirsiniz.
pip -q install openaiBu Python örneğinde OpenAI istemcisi, yerelde çalışan llama.cpp çıkarım sunucusuna istek gönderecek şekilde yapılandırılmıştır.
base_url yerel API uç noktasını işaret eder ve API anahtarı alanı SDK tarafından zorunludur ancak kimlik doğrulama yerelde işlendiğinden herhangi bir yer tutucu değer verilebilir.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local"
)
İstemci, çıkarım sunucusu başlatılırken tanımlanan model takma adını kullanarak GLM 4.7 Flash’a bir sohbet tamamlama isteği gönderir. İstem standart sohbet biçiminde verilir ve yanıt yapılandırılmış bir nesne olarak döner.
r = client.chat.completions.create(
    model="GLM-4.7-Flash",
    messages=[{"role": "user", "content": "Build me a Simple API server using FastAPI"}]
)

print(r.choices[0].message.content)
Birkaç saniye içinde model; örnek kod ve açıklamalar dâhil olmak üzere tam bir yanıt döndürecektir.
OpenCode; kod üretimi, dosya düzenleme, komut yürütme ve yinelemeli problem çözme gibi aracısal iş akışlarını desteklerken yerelde çalışacak şekilde tasarlanmış açık kaynak bir yapay zekâ kodlama aracısıdır.
Bulut tabanlı kodlama asistanlarının aksine OpenCode, kendi barındırdığınız çıkarım sunucularına bağlanabilir; böylece tamamen yerel ve ücretsiz bir yapay zekâ kodlama kurulumu oluşturabilirsiniz.
Bu eğitimde OpenCode, OpenAI uyumlu bir API üzerinden GLM 4.7 Flash’ı çalıştıran yerel llama.cpp sunucusunu kullanacak şekilde yapılandırılmıştır.
Başlamak için, aynı terminal oturumunu kullanarak OpenCode’u resmi kurulum betiğiyle yükleyin.
curl -fsSL https://opencode.ai/install | bash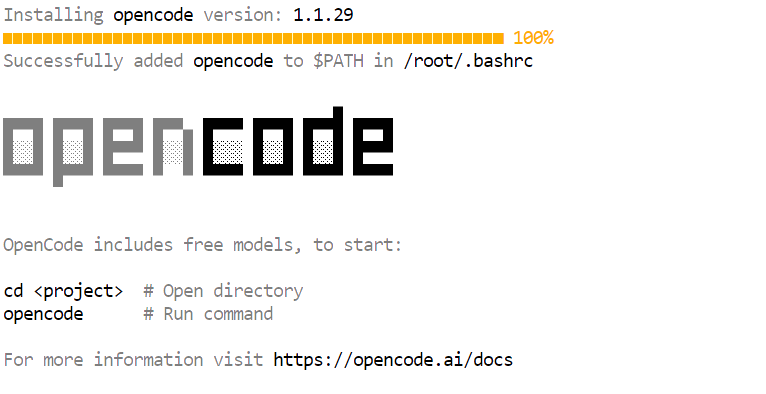 Kurulumdan sonra PATH’inizi güncelleyin ki opencode komutu terminalde kullanılabilir olsun.
export PATH="$HOME/.local/bin:$PATH"Yeni bir terminal penceresi açın ve OpenCode’un doğru kurulduğunu doğrulayın.
opencode --versionAşağıdakine benzer bir sürüm numarası görmelisiniz.
1.1.29Sonraki adımda OpenCode yapılandırma dizinini oluşturun. Ardından OpenCode yapılandırma dosyasını oluşturup sağlayıcı olarak llama.cpp’yi tanımlayın. Bu yapılandırma, OpenCode’a tüm istekleri yerelde çalışan çıkarım sunucusuna göndermesini ve GLM 4.7 Flash modelini kullanmasını söyler.
mkdir -p ~/.config/opencode


cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llamacpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama.cpp (local)",
      "options": {
        "baseURL": "http://127.0.0.1:8080/v1"
      },
      "models": {
        "GLM-4.7-Flash": {
          "name": "GLM-4.7-Flash (UD-Q4_K_XL)"
        }
      }
    }
  },
  "model": "GLM-4.7-Flash"
}
EOF
Son olarak OpenCode’u yetkilendirin. Bu adım araç tarafından gereklidir; ancak çıkarım sunucusu yerel olduğundan API anahtarı herhangi bir yer tutucu değer olabilir.
opencode auth loginİstendiğinde aşağıdaki değerleri kullanın.
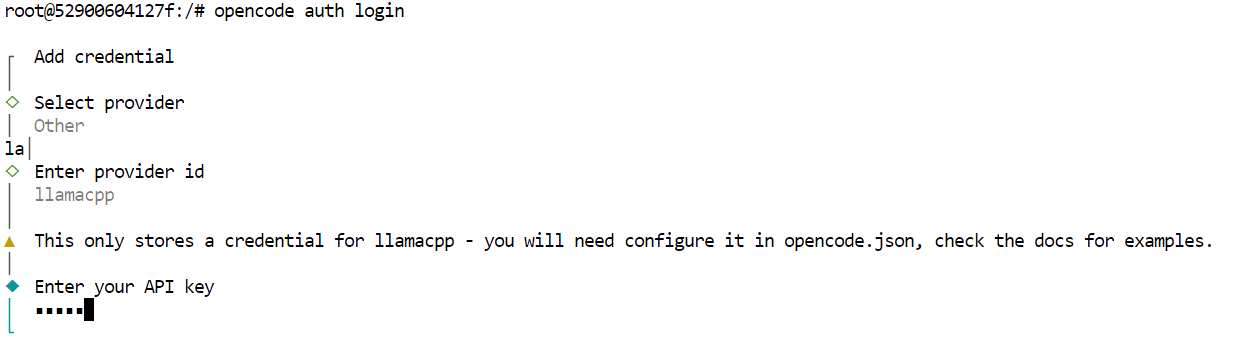
Bu noktada OpenCode, GLM 4.7 Flash’ı yerel llama.cpp sunucusu üzerinden kullanacak şekilde tamamen yapılandırılmıştır.
OpenCode yapılandırılıp yerel llama.cpp sunucusuna bağlandıktan sonra GLM 4.7 Flash’ı tamamen otomatik bir yapay zekâ kodlama aracısı olarak kullanabilirsiniz.
Yeni bir proje dizini oluşturarak başlayın ve o dizine geçin.
mkdir -p /workspace/project
cd /workspace/project
Ardından OpenCode’u aynı terminalden başlatın.
opencodeOpenCode başladıktan sonra Sekme tuşuna basarak Plan moduna geçin. Bu modda, ne inşa etmek istediğinizi anlatın.
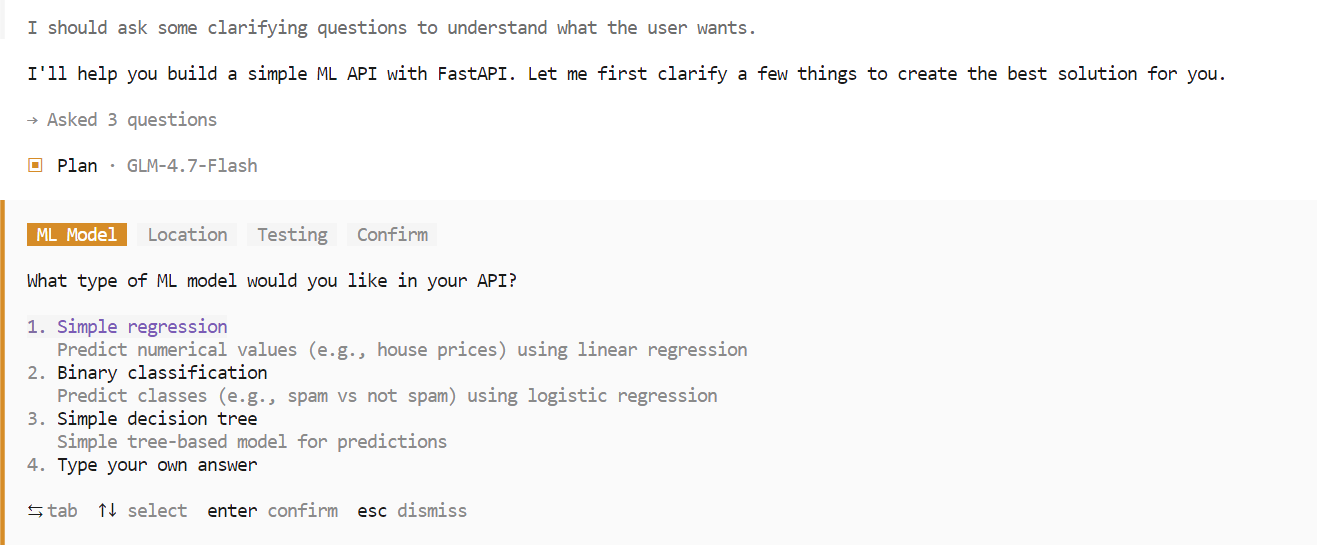
Örneğin, OpenCode’dan FastAPI kullanarak basit bir makine öğrenimi destekli API oluşturmasını isteyin. OpenCode projeyi otomatik olarak planlayacak, kodu üretecek, API sunucusunu çalıştıracak ve uygulamayı test edecektir.
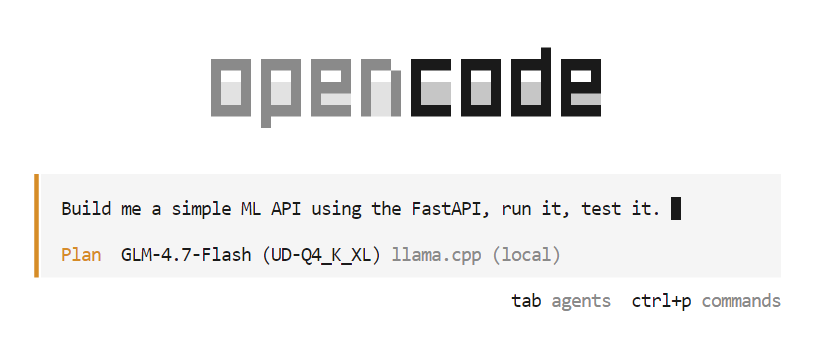
Planlama aşamasında OpenCode; çerçeve tercihleri, uç noktalar veya proje yapısı gibi gereksinimleri netleştirmek için takip soruları sorabilir. Tercih ettiğiniz seçenekleri belirleyin ve devam etmek için onaylayın.
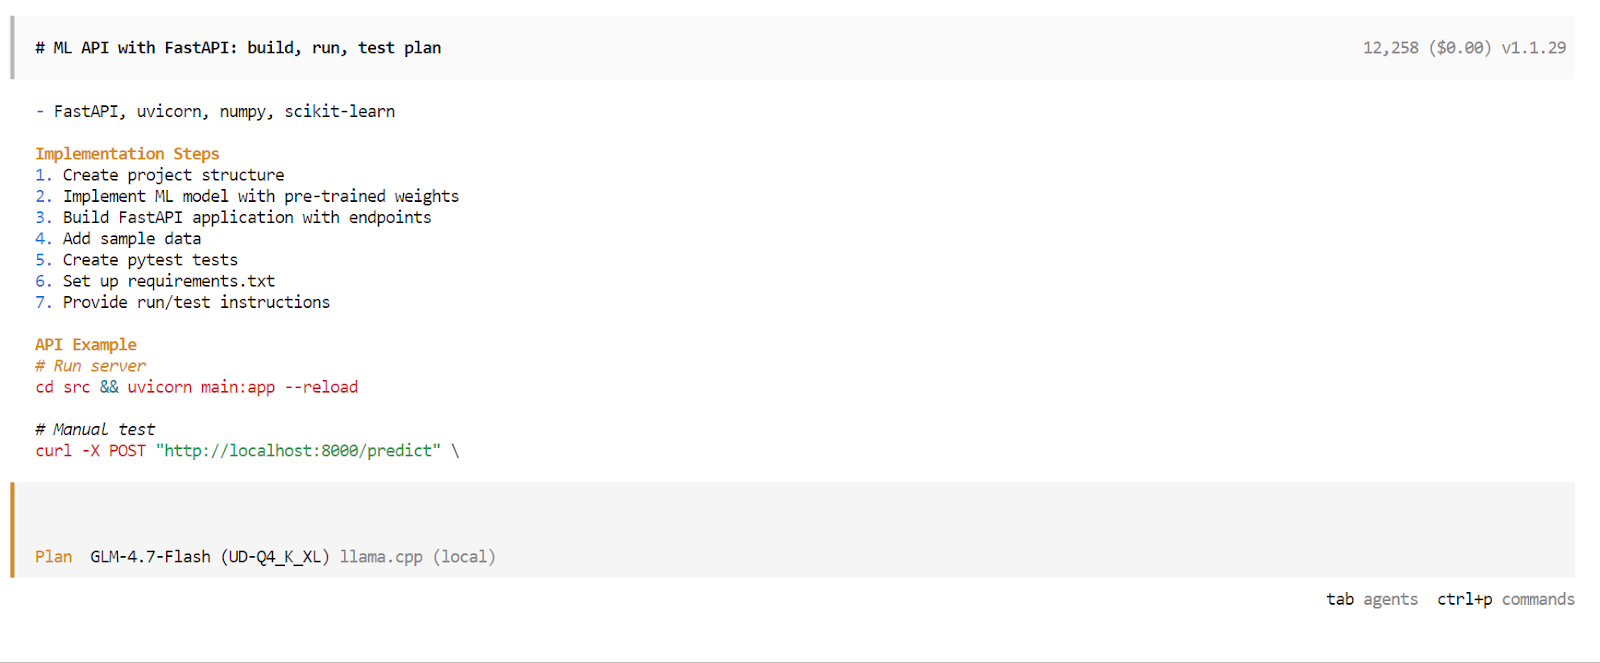
Planlama aşaması tamamlandığında OpenCode ayrıntılı bir yürütme planı sunar. Planı inceleyin ve beklentilerinize uyuyorsa onaylayın. Ardından tekrar Sekme tuşuna basarak Plan modundan Derleme moduna geçin.
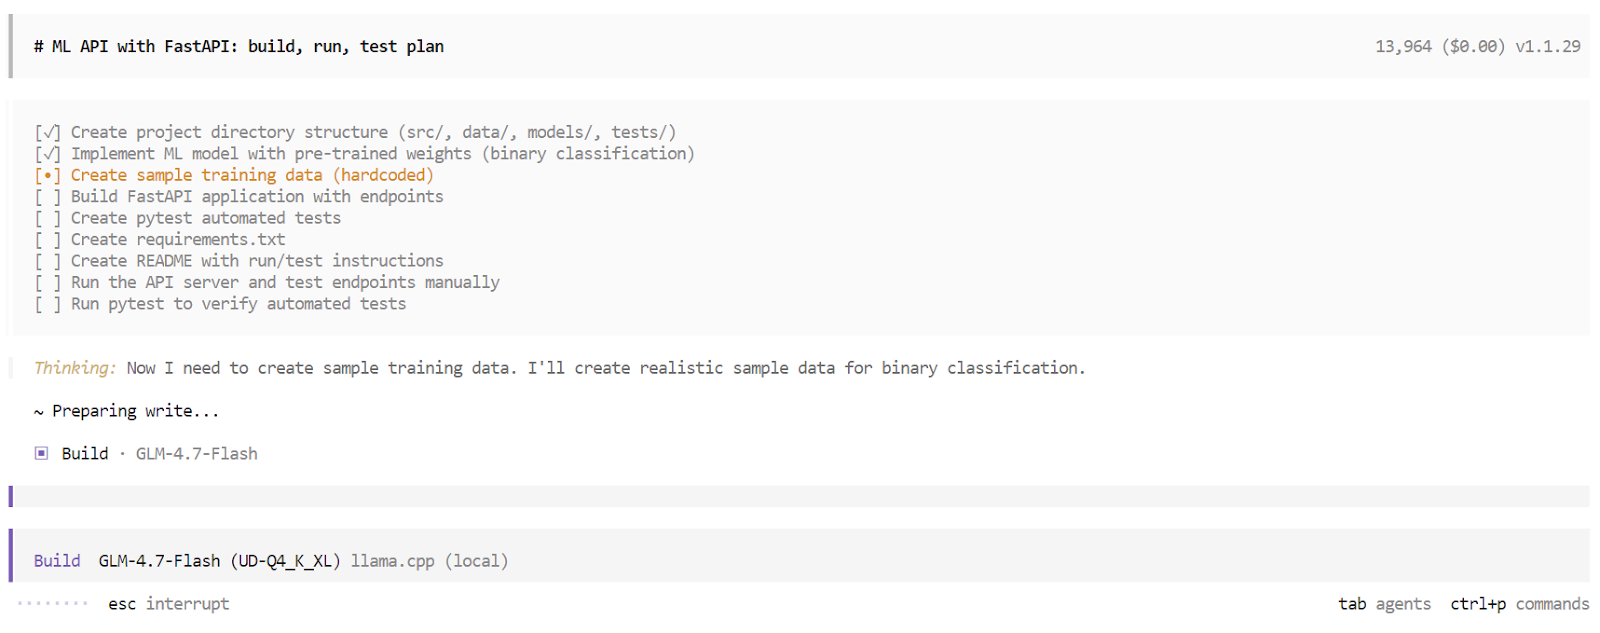
Derleme modunda OpenCode yapılandırılmış bir görev listesi oluşturur ve her adımı sırasıyla yürütür. Buna dosyaların oluşturulması, kodun yazılması, bağımlılıkların kurulması, sunucunun çalıştırılması ve testlerin yürütülmesi dâhildir. Her bir görevin gerçek zamanlı tamamlandığını izleyebilirsiniz.
Derleme süreci tamamlandığında OpenCode uygulamaya ilişkin kapsamlı bir özet sunar. Buna kullanım talimatları, örnek istekler ve otomatik testlerin sonuçları dâhildir. Bu noktada, tamamen makinenizde çalışan yerel bir yapay zekâ kodlama aracısı tarafından inşa edilip doğrulanmış, tamamen çalışan bir uygulamaya sahipsiniz.
GLM 4.7 Flash, tamamen yerel yapay zekâ kodlama aracılarına doğru atılmış güçlü bir adımdır. Hızlı ve yetenekli bir akıl yürütme modelini tamamen yerel donanımda çalıştırabilmek ve OpenCode gibi araçlarla entegre edebilmek, buluta bağımlı iş akışlarından anlamlı bir kopuşu temsil ediyor.
Bununla birlikte GLM 4.7 Flash’ın hâlâ sınırlamaları var. Küçük ve orta ölçekli görevlerde iyi performans gösterse de daha karmaşık, çok adımlı kodlama iş akışlarında zorlanabilir. Bağlam hızla dolabilir, araç yürütmeleri ara sıra başarısız olabilir ve bazı durumlarda aracı sürecin ortasında durabilir; devam etmek için yeni bir oturum gerekebilir.
Bu sorunlar, hız için en iyilenmiş hafif bir MoE modelinden, en yüksek akıl yürütme derinliğinden ziyade, beklenen durumlardır.
Ham yetenek açısından GLM 4.7 Flash, Claude 4.5 Sonnet gibi modellere daha yakın olan tam GLM 4.7 modeliyle aynı düzeyde değildir. Tercih net: GLM 4.7 Flash, en yüksek akıl yürütme gücü yerine hız, verimlilik ve yerel kullanılabilirliği önceliklendirir.
Bu eğitimi uygulamak ve çıkarım sunucusunu ayarlamak değerli bir deneyimdi. Daha yüksek hassasiyetli varyantları çalıştırmak ve bağlam penceresini artırmak, kodlama güvenilirliğini iyileştirebilir; ancak en iyi sonuçlara ulaşmak için sıcaklık, top p, yığın boyutları ve bağlam uzunluğu gibi parametrelerle dikkatli deneyler yapmak gerekir. En iyi ayarlara ulaşmak yinelemeli bir süreçtir.
Genel olarak GLM 4.7 Flash, bugün hızlı, yerel ve ücretsiz yapay zekâ kodlama aracıları isteyen geliştiriciler için pratik ve heyecan verici bir seçenektir; araçlar ve modeller geliştikçe iyileştirme için de açık bir alan sunar.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



