
Last chance! 50% off DataCamp Premium
Sale ends in
GLM 4.7 Flash is een recent uitgebrachte open-weight large language model dat veel aandacht krijgt omdat het lokaal kan draaien en toch sterke prestaties levert voor coderen, redeneren en agent-achtige workflows.
In tegenstelling tot veel moderne modellen die afhankelijk zijn van betaalde API's of cloud-hosted infrastructuur, kan GLM 4.7 Flash volledig op lokale hardware worden uitgevoerd met lichtgewicht inferentiekaders. Dit maakt het een aantrekkelijke optie voor ontwikkelaars die volledige controle over hun modellen willen, offline gebruik, voorspelbare kosten en snelle iteratie tijdens ontwikkeling.
Met de juiste setup en kwantisatie kan het model hoge tokensnelheden behalen op consument-GPU's, terwijl het nuttige redeneerkwaliteit behoudt.
In deze tutorial laat ik je zien hoe je de systeemomgeving instelt die nodig is om GLM 4.7 Flash lokaal uit te voeren met llama.cpp. De focus ligt op een simpele, schone en reproduceerbare setup. We downloaden het model, bouwen en configureren llama.cpp en testen het model vervolgens met zowel een webapplicatie als een API-gebaseerde inferentieserver.
Later in de tutorial integreren we de lokale llama.cpp-server met een AI-codeeragent, zodat geautomatiseerde workflows voor codegeneratie, uitvoering en testen mogelijk worden. Je kunt ook onze gids bekijken over hoe je GLM-4.7 lokaal draait.
Controleer voordat je GLM 4.7 Flash lokaal draait of je systeem aan de volgende vereisten voldoet.
Voor volledige precisie of hogere bit-kwantisatie:
Voor 4 4-bit gekwantiseerd model
De Q4_K_XL-kwantisatie verlaagt het geheugenverbruik aanzienlijk met behoud van sterke redeneer- en codeerprestaties, waardoor het geschikt is voor GPU's zoals RTX 3090, RTX 4080 en RTX 4090. Deze variant is ideaal voor gebruikers die hoge token-throughput willen zonder full-precision gewichten te draaien.
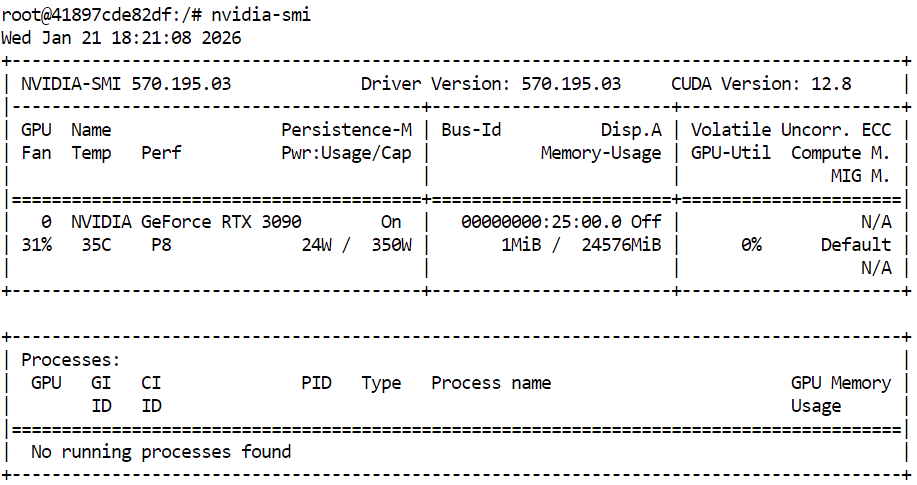
Bevestig voordat je llama.cpp bouwt en GLM 4.7 Flash draait eerst dat je NVIDIA GPU en drivers correct zijn geïnstalleerd. Dit zorgt ervoor dat CUDA beschikbaar is en dat het systeem GPU-versnelde inferentie kan uitvoeren.
nvidia-smiDe output toont een RTX 3090 met CUDA-versie 12.8 en 24GB GPU-geheugen beschikbaar, wat voldoende is voor het draaien van GLM 4.7 Flash en de gekwantiseerde varianten.
Open vervolgens een terminal en definieer een schone werkruimte en mappenstructuur. Dit houdt broncode, modelbestanden en cachedata geordend, helpt toestemmingsproblemen te voorkomen en maakt de setup eenvoudig te reproduceren.
export WORKDIR="/workspace"
export LLAMA_DIR="$WORKDIR/llama.cpp"
export MODEL_DIR="$WORKDIR/models/unsloth/GLM-4.7-Flash-GGUF"
Maak de map aan waarin de modelbestanden worden opgeslagen en configureer de Hugging Face-cachelocaties binnen de werkruimte in plaats van in de homedirectory. Dit verbetert de downloadprestaties en voorkomt onnodige waarschuwingen.
mkdir -p "$MODEL_DIR"
export HF_HOME="$WORKDIR/.cache/huggingface"
export HUGGINGFACE_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
export HF_HUB_CACHE="$WORKDIR/.cache/huggingface/hub"
Stel aanvullende omgevingsvariabelen in om symlink-waarschuwingen te onderdrukken en downloads met hoge prestaties in te schakelen.
export HF_HUB_DISABLE_SYMLINKS_WARNING=1
export HF_XET_HIGH_PERFORMANCE=1
Installeer ten slotte de vereiste systeembibliotheken voor het bouwen van llama.cpp en het beheren van downloads.
sudo apt-get update
sudo apt-get install -y \
  build-essential cmake git curl libcurl4-openssl-dev
Op dit punt is de systeemomgeving klaar. De volgende sectie richt zich op het clonen en bouwen van llama.cpp met ingeschakelde CUDA-ondersteuning.
Met de omgeving voorbereid is de volgende stap het installeren van llama.cpp en dit bouwen met ingeschakelde CUDA-ondersteuning. Dit stelt GLM 4.7 Flash in staat efficiënt op de GPU te draaien.
Navigeer in de terminal naar je werkruimte. Voer vervolgens de volgende opdracht uit om de officiële llama.cpp-repository te clonen.
git clone https://github.com/ggml-org/llama.cpp "$LLAMA_DIR"Nadat de repository is gekloond, worden de bronbestanden gedownload naar de werkruimtemap.
Cloning into '/workspace/llama.cpp'...
remote: Enumerating objects: 76714, done.
remote: Counting objects: 100% (238/238), done.
remote: Compressing objects: 100% (157/157), done.
remote: Total 76714 (delta 172), reused 81 (delta 81), pack-reused 76476 (from 3)
Receiving objects: 100% (76714/76714), 282.23 MiB | 13.11 MiB/s, done.
Resolving deltas: 100% (55422/55422), done.
Updating files: 100% (2145/2145), done.
Configureer vervolgens de build met CMake en schakel expliciet CUDA-ondersteuning in. Deze stap bereidt het buildsysteem voor om GPU-versnelde binaries te compileren.
cmake "$LLAMA_DIR" -B "$LLAMA_DIR/build" \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON
Zodra de configuratie is voltooid, bouw je de vereiste llama.cpp-binaries. Deze opdracht compileert de kern-inferentietools, inclusief de command-line interface en de inferentieserver.
cmake --build "$LLAMA_DIR/build" --config Release -j --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split
Kopieer na het bouwen de gecompileerde binaries naar de hoofdmap van llama.cpp voor eenvoudigere toegang.
cp "$LLAMA_DIR/build/bin/llama-"* "$LLAMA_DIR/"Controleer ten slotte of llama.cpp correct is gebouwd en of CUDA wordt gedetecteerd door het help-commando van de inferentieserver uit te voeren.
"$LLAMA_DIR/llama-server" --help >/dev/null && echo "✔ llama.cpp built"Als CUDA-ondersteuning correct is ingeschakeld, bevestigt de output dat een CUDA-apparaat is gedetecteerd, inclusief het GPU-model en de compute capability.
ggml_cuda_init: found 1 CUDA devices:
  Device 0: NVIDIA GeForce RTX 3090, compute capability 8.6, VMM: yes
✔ llama.cpp builtMet llama.cpp gebouwd en CUDA-ondersteuning geverifieerd, is de volgende stap het downloaden van het GLM 4.7 Flash-model. In deze tutorial gebruiken we de Hugging Face Hub met Xet-ondersteuning om snelle en betrouwbare downloads van grote modelbestanden mogelijk te maken.
Typ in dezelfde terminal de volgende commando's om de vereiste Python-pakketten voor downloads met hoge prestaties te installeren.
pip -q install -U "huggingface_hub[hf_xet]" hf-xet
pip -q install -U hf_transfer
Voer vervolgens het volgende Python-script uit in de terminal om de 4-bit gekwantiseerde modelvariant te downloaden. Dit script gebruikt de eerder gedefinieerde werkruimtepaden en downloadt alleen het vereiste GGUF-bestand.
python - <<'PY'
import os
from huggingface_hub import snapshot_download

model_dir = os.environ["MODEL_DIR"]

snapshot_download(
    repo_id="unsloth/GLM-4.7-Flash-GGUF",
    local_dir=model_dir,
    allow_patterns=["*UD-Q4_K_XL*"],
)

print("✔ Download complete:", model_dir)
PY
Zodra de download is voltooid, zie je output die bevestigt dat het modelbestand succesvol is opgehaald, met een totale grootte van ongeveer 17,5 GB.
Fetching 1 files: 100%|███████████████████████████████████████████████████████████████████████████████████| 1/1 [00:52<00:00, 52.80s/it]
Download complete: 100%|████████████████████████████████████████████████████████████████████████████| 17.5G/17.5G [00:52<00:00, 480MB/s]✔ Download complete: /workspace/models/unsloth/GLM-4.7-Flash-GGUF
Controleer ten slotte of het modelbestand in de doelmap aanwezig is.
ls -lh "$MODEL_DIR"Je zou het bestand GLM-4.7-Flash-UD-Q4_K_XL.gguf moeten zien, wat bevestigt dat het model klaar is voor inferentie.
total 17G
-rw-rw-rw- 1 root root 17G Jan 21 18:46 GLM-4.7-Flash-UD-Q4_K_XL.ggufMet het model gedownload en llama.cpp gebouwd met CUDA-ondersteuning, is de volgende stap het starten van de inferentieserver. Hiermee stel je GLM 4.7 Flash bloot als een lokale API die kan worden gebruikt door gebruikersinterfaces, scripts en AI-codeeragenten.
Gebruik dezelfde terminalsessie en werkruimte die je in de vorige secties hebt geconfigureerd.
Lokaliseer eerst het gedownloade GGUF-modelbestand en sla het pad op in een omgevingsvariabele.
export MODEL_FILE="$(ls "$MODEL_DIR"/*.gguf | grep -i UD-Q4_K_XL | head -n 1)"Start vervolgens de llama.cpp-inferentieserver met het volgende commando. Deze configuratie is geoptimaliseerd voor een RTX 3090 en balanceert doorvoer, latentie en contextlengte.
$LLAMA_DIR/llama-server \
  --model "$MODEL_FILE" \
  --alias "GLM-4.7-Flash" \
  --threads 32 \
  --host 0.0.0.0 \
  --ctx-size 16384 \
  --temp 0.7 \
  --top-p 1 \
  --port 8080 \
  --fit on \
  --prio 3 \
  --jinja \
  --flash-attn auto \
  --batch-size 1024 \
--ubatch-size 256--model laadt het geselecteerde GLM 4.7 Flash GGUF-modelbestand voor inferentie.--alias kent een leesbare modelnaam toe die verschijnt in API-responses en logs.--threads gebruikt 32 CPU-threads om tokenisatie, scheduling en afhandeling van requests op een systeem met veel cores te ondersteunen.--host bindt de server aan alle netwerkinterfaces zodat deze lokaal of vanaf andere machines in het netwerk toegankelijk is.--ctx-size stelt een groot contextvenster in dat lange prompts ondersteunt met een gebalanceerd GPU-geheugenverbruik.--temp past gematigde willekeur toe om de responskwaliteit te verbeteren zonder de redeneerstabiliteit te schaden.--top-p schakelt nucleus-filtering uit om de volledige tokenverdeling tijdens generatie toe te staan.--port 8080 stelt de inferentieserver bloot op een standaard lokale ontwikkelingspoort.--fit schakelt automatische memory fitting in om de GPU-benutting te maximaliseren zonder VRAM-limieten te overschrijden.--prio stelt een gebalanceerd prioriteitsniveau in voor inferentieworkloads bij gelijktijdige requests.--jinja schakelt Jinja-templating in voor gestructureerde prompts en agent-achtige workflows.--flash-attn schakelt Flash Attention automatisch in wanneer ondersteund door de GPU om de doorvoer te verhogen.--batch-size maakt grote batchverwerking mogelijk om de token-throughput op de RTX 3090 te verbeteren.--ubatch-size splitst grote batches in kleinere microbatches om geheugenbelasting en latentie te beheersen.Zodra de server start, wordt het model in het GPU-geheugen geladen en luistert de server naar requests op poort 8080. Op dit punt draait GLM 4.7 Flash lokaal en is het toegankelijk via HTTP-endpoints voor chat-, completion- en agent-gebaseerde workflows.
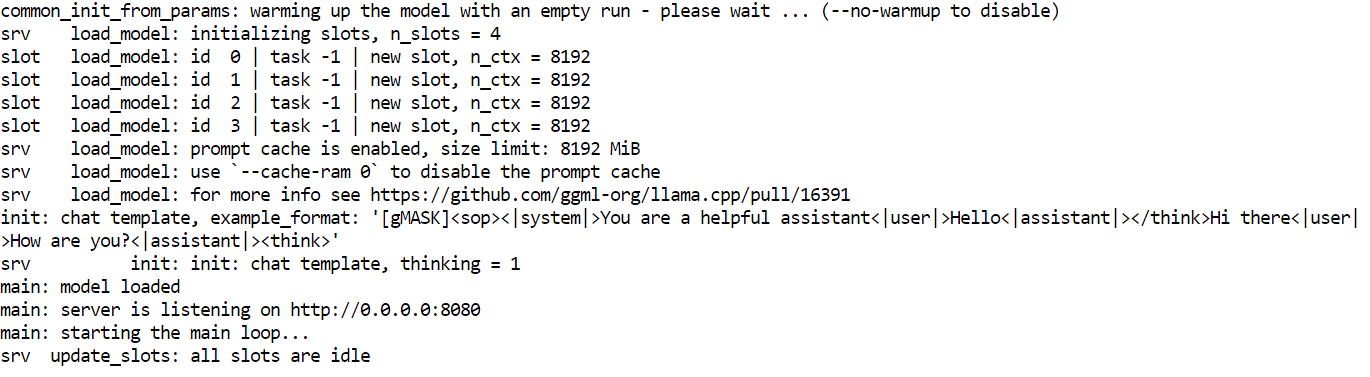
Nu de inferentieserver draait, kun je GLM 4.7 Flash testen via meerdere interfaces, waaronder de ingebouwde web-UI, directe HTTP-requests en de OpenAI-compatibele Python SDK.
De webinterface van llama.cpp is beschikbaar op: http://0.0.0.0:8080
Kopieer deze URL en open hem in je webbrowser om toegang te krijgen tot een eenvoudige chatinterface zoals ChatGPT.
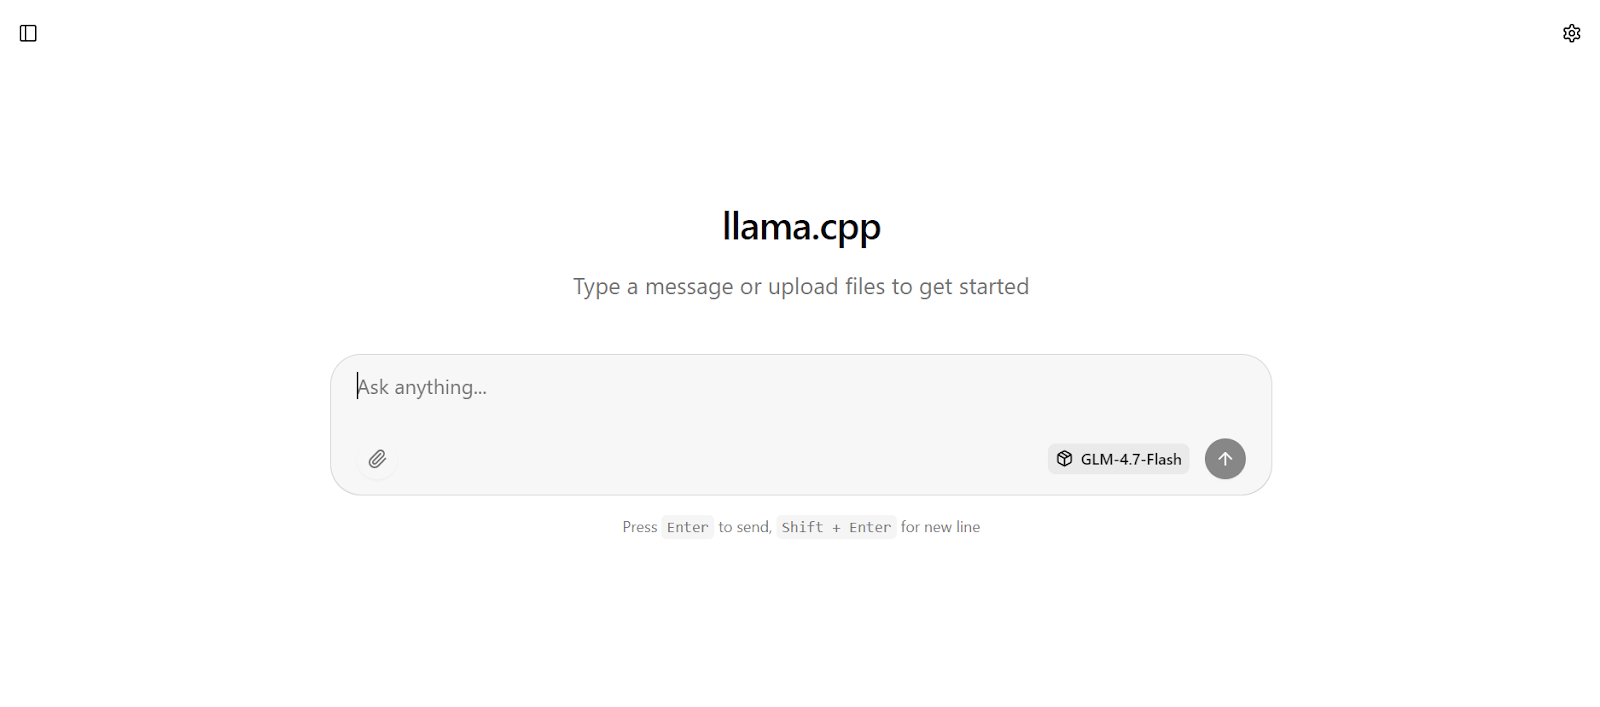
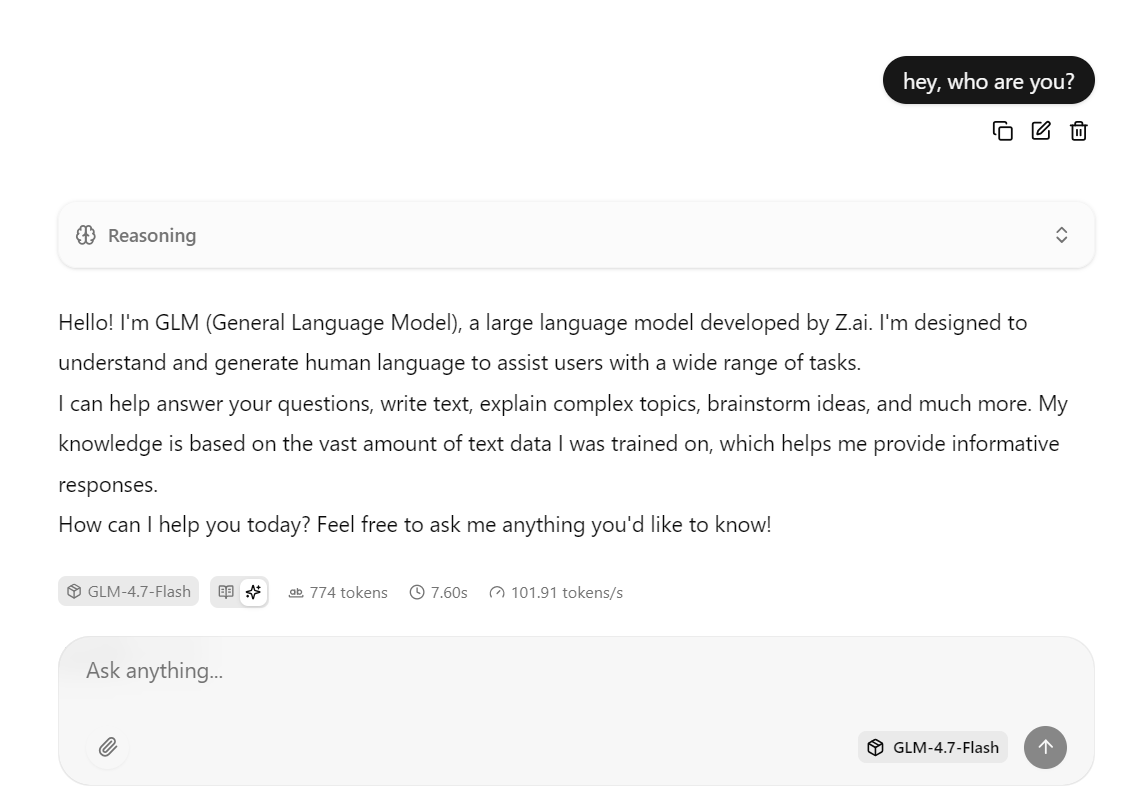
Voer een prompt in en het model begint direct met het genereren van een antwoord.
Deze setup is geoptimaliseerd voor snelheid door het model op de RTX 3090 te draaien met CUDA ingeschakeld, Flash Attention waar beschikbaar en batching-instellingen afgestemd op hoge throughput.
In de praktijk kan deze configuratie ongeveer 100 tokens per seconde halen voor korte tot middellange antwoorden.
Je kunt ook met dezelfde server interageren via een curl-commando. Open een nieuw terminalvenster en voer de volgende request uit om een chat completion-prompt te sturen.
curl -N http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer local" \
  -d '{
    "model": "GLM-4.7-Flash",
    "messages": [
      { "role": "user", "content": "Write a short bash script that prints numbers 1 to 5." }
    ]
  }'
Je kunt het model ook testen met Python door de OpenAI Python SDK te installeren.
pip -q install openaiIn dit Python-voorbeeld wordt de OpenAI-client geconfigureerd om requests te sturen naar de lokaal draaiende llama.cpp-inferentieserver.
De base_url wijst naar het lokale API-endpoint en het API-sleutelveld is vereist door de SDK, maar kan elke placeholderwaarde zijn omdat authenticatie lokaal wordt afgehandeld.
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="local"
)
De client stuurt vervolgens een chat completion-request naar GLM 4.7 Flash met gebruik van de modelalias die is gedefinieerd toen de inferentieserver werd gestart. De prompt wordt aangeleverd in standaard chatformaat en de response wordt teruggegeven als een gestructureerd object.
r = client.chat.completions.create(
    model="GLM-4.7-Flash",
    messages=[{"role": "user", "content": "Build me a Simple API server using FastAPI"}]
)

print(r.choices[0].message.content)
Binnen enkele seconden geeft het model een volledig antwoord terug, inclusief voorbeeldcode en uitleg.
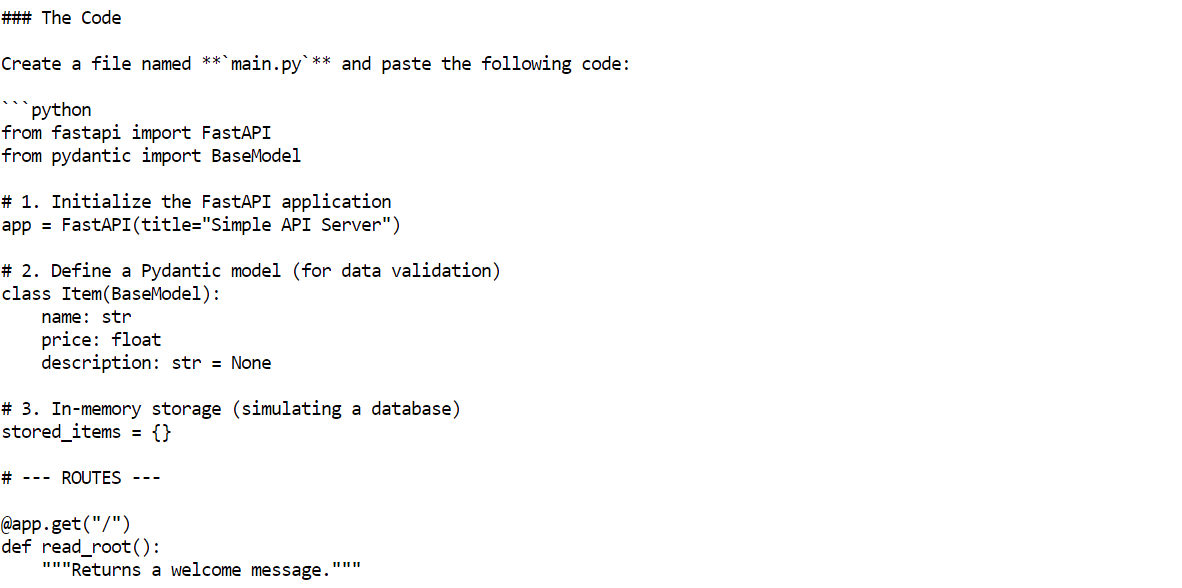
OpenCode is een open-source AI-codeeragent die lokaal draait en agentische workflows ondersteunt zoals codegeneratie, bestanden bewerken, commando's uitvoeren en iteratief problemen oplossen.
In tegenstelling tot cloudgebaseerde codeerassistenten kan OpenCode worden gekoppeld aan zelf-gehoste inferentieservers, zodat je een volledig lokale en gratis AI-codeeropstelling kunt bouwen.
In deze tutorial wordt OpenCode geconfigureerd om de lokale llama.cpp-server te gebruiken die GLM 4.7 Flash draait via een OpenAI-compatibele API.
Begin met dezelfde terminalsessie en installeer OpenCode met het officiële installatie-script.
curl -fsSL https://opencode.ai/install | bash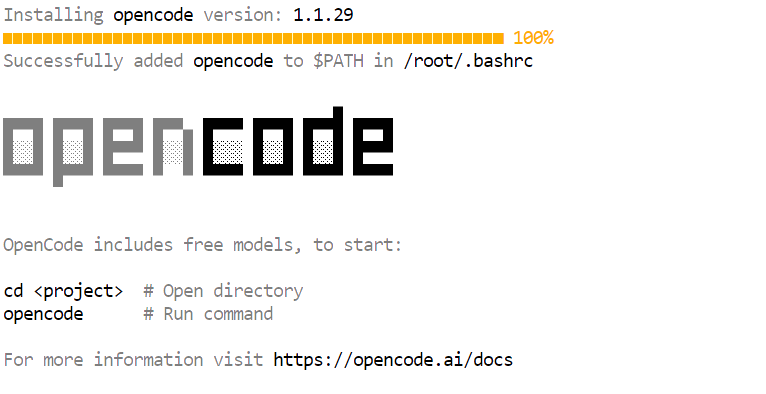 Werk na de installatie je PATH bij zodat het opencode-commando beschikbaar is in de terminal.
export PATH="$HOME/.local/bin:$PATH"Open een nieuw terminalvenster en controleer of OpenCode correct is geïnstalleerd.
opencode --versionJe zou een versienummer moeten zien dat hierop lijkt.
1.1.29Maak vervolgens de configuratiemap van OpenCode aan. Maak daarna het configuratiebestand van OpenCode en definieer llama.cpp als de provider. Deze configuratie vertelt OpenCode om alle requests naar de lokaal draaiende inferentieserver te sturen en het GLM 4.7 Flash-model te gebruiken.
mkdir -p ~/.config/opencode


cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llamacpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama.cpp (local)",
      "options": {
        "baseURL": "http://127.0.0.1:8080/v1"
      },
      "models": {
        "GLM-4.7-Flash": {
          "name": "GLM-4.7-Flash (UD-Q4_K_XL)"
        }
      }
    }
  },
  "model": "GLM-4.7-Flash"
}
EOF
Authenticeer ten slotte OpenCode. Deze stap is vereist door de tool, maar omdat de inferentieserver lokaal is, kan de API-sleutel elke placeholderwaarde zijn.
opencode auth loginGebruik bij de prompts de volgende waarden.
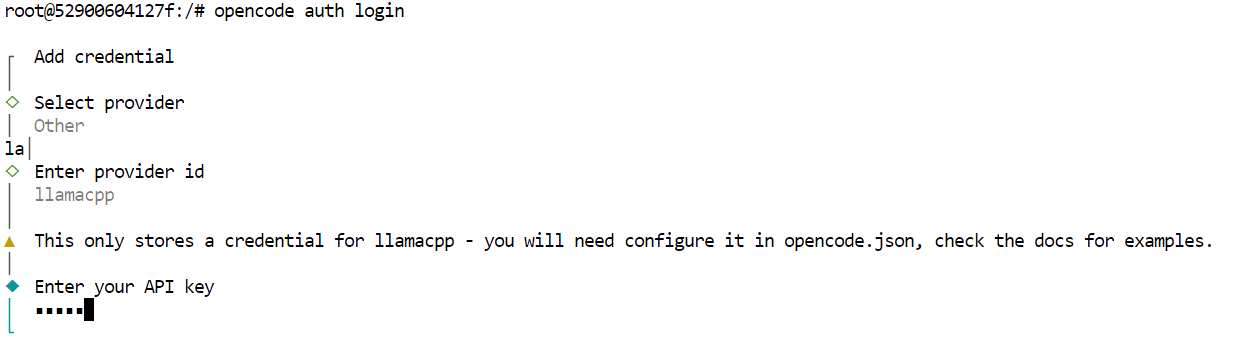
Op dit punt is OpenCode volledig geconfigureerd om GLM 4.7 Flash te gebruiken via de lokale llama.cpp-server.
Met OpenCode geconfigureerd en verbonden met de lokale llama.cpp-server kun je GLM 4.7 Flash nu gebruiken als een volledig geautomatiseerde AI-codeeragent.
Begin met het aanmaken van een nieuwe projectmap en navigeer ernaartoe.
mkdir -p /workspace/project
cd /workspace/project
Start vervolgens OpenCode vanuit dezelfde terminal.
opencodeZodra OpenCode start, druk je op de Tab-toets om naar Plan-modus te schakelen. Beschrijf in deze modus wat je wilt bouwen.
Voer bijvoorbeeld een prompt in waarin je OpenCode vraagt een eenvoudige, door machine learning aangedreven API te maken met FastAPI. OpenCode zal het project automatisch plannen, de code genereren, de API-server draaien en de implementatie testen.
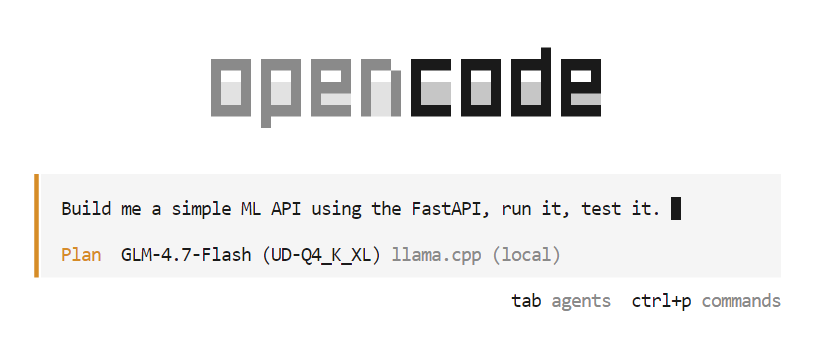
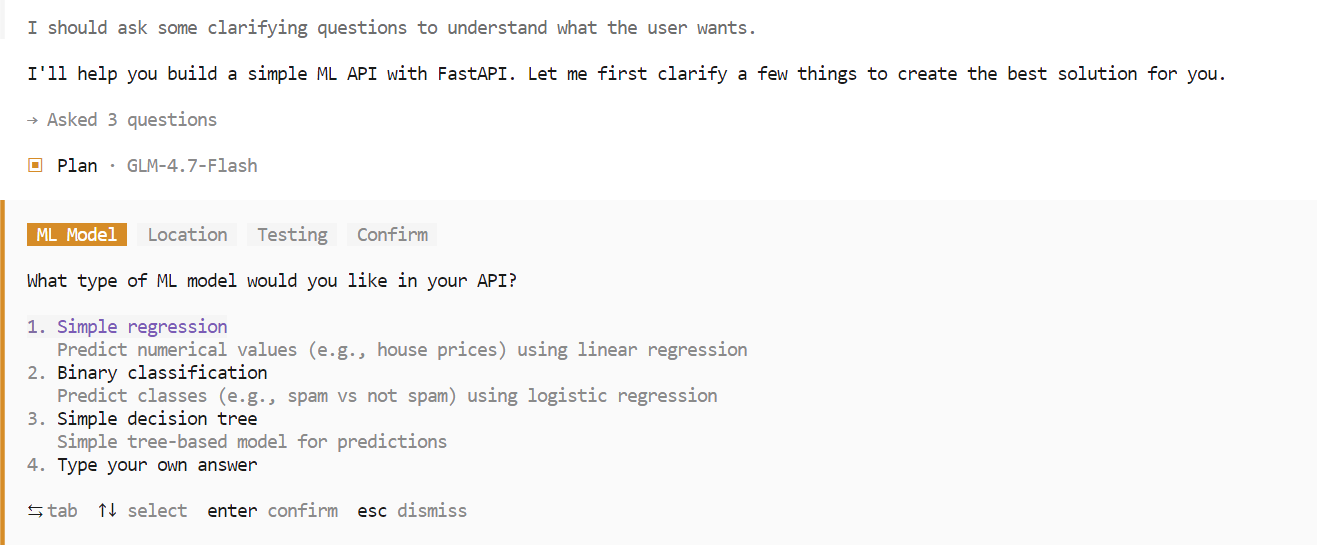
Tijdens de planningsfase kan OpenCode vervolgvragen stellen om vereisten te verduidelijken, zoals frameworkkeuzes, endpoints of projectstructuur. Selecteer de opties die je verkiest en bevestig om door te gaan.
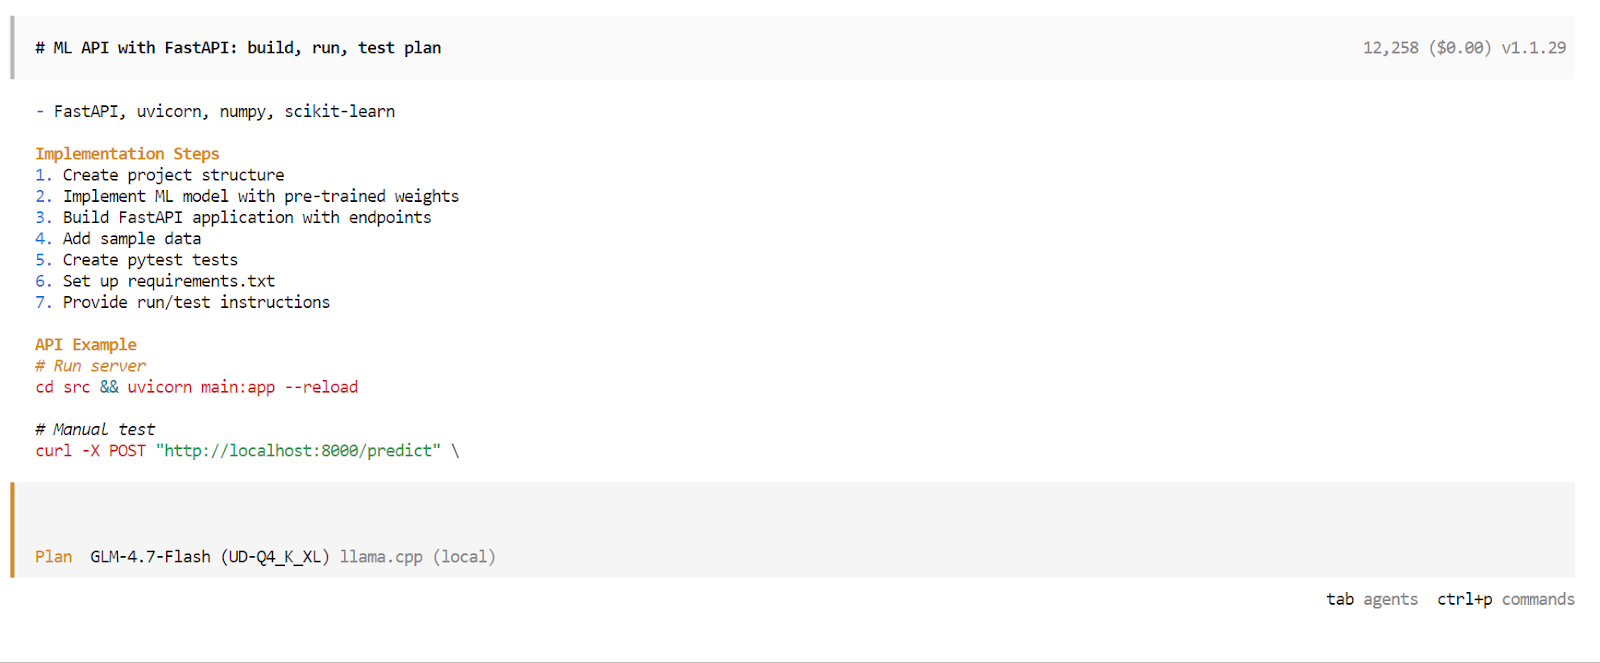
Na de planningsfase presenteert OpenCode een gedetailleerd uitvoeringsplan. Bekijk het plan en keur het goed als het aan je verwachtingen voldoet. Druk vervolgens opnieuw op Tab om van Plan-modus naar Build-modus te schakelen.
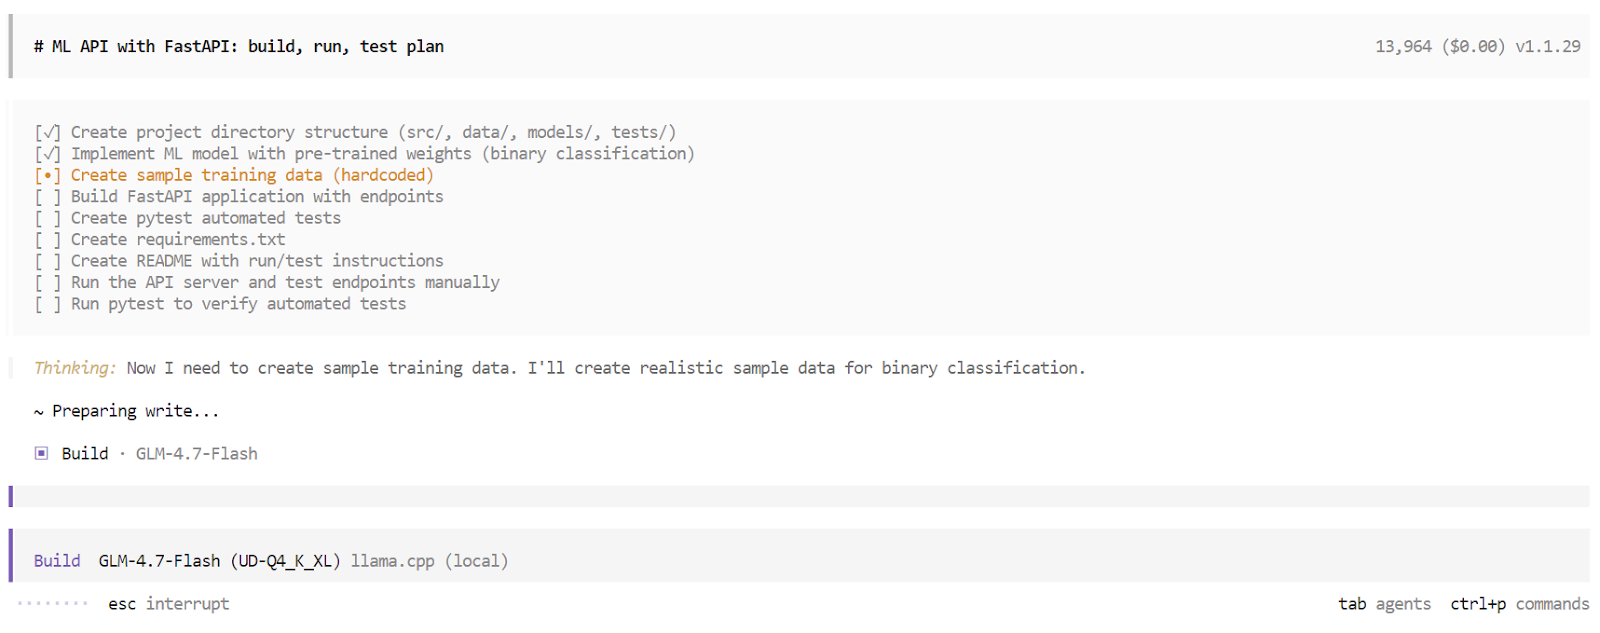
In Build-modus maakt OpenCode een gestructureerde takenlijst en voert elke stap sequentieel uit. Dit omvat bestanden genereren, code schrijven, dependencies installeren, de server draaien en tests uitvoeren. Je kunt elke taak in realtime zien voltooien.
Zodra het buildproces is voltooid, geeft OpenCode een volledig overzicht van de applicatie. Dit omvat gebruiksinstructies, voorbeeldaanvragen en de resultaten van geautomatiseerde tests. Op dit punt heb je een volledig werkende applicatie, gebouwd en gevalideerd door een lokale AI-codeeragent die volledig op je eigen machine draait.
GLM 4.7 Flash is een sterke stap richting volledig lokale AI-codeeragenten. De mogelijkheid om een snel, capabel redeneermodel volledig op lokale hardware te draaien en te integreren met tools zoals OpenCode, betekent een betekenisvolle verschuiving weg van cloudafhankelijke workflows.
Dat gezegd hebbende, GLM 4.7 Flash heeft nog beperkingen. Hoewel het goed presteert bij kleine tot middelgrote taken, kan het moeite hebben met complexere, meerstaps codeerworkflows. De context kan snel vollopen, toolexecutie kan soms mislukken en in sommige gevallen kan de agent halverwege stoppen, waardoor een nieuwe sessie nodig is om door te gaan.
Deze issues zijn te verwachten bij een lichtgewicht MoE-model dat is geoptimaliseerd voor snelheid in plaats van maximale redeneerdiepte.
Qua ruwe capaciteit staat GLM 4.7 Flash niet op hetzelfde niveau als het volledige GLM 4.7-model, dat qua prestaties dichter in de buurt komt van modellen zoals Claude 4.5 Sonnet. De trade-off is duidelijk: GLM 4.7 Flash geeft prioriteit aan snelheid, efficiëntie en lokale bruikbaarheid boven maximale redeneerkracht.
Het doorlopen van deze tutorial en het tunen van de inferentieserver was een waardevolle ervaring. Het draaien van varianten met hogere precisie en het vergroten van het contextvenster kan de codereliabiliteit verbeteren, maar de beste resultaten vereisen zorgvuldige experimenten met parameters zoals temperatuur, top p, batchgroottes en contextlengte. Een optimale setup bereiken is een iteratief proces.
Al met al is GLM 4.7 Flash een praktische en spannende optie voor ontwikkelaars die vandaag nog snelle, lokale en gratis AI-codeeragenten willen, met duidelijke ruimte voor verbetering naarmate tooling en modellen blijven evolueren.
Beste DataCamp-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


