Curso
Introdução à Regressão em R
4 h
78.5K
Se eu pudesse recomendar uma coisa para você dominar e se tornar um analista de dados ou cientista de dados melhor, seria regressão. E uma parte essencial de aprender regressão é entender exatamente o que é heterocedasticidade.
Neste artigo, vamos explorar o fenômeno da heterocedasticidade, entender por que isso importa, como identificar e como tratar. Vou ser completo, mas direto ao ponto. Então, seja você um analista experiente ou esteja começando agora, espero que encontre algo útil por aqui. Para saber mais e começar sua jornada rumo à especialização, faça nosso Intro to Regression in R ou nosso Intro to Regression in Python. Também tenho um tutorial sobre regressão linear simples, caso você precise relembrar rapidamente.
Então, o que exatamente é heterocedasticidade? Vamos tirar as definições técnicas do caminho antes de vermos alguns exemplos. Se você tropeça nessa palavra como eu, pode dizer "variância desigual" que dá no mesmo.
Heterocedasticidade se refere a uma situação em que a variabilidade de uma variável dependente é desigual ao longo do intervalo de valores de uma variável independente. Ou, em uma definição mais ancorada na construção de modelos, podemos dizer que ocorre heterocedasticidade quando a dispersão dos resíduos não é constante, como às vezes vemos em um modelo de regressão ou de séries temporais.
De certa forma, eu prefiro essa segunda definição porque ela nos lembra que heterocedasticidade é um aspecto comum (embora também um problema frequente) da modelagem estatística. Mas, para deixar claro, embora a heterocedasticidade seja mais discutida no contexto de modelos como regressão, ela pode ser tanto uma característica da especificação do modelo quanto uma propriedade dos próprios dados.
Vamos ver alguns exemplos usando R e escolher uma área — finanças domésticas, por exemplo. Para começar, vou mostrar o formato clássico de funil ou leque, que é o que mais me vem à cabeça quando penso em variância desigual.
Esse tipo de heterocedasticidade pode ocorrer, por exemplo, em dados de renda vs. gastos: famílias de baixa renda costumam ter gastos mensais mais consistentes focados em itens essenciais como aluguel e alimentação, resultando em baixa variabilidade; já famílias de alta renda podem ter maior variabilidade nos gastos porque apenas parte delas opta por compras discricionárias caras, como viagens ou itens de luxo, enquanto outras poupam. Nesse exemplo, à medida que a renda aumenta, a variabilidade nas despesas mensais também aumenta, formando o formato em leque.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )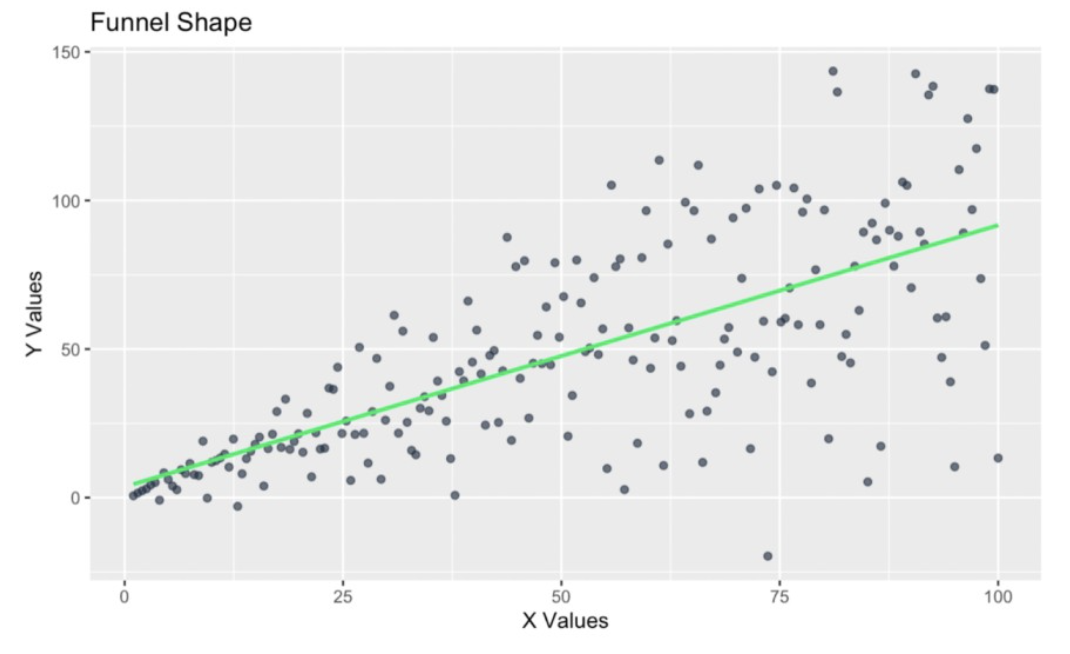
Formato de funil nos resíduos. Imagem do autor
Vamos tentar outro exemplo, também no universo das finanças domésticas. Imagine agora que estamos criando um modelo de regressão para mostrar a variabilidade da poupança em função da idade dos membros do domicílio.
Suspeitamos que esses dados apresentarão heterocedasticidade porque domicílios mais jovens podem ter alta variabilidade na poupança devido à renda irregular, como bicos e estágios, ou despesas não planejadas, como pagamento de faculdade ou início de família. Mas, à medida que os domicílios envelhecem e estabilizam financeiramente, o comportamento de poupança se torna mais consistente, criando um formato de funil invertido em que a variabilidade diminui com a idade.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )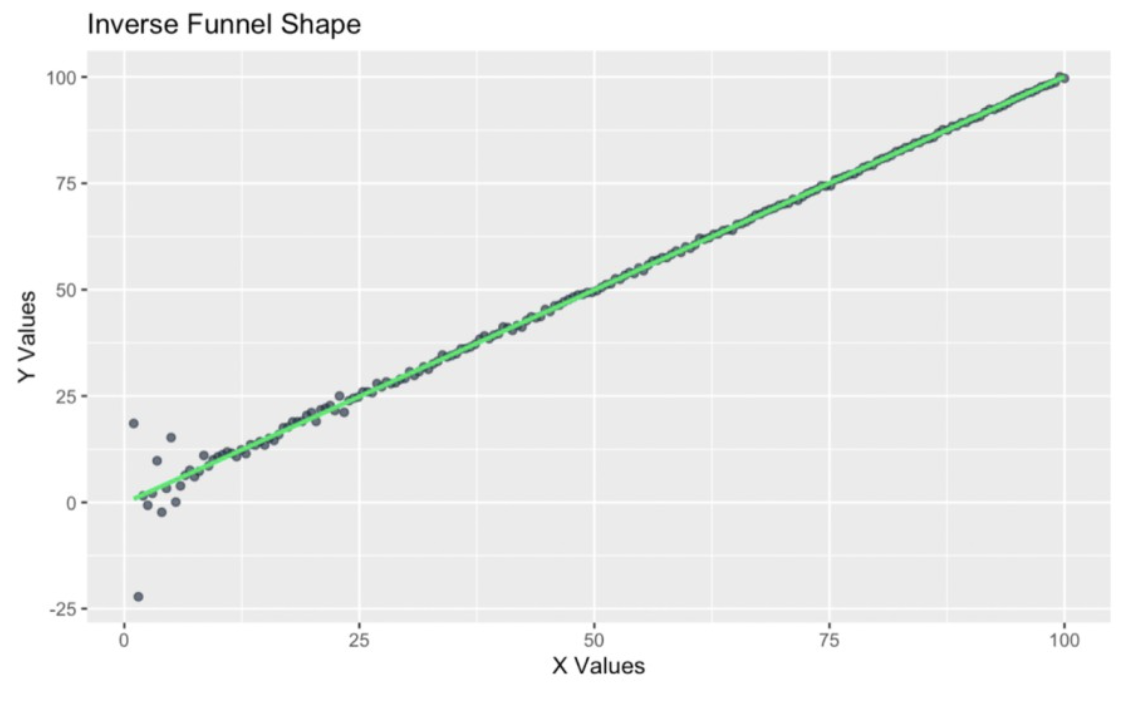
Formato de funil invertido nos resíduos. Imagem do autor
Vamos ver um último exemplo com rendas familiares. Aqui, observamos variância cíclica, especificamente a variabilidade de gastos ao longo das estações. Você pode reconhecer esse padrão se já fez algum dos nossos cursos de previsão, como o muito popular Forecasting in R.
Sabemos que os gastos domésticos costumam oscilar ciclicamente ao longo do ano. Por exemplo, a variância pode aumentar em períodos de festas porque compramos presentes ou viajamos para ver a família, e diminuir em meses com menos feriados, como março ou setembro. O gráfico a seguir mostra heterocedasticidade de um jeito mais complexo, aumentando e diminuindo em períodos diferentes.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )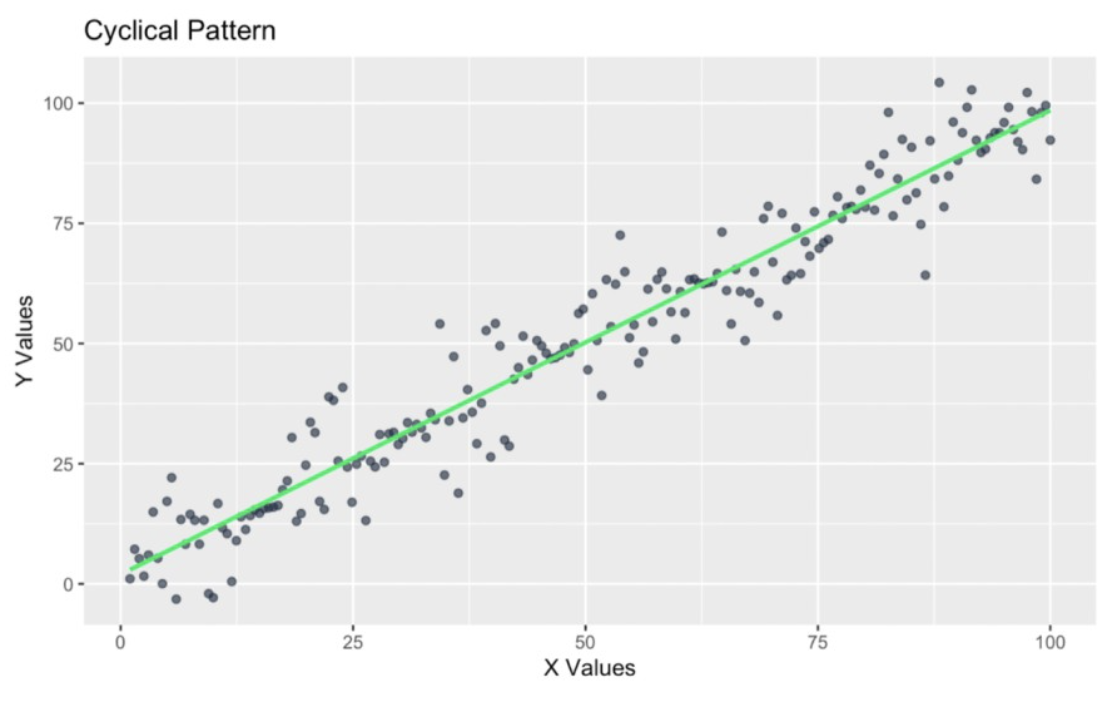
Padrão cíclico nos resíduos. Imagem do autor
Como você viu, a heterocedasticidade pode assumir várias formas. Agora vamos ver por que isso tudo importa.
Eu diria que, de modo geral, não dá para fazer regressões direito sem entender heterocedasticidade, já que ela é tão comum e pode distorcer bastante nossos resultados.
Provavelmente por isso a homocedasticidade — o oposto de heterocedasticidade — é uma das principais premissas de modelos de regressão, junto com linearidade, independência dos erros, normalidade dos resíduos e a ausência de multicolinearidade.
Essas premissas importam porque ajudam a garantir que as previsões e inferências do nosso modelo façam sentido. Quando são violadas, a confiabilidade das estimativas — incluindo erros-padrão e intervalos de confiança — pode piorar, e nossos testes de hipótese ficam menos válidos.
Heterocedasticidade não aparece do nada. Suas raízes muitas vezes estão em como os dados são coletados ou transformados. Vamos ver questões de transformação e de coleta de dados.
Às vezes, as próprias etapas que tomamos para preparar os dados podem introduzir heterocedasticidade. Estou pensando em como escalas inadequadas ou transformações não lineares podem criar variabilidade indesejada.
Para pensar nisso, imagine que estamos estudando a relação entre o tamanho de um apartamento e seu aluguel mensal. Normalmente, esperaríamos uma relação linear entre tamanho e aluguel, porque apartamentos maiores custam mais, e a variância no aluguel não necessariamente aumentaria com o tamanho, já que a relação (pode ser) proporcional. Veja como isso poderia ser:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")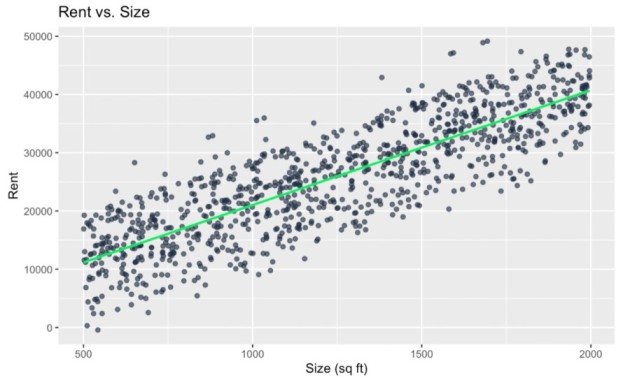
Sem heterocedasticidade. Imagem do autor
Se escalarmos o aluguel pelo tamanho para calcular "aluguel por pé quadrado", criamos uma nova métrica. Se depois tentarmos prever aluguel por pé quadrado pelo aluguel, podemos ver que essa transformação cria ou exagera a heterocedasticidade. Para deixar claro, em geral eu reconheço que isso não é uma boa ideia — dividir a variável independente pela dependente — porque criamos uma situação em que y já é influenciado por x, gerando correlação espúria. Então, sim, isso traz desafios conceituais e estatísticos. Mas (aguenta firme) estou usando como exemplo para ilustrar o ponto:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")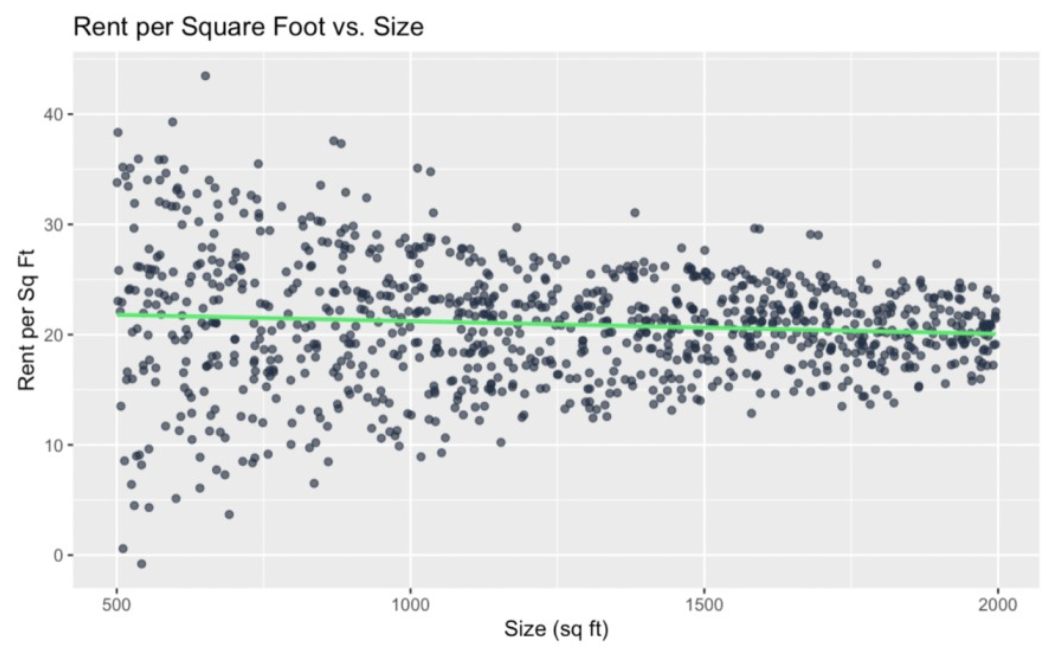
Heterocedasticidade induzida por dependência funcional. Imagem do autor
Vemos um formato de funil em que a variabilidade do aluguel por pé quadrado diminui à medida que o tamanho aumenta. Ou seja, criamos heterocedasticidade do nada. Em outro exemplo, podemos elevar ambas as variáveis ao quadrado:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")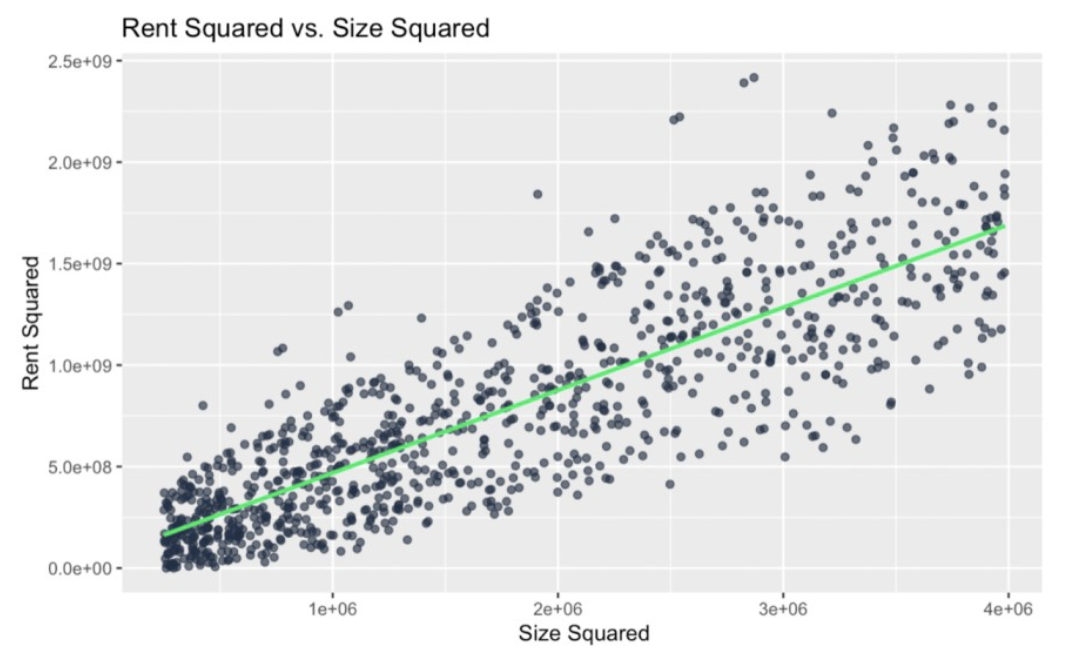
Heterocedasticidade induzida pelo uso de quadrados. Imagem do autor
De novo, criamos heterocedasticidade onde antes não havia, porque insistimos em elevar x e y ao quadrado. Em alguns contextos, tudo bem, mas aqui eu suspeitava que isso criaria heterocedasticidade porque a transformação amplificaria diferenças de variância conforme os valores aumentassem.
Esse segundo exemplo também é um pouco forçado, porque não deveríamos fazer esse modelo — ele seria difícil de interpretar à toa. Mas, em um fluxo de trabalho real, transformações que, sem querer, criam heterocedasticidade podem ser mais sutis. Você pode não perceber, especialmente quando o processo tem várias etapas.
Mais precisamente, neste caso, a heterocedasticidade resultou de engenharia de atributos com razões. Razões como "aluguel por pé quadrado" são comuns em feature engineering. Porém, essas variáveis podem introduzir heterocedasticidade se o denominador, em especial, variar muito entre as observações. Transformações logarítmicas ou exponenciais também são usadas com frequência para estabilizar variância ou linearizar relações. No entanto, aplicá-las de forma inconsistente pode sair pela culatra. Suponha que você aplique log na renda, mas não ajuste recursos relacionados como despesas. Esse desalinhamento é uma fonte comum de heterocedasticidade, então verifique se tudo está coerente para não induzir dinâmicas falsas.
Heterocedasticidade também pode surgir de práticas inconsistentes de coleta de dados. Por exemplo, trocar o instrumento de medição no meio do estudo pode introduzi-la. Ter grupos de tamanhos diferentes e, portanto, amostras distintas em um estudo também pode criar heterocedasticidade. Manter um método consistente faz diferença.
Detectar heterocedasticidade é o primeiro passo para tratá-la e, felizmente, existem ferramentas visuais e estatísticas que ajudam.
Gráficos de dispersão revelam padrões nos dados que ajudam a identificar heterocedasticidade. Eu gosto do gráfico de valores ajustados vs. resíduos para isso. Observação: um histograma de resíduos ou um gráfico q-q de resíduos não é suficiente para detectar heterocedasticidade, pois esses dois gráficos servem melhor para testar normalidade.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")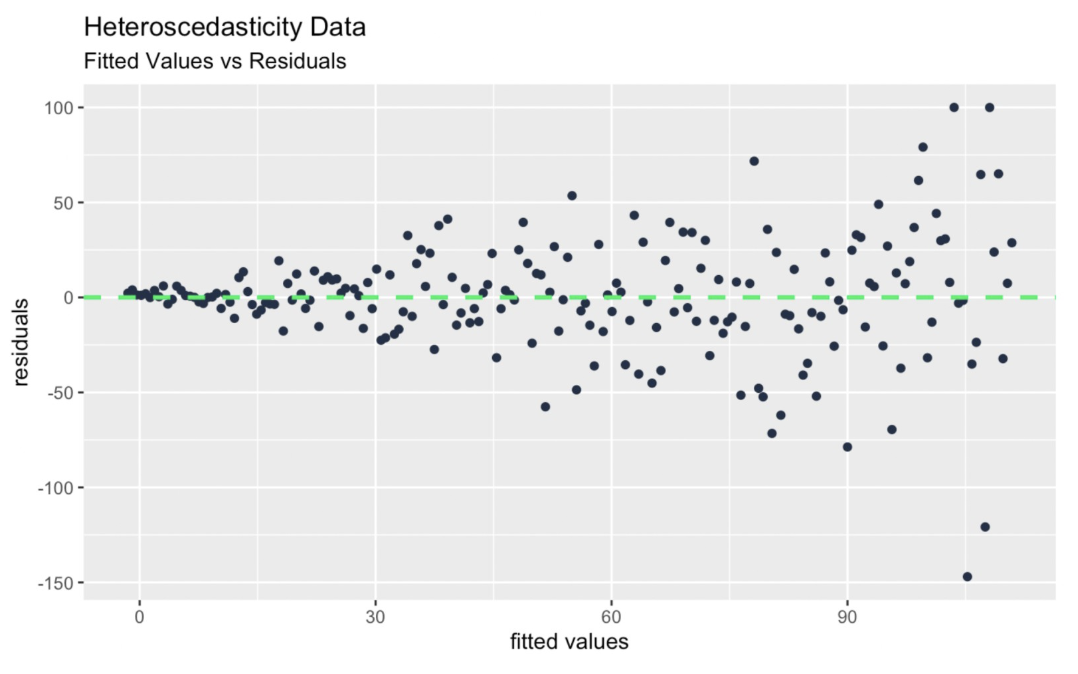 Gráfico diagnóstico de valores ajustados vs. resíduos. Imagem do autor
Testes como o teste de Breusch–Pagan oferecem uma abordagem quantitativa. O Breusch–Pagan verifica se os resíduos ao quadrado do modelo se relacionam com os preditores. Para conduzir o teste, ajustamos o modelo e usamos a função bptest() da biblioteca lmtest. Vale saber que o teste assume resíduos normais.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Depois de identificar a heterocedasticidade, o próximo passo é enfrentá-la com técnicas consagradas.
Transformações simples, como aplicar logaritmos, muitas vezes reduzem ou eliminam heterocedasticidade. Mais acima, pegamos um modelo sem variância desigual, aplicamos transformações e criamos problemas, mas o fluxo natural costuma ser o oposto: usamos transformações como logaritmo, raiz quadrada ou recíproca para comprimir valores maiores e ampliar os menores. Por exemplo, se o aluguel crescesse exponencialmente com o tamanho, aplicar log no aluguel achata o crescimento exponencial e torna a relação linear com (talvez) variância mais uniforme.
Também vale lembrar que, ao preparar dados, costumamos pensar em corrigir assimetria. Por exemplo, se temos dados assimétricos à direita, podemos usar raiz quadrada para aproximá-los de uma distribuição Gaussiana. O que às vezes não nos damos conta é que, em dados assimétricos, valores maiores tendem também a ter maior variabilidade, o que também viola a premissa de homocedasticidade.
Quando as transformações não bastam, métodos robustos como mínimos quadrados ponderados (WLS) ajudam. WLS é especialmente interessante aqui porque é feito para lidar com problemas como heterocedasticidade e outliers. Especificamente, WLS atribui pesos às observações com base em sua variância, reduzindo a influência de pontos com maior variabilidade e trazendo estimativas mais estáveis. Observação: no WLS, assumimos que os pesos são bem conhecidos ou bem estimados.
Ignorar a heterocedasticidade pode parecer inofensivo, mas traz problemas.
Heterocedasticidade pode distorcer como o modelo interpreta a importância dos atributos. Por exemplo, em um modelo de gastos, variáveis como renda podem parecer mais importantes se estiverem ligadas a grupos com alta variabilidade, como domicílios de alta renda com compras discricionárias. Essa má representação pode nos levar a supervalorizar preditores menos confiáveis e subestimar os mais consistentes, prejudicando a utilidade do modelo.
Heterocedasticidade pode invalidar o uso de testes estatísticos comuns como t e F se você estiver assumindo variância igual e essa premissa não for atendida. Variância desigual também é problemática em séries temporais, onde os padrões de variabilidade mudam ao longo do tempo, gerando confusão ao analisar tendências sazonais. Erros-padrão consistentes com heterocedasticidade (HCSE) podem ser usados para possibilitar inferência estatística mais confiável.
Neste artigo, estudamos a situação em que a variância dos resíduos não é constante entre níveis de uma variável independente em um modelo. Aqui, quero falar rapidamente sobre uma ideia relacionada, que é a heterogeneidade de variância em nível de grupo, referindo-se à variabilidade entre grupos predefinidos — algo menos ligado a premissas de modelo e mais a uma observação descritiva dos dados.
Vou mostrar com um exemplo final. Aqui, uso uma simulação de dados de pesquisa. Considero um cenário em que renda é coletada por dois métodos: pesquisas e registros administrativos. Esses métodos podem ter níveis diferentes de precisão (pesquisas não são famosas por isso?). Vemos que a quantidade de variação dentro de cada grupo não é consistente, o que pode ser um problema em algo como ANOVA.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)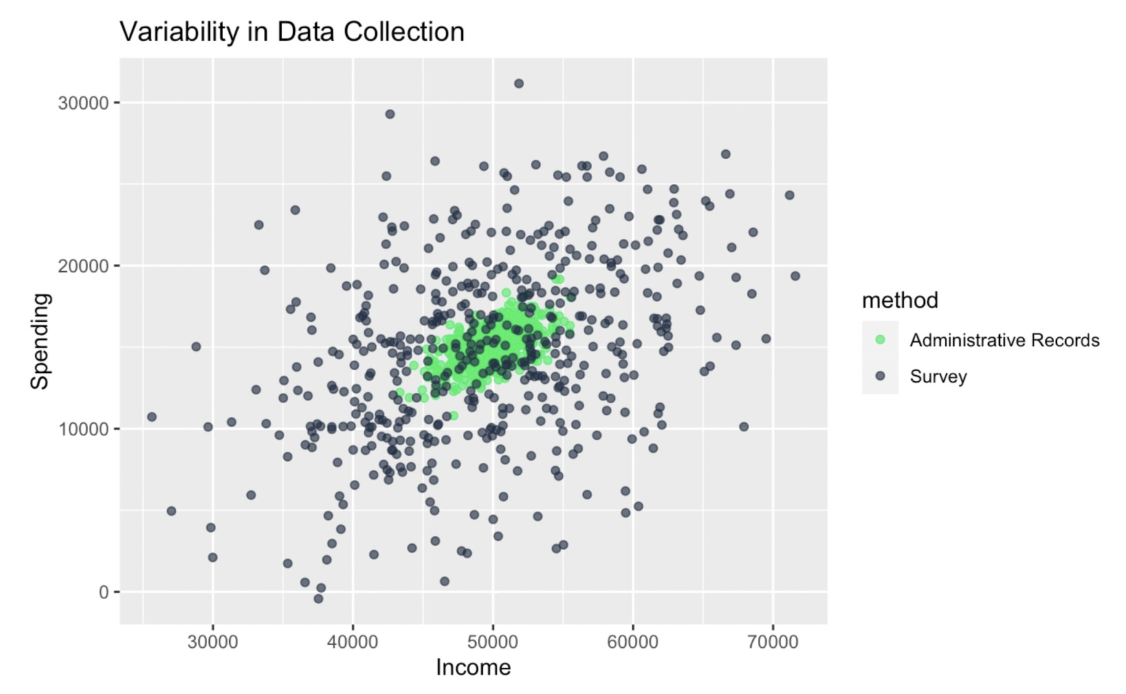
Heterogeneidade de variância em nível de grupo. Imagem do autor
Tratar a heterocedasticidade não é só melhorar seu modelo de regressão. É garantir que seu trabalho resista a qualquer escrutínio. Para continuar aprendendo e se tornar especialista, faça nossa trilha Statistical Inference in R e o curso Foundations of Inference in R. Também acho que a trilha Statistician in R é outra ótima opção para aprender e impulsionar sua carreira.
Aprenda regressão com a DataCamp
Curso
Curso
Curso
Tutorial
Vidhi Chugh
14 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Somil Asthana
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
10 min
Tutorial