
Kurs
Einführung in Regression mit R
4 Std.
78.5K
Wenn ich eine Sache empfehlen könnte, die du dir wirklich gründlich aneignen solltest, um als Data Analyst oder Data Scientist besser zu werden, dann ist es Regression. Und ein zentraler Teil davon ist zu verstehen, was genau Heteroskedastizität ist.
In diesem Artikel schauen wir uns das Phänomen der Heteroskedastizität an, warum es wichtig ist, wie man es erkennt und welche Schritte helfen, es zu beheben. Ich halte es umfassend, gehe aber zügig vor. Egal, ob du schon viel Erfahrung hast oder gerade erst startest – ich hoffe, du findest hier Nützliches. Mehr dazu und für deinen Einstieg in die Expertise: Starte mit unserem Kurs Intro to Regression in R oder mit Intro to Regression in Python. Außerdem habe ich ein Tutorial zur einfachen linearen Regression, falls du eine kurze Auffrischung brauchst.
Was genau ist Heteroskedastizität? Räumen wir erst die technischen Definitionen aus dem Weg, bevor wir Beispiele ansehen. Wenn du wie ich über dem Wort stolperst, sag einfach „ungleiche Varianz“ – damit ist der Kern getroffen.
Heteroskedastizität beschreibt eine Situation, in der die Streuung einer abhängigen Variablen über den Wertebereich einer unabhängigen Variablen ungleich ist. Modellbezogen formuliert: Heteroskedastizität liegt vor, wenn die Streuung der Residuen nicht konstant ist, wie wir es etwa in Regressions- oder Zeitreihenmodellen beobachten können.
Ich mag diese zweite Definition, weil sie uns daran erinnert, dass Heteroskedastizität ein häufiges Element (wenn auch häufiges Problem) statistischer Modellierung ist. Zur Klarstellung: Auch wenn Heteroskedastizität meist im Kontext von Modellen wie der Regression diskutiert wird, kann sie sowohl aus der Modellspezifikation als auch aus den Daten selbst resultieren.
Schauen wir uns ein paar Beispiele in R an und nehmen wir einen Bereich – sagen wir: Haushaltsfinanzen. Zum Einstieg zeige ich die klassische Trichter- oder Fächerform, an die ich bei ungleicher Varianz zuerst denke.
Diese Ausprägung von Heteroskedastizität kann z. B. bei Daten zu Einkommen vs. Ausgaben auftreten: Haushalte mit geringem Einkommen haben oft relativ konstante monatliche Ausgaben für Grundbedürfnisse wie Miete und Lebensmittel – geringe Varianz. Haushalte mit hohem Einkommen zeigen dagegen mehr Streuung, da nur manche teure, diskretionäre Käufe wie Urlaube oder Luxusgüter tätigen, während andere sparen. Mit steigendem Einkommen nimmt also die Streuung der monatlichen Ausgaben zu – daher die Fächerform.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )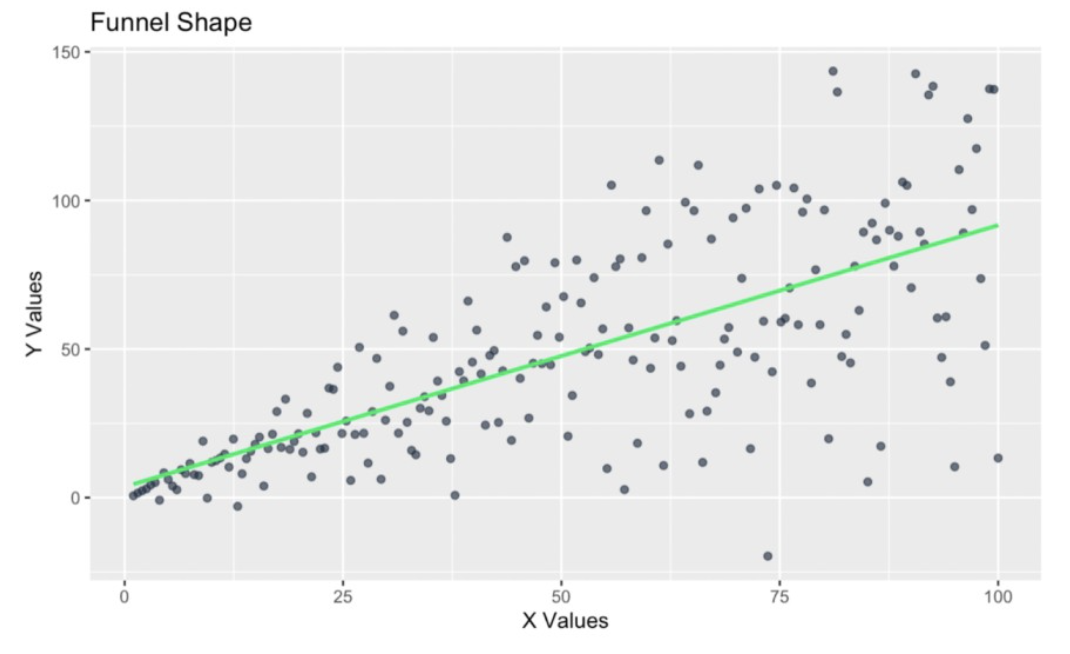
Trichterform in den Residuen. Bild: Autor
Nehmen wir ein weiteres Beispiel aus den Haushaltsfinanzen. Stell dir vor, wir bauen ein Regressionsmodell, das die Streuung der Ersparnisse in Abhängigkeit vom Alter der Haushaltsmitglieder zeigt.
Wir vermuten hier Heteroskedastizität, weil jüngere Haushalte durch unregelmäßiges Einkommen (Gig-Jobs, Praktika) oder ungeplante Ausgaben (Studienkredite, Familiengründung) eine hohe Streuung beim Sparen aufweisen könnten. Mit zunehmendem Alter und finanzieller Stabilität wird das Sparverhalten konstanter – es entsteht eine inverse Trichterform, in der die Streuung mit dem Alter abnimmt.
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )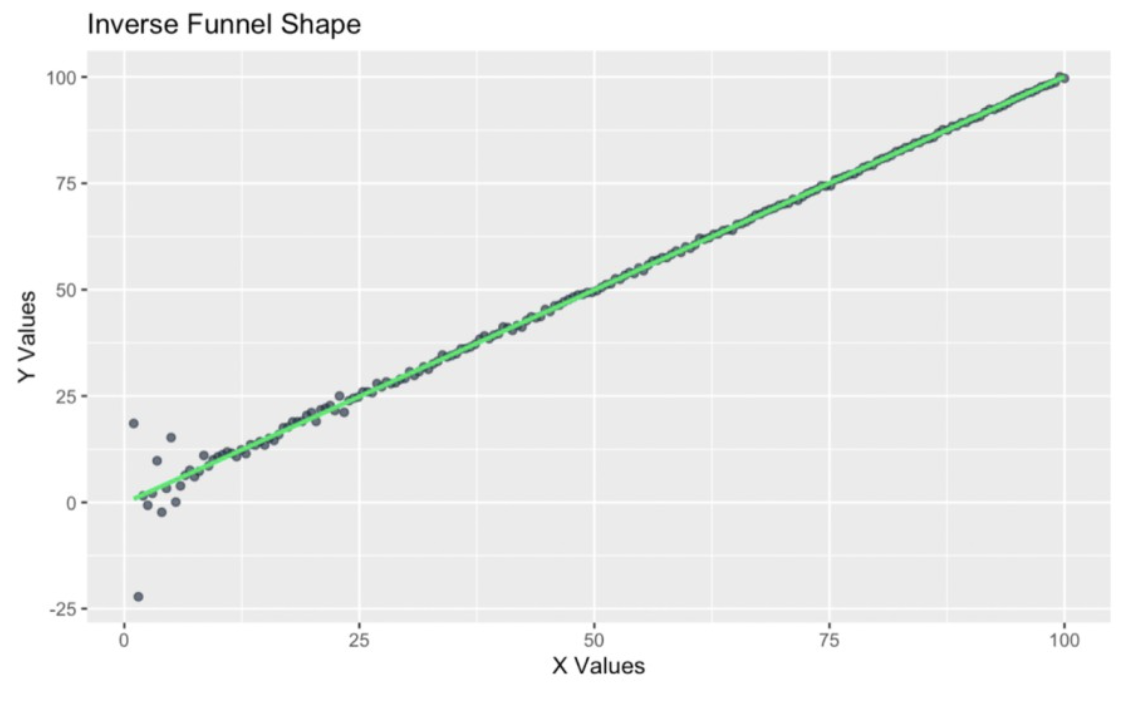
Inverse Trichterform in den Residuen. Bild: Autor
Zum Abschluss noch ein Beispiel zu Haushaltseinkommen. Hier betrachten wir zyklische Varianz, konkret die Ausgabenstreuung über die Jahreszeiten. Dieses Muster kennst du vielleicht aus unseren Forecasting-Kursen, zum Beispiel unserem sehr beliebten Forecasting in R.
Wir wissen, dass Haushaltsausgaben oft über das Jahr hinweg zyklisch schwanken. So steigt die Varianz in der Feiertagssaison durch Geschenke oder Reisen und sinkt in Monaten mit weniger Anlässen, etwa März oder September. Die folgende Grafik zeigt Heteroskedastizität in komplexerer Form: Sie nimmt in verschiedenen Phasen zu und ab.
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )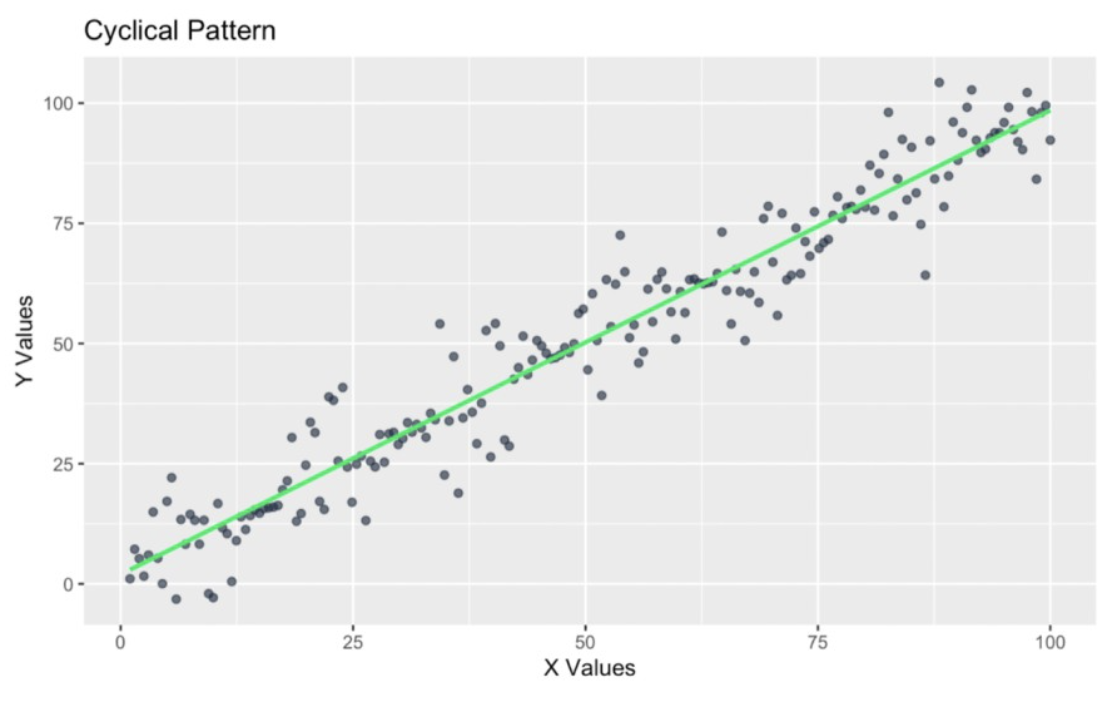
Zyklisches Muster in den Residuen. Bild: Autor
Du siehst: Heteroskedastizität kann verschiedene Formen annehmen. Schauen wir uns nun an, warum das wichtig ist.
Ganz allgemein würde ich sagen: Ohne ein Verständnis für Heteroskedastizität kannst du Regressionen nicht sauber durchführen – sie ist so verbreitet und kann Ergebnisse so stark verzerren.
Wahrscheinlich deshalb ist Homoskedastizität – das Gegenteil von Heteroskedastizität – eine der zentralen Annahmen von Regressionsmodellen, neben Linearität, Unabhängigkeit der Fehler, Normalverteilung der Residuen und der Abwesenheit von Multikollinearität.
Diese Annahmen sind wichtig, weil sie sicherstellen, dass Vorhersagen und Schlussfolgerungen unseres Modells sinnvoll sind. Werden sie verletzt, leidet die Verlässlichkeit unserer Schätzungen – inklusive Standardfehlern und Konfidenzintervallen – und unsere Hypothesentests werden weniger belastbar.
Heteroskedastizität entsteht nicht aus dem Nichts. Ihre Ursachen liegen oft in der Art, wie Daten erhoben oder transformiert werden. Schauen wir auf Probleme durch Transformationen und durch Datenerhebung.
Manchmal erzeugen die Schritte der Datenaufbereitung selbst Heteroskedastizität. Gemeint sind fehlerhafte Skalierung oder unpassende nichtlineare Transformationen, die unbeabsichtigte Streuung erzeugen.
Stell dir vor, wir untersuchen den Zusammenhang zwischen der Größe einer Wohnung und der monatlichen Miete. Normalerweise erwarten wir eine lineare Beziehung, weil größere Wohnungen mehr kosten, und die Varianz der Miete muss mit der Größe nicht zwangsläufig zunehmen, wenn der Zusammenhang (möglicherweise) proportional ist. So könnte das aussehen:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")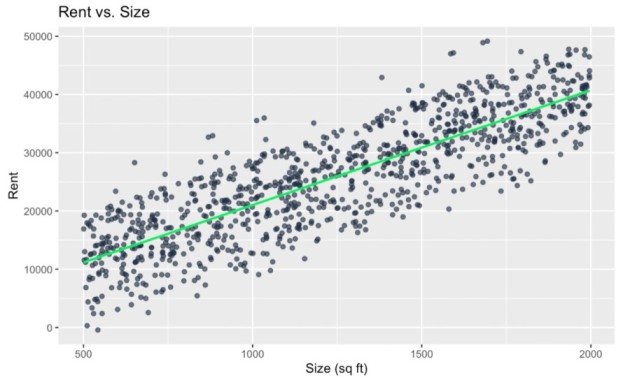
Keine Heteroskedastizität. Bild: Autor
Wenn wir die Miete durch die Größe teilen und so die „Miete pro Quadratfuß“ berechnen, schaffen wir eine neue Kennzahl. Versuchen wir dann, die Miete pro Quadratfuß über die Größe zu modellieren, kann diese Transformation Heteroskedastizität erzeugen oder verstärken. Zur Klarstellung: Allgemein ist es keine gute Idee, die abhängige durch die unabhängige Variable zu teilen, weil y dadurch funktional von x abhängt und eine Scheinkorrelation entsteht. Das ist konzeptionell und statistisch problematisch. Aber (bleib kurz bei mir) ich nutze es hier als Beispiel, um den Punkt zu verdeutlichen:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")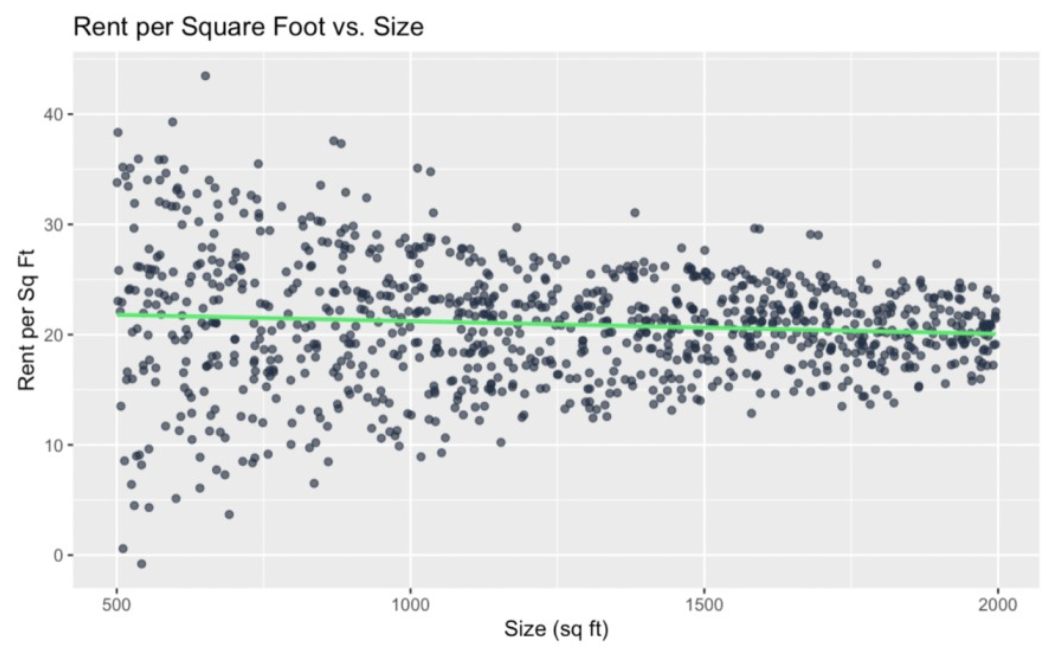
Durch funktionale Abhängigkeit induzierte Heteroskedastizität. Bild: Autor
Wir sehen eine Trichterform, in der die Streuung der Miete pro Quadratfuß mit zunehmender Größe abnimmt. Wir haben Heteroskedastizität aus dem Nichts geschaffen. Ein weiteres Beispiel: Wir quadrieren beide Variablen:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")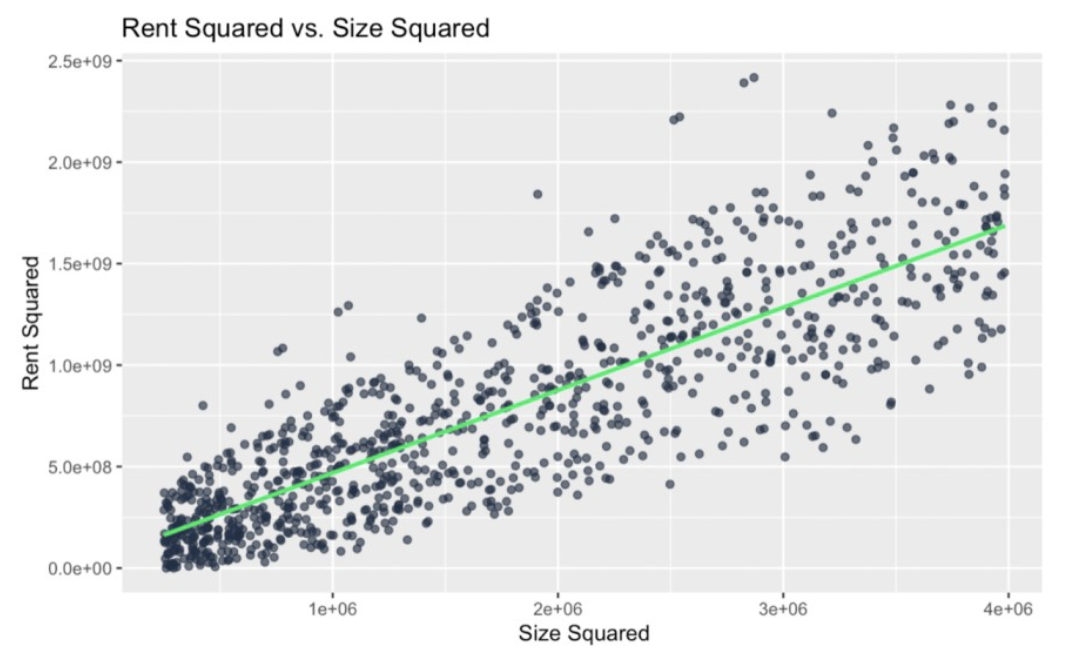
Durch Quadrieren induzierte Heteroskedastizität. Bild: Autor
Erneut haben wir Heteroskedastizität erzeugt, weil wir unbedingt x und y quadrieren wollten. In manchen Kontexten ist das in Ordnung, aber hier habe ich vermutet, dass sich dadurch die Varianzunterschiede mit zunehmenden Werten verstärken.
Auch dieses zweite Beispiel ist etwas konstruiert – so ein Modell würden wir nicht bauen, weil es ohne Not schwer zu interpretieren wäre. In echten Workflows können Transformationsschritte, die unbeabsichtigt Heteroskedastizität erzeugen, subtiler sein – besonders wenn mehrere Schritte involviert sind.
Genauer gesagt entstand Heteroskedastizität hier durch Feature Engineering mit Verhältnissen. Kennzahlen wie „Miete pro Quadratfuß“ sind gängig. Sie können aber Heteroskedastizität einführen, wenn insbesondere der Nenner stark zwischen Beobachtungen variiert. Logarithmische oder exponentielle Transformationen werden häufig genutzt, um Varianz zu stabilisieren oder Relationen zu linearisieren. Uneinheitlich angewandt, können sie jedoch nach hinten losgehen. Wenn du z. B. das Einkommen log-transformierst, aber verwandte Features wie Ausgaben nicht anpasst, entsteht leicht ein Missverhältnis – eine häufige Quelle von Heteroskedastizität. Achte daher auf Konsistenz, um keine künstlichen Dynamiken zu erzeugen.
Heteroskedastizität kann auch aus uneinheitlicher Datenerhebung resultieren. Wechselst du z. B. mitten in einer Studie das Messinstrument, kann das Heteroskedastizität erzeugen. Unterschiedliche Gruppengrößen und damit abweichende Stichprobengrößen in einer Untersuchung können ebenfalls Heteroskedastizität verursachen. Konsequenz in der Vorgehensweise ist wichtig.
Das Erkennen von Heteroskedastizität ist der erste Schritt zur Korrektur – zum Glück helfen visuelle und statistische Werkzeuge.
Streudiagramme können Muster aufdecken, die auf Heteroskedastizität hinweisen. Besonders hilfreich finde ich den Plot „angepasste Werte vs. Residuen“. Hinweis: Ein Histogramm der Residuen oder ein Q-Q-Plot der Residuen reicht dafür nicht aus – diese Plots sind vor allem für die Prüfung der Normalverteilung gedacht.
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")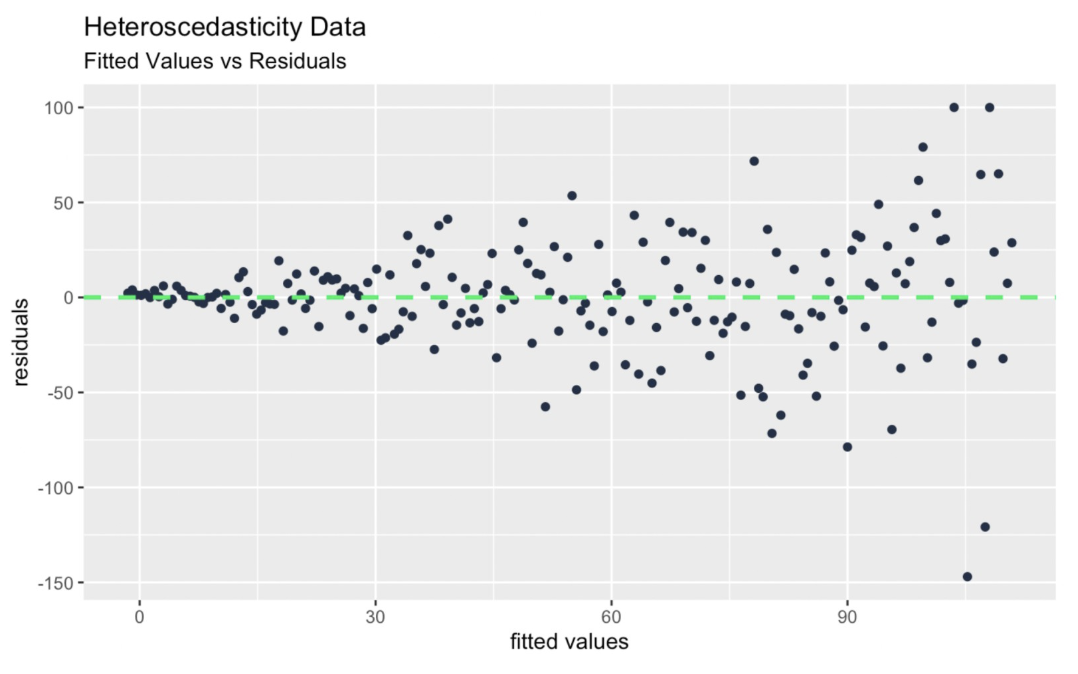 Diagnose-Plot: Angepasste Werte vs. Residuen. Bild: Autor
Statistische Tests wie der Breusch-Pagan-Test bieten einen quantitativen Ansatz. Der Breusch-Pagan-Test prüft, ob die quadrierten Residuen mit den Prädiktoren zusammenhängen. Dazu fitten wir ein Modell und verwenden die Funktion bptest() aus dem Paket lmtest. Beachte: Der Test setzt normalverteilte Residuen voraus.
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)Wenn Heteroskedastizität identifiziert ist, geht es an die Korrektur – mit bewährten Methoden.
Einfache Transformationen, etwa Logarithmen, können Heteroskedastizität oft reduzieren oder beseitigen. Vorhin haben wir ein Modell ohne ungleiche Varianz transformiert und dadurch Probleme erzeugt – in der Praxis ist es meist umgekehrt: Wir nutzen Logarithmen, Wurzeln oder Kehrwerte, um große Werte zu stauchen und kleine zu dehnen. Wenn die Miete z. B. exponentiell mit der Größe steigt, macht ein Log auf der Miete das Wachstum flacher und die Beziehung linearer – möglicherweise mit konstanter Varianz.
Außerdem denken wir bei der Datenvorbereitung oft an Schiefe. Bei rechtsschiefen Daten nutzen wir etwa eine Quadratwurzel-Transformation, um die Daten gaussförmig zu machen. Was dabei manchmal übersehen wird: In schiefen Verteilungen weisen größere Werte häufig auch größere Varianz auf – ebenfalls ein Verstoß gegen die Annahme der Homoskedastizität.
Wenn Transformationen nicht reichen, helfen robuste Verfahren wie Weighted Least Squares (WLS). WLS ist hier besonders interessant, da es speziell mit Problemen wie Heteroskedastizität und Ausreißern umgehen kann. Beobachtungen werden entsprechend ihrer Varianz gewichtet, Punkte mit hoher Varianz haben weniger Einfluss – die Schätzungen werden stabiler. Wichtig: Die Gewichte sollten bekannt oder gut geschätzt sein.
Heteroskedastizität zu ignorieren mag harmlos wirken, bringt aber Risiken mit sich.
Heteroskedastizität kann die Bedeutung von Merkmalen im Modell verzerren. In einem Ausgabenmodell könnte Einkommen wichtiger erscheinen, wenn es mit Gruppen hoher Varianz zusammenhängt, etwa wohlhabenden Haushalten mit diskretionären Käufen. Das führt dazu, dass unzuverlässigere Prädiktoren überbewertet und verlässlichere unterschätzt werden – die Nützlichkeit des Modells leidet.
Setzt du gleiche Varianz voraus, kann Heteroskedastizität gängige Tests wie t- und F-Tests ungültig machen. Problematisch ist ungleiche Varianz auch in Zeitreihen, wenn sich die Streuungsmuster über die Zeit ändern und saisonale Trends schwerer zu interpretieren sind. Heteroskedastizitätskonsistente Standardfehler (HCSE) können hier robustere Inferenz ermöglichen.
In diesem Artikel haben wir die Situation betrachtet, in der die Varianz der Residuen über die Ausprägungen einer unabhängigen Variable im Modell nicht konstant ist. Verwandt ist die Varianzheterogenität auf Gruppenebene – also Unterschiede der Streuung zwischen vordefinierten Gruppen. Das ist weniger ein modelltheoretisches Problem und mehr eine deskriptive Eigenschaft der Daten.
Ein letztes Beispiel dazu. Ich simuliere Umfragedaten und betrachte Einkommen, die über zwei Methoden erhoben wurden: Umfragen und Verwaltungsdaten. Diese Verfahren können unterschiedlich präzise sein (Umfragen sind berüchtigt, oder?). Man sieht, dass die Streuung innerhalb der Gruppen nicht einheitlich ist – problematisch etwa für ANOVA.
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)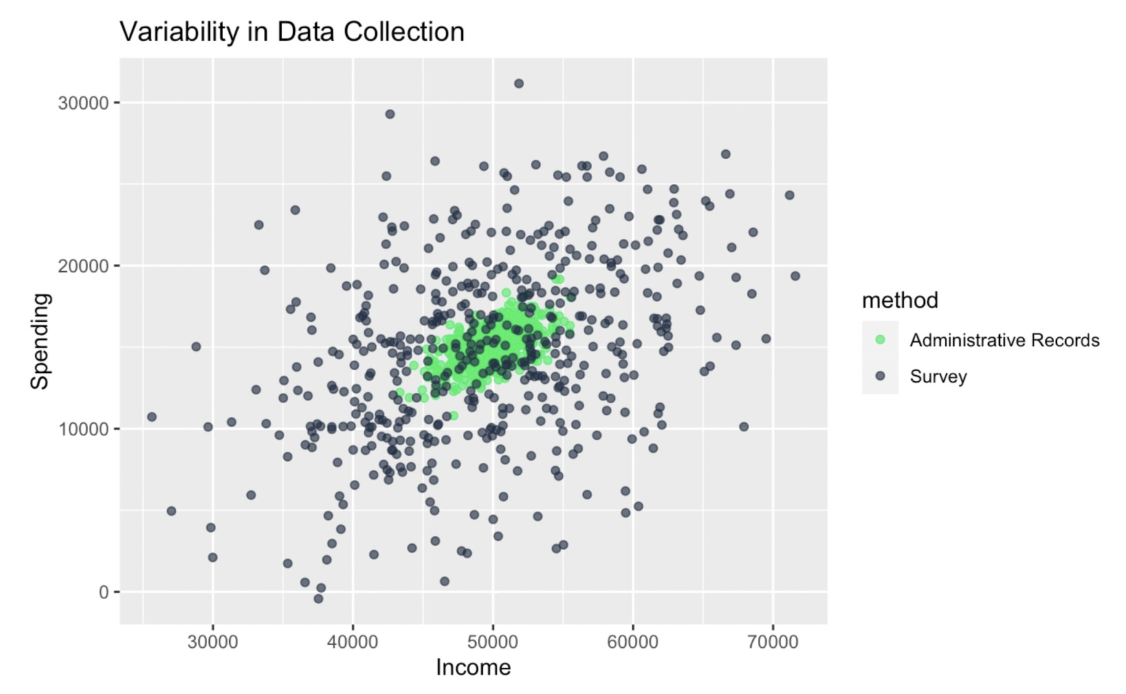
Varianzheterogenität auf Gruppenebene. Bild: Autor
Heteroskedastizität zu adressieren, verbessert nicht nur dein Regressionsmodell – es sorgt dafür, dass deine Arbeit einer kritischen Prüfung standhält. Wenn du weiterlernen und Expertin bzw. Experte werden willst, starte mit unserem Statistical Inference in R Lernpfad und dem Kurs Foundations of Inference in R. Auch unser Statistician in R Lernpfad ist eine starke Option – fürs Lernen und für deine Karriere.
Lerne Regression mit DataCamp
Kurs
Kurs
Kurs